


学术界到工业界:Python成为人工智能事实标准的原因

Python之所以能够成为整个人工智能领域跨越学术研究与工业落地的“事实标准”(De Facto Standard),并非取决于其解释器自身的执行速度,而是源于“高性能C/C++底层内核加轻量胶水接口”的双层架构范式、从学术论文探索到生产部署的平滑迁移流水线,以及在此基础上历经数十年演进所形成的不可替代的多维生态飞轮效应。
一、技术底座:胶水语言与底层算力引擎的分工架构
许多开发者在初次接触AI开发时常有疑问:Python由于全局解释器锁(GIL)与动态类型解释开销,本身运行并不快,为何它能统治极其耗费算力的人工智能计算?
答案在于人工智能计算的本质是“密集矩阵运算与张量计算”。在典型的深度学习模型中,99%以上的浮点运算时间都集中在底层GEMM(通用矩阵乘法)、卷积算子、非线性激活与CUDA核函数上。Python在整个技术栈中并不直接承担密集的底层循环计算,而是充当高度抽象、高可读性的“调度中枢”与“控制平面”。
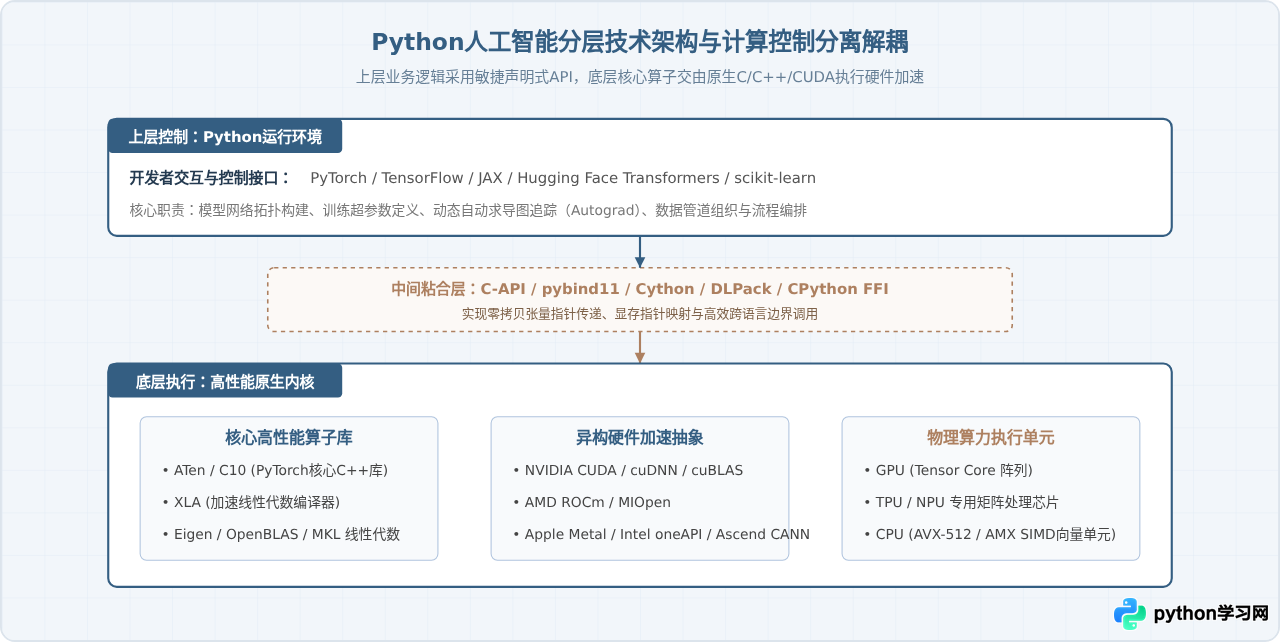
通过底层的分工,Python脚本执行诸如 y = torch.matmul(A, B) 时,Python虚拟机仅耗费几十纳秒将指令下发到底层C++运行时的显存缓冲区,紧接着触发CUDA核函数在GPU流多处理器(SM)中并发执行千万亿次浮点运算。开发人员获得了极高的脚本表现力与调试便利,而机器获得了原生硬件级的算力吞吐。
二、学术界的驱动:低认知负荷与科研探索范式契合
学术界在算法萌芽期对语言的选择具有决定性影响。在深度学习大爆发之前,科学计算与模式识别领域存在MATLAB、R、C/C++、Fortran等多方割据的局面。Python能够在这场学术工具之争中胜出,主要源于以下关键特质:
- 低语法噪音与伪代码般的表达能力:科研人员的核心目标是验证数学猜想与设计网络结构,而非花费精力管理手动内存分配、类型转换或指针越界错误。Python的语法结构与线性代数公式表述高度贴近。
- NumPy奠定的多维数组标准:NumPy的
ndarray结构统一了学术界连续内存块的步长(strides)、切片与广播机制(Broadcasting)。这一标准化内存抽象,成为日后所有深度学习框架构建张量(Tensor)的共同基石。 - 交互式计算范式的确立(IPython与Jupyter Notebook):科研探索不是一次性运行完的批处理作业,而是高度依赖“假设-切片查看-局部调优-可视化”的探索性反馈循环。Jupyter Notebook允许在保留内存变量上下文的前提下单步运行代码段,极大提升了模型探索的敏捷性。
- 动态计算图与即时执行模式(Eager Execution)的胜利:从早期需要先定义完整静态计算图的Theano和TensorFlow 1.x,转向以PyTorch为代表的动态图机制。原生Python控制流(如简单的
if和for循环)可以直接嵌入前向传播网络,使研究复杂动态架构(如RNN、图神经网络)如同写普通Python脚本一样直观。
# 示例:动态控制流与即时求导的自然融合
import torch

def dynamic_recurrent_block(x, condition_val):
    # 直接使用原生Python分支语句动态改变网络前向图拓扑
    if condition_val > 0.5:
        out = torch.relu(x) * 2.0
    else:
        out = torch.sigmoid(x)
    return out

# 初始化张量并保留梯度追踪
x_tensor = torch.tensor([1.2, -0.8], requires_grad=True)
y_res = dynamic_recurrent_block(x_tensor, 0.8)
loss = y_res.sum()
loss.backward()

# 示例验证:直接读取计算后的真实梯度
print("梯度结果:", x_tensor.grad)  # tensor([2., 0.])
这种与原生Python语法完全一致的体验,让学术界论文在开源代码实现时几乎百分之百选用Python,迅速在CVPR、NeurIPS、ICLR等顶级AI会议上形成了绝对统治地位。
三、工业界的承接:从算法原型到生产落地的平滑转化
如果一种语言仅仅在学术界流行,它可能停留为科研专用工具(如早期的MATLAB)。Python之所以能够进一步在工业生产环境中确立为工业标准,核心在于其完成了从“离线实验”到“在线系统服务”的全链路贯通。
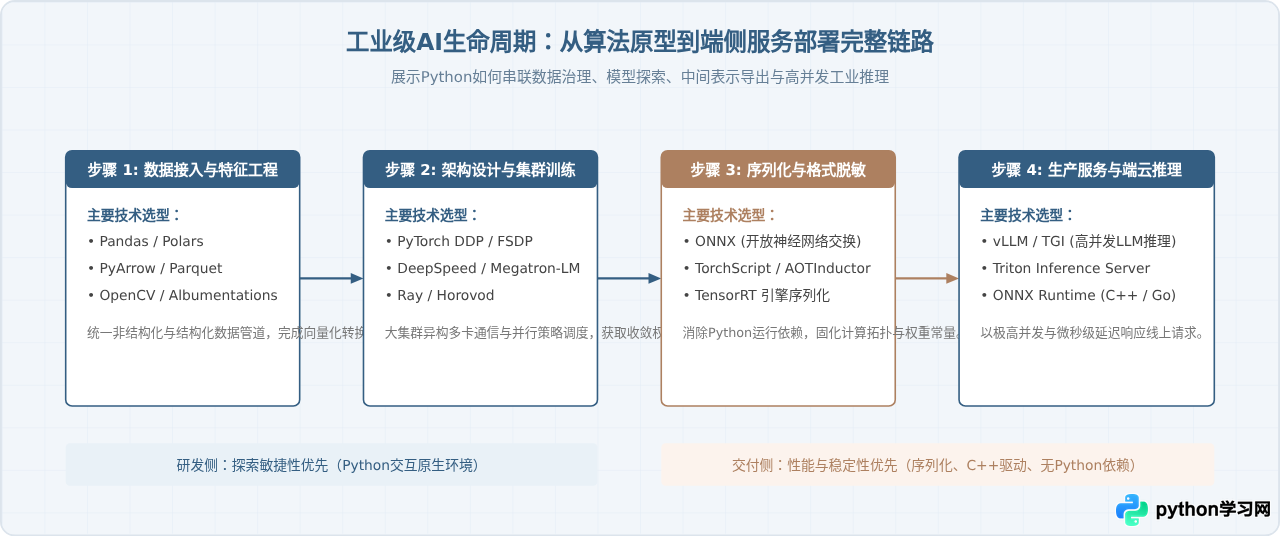
在企业工程实践中,传统痛点在于“算法工程师使用MATLAB或R写出算法原型后,工程部署团队必须用C++或Java完全重写一遍”,重写过程耗费数月甚至引入无数难以对齐的浮点精度偏差。Python生态彻底终结了这一割裂局面:
- 全链路同构语言栈:从数据抽取、特征预处理、模型离线训练到后处理评估,团队无需跨语言切换,沟通与协作成本降至最低。
- 规范化的导出中间表示(IR):模型训练完毕后,通过
torch.onnx.export或torch.compile将静态计算图序列化。生产推理系统可以直接由纯C++引擎(如NVIDIA TensorRT、OpenVINO)加载执行,彻底剥离Python解释器环境。 - 现代微服务化包装:对于大量通用业务场景,通过FastAPI结合异步事件循环,Python即可在单实例上轻松实现数千QPS的请求接入与异步批处理调度(Dynamic Batching),直接支撑生产业务。
四、生态横向对比:Python为何超越竞争语言
在人工智能演进的历史节点上,不仅有Python,还有诸多具备优秀特质的编程语言参与竞争。通过横向对比,可以清晰看到它们在关键维度上的取舍得失:
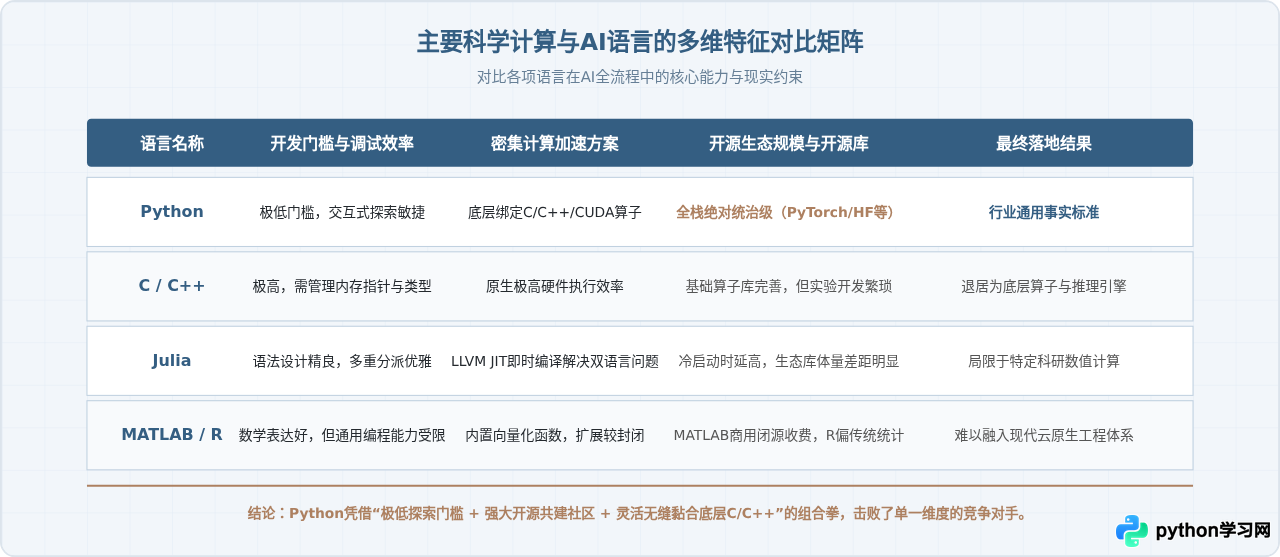
学术界曾提出“双语言问题”——即开发逻辑用动态语言、性能底层用静态语言会导致开发割裂。虽然Julia等语言尝试通过JIT编译在单语言内部彻底解决该问题,但在实际AI工程中,核心算子大多直接面向GPU汇编及专用微架构优化,无论高层采用何种语言,都必须调用芯片厂商高度封闭的特定底层库(如NVIDIA cuDNN)。因此,Python的胶水解耦架构不仅不是缺点,反而契合了硬件厂商各司其职的现实商业逻辑。
五、生态飞轮:正反馈闭环与大模型时代的网络效应
技术特性只是敲门砖,最终把Python推向“无可替代”地位的是强大的“生态网络效应(Network Effect)”。正如Metcalfe定律所揭示的,网络的价值与网络节点数的平方成正比。Python在AI领域构建的生态飞轮如下:
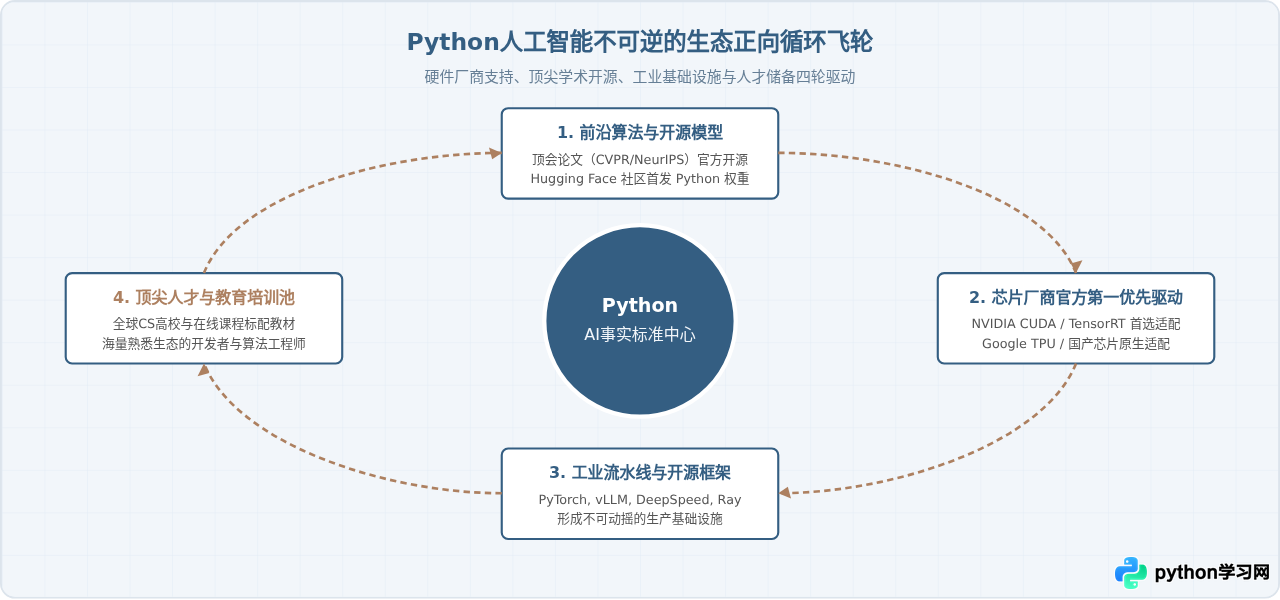
到了如今的大语言模型(LLM)与多模态AI时代,这种生态网络效应不仅没有减弱,反而进一步固化:
- 模型权重的分发中枢:全球最大的模型中心Hugging Face完全以Python为第一核心交互方式。开发者通过
from transformers import AutoModel仅需两行代码便能完成权重加载与推理。 - 算力驱动的研发重心:NVIDIA等芯片巨头推出全新芯片架构时,首要保证的就是PyTorch算子库的即时适配,所有编译器优化、CUDA升级与并行库首先交付给Python接口。
- AI Agent与应用开发生态:以LangChain、LlamaIndex等为代表的上层框架,促使AI正在从单纯的模型演进为具备逻辑调用、工具交互的自主智能体系统,而Python丰富的全栈Web库与爬虫工具,再次成为构建智能体应用的天然土壤。
六、总结与展望
回顾Python成为人工智能领域事实标准的过程,可以清晰地看出其成功的核心逻辑:
- 架构上坚持分层设计:不执着于用单一语言解决所有硬件级优化问题,而是将自身定位为高内聚、低耦合的“指挥调度系统”,将高难度计算沉淀到C/C++/CUDA底层内核。
- 学术到工业的无缝闭环:以极佳的人机可读性降低了前沿科研探索的认知成本,同时通过完善的序列化中间表示(ONNX/TorchScript/TensorRT)填平了通往工业落地的鸿沟。
- 不可逆转的生态飞轮:海量的人才储备、顶会官方开源代码、芯片厂商的战略绑定与模型分发中心,共同构成了其他竞争语言在短期内无法逾越的护城河。
对于技术从业者而言,理解Python在AI领域的这一深层定位,有助于在日常开发中准确划分关注点:在需要业务敏捷与快速试错的上层采用Python,在需要微秒级响应与资源受限的边缘环境利用序列化模型与C++推理引擎,真正发挥整个现代人工智能技术栈的最大威力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















