


怎么构建RAG系统?大模型应用开发中的检索增强实现教程

明明把公司文档都喂给了大模型,问起具体条款它还是在那儿“一本正经地胡说八道”?或者干脆回你一句“知识库中未找到相关信息”?这种尴尬在开发企业级AI助手时太常见了。大模型虽然博学,但它记不住你昨天刚上传的内部手册,这就是所谓的“知识截止”和“幻觉”问题。
解决这个问题的钥匙不是继续微调模型,而是给大模型配一个“外挂硬盘”,也就是检索增强生成(RAG)。别被这个高大上的名字吓到,核心逻辑其实就三步:把文档切碎存进向量库,用户提问时去库里找相关片段,最后把这些片段连同问题一起扔给大模型让它总结。今天我们就跳过那些晦涩的理论,直接看看怎么把这个流程跑通。
1. 把文档切成合适的“知识块”
很多新手最容易踩的坑,就是把整篇PDF直接丢进向量数据库。向量检索靠的是语义相似度,如果一段文字太长,里面混杂了太多无关信息,检索出来的结果就会噪音极大;如果切得太碎,又可能丢失上下文逻辑。
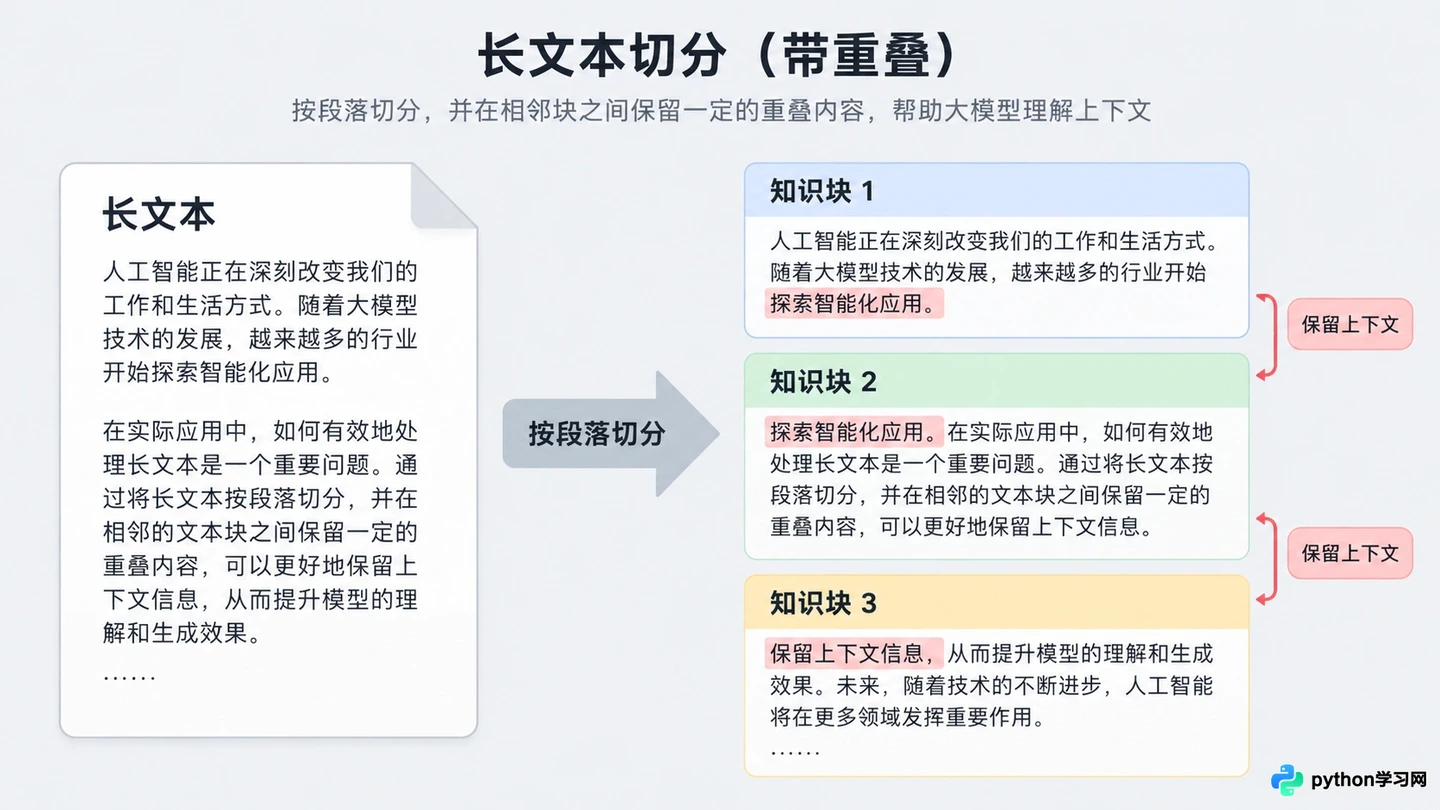
展示文本按段落切割并保留重叠部分的示意图
最稳妥的做法是按“语义完整性”切片。对于技术文档或合同,按章节标题或段落自然断点切割通常效果最好。你可以设置每个切片包含500-800个token,并保留10%-20%的重叠部分。这就像拼图时的边缘重合,能确保即使关键信息正好在两段交界处,也能被完整检索到。记得在切片元数据里打上来源标签,比如页码或文件名,这样最后回答时还能告诉用户“答案出自第几页”,可信度瞬间提升。
2. 选对向量数据库并建立索引
存切片的地方就是向量数据库。市面上选择很多,像轻量级的Chroma、Faiss,或者云原生的Pinecone、Milvus。对于刚开始做原型的朋友,Chroma是个不错的选择,因为它可以本地运行,无需配置复杂的服务器环境。
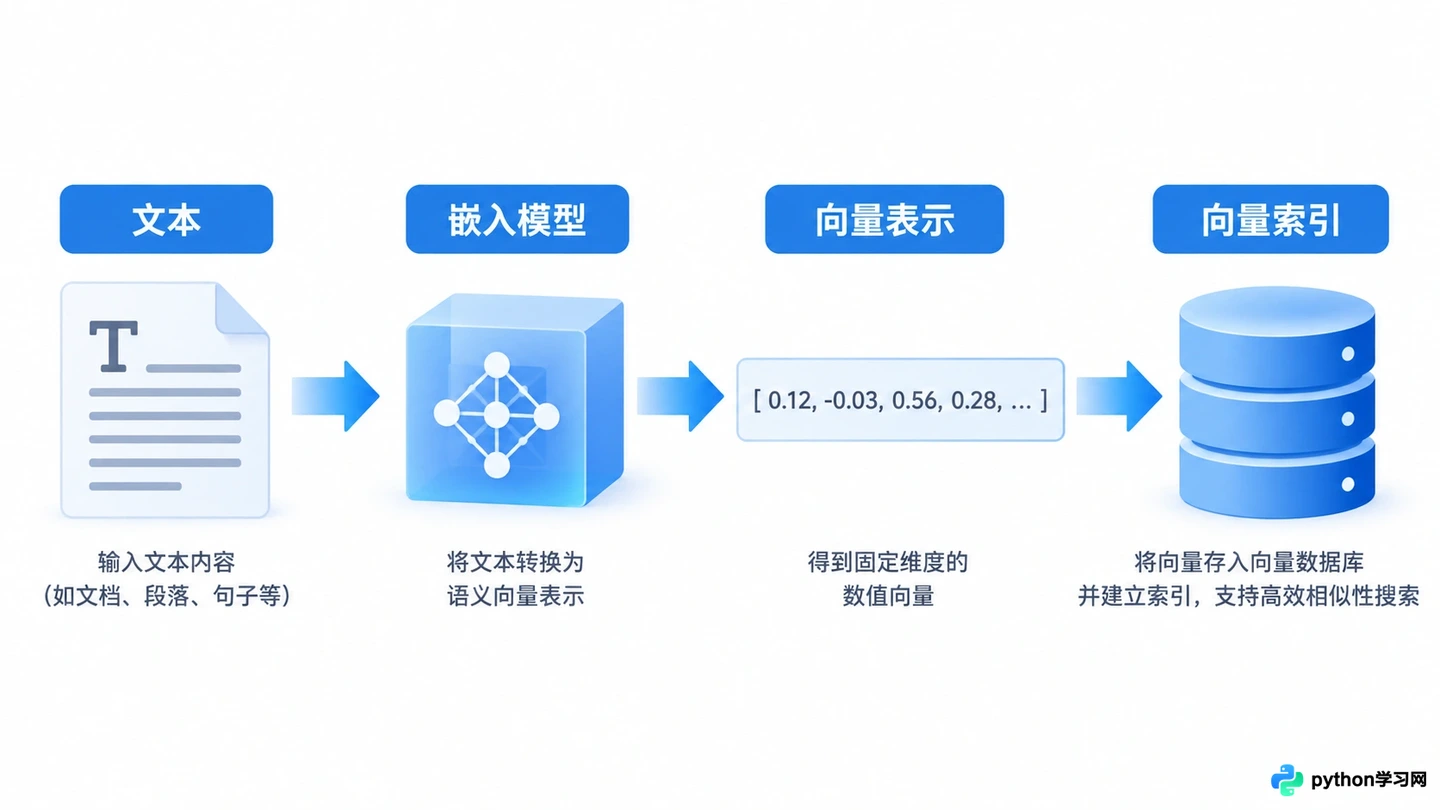
文本转化为向量并存入数据库的流程示意
接入过程并不复杂:首先调用Embedding模型(如text-embedding-ada-002或开源的bge-m3)将文本切片转化为向量数组。这一步是把文字变成计算机能理解的数字坐标。然后,将这些向量和原始文本一起存入数据库。关键在于选择合适的距离度量算法,余弦相似度(Cosine Similarity)通常是最通用的选择,它对文本长度不敏感,能较好地反映语义方向的一致性。存好后,试着用一个简单的关键词搜一下,看看能不能迅速定位到刚才存进去的那段话,这是验证索引是否生效的最快方法。
3. 优化检索策略,拒绝“答非所问”
存好了不代表能搜得准。用户问“怎么报销差旅费”,如果只靠向量相似度,可能会搜出一堆包含“差旅”但讲的是“申请流程”而非“报销标准”的文档。这时候需要引入混合检索或重排序机制。
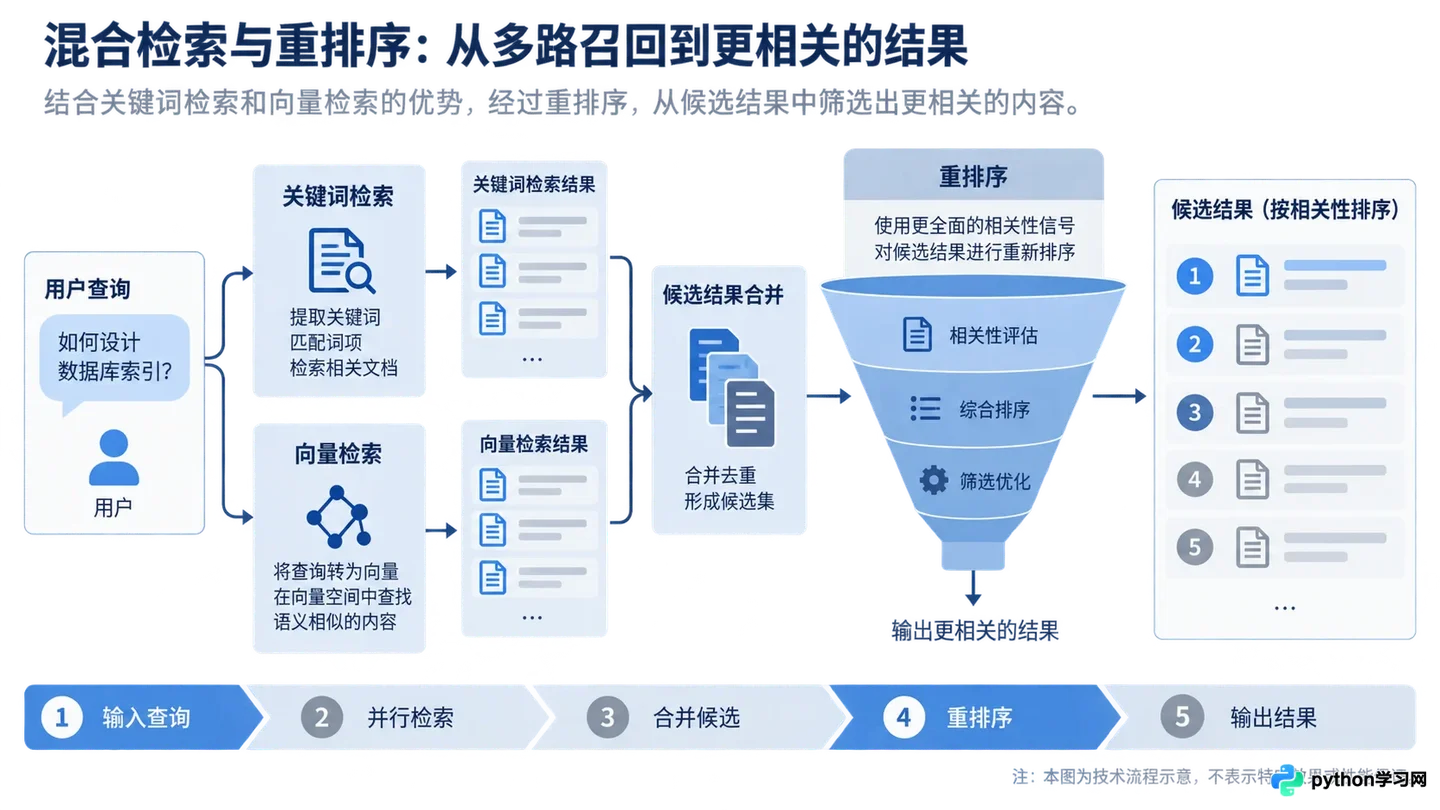
混合检索与重排序机制的工作原理
一个简单的优化技巧是“查询改写”。在真正去向量库搜索前,先让大模型把用户的口语化问题改写成更专业的查询语句。比如把“那个谁欠我钱怎么搞”改写成“个人借款催收法律流程”。此外,可以设置检索返回的前K个结果(Top-K),通常K=3到5比较合适。太少容易漏掉关键信息,太多则会超出大模型的上下文窗口,引入噪音。如果条件允许,加一个Cross-Encoder重排序步骤,对初筛回来的片段进行精细打分,能显著提升最终答案的准确度。
4. 组装提示词,让大模型“看图说话”
最后一步是把检索到的片段和用户问题打包发给大模型。这里的提示词(Prompt)结构非常固定:先给出角色设定,再列出检索到的参考上下文,最后放上用户的问题,并明确要求“仅根据提供的上下文回答”。
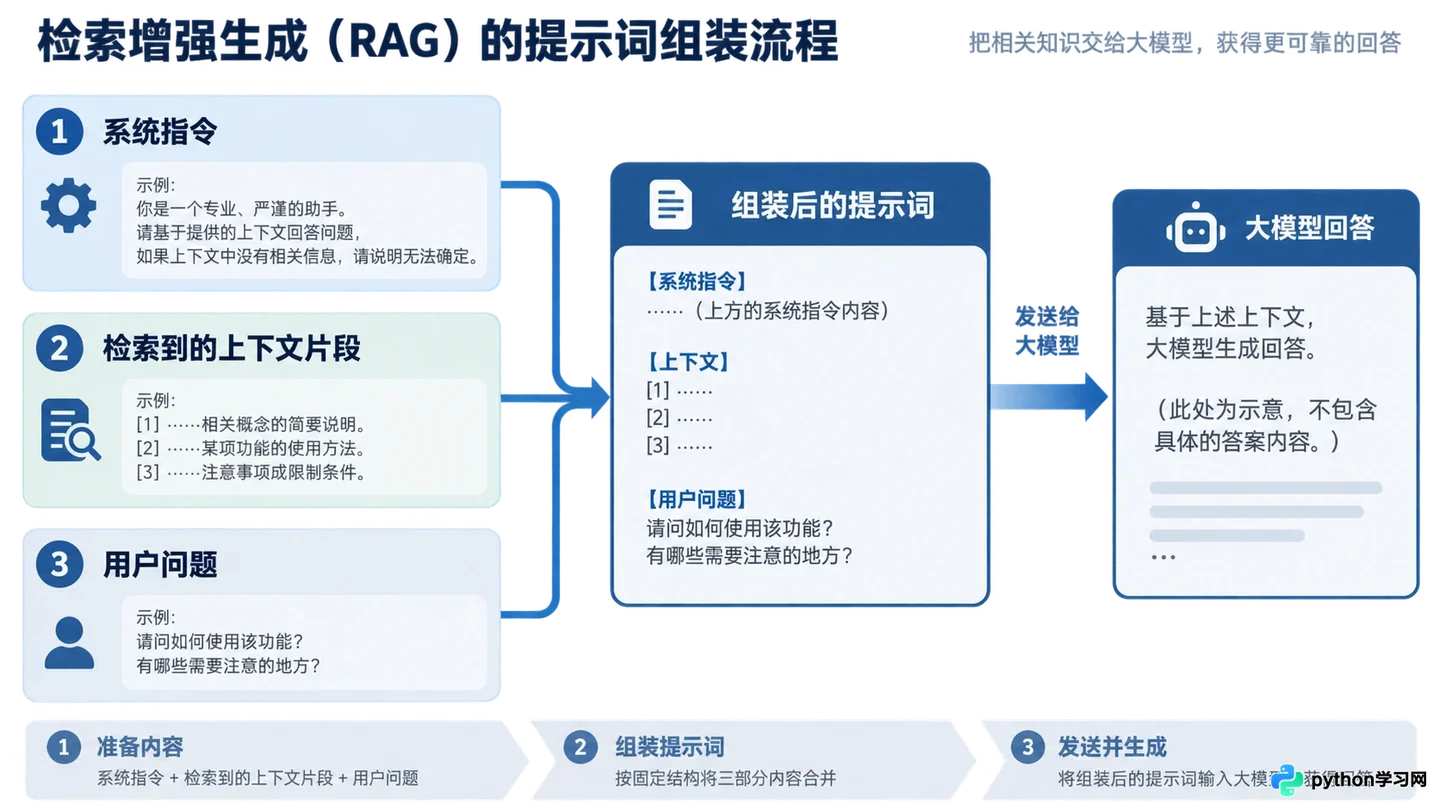
最终发送给大模型的Prompt结构示意
一定要加上约束条件,比如“如果上下文中没有答案,请直接说不知道,不要编造”。这一步是防止幻觉的最后一道防线。当你能看到大模型引用的内容确实来自你的私有文档,且回答逻辑清晰时,这个RAG系统就算初步建成了。接下来要做的,就是不断调整切片大小和检索阈值,在查全率和查准率之间找到那个最佳平衡点。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















