


Python爬虫能用于SEO优化吗?关键词排名与内容策略分析

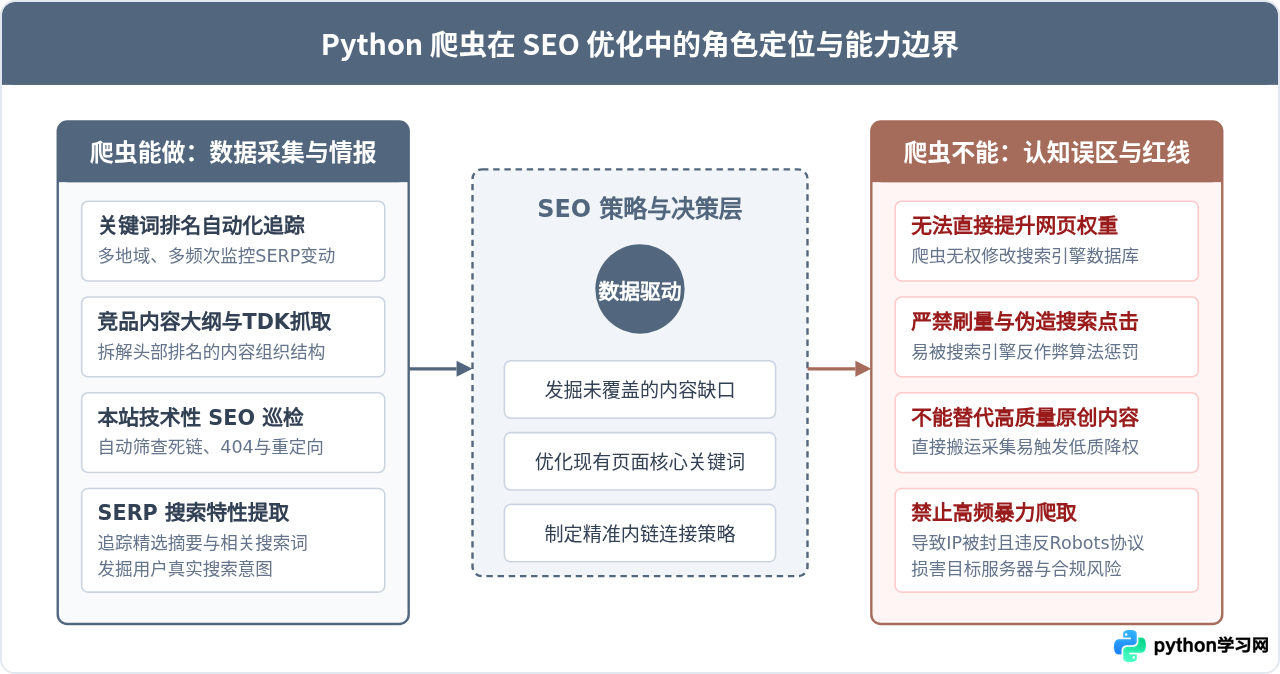
Python爬虫不仅能够用于SEO优化,而且是专业SEO团队构建数据驱动壁垒的核心技术。但它发挥作用的前提是清晰界定其能力边界:爬虫本身绝不会直接让网站排名上升,它无法直接改写搜索引擎算法,更不可用于恶意刷量;它的真正价值在于充当高灵敏度的“数据情报中枢”,通过全自动采集搜索引擎结果页(SERP)追踪自身与竞品的排位轨迹,并逆向解析头部内容结构,为关键词查漏补缺和制定内容策略提供扎实的数据支撑。
一、Python爬虫在SEO中的角色定位与边界界定
很多初学者容易将爬虫与“黑帽作弊”或“快速上位”混为一谈。有人误以为只要写个爬虫疯狂抓取搜索引擎,或者抓取别人网页来批量拼凑伪原创,网站排名就会蹭蹭上涨。这种认知不仅错误,而且会导致严重的搜索引擎惩罚。
在白帽与现代精细化SEO体系中,Python爬虫的角色是极其纯粹的自动化数据采集器与分析管道。它解决的是传统SEO管理中的三个典型瓶颈:人工逐个查词记录费时费力、商业SEO工具更新滞后且数据维度固化、难以全面系统地看清竞争对手的内容大纲编排。
二、核心应用一:自动化关键词排名监控流水线
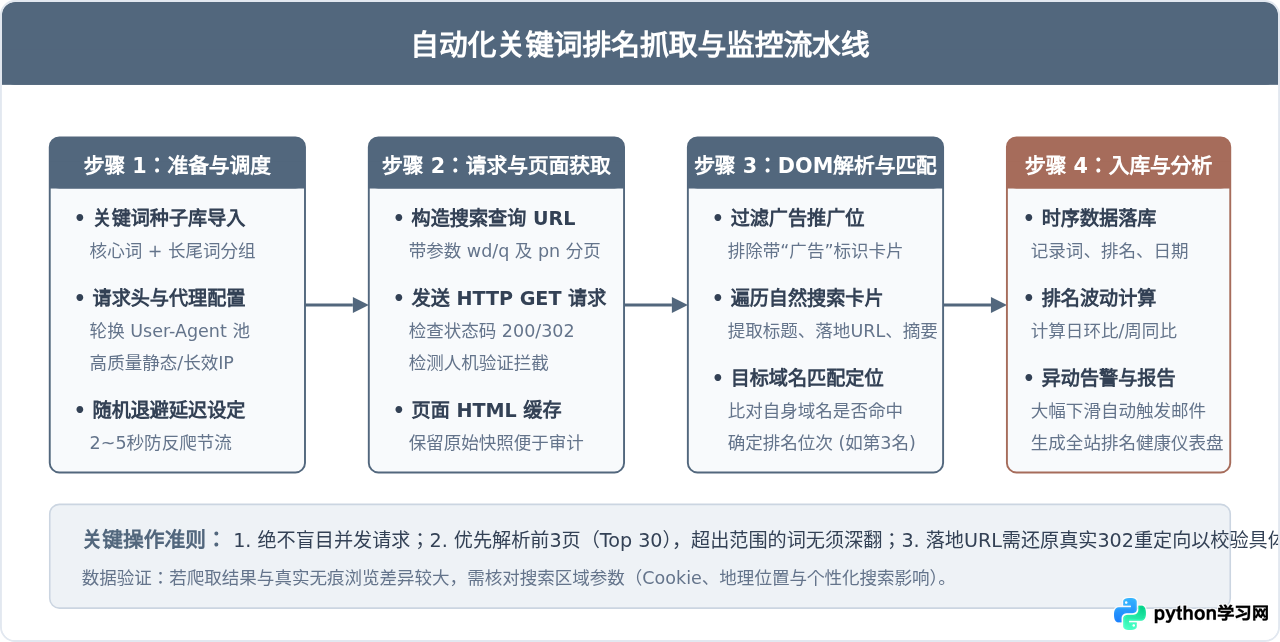
关键词排名是衡量SEO工作成效最直接的晴雨表。如果依靠站长在浏览器无痕模式下一行行输入搜索词、肉眼找寻自己网站所在的位置,当监控词汇量扩展到几百甚至上万个长尾词时,人工操作完全不可行。利用Python爬虫建立常态化的监控脚本,可以在指定时间全自动跑完词库,并将结果存入时序数据库。
核心抓取与匹配代码示例
以下代码展示了一个极简但结构完整的SERP解析器。代码使用标准 requests 发起受控请求,并通过 BeautifulSoup 解析返回的搜索结果条目,提取标题、链接并定位特定目标域名的自然排位。
import time
import random
import requests
from bs4 import BeautifulSoup
from urllib.parse import urlparse

def check_keyword_rank(keyword, target_domain, max_pages=3):
    """
    检查指定关键词下目标域名的自然排名
    :param keyword: 待查询关键词
    :param target_domain: 目标主域名 (如 example.com)
    :param max_pages: 最大翻页深度 (通常前3页共30条足以反映核心表现)
    :return: 匹配到的最好排名及对应页面信息
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                      "(KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    current_rank = 0

    for page in range(max_pages):
        # 此处以典型搜索引擎分页参数为例 (第一页0,第二页10...)
        start = page * 10
        url = f"https://www.example-engine.com/search?q={keyword}&start={start}"

        try:
            response = requests.get(url, headers=headers, timeout=10)
            if response.status_code != 200:
                print(f"[警告] 页面响应异常,状态码: {response.status_code}")
                break

            soup = BeautifulSoup(response.text, "html.parser")

            # 查找所有自然搜索结果容器 (排除广告推广标记)
            result_items = soup.select(".search-result-item:not(.ad-badge)")

            for item in result_items:
                current_rank += 1
                link_tag = item.find("a", href=True)
                title_tag = item.find("h3") or item.find("h2")

                if not link_tag or not title_tag:
                    continue

                raw_url = link_tag["href"]
                title = title_tag.get_text(strip=True)

                # 解析域名比对
                domain = urlparse(raw_url).netloc
                if target_domain in domain:
                    return {
                        "keyword": keyword,
                        "rank": current_rank,
                        "page": page + 1,
                        "title": title,
                        "landing_url": raw_url
                    }

            # 抓取间隔延时,避免频率过高被封
            time.sleep(random.uniform(2.5, 4.5))

        except requests.RequestException as err:
            print(f"[错误] 请求发生网络异常: {err}")
            break

    return {"keyword": keyword, "rank": None, "page": None, "message": "未在前3页中发现该域名"}

# 测试执行
if __name__ == "__main__":
    result = check_keyword_rank("python爬虫技术", "example.com")
    print(f"查询结果: {result}")
三、核心应用二:竞品内容策略反编译与缺口挖掘
SEO优化的本质不仅是让页面加载更快、标签更规范,更关键的是提供比现有搜索结果更全面、更具价值的解答。如果闭门造车,很难知道搜索引擎为什么偏好目前排在第一名的竞品网页。通过Python爬虫抓取排名前列的竞争对手页面,我们可以将它们的内容组织策略进行“反编译”。
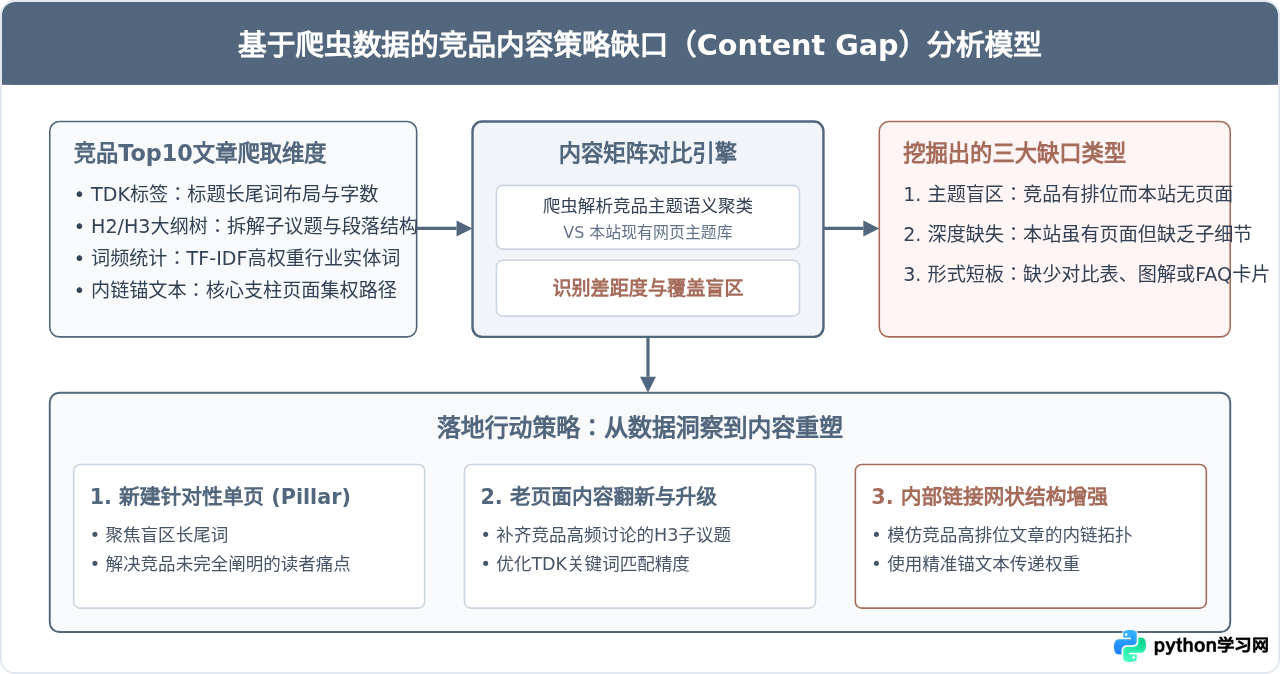
具体而言,爬虫反编译竞品内容主要聚焦以下四个核心信息层:
- TDK标签元数据:观察排名前三的文章在
<title>、<meta name="description">中重点塞入了哪些修饰词与疑问句式,统计其字数长度与主副词排序。 - 层级大纲树(H1-H3):自动遍历提取页面中所有的标题标签。高排名的文章往往具有非常严密的逻辑大纲,例如不仅涵盖“是什么”,还包含“操作步骤”、“报错排查”和“常见问答”。
- 高频实体与语义主题词:将正文剥离HTML标签后,利用 Python 的中文分词工具(如
jieba)结合 TF-IDF 算法,统计排名前列文章普遍覆盖的实体名词与技术专有名词。如果你的文章漏掉了这批高频共性词,搜索引擎很可能会判定你的内容权威度或完整性不足。 - 内部链接锚文本拓扑:爬取页面内部的所有
<a>链接,分析对方将权重集中导入了哪些支柱型产品页或聚合专题页。
四、技术性SEO:用爬虫对本站进行自主健康巡检
除了盯紧外部环境,Python爬虫同样是排查自身网站健康度极其得力的工具。搜索引擎派出的蜘蛛程序(如 Googlebot、Baiduspider)在访问你的网站时,其行为逻辑本质上就是一个深度优先或广度优先的网络爬虫。你可以编写一个以自身首页为起点的递归爬虫,模拟蜘蛛抓取全站,快速排查以下隐患:
- 死链与损坏链接:遍历全站所有超链接,收集所有返回
404 Not Found或500 Internal Server Error的损坏URL,防止搜索引擎蜘蛛因大量死链消耗抓取配额。 - 多层重定向链:排查页面中存在的连续301/302跳跃。重定向链每增加一层,就会降低抓取效率并稀释PageRank权重传递。
- 图片Alt属性缺失:批量提取所有
<img>标签,筛查没有填写alt描述属性的图片,保证无障碍与图片搜索收录。 - 深层无入口页面(孤岛页面):通过爬虫遍历到的页面集合,与网站后台导出的完整数据库文章URL集合进行差集比对,即可找出那些没有任何内链指向的“孤岛页面”。
五、全流程闭环与合规准则
将上述各个模块串联起来,就可以在企业或团队内部构建起一个高效率的SEO智能闭环系统。在这个闭环中,Python爬虫扮演的是“眼睛”的角色,负责捕捉信息波动;而人工编辑与策略人员则根据客观数据做出科学判断,避免了主观盲目猜疑。
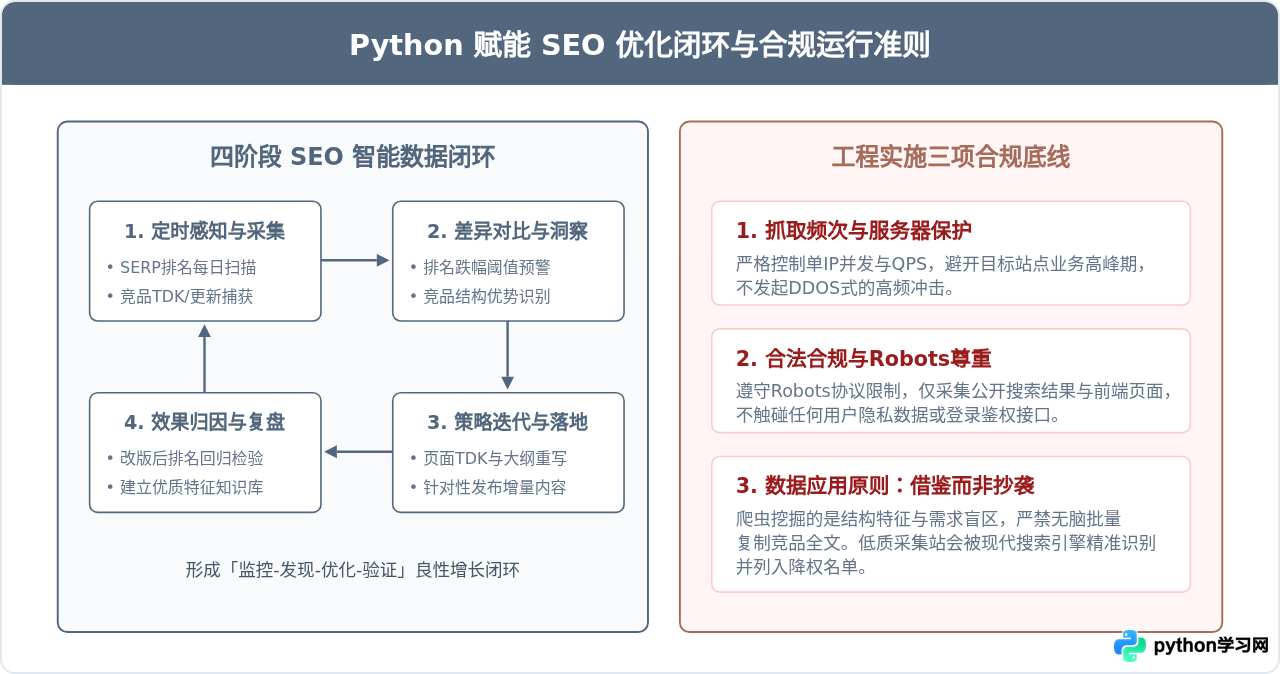
最终需要牢记,无论是多么精密的Python爬虫系统,抓取下来的永远只是冰冷的客观数据。真正决定网站长远搜索表现的,始终是站长能否根据这些数据所反馈的意图缺口,持续产出高质量、有深度且能真正帮读者解决实际问题的原创内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















