


Python中矩阵加法、乘法与点积的代码实现

一、核心概念辨析:矩阵加法、矩阵乘法与点积的区别
初学者在编写数值计算代码时,最常遇到的问题是将逐元素相乘(Hadamard积)、向量点积(Dot Product)与矩阵代数乘法(Matrix Multiplication)混为一谈。理解它们在输入要求与输出维度的根本差异,是写出正确代码的前提。
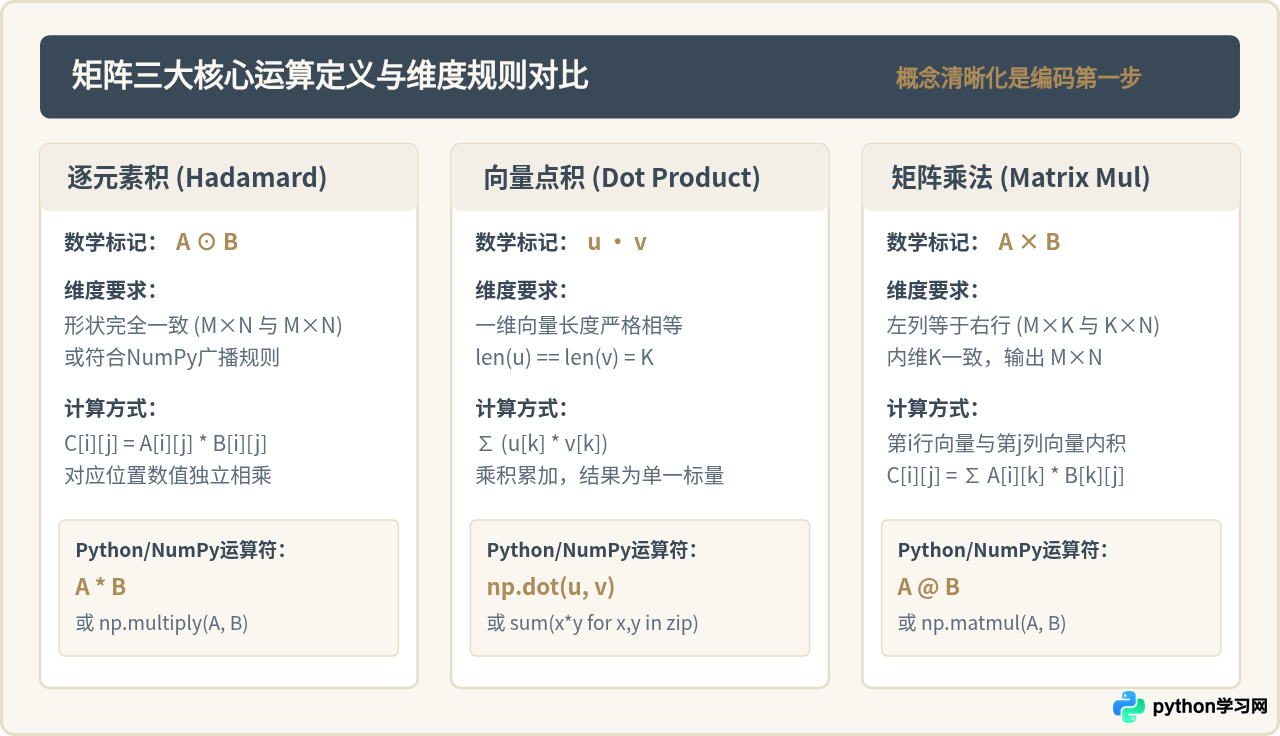
| 运算类型 | 输入对象与维度约束 | 输出结构 | NumPy标准推荐用法 |
|---|---|---|---|
| 矩阵加法 | 两个形状完全一致的矩阵(M×N 与 M×N) | M×N 矩阵 | A + B 或 np.add(A, B) |
| 逐元素相乘 | 两个形状完全一致的矩阵(M×N 与 M×N) | M×N 矩阵 | A * B 或 np.multiply(A, B) |
| 一维点积 | 两个长度相同的1D向量(K 与 K) | 标量(单个数值) | np.dot(u, v) 或 u @ v |
| 二维矩阵乘法 | 左列等于右行(M×K 与 K×N) | M×N 矩阵 | A @ B 或 np.matmul(A, B) |
二、矩阵加法的代码实现与维度规则
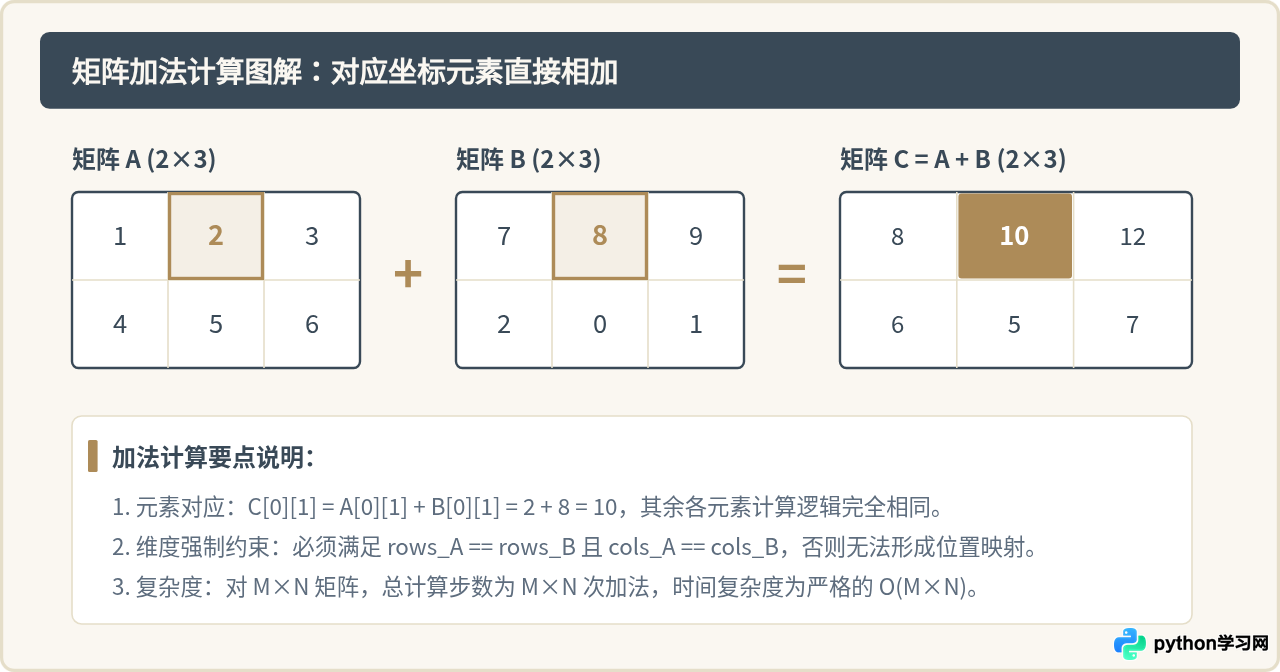
矩阵加法是线性代数中最直观的运算。定义为两个同型矩阵各对应位置数值的直接求和。若两矩阵行数或列数存在任何差异,数学上矩阵加法无定义。
1. 原生 Python 嵌套列表实现
在不引入外部依赖的情况下,Python通常使用二维列表(嵌套列表)来表达矩阵。为保证工程健壮性,在执行加法前必须进行边界校验:检查矩阵非空、各行长度一致性,以及两个矩阵的行数列数是否完全相同。
def matrix_add_native(A, B):
    """
    原生Python实现矩阵加法
    :param A: 二维列表 List[List[float/int]]
    :param B: 二维列表 List[List[float/int]]
    :return: 相加后的新二维列表
    """
    # 基础非空校验
    if not A or not B or not A[0] or not B[0]:
        raise ValueError("输入矩阵不能为空")

    rows_A, cols_A = len(A), len(A[0])
    rows_B, cols_B = len(B), len(B[0])

    # 验证矩形规则性
    if any(len(row) != cols_A for row in A) or any(len(row) != cols_B for row in B):
        raise ValueError("输入矩阵每一行的长度必须保持一致(非规则矩形)")

    # 验证维度一致性
    if rows_A != rows_B or cols_A != cols_B:
        raise ValueError(f"维度不匹配:无法将 ({rows_A}x{cols_A}) 矩阵与 ({rows_B}x{cols_B}) 矩阵相加")

    # 列表推导式构造新矩阵
    return [[A[i][j] + B[i][j] for j in range(cols_A)] for i in range(rows_A)]

# 示例执行与验证
mat_A = [[1, 2, 3], [4, 5, 6]]
mat_B = [[7, 8, 9], [2, 0, 1]]
result_add = matrix_add_native(mat_A, mat_B)
print("原生加法结果示例:", result_add)
# 输出: [[8, 10, 12], [6, 5, 7]]
2. NumPy 高性能实现与广播扩展
使用科学计算库 NumPy 时,矩阵加法通过重载的加号运算符 + 或 np.add() 函数即可完成。NumPy 底层由 C/Fortran 编写,内存连续存放并充分利用 CPU SIMD 指令集。
import numpy as np

arr_A = np.array([[1, 2, 3], [4, 5, 6]])
arr_B = np.array([[7, 8, 9], [2, 0, 1]])

# 方式一:运算符重载(最推荐)
res_np1 = arr_A + arr_B

# 方式二:函数式调用
res_np2 = np.add(arr_A, arr_B)

print("NumPy加法结果示例:\n", res_np1)arr_A.shape == arr_B.shape。
三、矩阵乘法的代码实现与行列内积推导
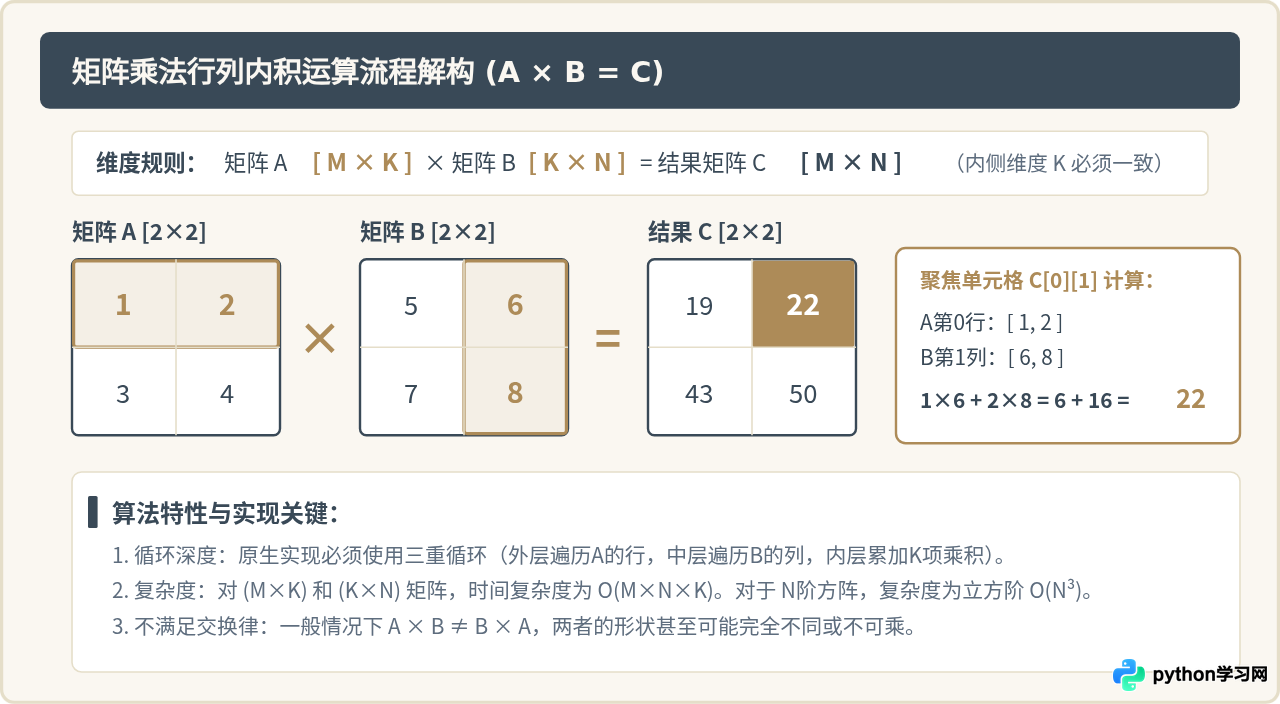
矩阵乘法(Matrix Multiplication)不同于简单的逐元素相乘,它是线性映射的复合。设有矩阵 $A$ 与 $B$,乘积 $C = A \times B$ 成立的充要条件是:左矩阵 $A$ 的列数必须等于右矩阵 $B$ 的行数。
结果矩阵中第 $i$ 行第 $j$ 列的元素 $C_{i,j}$,等于矩阵 $A$ 的第 $i$ 个行向量与矩阵 $B$ 的第 $j$ 个列向量的点积(对应项相乘再求和):
C[i][j] = ∑k=0K-1 (A[i][k] × B[k][j])
1. 原生 Python 三重循环与列表推导式实现
为了直观展现矩阵乘法的数学定义,可以用经典的 Python 三重嵌套循环实现。代码包含严格的内维契合校验。
def matrix_multiply_native(A, B):
    """
    原生Python三重循环实现矩阵乘法
    A: M x K 维矩阵
    B: K x N 维矩阵
    返回: M x N 维矩阵
    """
    if not A or not B or not A[0] or not B[0]:
        raise ValueError("输入矩阵不能为空")

    rows_A, cols_A = len(A), len(A[0])
    rows_B, cols_B = len(B), len(B[0])

    # 核心约束:A的列数必须等于B的行数
    if cols_A != rows_B:
        raise ValueError(
            f"矩阵乘法不可行:左矩阵列数({cols_A})不等于右矩阵行数({rows_B})"
        )

    # 初始化 M x N 零矩阵
    result = [[0 for _ in range(cols_B)] for _ in range(rows_A)]

    # 三重循环计算行列内积
    for i in range(rows_A):
        for j in range(cols_B):
            # 累加第 i 行与第 j 列对应项乘积
            total = 0
            for k in range(cols_A):
                total += A[i][k] * B[k][j]
            result[i][j] = total

    return result

# 示例验证
A = [[1, 2], [3, 4]]
B = [[5, 6], [7, 8]]
mul_res = matrix_multiply_native(A, B)
print("原生矩阵乘法结果示例:", mul_res)
# 输出: [[19, 22], [43, 50]]
2. 原生 Python 使用 zip(*) 提取转置列的高效写法
在 Python 中,通过 zip(*B) 可以极其轻巧地解包获取矩阵 $B$ 的转置(即直接提取列向量)。这样便可以将内层循环转换为行向量与列向量的点积计算:
def matrix_multiply_zip(A, B):
    """利用 zip(*) 转置右矩阵,提取列向量加速内积计算"""
    if len(A[0]) != len(B):
        raise ValueError("左矩阵列数与右矩阵行数不一致")

    # zip(*B) 获取 B 的所有列
    cols_B = list(zip(*B))

    # 直接计算每行与每列的向量点积
    return [[sum(a * b for a, b in zip(row_A, col_B)) for col_B in cols_B] for row_A in A]

print("zip(*)推导结果示例:", matrix_multiply_zip(A, B))
3. NumPy 现代标准:使用 @ 操作符与 np.matmul
自 Python 3.5 引入 PEP 465 以来,Python 官方正式为矩阵乘法分配了专用二元中缀运算符 @。在现代工程实践中,推荐优先使用 @,次选 np.matmul()。
import numpy as np

np_A = np.array([[1, 2], [3, 4]])
np_B = np.array([[5, 6], [7, 8]])

# 方式一:推荐中缀操作符 @(PEP 465)
res_at = np_A @ np_B

# 方式二:函数调用 np.matmul
res_matmul = np.matmul(np_A, np_B)

print("NumPy @ 矩阵乘法输出示例:\n", res_at)
# 输出:
# [[19 22]
#  [43 50]]
四、点积与逐元素乘积(Hadamard积)的代码实现与API细节
在工程与数学文献中,“点积”一词常常被泛化,但在代码实现层面必须严格区分其具体语义:
- 一维向量点积(Vector Dot Product):输入为两个同维度的 1D 数组,运算为各分量相乘后求和,产物为单个标量。
- 逐元素相乘(Hadamard Product / Element-wise Product):输入为形状相同的数组,对应位置直接相乘,不求和,产物形状与原数组相同。
- 二维场景下的 np.dot 与 @ 的等价与分支:在处理 2D 矩阵时,
np.dot(A, B)与np.matmul(A, B)/A @ B产生完全相同的矩阵乘法结果;但当输入维度大于2(张量运算)时,两者的广播与轴匹配逻辑存在明显差异。
1. 一维向量点积的代码实现
# 原生 Python 列表点积
def vector_dot_native(u, v):
    if len(u) != len(v):
        raise ValueError(f"向量长度不一致:len(u)={len(u)}, len(v)={len(v)}")
    return sum(x * y for x, y in zip(u, v))

vec_u = [1, 2, 3]
vec_v = [4, 5, 6]
print("原生一维点积结果示例:", vector_dot_native(vec_u, vec_v))
# 计算过程: 1*4 + 2*5 + 3*6 = 4 + 10 + 18 = 32

# NumPy 实现
import numpy as np
u_arr = np.array([1, 2, 3])
v_arr = np.array([4, 5, 6])

dot_res = np.dot(u_arr, v_arr)  # 或 u_arr @ v_arr
print("NumPy一维点积结果示例:", dot_res)  # 输出: 32
2. 逐元素乘积(Hadamard积)的代码实现
# 原生 Python 嵌套列表逐元素相乘
def matrix_hadamard_native(A, B):
    if len(A) != len(B) or len(A[0]) != len(B[0]):
        raise ValueError("矩阵维度必须完全一致")
    return [[A[i][j] * B[i][j] for j in range(len(A[0]))] for i in range(len(A))]

A = [[1, 2], [3, 4]]
B = [[5, 6], [7, 8]]
print("原生逐元素乘积结果示例:", matrix_hadamard_native(A, B))
# 输出: [[5, 12], [21, 32]]

# NumPy 实现(使用星号 * 运算符)
np_A = np.array(A)
np_B = np.array(B)
hadamard_np = np_A * np_B  # 等价于 np.multiply(np_A, np_B)
print("NumPy星号(*)逐元素乘积结果示例:\n", hadamard_np)
# 输出:
# [[ 5 12]
# [21 32]]* 表示矩阵代数乘法,.* 表示逐元素相乘;而在 Python / NumPy 中正好相反,* 表示逐元素乘积,而代数矩阵乘法必须使用 @ 或 np.matmul。从其他语言转入 Python 的开发者极易在此处引入静默逻辑错误。
五、常见异常排查与工程实践建议
在实际工程和调试过程中,矩阵计算报错多由维度不匹配或符号混淆引起。掌握快速定位错误和技术选型路径能够大幅提升排错效率。
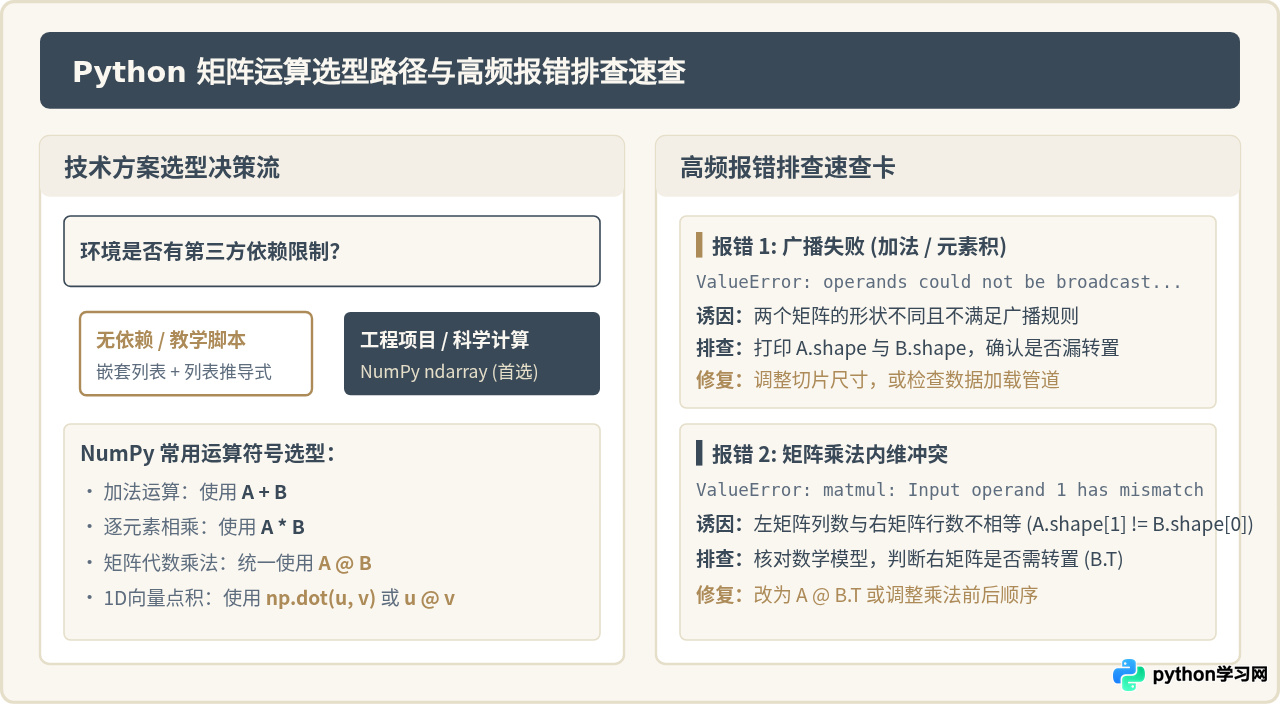
常见排错实录
- 问题一:
IndexError: list index out of range(原生实现)
通常是因为嵌套列表不是严整的矩形(例如某一行缺失元素,即所谓的“不规则列表”Ragged List),在双重循环按固定列数索引时越界。建议在运算前显式验证all(len(r) == cols for r in matrix)。 - 问题二:混用
*与@导致静默逻辑 Bug
当两个方阵尺寸相同时(如都是 $3 \times 3$),A * B与A @ B都能顺利执行,程序不会抛出任何异常,但计算出来的数值完全不同。在涉及权重更新或坐标变换时,务必反复确认数学本质是逐元素权重掩码还是线性变换复合。
六、全文总结
本文系统梳理了 Python 中矩阵加法、乘法与点积的数学根基与实现方案:
- 矩阵加法:要求形状完全对齐,按坐标逐元素累加。原生通过二维列表推导式实现,NumPy 中直接使用
+或np.add。 - 矩阵乘法:必须满足内维对齐(左列等于右行),基于行列内积展开。原生实现需三重循环,NumPy 首推 PEP 465 规范的
@中缀运算符。 - 点积与Hadamard积:1D向量点积使用
np.dot()输出标量;逐元素矩阵相乘使用*输出同型矩阵;二维方阵代数乘法应统一采用@。 - 生产工程建议:除算法教学与无依赖轻量环境外,生产场景应全面采用 NumPy。其底层高度优化的 BLAS/LAPACK 库能带来数十至上百倍的计算吞吐提升,并天然规避原生指针链表所致的内存碎片问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















