


Python数据分析怎么学?新手必备的学习路线与资源推荐

一、四阶段学习路线规划
新手常犯的错误是一开始就购买厚重的高级编程书,花费数月去死磕面向对象继承、装饰器、多线程或网络爬虫底层原理,结果迟迟无法处理一张真实的Excel表格。实际上,数据分析对代码的诉求主要集中在数据结构的读取、过滤、切片与统计上。将整个学习周期拆解为循序渐进的四个阶段,能够清晰把握各阶段重点与时间分配。
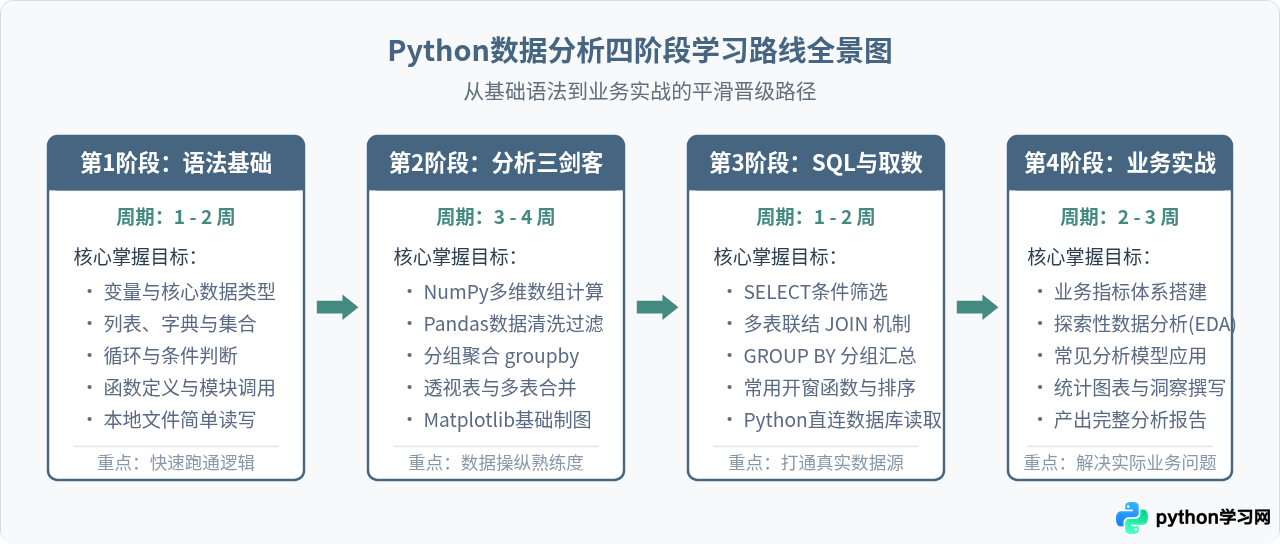
1. 第一阶段:Python基础语法精要(1 - 2 周)
这个阶段的目标不是成为全栈工程师,而是能够编写简单的数据处理脚本。重点聚焦在以下几个概念:
- 基本数据类型:整数(
int)、浮点数(float)、字符串(str)和布尔值(bool),掌握类型转换规则。 - 核心容器操作:列表(
list)与字典(dict)。数据分析中的表格在本质上就是嵌套的字典或列表,熟练掌握键值检索、列表切片和列表推导式至关重要。 - 流程控制:
if-elif-else分支判断与for循环,学会根据业务条件对变量打标。 - 函数与模块:学会使用
def定义函数封装重复的数据转换逻辑,并能使用import引入外部工具包。
2. 第二阶段:核心工具库“三剑客”(3 - 4 周)
该阶段是技术能力的基石。Pandas 是绝对的核心,日常分析中超过70%的代码都在调用 Pandas 的 API;NumPy 提供底层的数组矩阵计算支撑;Matplotlib 与 Seaborn 则负责将数据以图表形式表达出来。
3. 第三阶段:SQL取数与数据库协作(1 - 2 周)
真实企业场景中,分析师极少拿到现成的单张洁净 CSV 文件,海量业务日志存放在 MySQL、PostgreSQL 或企业数据仓库中。新手必须掌握基本的 SQL 查询语句(SELECT ... WHERE ... GROUP BY ... HAVING ... JOIN),并学会使用 Python 的 sqlalchemy 或内置连接驱动将查询结果直接注入 Pandas 的 DataFrame 中。
4. 第四阶段:业务指标理解与项目实战(2 - 3 周)
工具熟练后,脱离业务依然无法产生价值。通过实际项目训练“业务敏锐度”,例如电商用户留存分析(Cohort Analysis)、用户价值分类(RFM模型)、流量转化漏斗等。在项目中综合演练数据清洗、探索性分析(EDA)以及报告撰写。
二、Python数据分析技术栈与协作体系
理解各个技术组件的分工,可以避免工具选型上的混乱。Python数据分析生态是一个上下游分工明确的流水线结构,各个库各司其职又紧密配合。
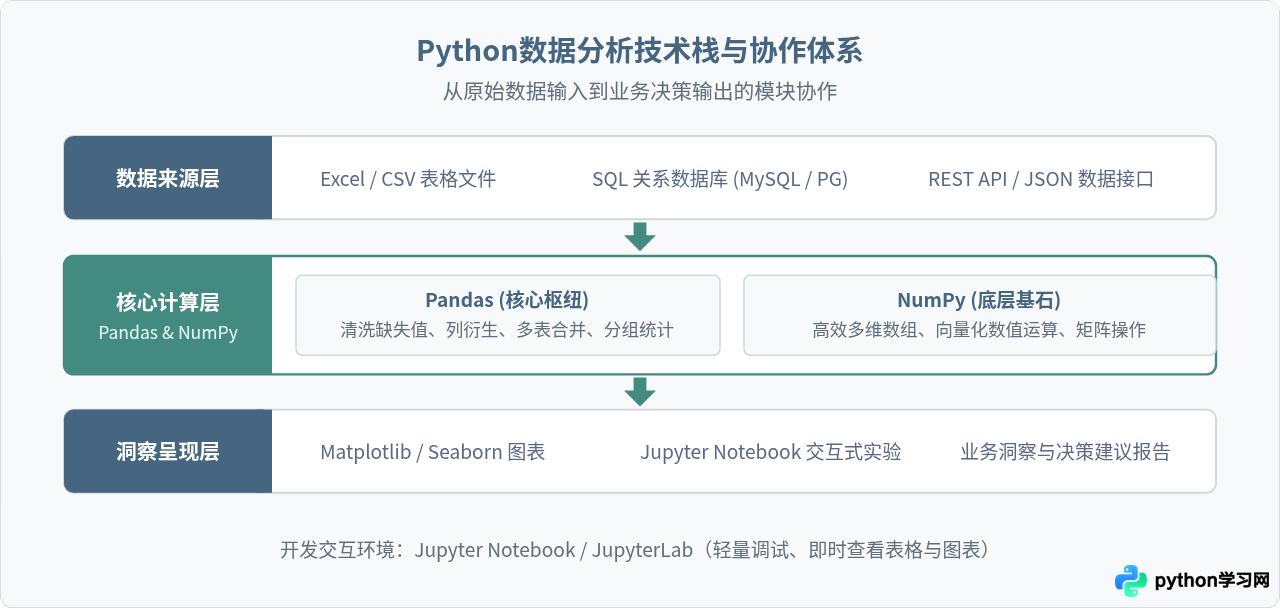
开发环境选择:强烈建议新手使用 Jupyter Notebook 或 JupyterLab 作为主要分析环境,而不是传统的 PyCharm 或 VS Code 纯脚本运行模式。Jupyter 支持“分块运行(Cell-by-cell)”,每次对表格执行一次过滤或聚合,都能在下方直接看到表格当前的前五行(head()),极大降低了排错与心智负担。
三、标准数据分析实战闭环工作流
一次规范的数据分析任务通常由五个明确的步骤组成:明确业务目标、提取数据、清洗加工、探索性分析(EDA)以及输出结论与建议。
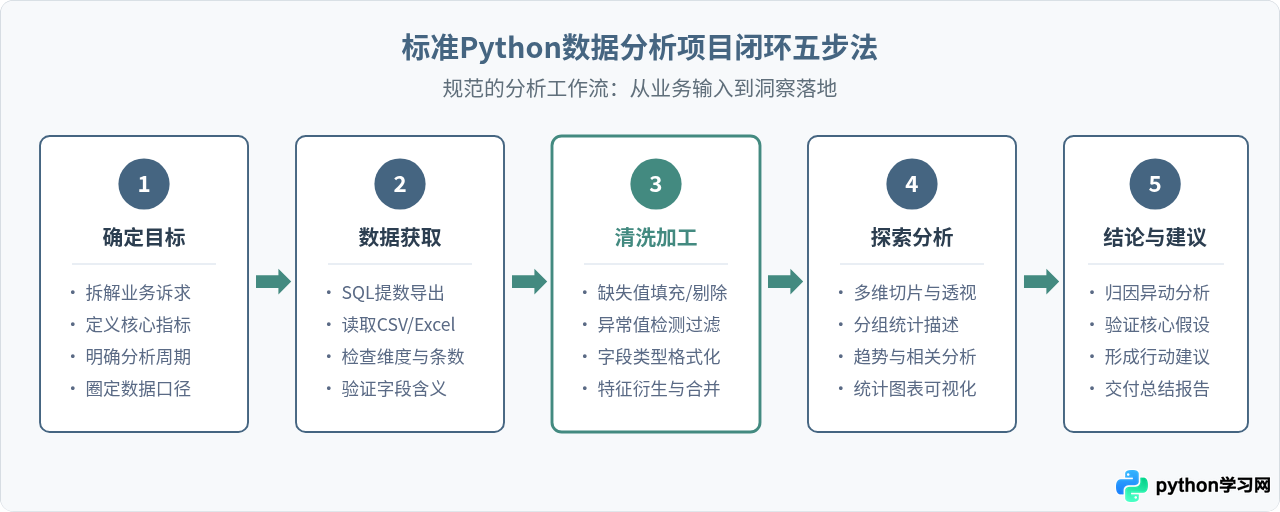
实战代码示例:电商订单数据聚合与分析
为了直观感受 Pandas 的具体工作方式,以下展示一段标准的数据清洗与统计代码。示例环境为 Python 3.8+,需安装 pandas 库。
import pandas as pd

# 1. 模拟读取原始订单数据
raw_data = {
    'order_id': ['A101', 'A102', 'A103', 'A104', 'A105', 'A106'],
    'category': ['电子产品', '日用百货', '电子产品', '图书文具', '日用百货', None],
    'amount': [1299.0, 58.5, None, 120.0, 89.0, 450.0],
    'order_date': ['2026-03-01', '2026-03-01', '2026-03-02', '2026-03-02', '2026-03-03', '2026-03-03']
}
df = pd.DataFrame(raw_data)

# 2. 数据清洗:处理缺失值与日期类型格式化
# 剔除类别或金额为空的异常行
clean_df = df.dropna(subset=['category', 'amount']).copy()
# 转换日期字段格式
clean_df['order_date'] = pd.to_datetime(clean_df['order_date'])

# 3. 探索性分析:按商品品类分组,统计订单量与总销售额
summary = clean_df.groupby('category')['amount'].agg(
    order_count='count',
    total_sales='sum',
    avg_order_value='mean'
).reset_index()

# 4. 格式化数值以便阅读
summary['avg_order_value'] = summary['avg_order_value'].round(2)
print("=== 品类销售统计汇总表 ===")
print(summary)
示例输出结果说明:
=== 品类销售统计汇总表 ===
   category  order_count  total_sales  avg_order_value
0      图书文具            1        120.0           120.00
1      日用百货            2        147.5            73.75
2      电子产品            1       1299.0          1299.00
在执行切片赋值或清洗操作时,推荐加上 .copy() 显式创建副本,能彻底避免常见的 SettingWithCopyWarning 警告。在分组统计时,使用具名聚合语法 .agg(新列名=('目标列', '计算方法')) 可以一次性产出规整的二维表,极大提升代码可读性。
四、新手必备资源推荐与避坑矩阵
学习资料不在于多,而在于形成体系。资料过多反而会产生“收藏夹膨胀”却迟迟不行动的信息过载。以下将高性价比的学习工具与最容易踩坑的误区整理成对照矩阵。
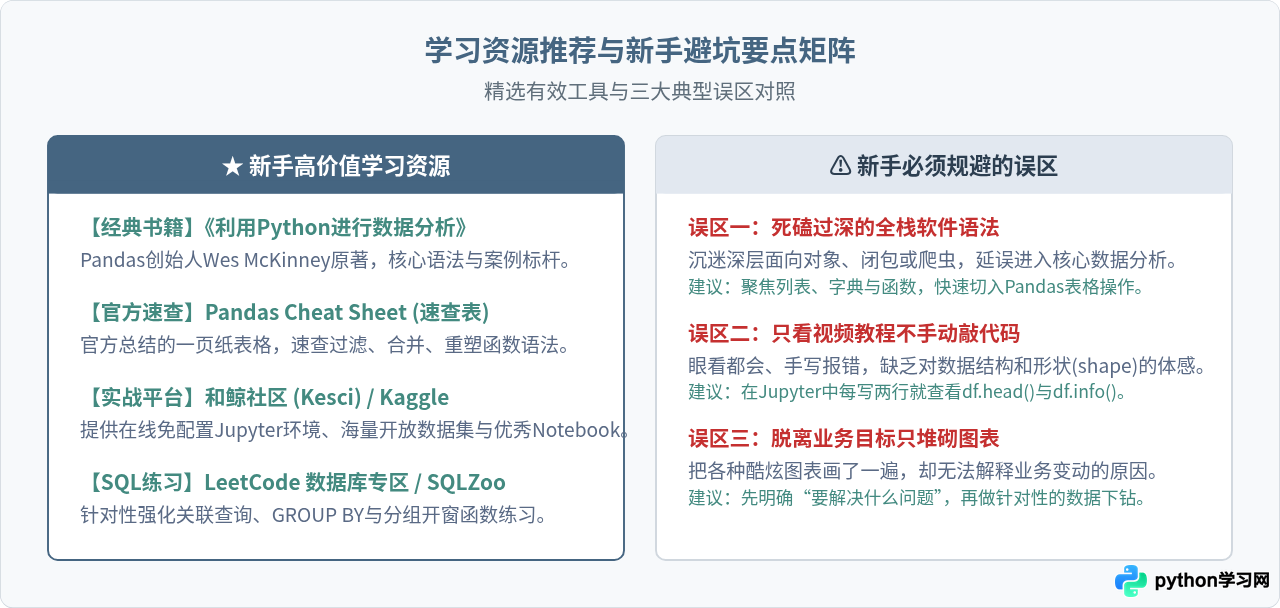
1. 核心资源详细推荐
- 推荐书籍:《Python for Data Analysis》(中文名《利用Python进行数据分析》,目前已出至第3版)。由 Pandas 库的原作者 Wes McKinney 撰写,是业内公认的经典教材,全书以实际数据集为贯穿主线,非常适合配合 Jupyter Notebook 边读边敲。
- 速查卡工具:Pandas 官方提供的 Pandas Cheat Sheet(速查表)。将常用的数据切片、透视、合并函数高度浓缩在一张 PDF 中,写代码遇到遗忘的参数时随手查阅,无需频繁搜索引擎检索。
- 免配置实战平台:和鲸社区(Kesci)或 Kaggle。新手在本地安装 Python 与各类依赖库时经常遭遇环境与版本冲突,这类平台提供开箱即用的在线 Jupyter 环境,同时附带了丰富的真实业务数据集与高赞分析项目源码,是极佳的练习场。
- SQL 与题库练习:SQLZoo 适合零基础交互式通关学习;LeetCode 的 Database 模块则适合针对性练习窗口函数(如
ROW_NUMBER()、RANK())与多表关联查询。
2. 新手避坑与落地建议
掌握代码语法只是数据分析的敲门砖,决定分析质量的往往是指标思维。每次面对一份新数据时,建议先问自己三个问题:
- 这份数据由哪些维度(如时间、地区、品类)和哪些度量(如金额、点击量、耗时)构成?
- 当前的异常表现(如某天下跌了20%)可能由哪个细分维度的异动引起?
- 分析得出的结论,能否给业务部门提供明确的执行建议?
带着这三个问题去编写过滤、分组和透视代码,数据分析技能才能真正转化为解决实际问题的战斗力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















