


Python可变序列与不可变序列的区别及选择建议

在 Python 中,序列(Sequence)是按固定次序存储元素的数据结构,核心代表包括列表、元组、字符串以及字节序列。理解序列分类的关键在于可变性(Mutability):可变序列(如 list、bytearray)创建后允许在同一内存地址上就地修改其长度与内容;不可变序列(如 tuple、str、bytes)一旦初始化,其槽位所引用的内存对象便永久固定,任何形式的变更都会派生出全新的对象。开发时究竟该选哪一种,取决于数据是否需要频繁变更、是否用作散列表(字典键或集合元素)的查找基准,以及系统对数据防篡改与并发安全的具体要求。
一、核心认知:内存行为与身份一致性
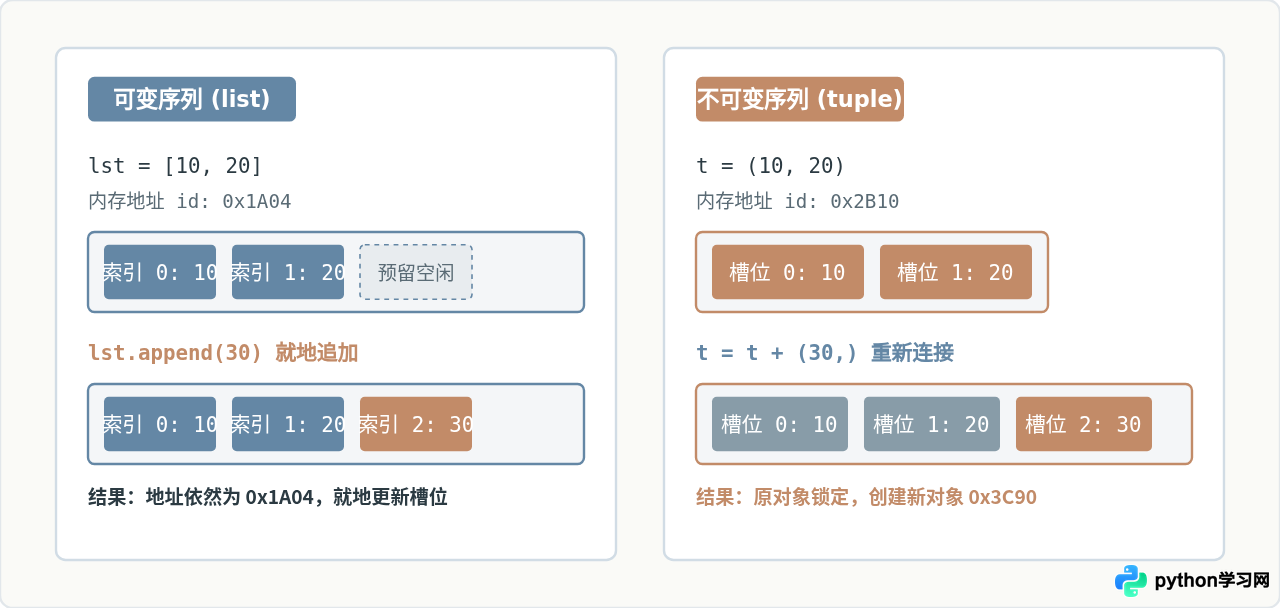
判断一个对象是否可变,最直观的检验方式是观察数据修改前后对象的唯一身份标识 id() 是否保持一致。在 CPython 实现中,id(obj) 代表对象在内存中的实际地址。
# 可变序列示例(list)
lst = [10, 20]
original_id = id(lst)
lst.append(30)
print(id(lst) == original_id)  # 输出:True,原地址上原地扩容

# 不可变序列示例(tuple)
tup = (10, 20)
original_tup_id = id(tup)
tup = tup + (30,)
print(id(tup) == original_tup_id)  # 输出:False,原元组未变,创建了新元组
当执行 lst.append(30) 时,Python 底层修改的是列表内部的指针数组,变量 lst 所指向的容器实体未发生迁移。而执行 tup + (30,) 时,底层无法改写元组的固定存储单元,解释器会新申请一块容纳 3 个指针的内存块,完成浅拷贝后将新指针赋予变量 tup,旧元组如果没有其他引用则进入垃圾回收。
进阶边界注意:包含可变对象的不可变序列
元组的“不可变”仅指元组物理槽位中保存的对象引用(指针)不可改写。如果元组内包含了一个列表元素,例如 item = (1, [2, 3]),虽然你不能将 item[1] 重新赋值给其他对象(会引发 TypeError),但可以通过 item[1].append(4) 修改该列表的内部数据。此时元组的哈希性也会随之失效。
二、哈希性与字典键/集合元素支持
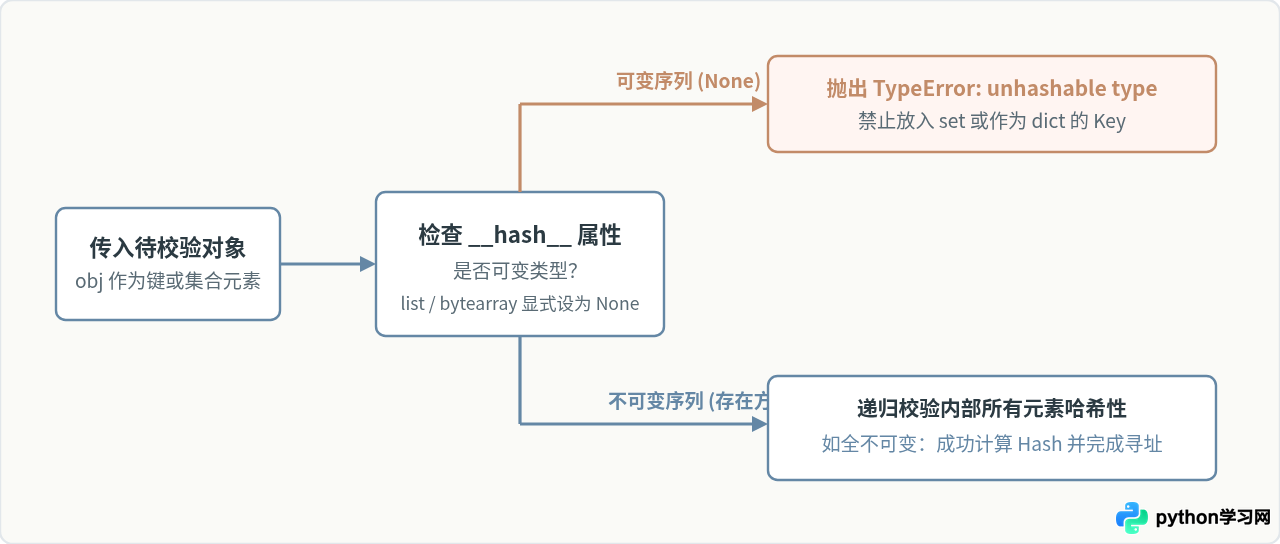
Python 中只有可哈希对象(Hashable)才能作为字典的键(Key)或集合的元素(Set Element)。散列表结构要求对象的生命周期内哈希值始终恒定不变,并且能够通过 __eq__() 进行判等。
- 不可变序列:通常具备原生
__hash__()实现。例如str、bytes以及所有元素均为可哈希对象的tuple都可以安全计算散列值。 - 可变序列:如
list与bytearray,其__hash__属性被显式设置为None。如果尝试将其放入集合或作为键,解释器会立即抛出TypeError: unhashable type: 'list'。
三、底层性能与内存开销剖析
除了功能维度的差异,二者在底层 CPython 架构中的内存利用率和分配效率也存在显著区别:
1. 内存过量分配机制(Over-allocation)
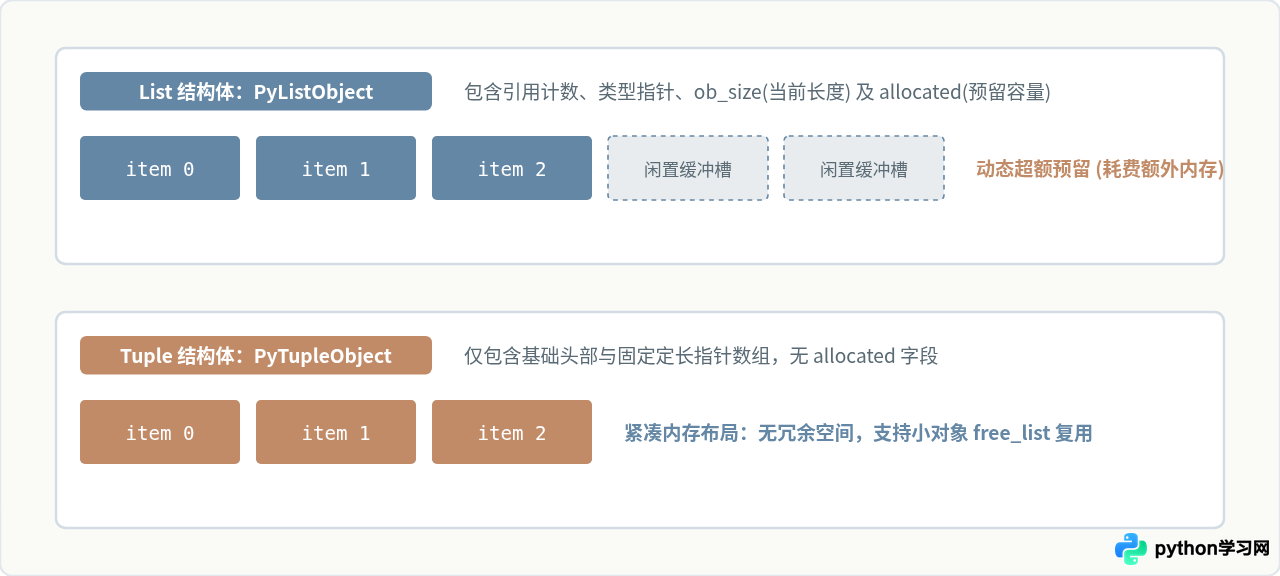
list 作为动态数组,为了保证每次执行 append() 的平摊时间复杂度达到 O(1),采用了过量分配策略。当底层数组容量耗尽时,CPython 会分配比当前所需更多的连续槽位(遵循公式 new_allocated = (newsize >> 3) + (newsize < 9 ? 3 : 6) + newsize)。这意味着列表中经常存在未被使用的空白指针槽,带来额外的常驻内存占用。
相反,tuple 是固定长度的容器。创建时根据元素确切数量一次性精准分配连续内存空间,不包含任何预留指针槽位,因此元组的内存开销始终小于同等元素数量的列表。
2. 自由列表(Free List)与小对象复用
CPython 运行时对长度小于等于 20 的元组实现了 free_list 机制。当一个短元组被销毁时,其占据的内存块不会立即归还给操作系统内核,而是挂载在内部链表上供后续相同长度的元组快速复用。因此,频繁创建和销毁小型元组的开销显著低于列表。
四、工程实战选择建议与避坑指南
在实际编码与架构设计中,面对具体的数据处理需求,可以依据以下规则进行选型:
1. 优先使用不可变序列(tuple, str, bytes)的场景
- 函数的多元返回值:如
return lat, lon,语义上代表不可分割的一条完整记录。 - 字典键与集合容器:例如组合主键
cache[(user_id, date)],利用元组的可哈希性提供高效率散列映射。 - 不可变常量配置:模块内部的全局白名单、状态码枚举列表,使用元组能避免在代码其他位置被意外
pop()或修改。 - 只读多线程共享:不可变对象天然具备只读特性,多线程并发读取时无需加锁,规避数据竞争风险。
2. 明确使用可变序列(list, bytearray)的场景
- 流式数据收集与动态容器:从文件或网络连接分批读取数据行、增量添加项(
append、extend)。 - 就地排序与反转:数据量庞大时,使用
lst.sort()和lst.reverse()能避免额外生成整份新数据的内存翻倍。 - 二进制流的原地拼接修改:处理图像编解码或底层协议帧组装时,使用
bytearray代替bytes,可极大减少字符串拼接产生的大量短生命周期垃圾对象。
3. 常见陷阱警示:可变默认参数
# 典型危险代码
def collect_data(item, container=[]):
    container.append(item)
    return container

# 正确写法:使用不可变哨兵值 None
def collect_data(item, container=None):
    if container is None:
        container = []
    container.append(item)
    return container
在 Python 中,函数的默认参数在模块加载定义时仅求值一次。如果将可变序列(如 [])作为默认参数,所有后续调用将共享同一个列表实例,引发隐蔽的状态污染问题。
五、综合总结与选型决策树
综合以上分析,通过以下判定逻辑可快速确定序列类型:
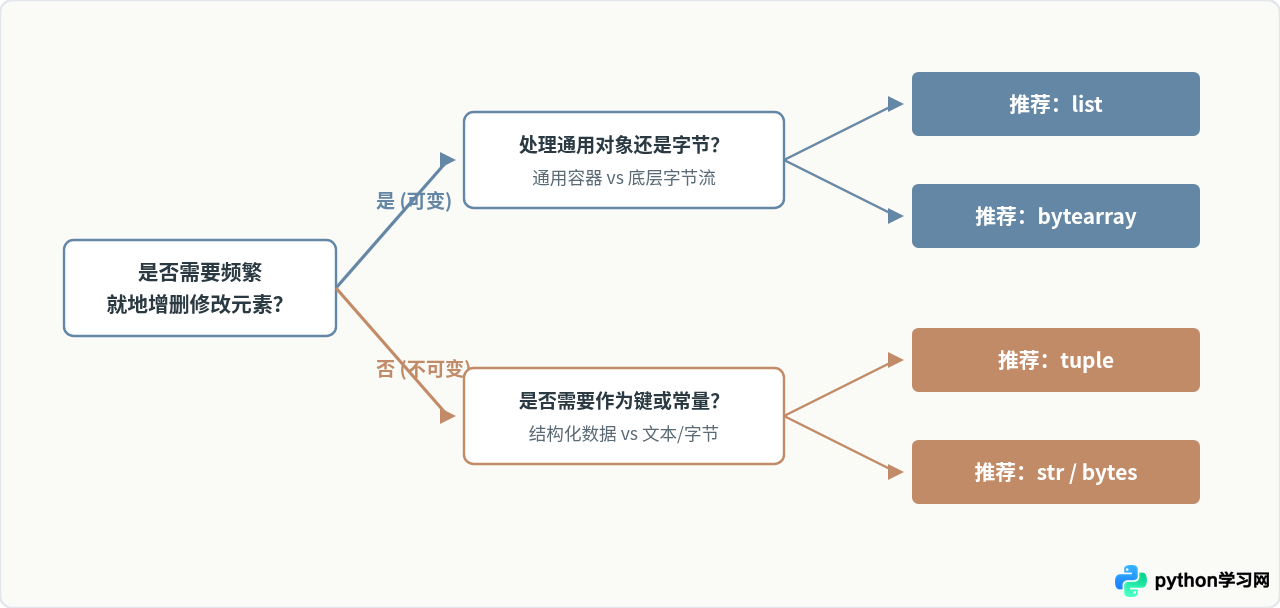
| 序列类型 | 可变性 | 哈希支持(Hashable) | 内存布局特征 | 核心选型场景 |
|---|---|---|---|---|
list |
可变 | 否(抛出 TypeError) | 带过量预留缓冲槽的动态数组 | 频繁追加、删除、就地排序的常规业务集合 |
tuple |
不可变 | 是(需内部所有元素均可哈希) | 紧凑定长连续内存,短对象享 free_list | 字典键、固定记录、多返回值、防篡改常量配置 |
str |
不可变 | 是(原生支持高效哈希) | 紧凑 Unicode 表示法(PEP 393) | 文本展示、标识符定义、不可变字符串键 |
bytearray |
可变 | 否 | 类似 list 的可扩展字节数组 | 高频二进制网络封包组装、图像就地处理 |
bytes |
不可变 | 是 | 定长连续只读字节块 | 只读二进制数据传输、固定加密哈希结果 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















