


Python包(Package)是什么:目录结构与__init__.py的作用

在 Python 开发中,随着代码规模逐步扩大,单个 .py 脚本文件会变得难以维护。Python 包(Package)正是官方提供的一种通过目录层级来组织相关模块的机制。本质上,包是一个包含了特殊文件 __init__.py 的文件夹。它不仅帮助开发者按逻辑归类功能、隔离命名空间,还通过 __init__.py 实现了包初始化与接口导出控制。
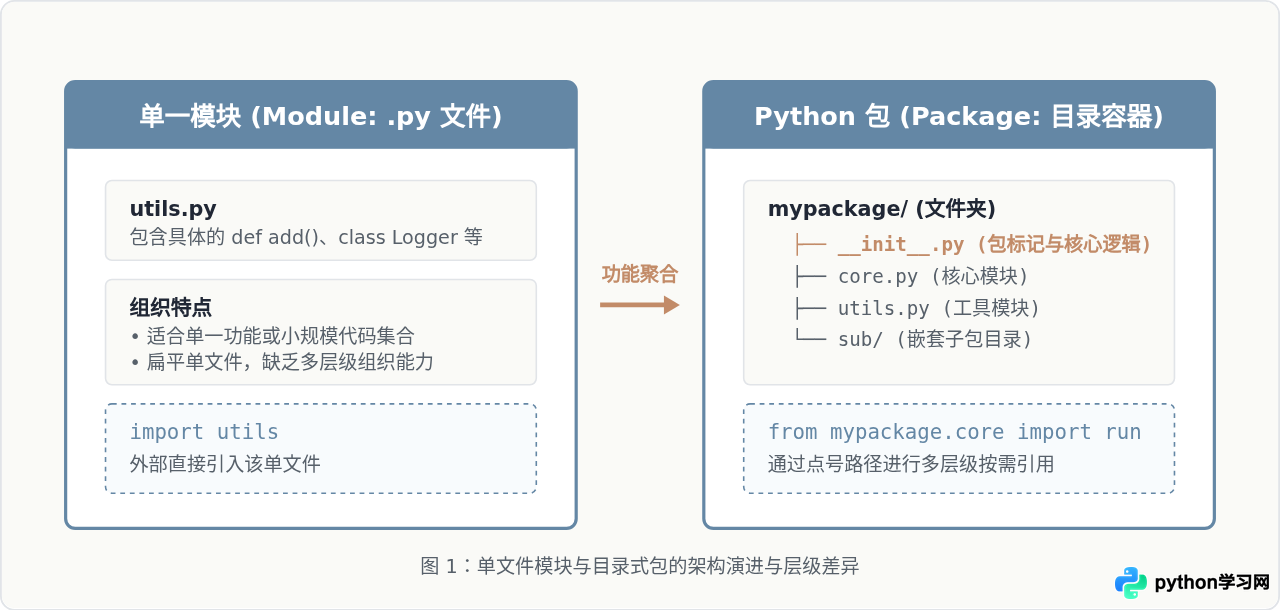
一、什么是 Python 包:与模块的核心区别
在深入目录细节之前,需要先厘清两个基础概念:模块(Module)与包(Package)。
- 模块(Module):单个 Python 文件(以
.py为后缀)。每个模块都拥有自己独立的局部作用域,内部可以定义函数、类和全局变量。 - 包(Package):一个包含若干模块文件或子包的文件夹目录。通过点号(
.)访问语法,包为多个模块提供了层次分明的命名空间,例如package.subpackage.module。
从 Python 解释器的视角看,包是一种特殊的模块。当目录被识别为包时,外部脚本不仅可以导入包本身,还能通过路径直接引用包内的具体子模块,彻底避免了大型项目中函数或类同名冲突的问题。
二、标准包目录结构解析
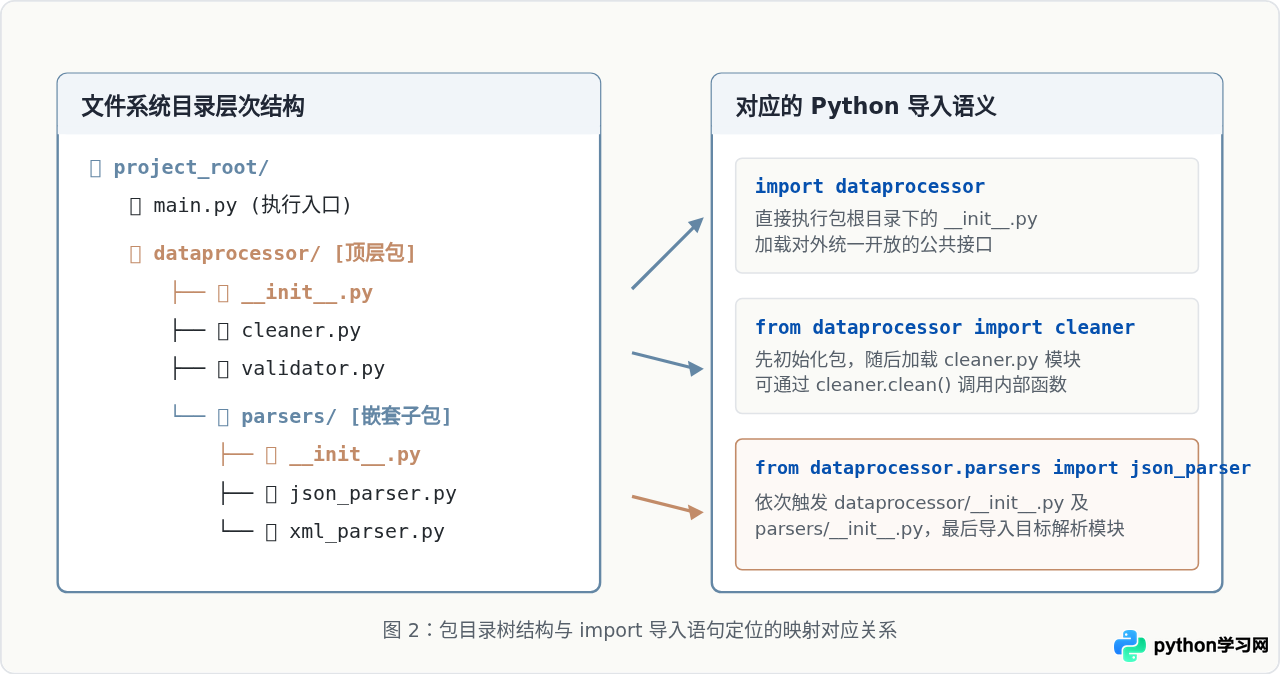
一个设计良好的 Python 包目录结构应当边界清晰、职责明确。以下是一个典型的业务项目与包目录结构示例:
project_root/
│
├── main.py                    # 项目入口启动脚本
├── README.md                  # 说明文档
│
└── dataprocessor/             # Python 包目录
    ├── __init__.py            # 包初始化入口文件
    ├── cleaner.py             # 数据清洗子模块
    ├── validator.py           # 数据校验子模块
    │
    └── parsers/               # 嵌套子包(Subpackage)
        ├── __init__.py        # 子包初始化文件
        ├── json_parser.py     # JSON解析模块
        └── xml_parser.py      # XML解析模块
在上述结构中,我们需要关注三个层级的关系:
- 项目根目录(
project_root):这是存放入口程序或执行脚本的地方。Python 启动时,会自动将运行脚本所在的目录加入sys.path搜索路径中。 - 顶层包(
dataprocessor):包的名字即是顶层命名空间。在main.py中,我们可以通过import dataprocessor或from dataprocessor import cleaner来引用它。 - 嵌套子包(
parsers):包目录内部可以继续包含子目录。只要子目录下同样包含__init__.py,它就构成了一个子包,支持类似dataprocessor.parsers.json_parser的链式导入。
三、深入理解 __init__.py 的核心作用
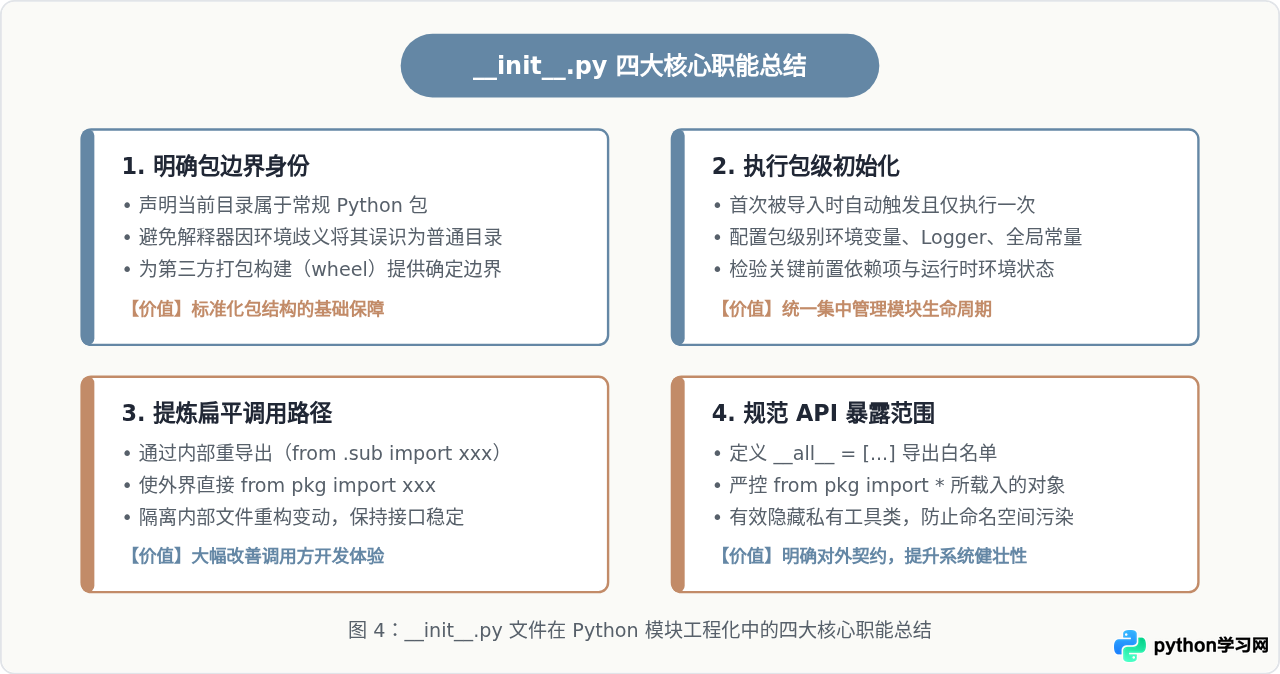
在整个包体系中,__init__.py 是最具标志性的核心文件。即使它是一个完全为空的文件,它的存在也对解释器有着明确的信号意义。具体而言,它主要承担以下四种职责:
1. 标识目录为常规 Python 包
在 Python 3.3 之前,一个目录若想被作为包导入,必须包含 __init__.py 文件;如果没有该文件,解释器会直接报 ModuleNotFoundError。尽管 Python 3.3 之后引入了无需该文件的“命名空间包”,但在绝大多数常规项目和第三方类库中,保留 __init__.py 依然是标识常规包(Regular Package)的标准行业实践。
2. 执行包级初始化逻辑
当包首次被任何模块导入时,该包目录下的 __init__.py 会被自动执行一次。你可以利用它完成包运行所需的全局准备工作,例如:
- 初始化连接池或配置默认运行参数;
- 设置包级别的日志记录器(Logger);
- 检查依赖运行环境与 Python 版本兼容性。
3. 控制模块导出(通过 __all__ 变量)
在 Python 中,使用 from package import * 会尝试导入所有非下划线开头的对象。通过在 __init__.py 中定义列表 __all__,可以显式白名单指定允许被外部星号导入的具体类或函数:
# dataprocessor/__init__.py
from .cleaner import clean_text
from .validator import check_schema

# 仅允许暴露给 from dataprocessor import * 的符号
__all__ = ['clean_text', 'check_schema']
通过严格限定 __all__,可以有效隐藏包内部的辅助工具函数,避免使用者的命名空间被无意污染。
4. 简化外部导入路径(提供扁平化对外接口)
若没有在 __init__.py 中做桥接,调用方若想使用深层模块的函数,必须书写冗长的导入路径:
# 传统冗长写法:调用者必须明确知晓内部文件划分
from dataprocessor.parsers.json_parser import parse_json_data
但如果在 dataprocessor/__init__.py 中预先进行了重导出(Re-export):
# dataprocessor/__init__.py
from .parsers.json_parser import parse_json_data
调用者便能享受到极简的导入语法,内部重构调整子模块文件名也不会影响外部调用者的既有代码:
# 扁平简洁写法:对外屏蔽了内部目录细节
from dataprocessor import parse_json_data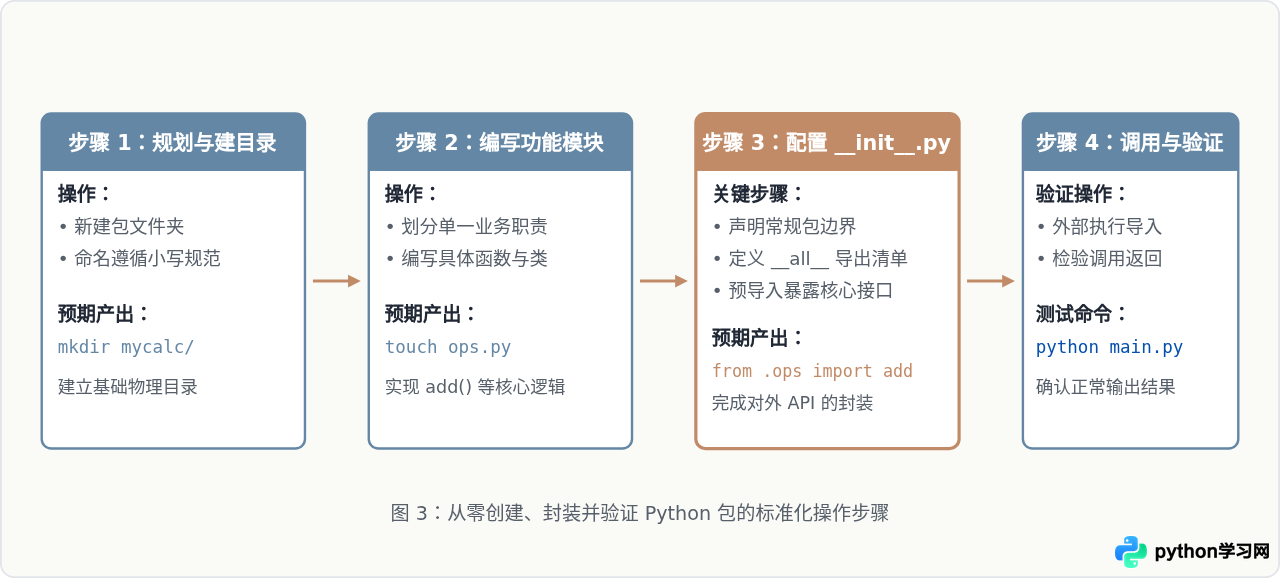
四、Python 3.3+ 命名空间包与常规包的辨析
在 Python 3.3 中,官方通过 PEP 420 规范引入了隐式命名空间包(Implicit Namespace Packages)。如果一个文件夹下完全没有 __init__.py,Python 3.3+ 也不会直接报错,而是将其视作一个命名空间包。
| 特性对比 | 常规包 (Regular Package) | 命名空间包 (Namespace Package) |
|---|---|---|
| 必须包含 __init__.py | 是(必须且核心) | 否(严禁包含) |
| 跨目录分散存储 | 不支持(对应单一物理目录) | 支持(多个独立目录可共享同一包名) |
| 包初始化逻辑 | 支持(在 __init__.py 中编写) | 不支持(没有统一初始化文件) |
| 典型适用场景 | 90% 以上的日常工程、完整类库 | 超大型微服务插件体系、独立仓库组件拼合 |
__init__.py。显式声明不仅能提升代码可读性,还能避免因为目录重名导致的难以察觉的导入合并问题。
五、实战示例:一步步实现并调用一个计算包
下面通过一个可以直接在本地创建的完整示例,演示包的具体组织与调用方法。
1. 建立目录与模块代码
在任意空工作区中,创建如下文件结构:
demo_workspace/
├── app.py
└── mathkit/
    ├── __init__.py
    └── basic.py
在 mathkit/basic.py 中编写核心算法逻辑:
# mathkit/basic.py

def add(x: float, y: float) -> float:
    """求两数之和"""
    return x + y

def subtract(x: float, y: float) -> float:
    """求两数之差"""
    return x - y
2. 编写 mathkit/__init__.py 封装接口
利用 __init__.py 提升 add 函数的调用层级,并定义导出白名单:
# mathkit/__init__.py

# 使用相对导入将内部模块函数提升至包顶级命名空间
from .basic import add

# 限制外界使用 * 导入时的范围
__all__ = ['add']

# 初始化提示(示例:观察包加载时机)
print("[系统通知] mathkit 包已被成功加载")
3. 在入口脚本中进行调用
在根目录下的 app.py 中引入并执行:
# app.py
from mathkit import add

def main():
    result = add(12.5, 7.5)
    print(f"计算结果为: {result}")

if __name__ == '__main__':
    main()
打开终端,定位到 demo_workspace 根目录,执行如下命令:
python app.py终端输出结果:
[系统通知] mathkit 包已被成功加载
计算结果为: 20.0
通过输出可以清楚地观察到:在 app.py 执行 from mathkit import add 时,mathkit/__init__.py 首先被执行并输出了提示信息,随后 add 函数成功运行。
六、常见问题与避坑指南
attempted relative import with no known parent package如果在
mathkit/basic.py 内部写了 from . import xxx,然后直接在终端执行 python mathkit/basic.py,Python 会直接报此错误。
原因:相对导入依赖模块的
__name__ 属性来解析父级包信息。直接作为脚本运行的文件,其 __name__ 会被设置为 "__main__",导致父包信息丢失。
解决:包内部的模块不要直接当主脚本运行;应统一在根目录执行入口脚本,或者使用
python -m mathkit.basic 以模块模式启动。
如果在
module_a.py 中 from module_b import func_b,同时在 module_b.py 中 from module_a import func_a,在导入时极易出现 ImportError: cannot import name ...。
解决: 1. 重新梳理职责,将两者共同依赖的数据结构或函数抽离到第三个底层模块(如
types.py 或 common.py);
2. 将个别仅仅在某个函数内部使用的导入语句,移动到函数内部延迟导入(Lazy Import)。
因为任何只要碰触到该包的
import 语句都会立即触发 __init__.py 的同步执行。如果在此处建立庞大的数据库连接或读取几百兆的模型文件,将导致所有轻量级子模块的导入变得极其缓慢。
七、总结
掌握 Python 包与 __init__.py 的机制,是迈向工程化模块设计的重要一步。理解包的层级逻辑与 __init__.py 的职责,能够帮助我们在日常架构中写出模块高内聚、依赖低耦合的规范 Python 代码:
- 目录即包:通过包含
__init__.py的文件夹对模块进行逻辑归类,形成清晰的多层级命名空间。 - 统一出口:善用
__init__.py做接口重导出,为外界提供简洁易用的调用方式,同时用__all__约束星号导入。 - 安全运行:保持
__init__.py逻辑轻量,统一从项目根目录启动脚本,避免循环导入与相对导入陷阱。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















