


Python NumPy创建矩阵的5种常用方法

在 Python 的科学计算与数据分析体系中,矩阵(二维数据表结构)是最基础的操作对象。虽然早期 NumPy 提供了专门的 numpy.matrix 类,但官方目前已明确推荐使用标准的二维 numpy.ndarray 来表示和运算矩阵。本文将系统梳理在实际开发中创建矩阵的 5 种高频方法,逐一讲解其语法结构、参数细节与应用场景,帮助读者建立清晰的矩阵构建思路。
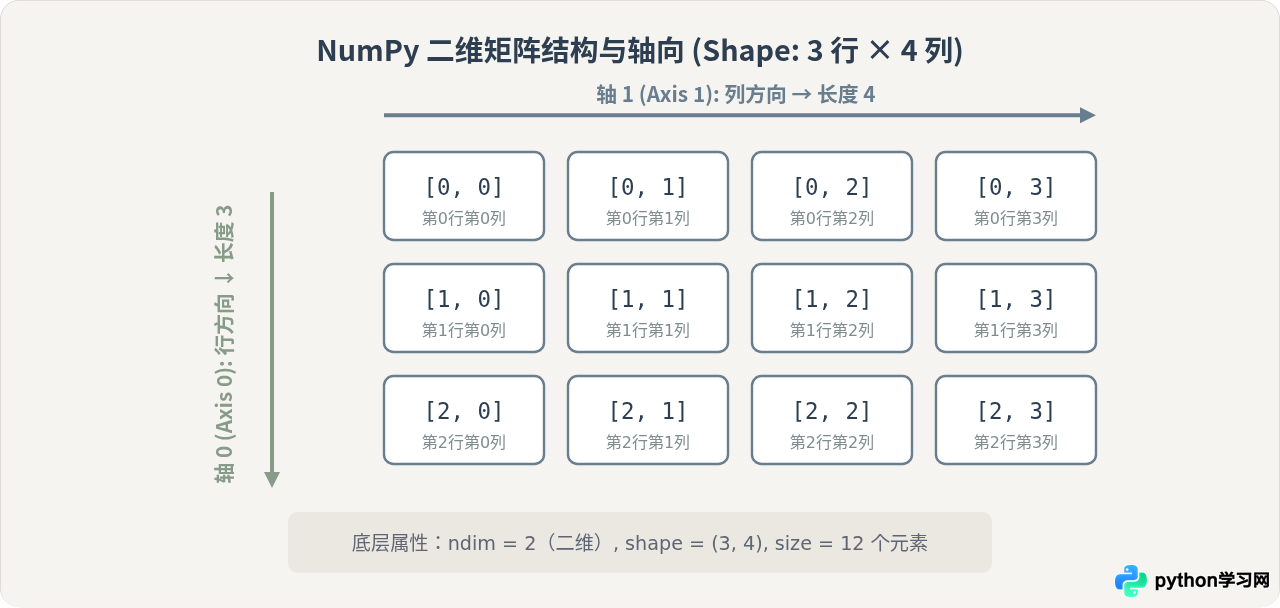
方法一:基于已有数据使用 np.array() 转换
当手上已经具备 Python 原生列表(List)或元组(Tuple)时,最直接的方法是使用 np.array() 进行转换。该函数接收嵌套列表作为输入,其中外层列表的每个元素对应矩阵的一行,内层列表包含该行所有列的数据。
import numpy as np

# 使用二维嵌套列表创建 2 行 3 列的整数矩阵
data = [
    [1, 2, 3],
    [4, 5, 6]
]
mat1 = np.array(data, dtype=np.int32)

print("矩阵内容:\n", mat1)
print("形状 (shape):", mat1.shape)
print("数据类型 (dtype):", mat1.dtype)关键要点与注意事项:
- 行长度必须一致: 嵌套列表中每一个子列表的元素个数必须相同。若长度参差不齐(例如第一行3个元素,第二行2个元素),NumPy 将无法正确构建二维数值数组,甚至抛出
ValueError。 - 类型自动推导: 如果未显式指定
dtype,NumPy 会根据数据特征自动提升类型。例如只要列表中混入一个浮点数,整个矩阵所有元素都会转换为浮点型。
方法二:使用 np.zeros()、np.ones() 或 np.full() 初始化常量矩阵
在算法实现或数值模拟中,我们通常需要先为矩阵预先分配内存空间并赋予固定初值,避免后续频繁动态扩容带来的性能损耗。
np.zeros(shape):生成全 0 矩阵。np.ones(shape):生成全 1 矩阵。np.full(shape, fill_value):生成指定标量填充的矩阵。
import numpy as np

# 传入元组 (行数, 列数) 指定形状
zero_mat = np.zeros((3, 3))               # 3x3 全 0 矩阵,默认浮点型 float64
ones_mat = np.ones((2, 4), dtype=int)     # 2x4 全 1 矩阵,显式指定为整型
seven_mat = np.full((2, 3), 7)            # 2x3 填充为 7 的矩阵

print("全0矩阵 (3x3):\n", zero_mat)
print("全1整型矩阵 (2x4):\n", ones_mat)
print("常数填充矩阵 (2x3):\n", seven_mat)技术对照:np.zeros() 与 np.empty() 的差异
np.empty(shape) 同样可以分配指定维度的数组,但它不会对内存进行清零初始化,里面残留的是内存块原有的随机垃圾值。虽然 np.empty() 在超大矩阵分配时比 np.zeros() 节省极细微的清零时间,但如果在后续赋值中有遗漏,会导致难以排查的未定义数值错误。除非极度追求极限分配性能且能保证立即全量重写,否则优先使用安全的 np.zeros()。
方法三:利用 np.arange() 与 np.linspace() 结合 reshape()
很多计算场景需要按规律生成的等差序列来构建矩阵。np.arange() 和 np.linspace() 默认生成一维数组,通过链式调用 .reshape(rows, cols) 可以将其快速塑形为二维矩阵。
import numpy as np

# 1. np.arange: 指定起点、终点和步长 (步长驱动)
# 生成 0 到 11 的连续整数,并重塑为 3 行 4 列
mat_range = np.arange(12).reshape(3, 4)

# 2. np.linspace: 指定起点、终点和元素总个数 (点数驱动)
# 在 0 到 1 之间均匀采样 6 个点,重塑为 2 行 3 列
mat_linear = np.linspace(0, 1, 6).reshape(2, 3)

print("步长生成重塑矩阵 (3x4):\n", mat_range)
print("等分采样重塑矩阵 (2x3):\n", mat_linear)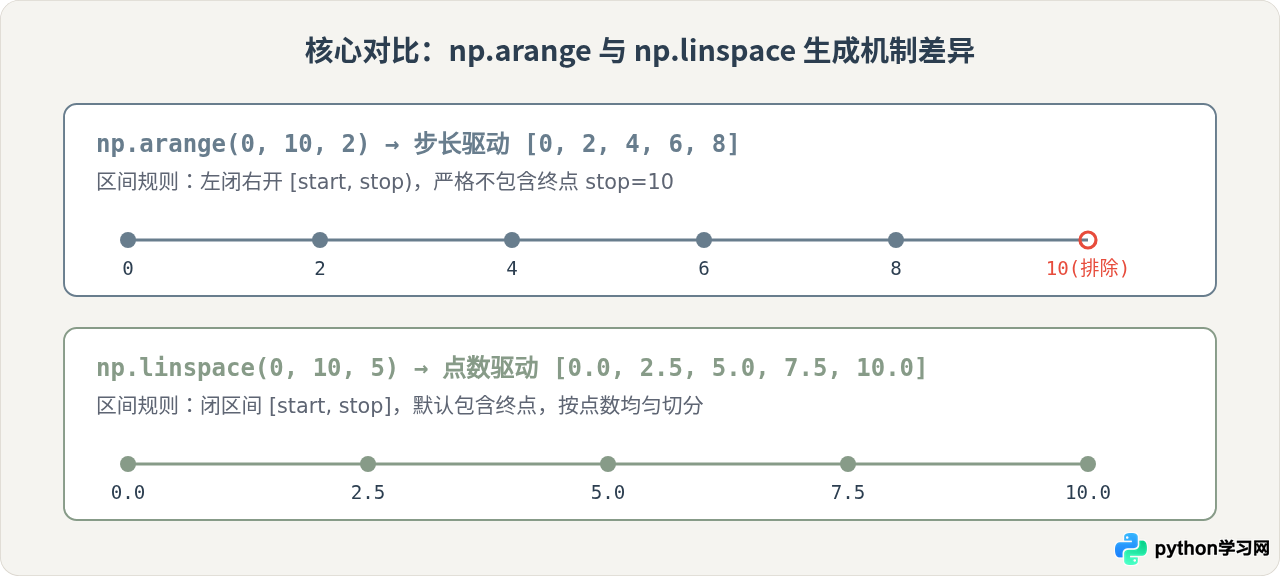
关键区别深度解析:
二者在构造矩阵时的侧重点截然不同:
- 控制维度不同:
np.arange控制的是相邻元素跨度(例如步长固定为 2 或 0.5);而np.linspace控制的是生成元素的总个数。 - 浮点数累加误差: 当步长为浮点小数时(例如
np.arange(0, 1, 0.1)),由于二进制浮点舍入问题,结果元素的数量可能出现不可预期的偏差。因此,只要需要包含浮点数区间并指定准确点数重塑矩阵,强烈建议使用np.linspace()。 - reshape 总量守恒: 重塑前的一维元素总数必须严格等于目标矩阵的行数与列数之积(
rows * cols)。例如 12 个元素可以 reshape 为(3, 4)或(2, 6),但若指定(3, 5)则会直接触发报错。
方法四:使用 np.eye() 与 np.diag() 构建单位矩阵与对角矩阵
在线性代数计算、坐标变换、协方差矩阵初始化等数学建模场景中,特殊结构的方阵至关重要:
np.eye(N, M=None, k=0):生成单位矩阵或主对角线全为 1 的矩阵。np.identity(n):生成严格严格为 n×n 的标准单位方阵。np.diag(v, k=0):根据输入一维向量构建对角矩阵;若传入二维矩阵,则提取其对角线元素。
import numpy as np

# 1. 构建 3x3 标准单位矩阵
identity_mat = np.eye(3)

# 2. 构建主对角线偏移的矩阵 (k=1 表示向上偏移一条对角线)
k_shift_mat = np.eye(4, 4, k=1)

# 3. 基于指定数值向量构建对角矩阵
diag_mat = np.diag([5, 10, 15])

print("标准 3x3 单位矩阵:\n", identity_mat)
print("向上偏移对角矩阵 (k=1):\n", k_shift_mat)
print("自定义对角矩阵:\n", diag_mat)方法五:使用 np.random 子模块生成随机矩阵
在机器学习模型参数初始化、算法模拟测试或蒙特卡洛仿真中,随机矩阵不可或缺。NumPy 的 numpy.random 模块提供了丰富的概率分布采样能力:
np.random.rand(d0, d1):生成在区间[0.0, 1.0)均匀分布的随机矩阵。np.random.randn(d0, d1):生成符合标准正态分布(均值为0,方差为1)的随机矩阵。np.random.randint(low, high, size=(rows, cols)):生成指定范围内的随机整数矩阵。
import numpy as np

# 设置随机数种子以确保结果可重现
np.random.seed(42)

# 1. 均匀分布矩阵 (2x3)
mat_uniform = np.random.rand(2, 3)

# 2. 标准正态分布矩阵 (2x3)
mat_normal = np.random.randn(2, 3)

# 3. 随机整数矩阵 (3x3,取值范围 [10, 50))
mat_int = np.random.randint(10, 50, size=(3, 3))

print("均匀分布随机矩阵:\n", mat_uniform)
print("标准正态分布随机矩阵:\n", mat_normal)
print("随机整数矩阵:\n", mat_int)注意参数传递风格: np.zeros((2, 3)) 接受一个元组表示形状,而传统的 np.random.rand(2, 3) 则是将各个维度作为独立参数传入。在较新版本 NumPy 中,也可以使用推荐的生成器接口 rng = np.random.default_rng(); rng.random((2, 3)),此时形状统一接收元组。
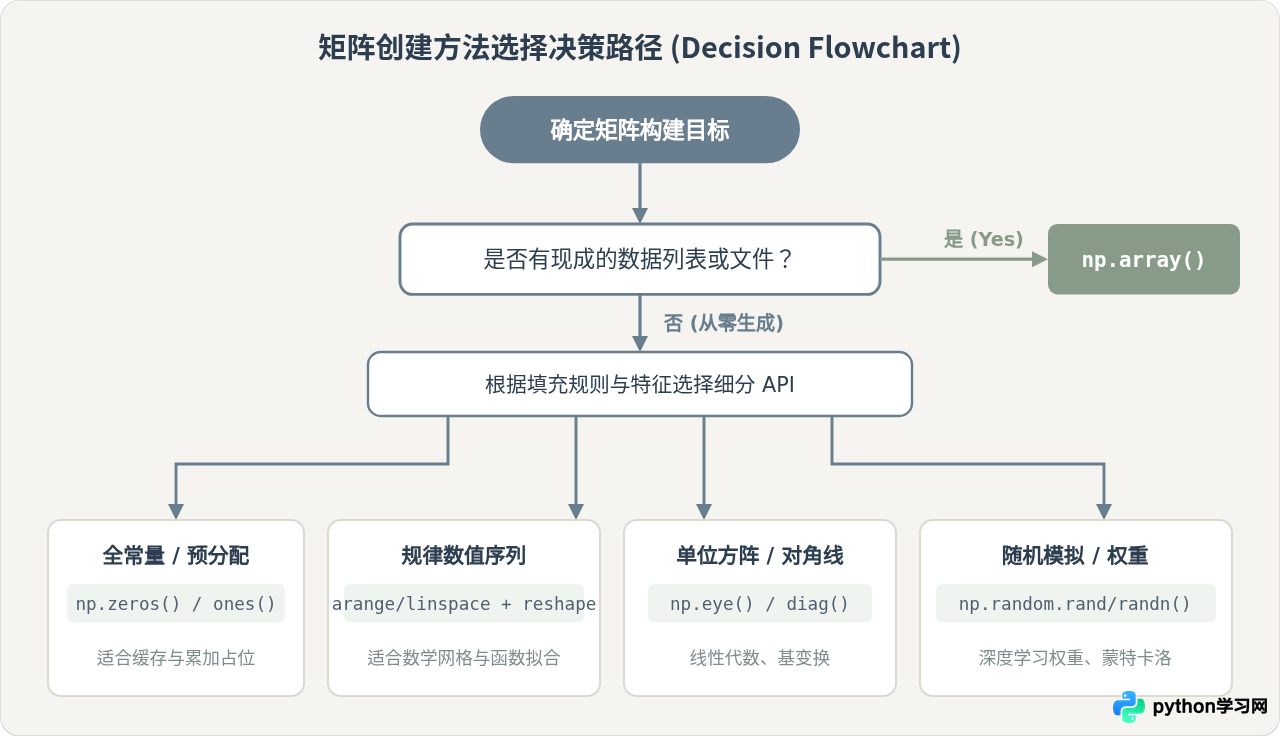
实战应用:创建矩阵的选择决策路径
面对具体的业务或计算需求,应该选择哪种方法?下图梳理了从需求场景到具体 API 的选择决策路径:
5 种矩阵创建方法横向对比与总结
为了便于查阅,下表归纳了上述 5 种核心方法的参数输入特征、返回维度以及典型适用业务:
| 方法名称 | 典型调用方式 | 形状控制机制 | 典型应用场景 |
|---|---|---|---|
| 已有列表转换 | np.array([[1,2],[3,4]]) |
由外层和内层列表长度自然确定 | 处理 Python 脚本采集到的原始数据、JSON 结构转换 |
| 常量初始化 | np.zeros((m, n)) / np.ones() |
显式传入形如 (m, n) 的元组 |
算法迭代缓冲区预分配、掩码(Mask)生成 |
| 等差序列重塑 | np.arange(12).reshape(3, 4) |
先生成一维向量,再调用 .reshape() 调整 |
离散数学实验、二维坐标系刻度网格构建 |
| 单位与对角阵 | np.eye(n) / np.diag(vec) |
指定维度 N 或根据输入一维向量长度推导 | 线性方程求解、主成分分析(PCA)、正则化惩罚项 |
| 随机数生成 | np.random.rand(m, n) |
直接传入整数维度或元组(取决于 API) | 神经网络初始权重设定、蒙特卡洛随机模拟、压力测试 |
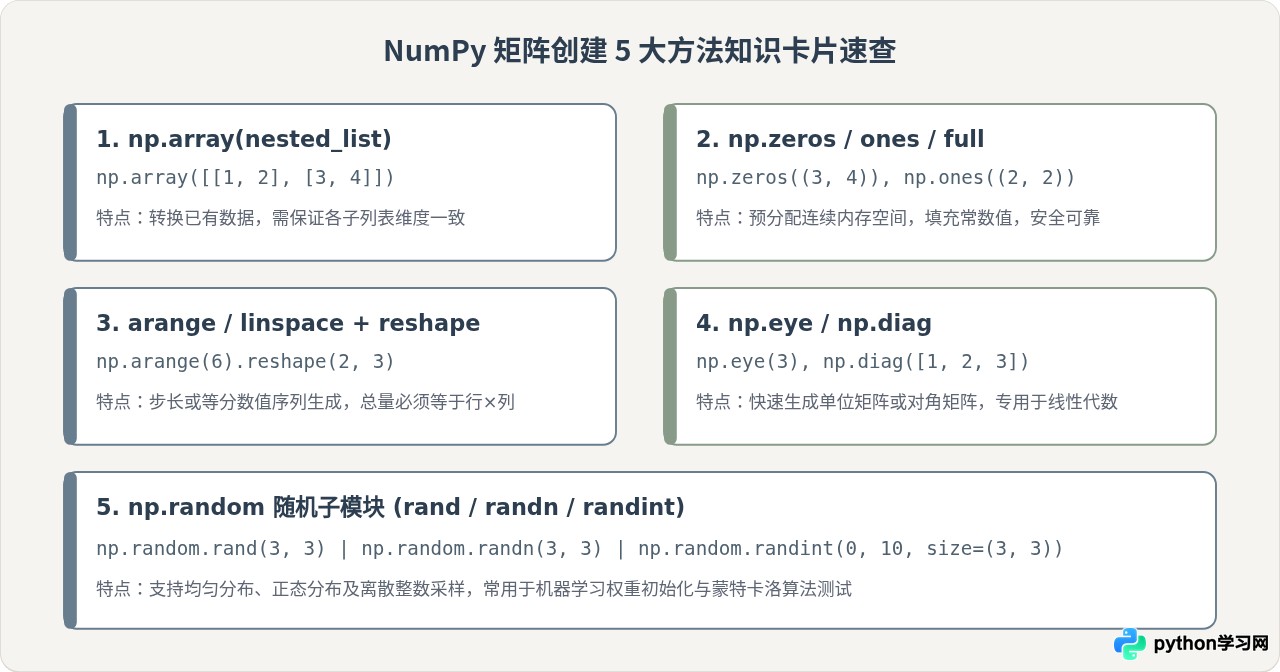
掌握这 5 种方法后,可以根据具体任务的数据源(现有数据、常量占位、等差序列、特殊方阵或随机分布)选用最简明、最高效的 API,写出规范且性能优异的 NumPy 数值计算程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















