


Python切片[::2]怎么隔项提取元素

在 Python 中,通过切片语法 sequence[start:stop:step] 可以灵活提取序列中的子集。当你写下形如 sequence[::2] 的表达式时,代码的核心行为是:从序列的第一个元素(索引 0)开始,每隔一个位置抽取一个元素,也就是精准提取出所有偶数索引项。本文将从语法拆解、取数流程、常见混淆辨析以及边界特性四个维度,完整说明 [::2] 是如何实现隔项提取的。
一、解构 [::2]:双冒号与步长的含义
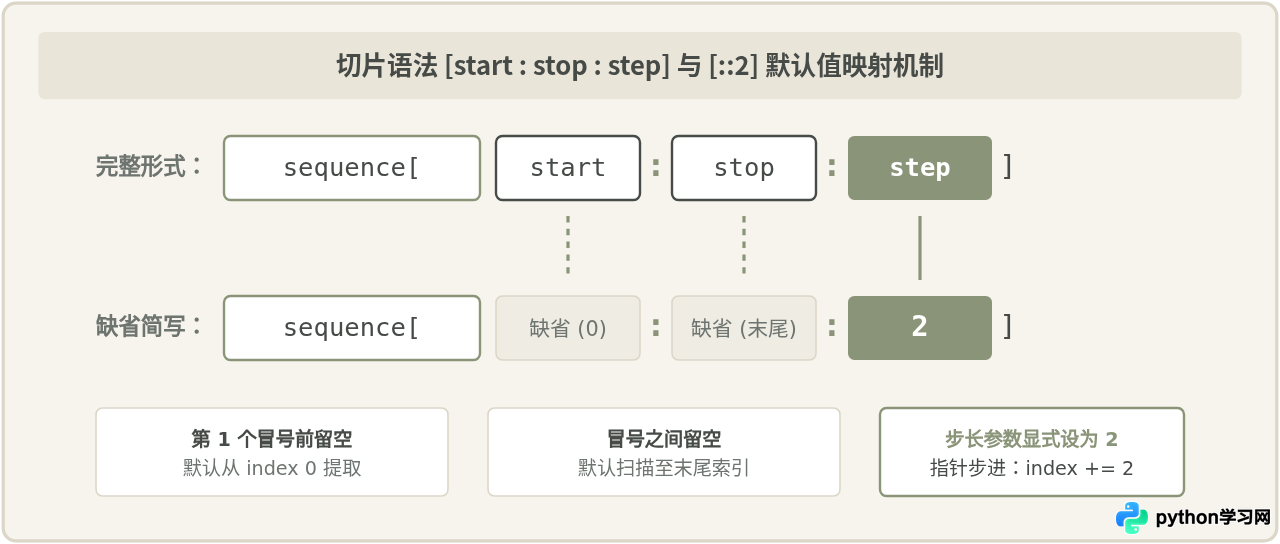
Python 序列切片的标准格式由三个参数组成,彼此通过英文冒号分隔:[起始位置 : 终止位置 : 步长]。很多初学者看到两个冒号连写时会感到困惑,实际上这只是省略参数后的标准简写形式。
当切片表达式写为 [::2] 时,表示同时省略了 start 和 stop,仅显式提供了第三个参数 step = 2。Python 内部对省略的参数有一套严格且明确的默认补齐规则:
- start(起始索引)默认值:当步长为正数时,省略
start默认从序列的最开头开始,即索引0。 - stop(终止索引)默认值:当步长为正数时,省略
stop默认一直扫描到序列的末尾(包含最后一个元素)。 - step(步长):设为
2,表示每次取完一个元素后,索引游标向前跨进 2 个单位,而非默认的 1 个单位。
因此,seq[::2] 在底层完全等价于 seq[0 : len(seq) : 2]。
二、隔项提取的实际操作与执行流程
为了直观看到 Python 解释器在内存中是如何运作的,我们以包含 7 个元素的列表为例进行操作演示:
# 准备一个包含数字 0 至 6 的示例列表
numbers = [10, 20, 30, 40, 50, 60, 70]

# 使用 [::2] 进行隔项提取
result = numbers[::2]

print("原列表:", numbers)
print("提取结果:", result)提取结果: [10, 30, 50, 70]
在上述执行过程中,切片引擎的具体计算步骤如下:
- 定位起始项:读取
start缺省值0,命中首个元素numbers[0](值为10),将其加入结果集。 - 跨步推进:当前索引加上步长(
0 + 2 = 2),定位到索引2,命中元素numbers[2](值为30)。 - 持续提取:再次跨步(
2 + 2 = 4),命中numbers[4](值为50);继续跨步(4 + 2 = 6),命中numbers[6](值为70)。 - 终止判断:继续累加跨步(
6 + 2 = 8),发现索引8 >= len(numbers)已超出序列长度边界,提取过程正常结束并返回结果列表。
这种提取机制不仅适用于列表(list),同样完全适用于字符串(str)与元组(tuple)等所有支持切片协议的内置序列类型:
# 字符串隔项提取示例
text = "ABCDEFG"
sub_text = text[::2]
print(sub_text)  # 输出示例: "ACEG"

# 元组隔项提取示例
data_tuple = (1, 2, 3, 4, 5)
print(data_tuple[::2])  # 输出示例: (1, 3, 5)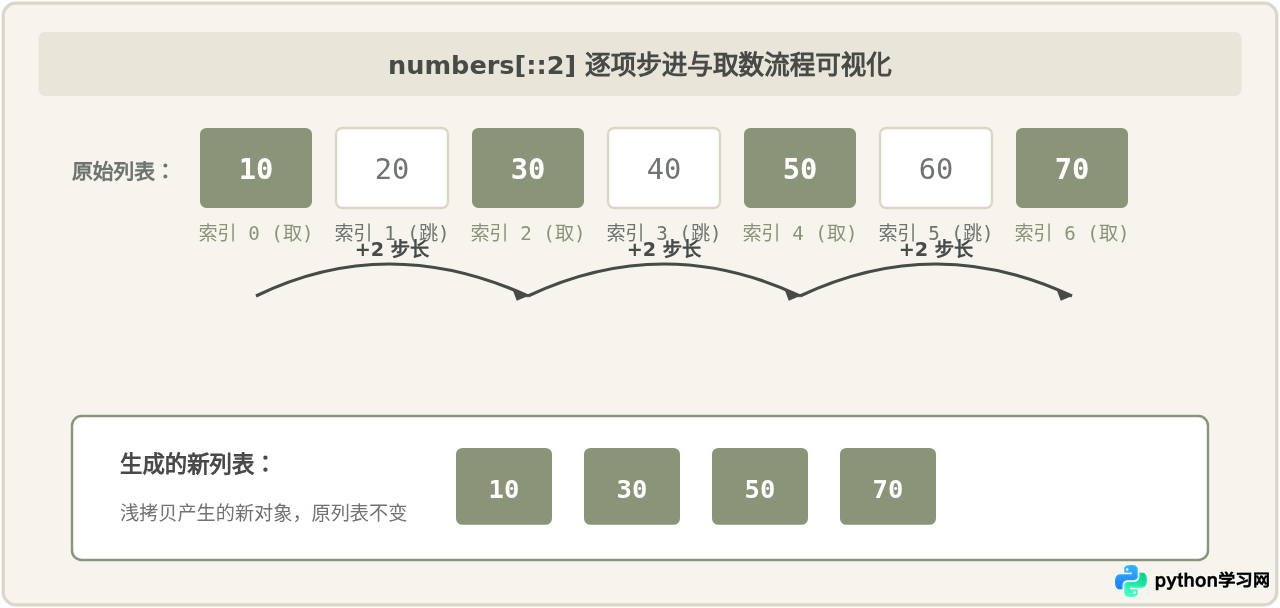
三、容易混淆的认知:到底提取的是奇数项还是偶数项?
在日常使用中,常常出现这样一种争论:“[::2] 到底提取的是序列中的奇数项,还是偶数项?”
这种分歧的产生并非由于代码逻辑有误,而是人类生活中的自然数数习惯与计算机的零基索引(0-based Indexing)之间存在认知错位:
- 从计算机底层索引角度看:
[::2]提取的是索引为0, 2, 4, 6...的元素。由于 0、2、4、6 都是数学意义上的偶数,因此技术文档通常准确地表述为“提取所有偶数索引项”。 - 从人类生活直觉角度看:日常数数从 1 开始(第 1 个、第 2 个、第 3 个……)。索引 0 恰恰对应的是“第 1 项”,索引 2 对应的是“第 3 项”。因此在直觉上,读者常觉得
[::2]提取的是“第奇数个元素”。
如果你需要在业务上提取生活直觉中的“第 2、4、6 项”(即计算机中的奇数索引项),只需要将起始参数设为 1,即使用 seq[1::2]:
items = ["A", "B", "C", "D", "E", "F"]

# 提取偶数索引项(第 1, 3, 5 个元素)
even_indices = items[::2]
print("items[::2]  ->", even_indices)   # 输出: ['A', 'C', 'E']

# 提取奇数索引项(第 2, 4, 6 个元素)
odd_indices = items[1::2]
print("items[1::2] ->", odd_indices)    # 输出: ['B', 'D', 'F']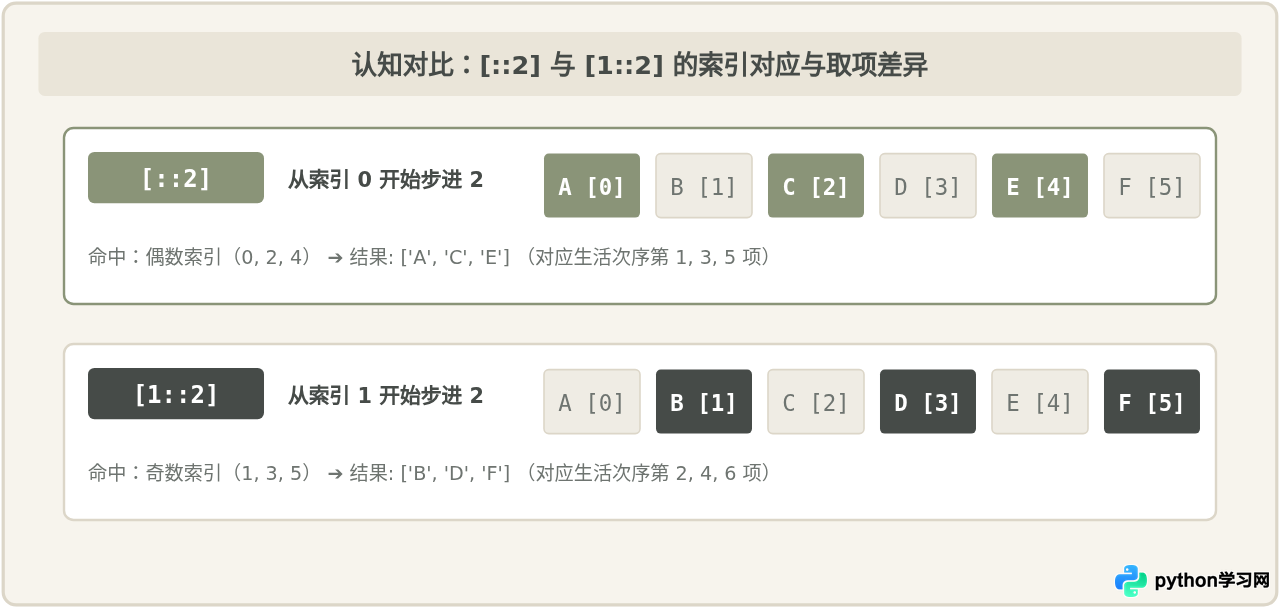
四、关键细节与边界行为
在实际编码中,除了最基础的隔项提取,还需注意以下三条关键特性,以避免潜在的逻辑陷阱:
1. 产生浅拷贝,不改变原序列
对列表或元组执行 seq[::2] 会在内存中分配新的存储空间,返回一个新的序列容器。对新切片列表进行追加、删除或赋值,均不会波及原始序列。但需留意,如果列表中存放的是可变嵌套对象(例如子字典或子列表),元素本身的引用仍然是共享的。
2. 自动截断容错,无越界风险
单项索引访问(例如 numbers[99])在下标越界时会立即抛出 IndexError 异常。但切片机制具有自动边界修剪特性:当计算出的下一个步进索引超过序列最大长度时,切片直接安全终止,既不报错,也不会填充空值。
short_list = [1]
# 只有一个元素时,跳步不会报错,安全返回包含单元素的切片
print(short_list[::2])  # 输出示例: [1]

empty_list = []
# 空列表切片,安全返回新的空列表
print(empty_list[::2])  # 输出示例: []
3. 负步长的逆序隔项提取:[::-2]
如果将步长设为负数(例如 [::-2]),Python 会自动倒置默认的起始与结束位置:start 默认变成最后一个元素的索引(-1),stop 默认跨越到最开头之前。此时提取行为变为从右向左倒序隔项提取:
letters = ["A", "B", "C", "D", "E", "F"]
# 从末尾倒序隔项提取
reverse_even = letters[::-2]
print(reverse_even)  # 输出示例: ['F', 'D', 'B']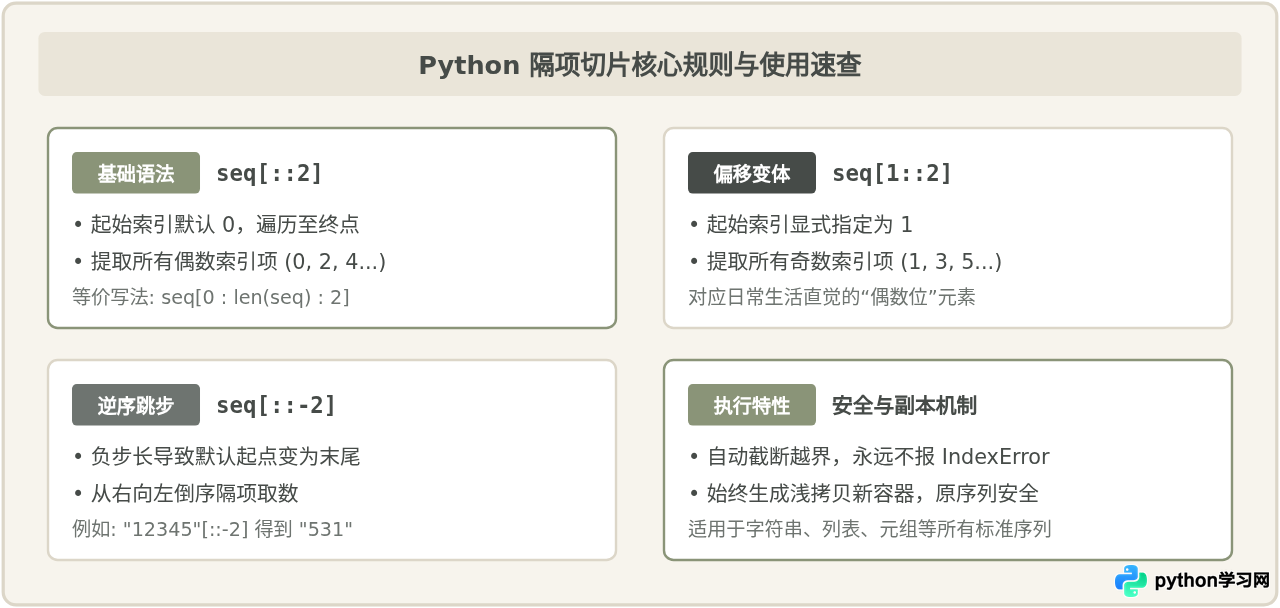
五、总结
掌握 [::2] 隔项切片的关键在于理解 Python 步长机制与省略默认值的交互关系:
- 双冒号
::是省略起始与终止边界的简写,等同于覆盖全序列范围。 - 末尾的
2是步长(step),决定索引指针每次前进两格。 - 正向隔项提取从索引 0 开始,若需从第二个元素开始隔项提取,应使用
[1::2];逆向隔项提取则使用[::-2]。
只要牢记“默认起点为 0”和“步长为 2 逐项跳进”这两点,便能在数据清洗、隔行处理或格式提取场景中准确、自如地运用切片语法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















