


Python字符串join与split高效拼接分割技巧

str.join() 与 str.split() 构成了字符串与列表相互转换的核心双向桥梁。由于Python字符串具有不可变(immutable)特性,理解 join() 如何在单次内存申请中完成拼接,以及 split() 在面对各种空白字符与分割限制参数时的行为差异,是编写高性能、少Bug代码的关键基石。
一、str.split() 分割机制与参数细节
str.split() 的核心作用是将一个字符串按照指定的分隔符拆分为子字符串列表。虽然初学者经常随意调用该方法,但在实际工程中,参数传与不传会导致截然不同的逻辑行为与性能开销。
1. 默认参数与显式指定空格的本质区别
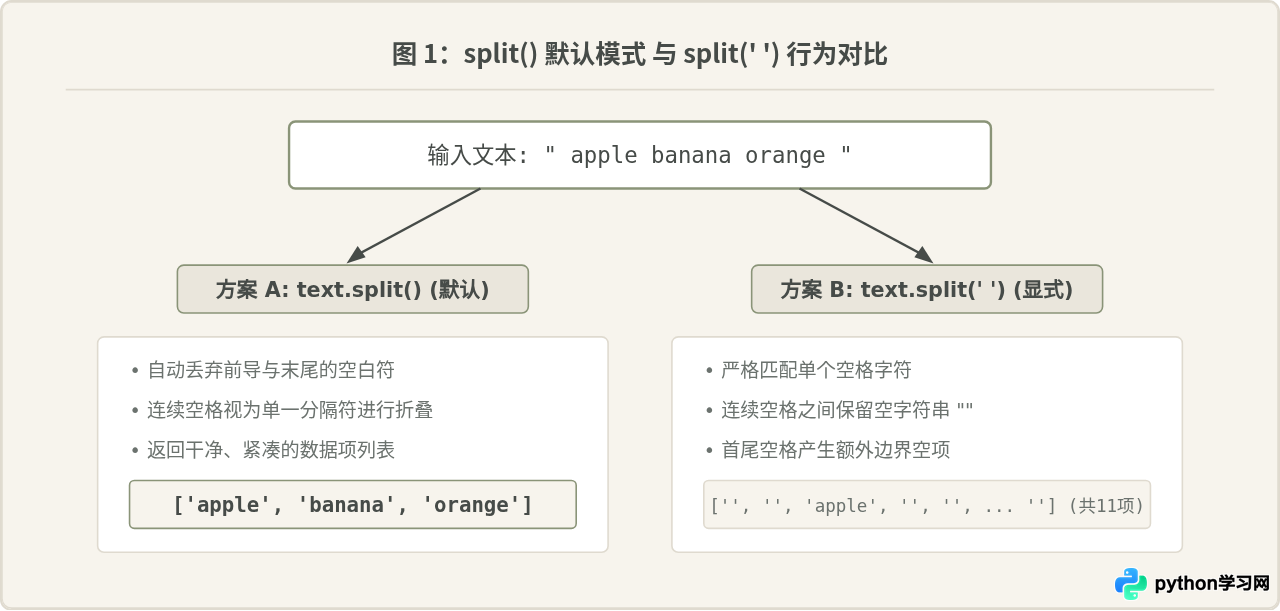
当不给 split() 传递任何参数,或者显式传入 sep=None 时,Python采用的是一种专门针对“任意连续空白符”设计的算法。它不仅会将单个空格、多个连续空格、制表符(\t)、换行符(\n、\r\n)统一视为单一边界,还会自动剔除字符串首尾的所有空白。
然而,如果明确指定了 sep=' '(单空格),Python就会完全退化为逐字符的严格匹配:相邻的两个空格之间会产生一个空字符串 "",字符串开头的空格会导致列表第一项为 "",末尾的空格也会导致最后一项为 ""。
# 示例:两种分割方式的输出差异
raw_text = "  apple   banana \t orange \n "

# 1. 默认规则:智能折叠任意空白,过滤空项
result_default = raw_text.split()
print("默认 split():", result_default)
# 示例输出:['apple', 'banana', 'orange']

# 2. 显式指定单空格:严格按字符切分,保留所有空字符串
result_space = raw_text.split(' ')
print("指定 sep=' ':", result_space)
# 示例输出:['', '', 'apple', '', '', 'banana', '\t', 'orange', '\n', '']
在清洗用户输入、分析日志或解析格式不规整的文本时,使用默认的无参调用通常能够直接得到纯净的词元列表;而只有在处理具有严格列对齐、需要通过空格占位来确定字段缺失状态时,才应考虑显式指定分隔符。
2. maxsplit 参数与反向切分 rsplit() 的截断技巧
在很多场景下,我们只需要切出前几个字段,或者只提取末尾的数据。如果不限制分割次数,对超长文本执行全量切分不仅会产生大量无用的列表项,还会增加额外的内存分配与垃圾回收压力。
split(sep, maxsplit) 参数用于限定最大分割次数。完成指定的分割次数后,剩余的整个字符串会完整保留在列表的最后一项中。对应地,rsplit() 则从字符串右侧开始切分。
# 场景:解析结构化日志或配置
log_line = "2026-10-20 16:40:00 INFO User kukukuwl login success from 192.168.1.1"

# 只需要提取时间、日志级别和后续消息正文
# 设置 maxsplit=3,仅切分前3个空格
date_part, time_part, level_part, message_part = log_line.split(" ", maxsplit=3)
print("日期:", date_part)
print("级别:", level_part)
print("正文:", message_part)
# 示例输出:
# 日期: 2026-10-20
# 级别: INFO
# 正文: User kukukuwl login success from 192.168.1.1

# 场景:提取文件扩展名或URL尾部参数
file_path = "archive.data.tar.gz"
base_name, ext = file_path.rsplit(".", maxsplit=1)
print("基础名:", base_name, "| 扩展名:", ext)
# 示例输出:基础名: archive.data.tar | 扩展名: gz
二、str.join() 拼接原理与性能核心
在Python中,拼接字符串最直观的写法似乎是用加号 +=。但是在循环中拼接大量字符时,+= 会带来灾难性的性能恶化,而 str.join() 则是公认的最佳实践。
1. 为什么 += 拼接存在性能陷阱?
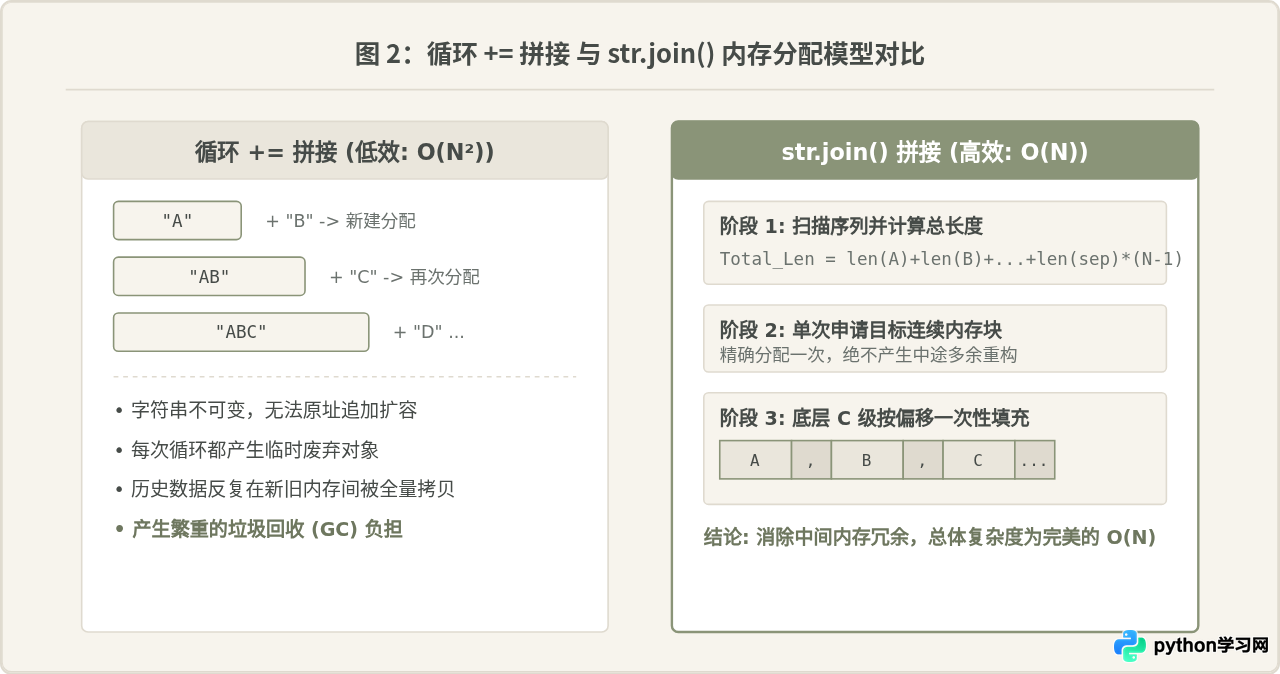
Python内部的字符串对象是不可变对象(Immutable)。这意味着字符串一旦在内存中创建,其内容与长度就固定不变,无法在原有内存末尾直接扩容追加。
当执行 s += item 时,底层必须执行以下操作:
- 向操作系统申请一块能够容纳
len(s) + len(item)的新连续内存空间; - 将原有
s中的字符完整拷贝到新内存块的前部; - 将
item的字符拷贝到新内存块的剩余位置; - 废弃旧的
s对象,等待垃圾回收(GC)。
在包含 $N$ 次迭代的循环中,第 $k$ 次拼接都需要拷贝此前累积的全部字符。总拷贝字符数呈现高斯求和公式增长:$\sum_{k=1}^{N} k \approx \frac{N^2}{2}$。这导致时间复杂度直接上升至 $O(N^2)$。随着拼接数量上升,程序耗时会呈现陡峭的二次方上升。
2. str.join() 的底层高效工作机制
与 += 的被动重新分配不同,delimiter.join(iterable) 在底层(CPython 实现)采用了“先计算、后分配、单次填充”的高效策略:
- 预先巡检长度:首先遍历可迭代对象中的所有元素,计算出所有子字符串的长度总和,再加上
(N - 1) * len(delimiter)的分隔符总长度; - 单次申请连续缓冲区:向系统一次性申请刚好能够装载最终结果的独立内存块;
- 按偏移量直接复制:底层的 C 代码通过内存拷贝函数(如
memcpy)按照已计算好的偏移量,依次将各个字符串和分隔符直接写入目标缓冲区。
整个过程没有任何中间字符串的创建与销毁,每个字符仅被拷贝一次,时间复杂度严格保持在 $O(N)$。
3. 处理非字符串元素:生成器、列表推导与 map 的权衡
join() 要求传入的可迭代对象中每一个元素都必须是 str 类型。如果包含数字、None或字典等对象,会直接抛出 TypeError: sequence item 0: expected str instance。
在将非字符串容器(如整数列表)转为字符串时,常见的写法有三种:
numbers = [101, 204, 305, 408, 512]

# 方式 1:列表推导式(推荐,执行速度最快,语法直观)
csv_line_1 = ",".join([str(x) for x in numbers])

# 方式 2:使用内置函数 map()(适合简单转换,底层 C 循环高效)
csv_line_2 = ",".join(map(str, numbers))

# 方式 3:生成器表达式(节省临时列表内存,但在数据量不大时迭代器开销略高)
csv_line_3 = ",".join(str(x) for x in numbers)
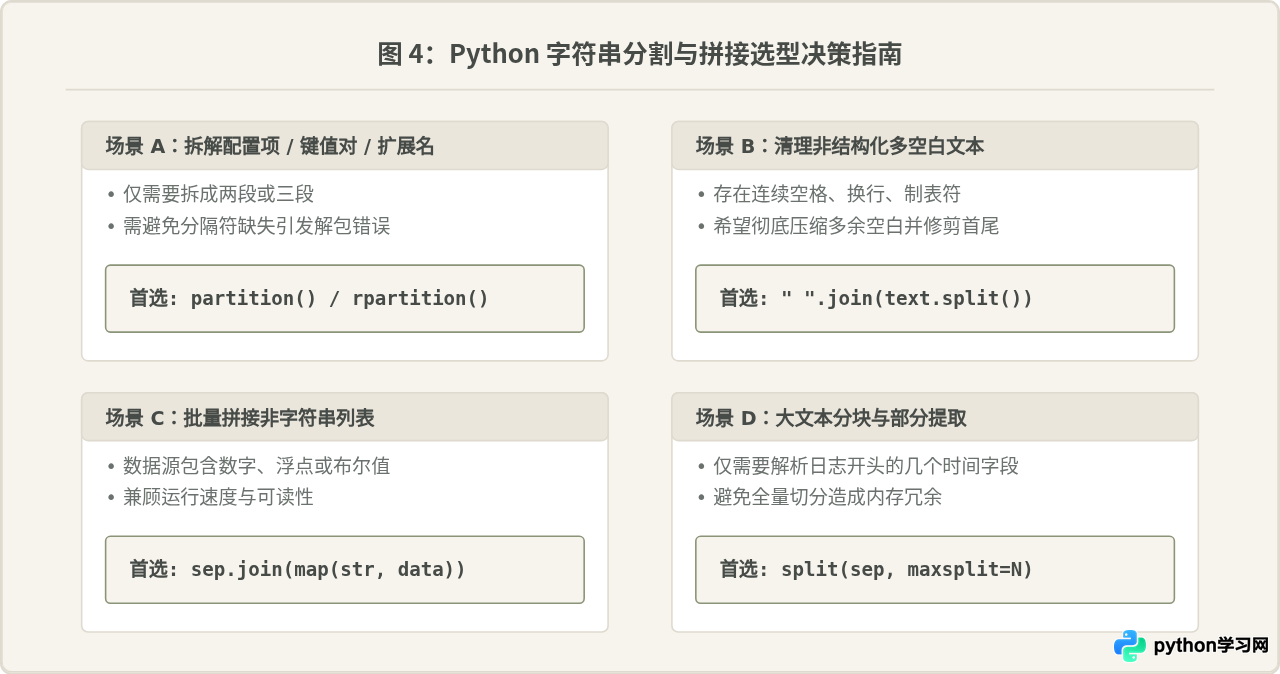
许多开发者误以为生成器表达式 ",".join(str(x) for x in numbers) 总是最快的,因为“它不产生中间列表”。然而事实是:由于生成器无法预先获知长度,join() 无法在第一阶段直接拿到总长度,内部必须动态扩展缓冲区或在底层先行收集为列表。因此,在内存可承受的常规规模下,列表推导式 [str(x) for x in numbers] 或 map(str, numbers) 的执行速度往往快于生成器表达式。
三、综合实战:文本清洗与字段规整流水线
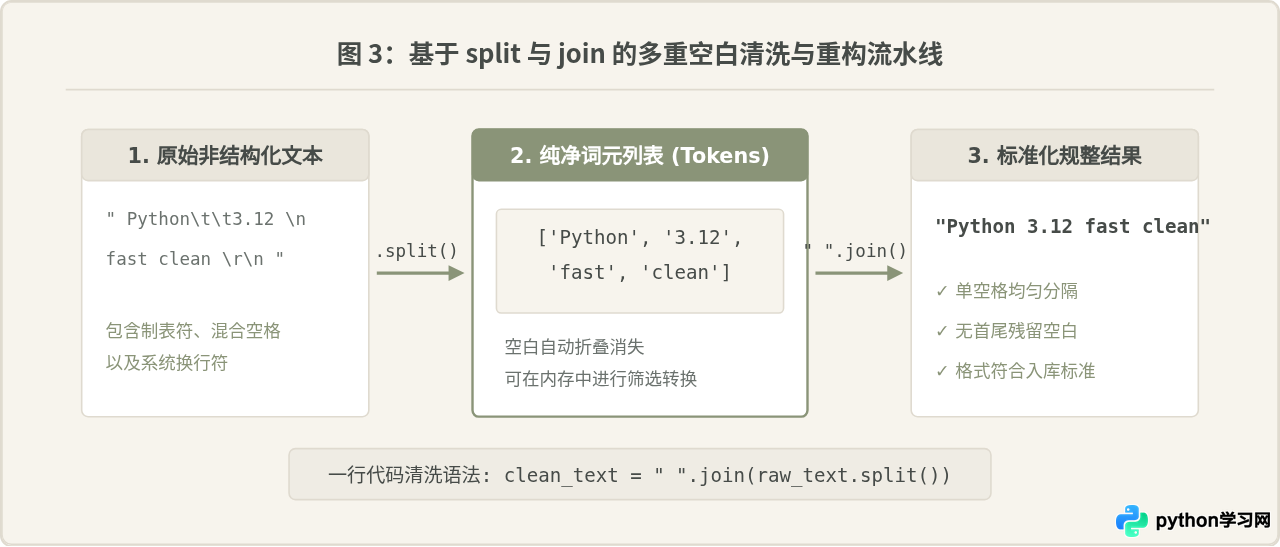
在实际项目(如日志分析、爬虫数据清洗、自然语言预处理)中,split() 与 join() 常常成对出现。典型的流水线模式是:通过 split() 拆散不规则输入,在列表阶段过滤无用项,最后通过 join() 用标准化分隔符重新聚合。
1. 经典一行式文本多余空格折叠
在很多数据预处理任务中,要求将段落中所有连续空格、换行符和制表符全部压缩为单一空格,并去除头尾空格。很多开发者尝试用复杂的正则表达式 re.sub(r'\s+', ' ', text).strip(),但这不仅需要编译正则引擎,而且在纯文本处理中运行速度并不占优势。
而利用 " ".join(text.split()),则完全在 Python 原生 C 扩展内部完成:split() 一次性解析出所有非空字符项,紧接着 join() 用单空格拼合。不仅代码极简,速度也极为强悍。
2. str.partition():三段式拆分的高性能替代
当只需要按照某个特定标记(如 =、:、@)将字符串切为“前半部分、分隔符、后半部分”三段时,split(sep, 1) 并非最轻量的方案。
Python提供了专用的 partition() 和 rpartition() 方法。它们返回一个固定的三元元组 (head, sep, tail):
config_item = "database.host = 127.0.0.1:5432"

# 使用 partition 进行三段式安全拆解
key, sep, val = config_item.partition("=")

if sep:
    key = key.strip()
    val = val.strip()
    print(f"配置键: [{key}], 配置值: [{val}]")
else:
    print("未找到分隔符")
# 示例输出:配置键: [database.host], 配置值: [127.0.0.1:5432]
与 split() 相比,partition() 始终返回长度为 3 的元组。如果找不到分隔符,它会返回 (original_str, '', ''),而不会抛出解包异常(如 ValueError: not enough values to unpack),在处理键值对配置时异常稳健且速度更快。
四、方法选择与避坑决策指南
在面对不同的文本处理需求时,选择最合适的方法不仅影响运行效率,也决定了边界条件下的容错能力。
三条关键注意事项
-
注意
splitlines()的边界:如果要按换行切分多行文本,尽量使用专门的text.splitlines()。它能统一识别\n、\r\n以及各种跨平台换行格式,并提供keepends=True/False参数控制是否保留换行符。 -
谨慎对大数据流进行无界拆分:面对数十兆甚至上百兆的单行文本,直接执行全量
split()会一次性在内存中创建海量的小字符串对象与指针列表。此时应结合find()或生成器配合maxsplit逐步消费。 -
固定长度拼接的特例:如果只有两到三个已知的固定字符串变量进行拼接,例如
f"{first}_{second}"或first + "_" + second,直接使用 f-string 或加号即可,Python会在编译期对其进行字节码层面的优化,无需刻意套用join()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















