


Python中for循环和while循环该怎么选择
在Python开发中,选择for循环还是while循环的核心准则非常明确:当需要遍历已知集合、可迭代对象或执行固定次数时,优先且坚定地选择for循环;而当循环的终止依赖于动态外部状态、收敛条件、未知轮数的等待或需要维持后台守护进程时,才使用while循环。在Python语言哲学中,for循环被赋予了极其高级且高效的抽象,绝大多数日常任务都应是for循环的舞台。
一、本质差异:迭代器驱动与状态驱动
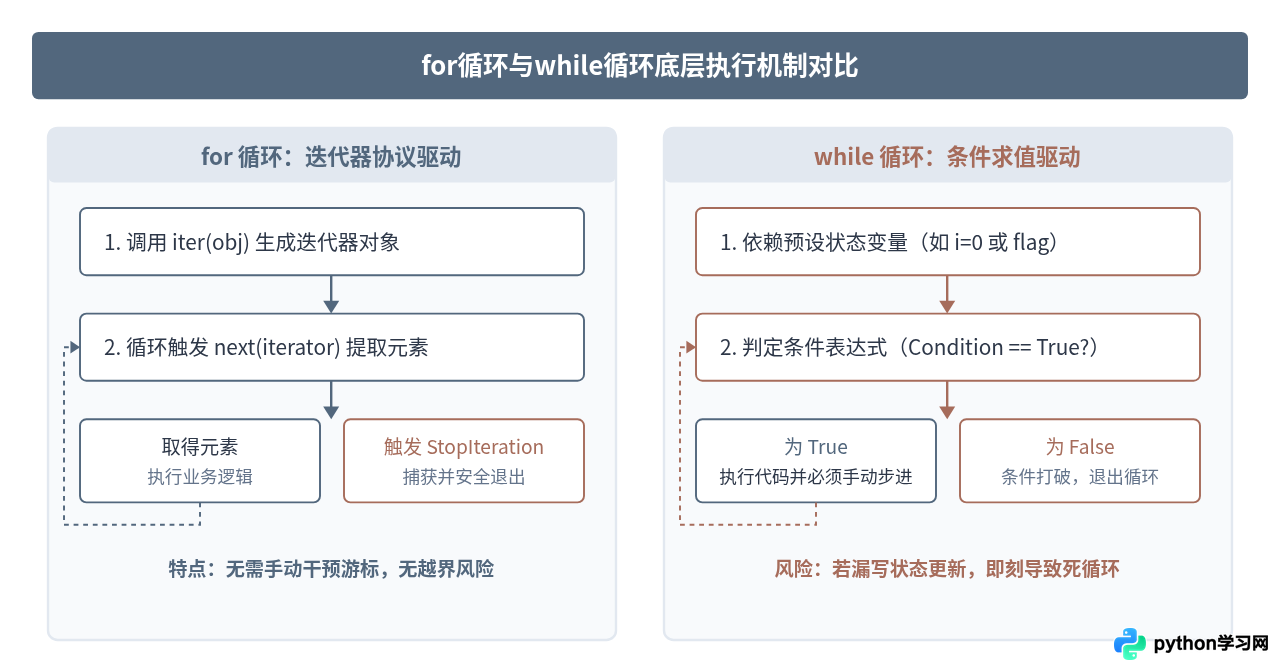
初学者容易将for与while简单地看作“换了写法的同种计数器”,这种理解遮蔽了Python最核心的语言特性。在C语言或早期的编程语言中,for循环本质上也是“初始化、条件判定、步进操作”的打包形式;但在Python中,for循环不是简单的数字步进,而是基于迭代器协议(Iterator Protocol)构建的高级管道。
当你编写for item in collection:时,Python在底层自动调用了iter(collection)获取迭代器,并在每一轮循环中调用next()取出下一个元素,直到遇到StopIteration异常后自动优雅退出。开发者无需关心集合有多长、当前下标是多少,也无需提防指针越界。
相对而言,while循环属于纯粹的布尔状态守卫(Condition Guard)。它只在每次循环开始前评估一个条件表达式:为True则执行块内语句,为False则离开。这意味着while循环内部必须显式地推进某种能够改变判定条件的状态,否则程序就会陷入无限死循环。
二、四步选型法则:清晰的决策路径
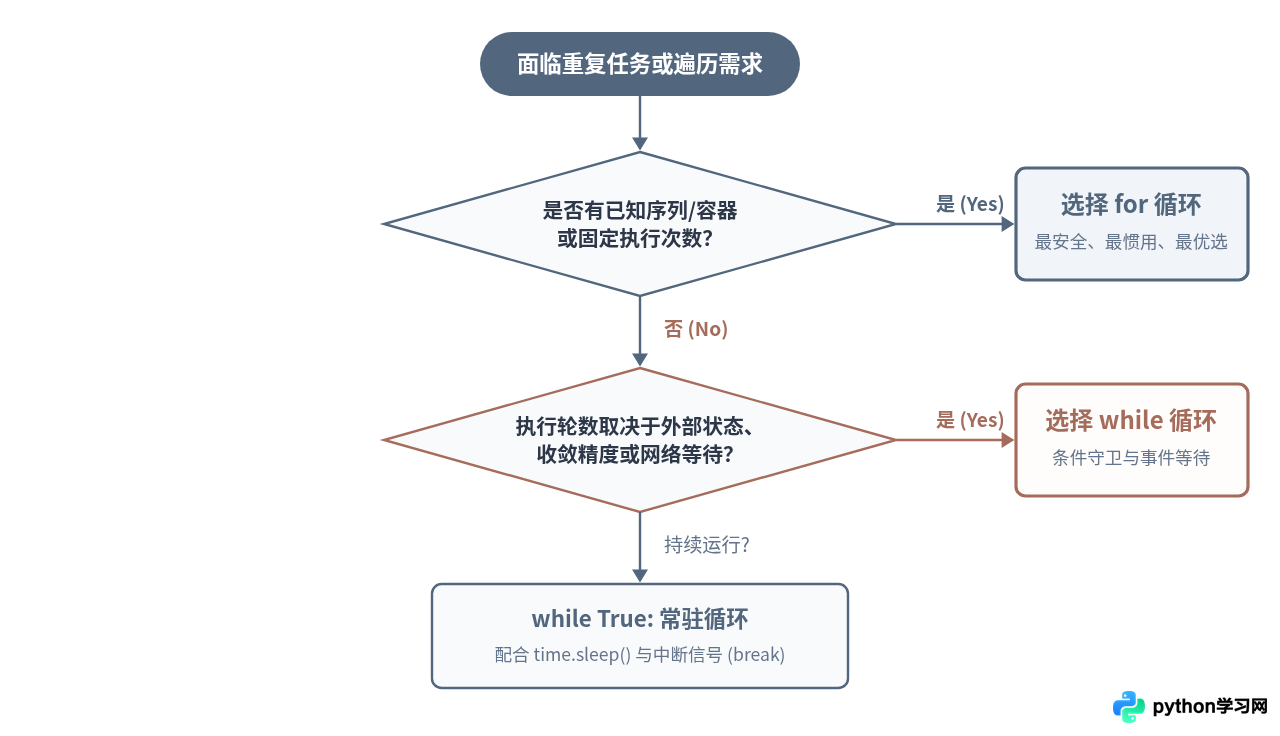
当你面对一个需要重复执行的任务时,不需要凭直觉猜测,可以通过以下四个逻辑节点迅速敲定选择:
- 第一问:数据源是不是可迭代对象或次数固定?
如果是列表、元组、字符串、字典、集合、生成器、文件对象,或者有固定的执行次数range(N),选for。 - 第二问:循环终止由“数据穷尽”还是“外部条件突变”决定?
如果是读取完所有数据项自然停下,选for;如果是在未知的某一时刻,某个状态变假(例如用户输入了指定字符、或者数值收敛到了误差阈值内),选while。 - 第三问:步长是否需要非线性跳跃或动态回退?
如果步长需要根据每一步的计算结果动态增加3、减少1或者重置游标(如指针双向逼近、语法解析器),while更为灵活;若步进固定,for更清晰。 - 第四问:是否是常驻后台的任务或事件监听器?
守护进程、Web服务器事件轮询、GUI消息循环通常需要持续运行,直接选用while True:搭配响应条件退出。
三、典型场景与实操对比
1. 集合遍历与计数:for与内置工具的绝对优势
在其他语言(如C或传统JavaScript)中,遍历数组通常使用下标计数:
# 不推荐的类C风格(啰嗦且易错)
fruits = ["apple", "banana", "cherry"]
index = 0
while index < len(fruits):
    print(index, fruits[index])
    index += 1
在Python中,这种写法被视为反模式(Anti-Pattern)。不但代码冗长,而且容易因为遗漏index += 1而死循环,或者因为拼写错误引发IndexError。Python标准写法应为:
# Pythonic风格:清晰、安全、高效
for index, fruit in enumerate(fruits):
    print(index, fruit)
如果不需要下标,直接写for fruit in fruits:即可;如果需要并行遍历多个序列,使用zip();如果需要字典的键值对,使用for k, v in data.items():。这些内置工具都是基于迭代器构建的,无论在运行效率还是代码可读性上都显著胜出。
2. 不确定步数的外部交互与轮询:while的典型阵地
当循环的轮数在进入循环前完全未知,必须根据运行时获取的输入或网络状态判定时,while是不二之选。
# 场景:要求用户输入有效数字,直到输入合法为止
user_value = None
while user_value is None:
    raw_input_str = input("请输入一个正整数: ").strip()
    if raw_input_str.isdigit():
        user_value = int(raw_input_str)
    else:
        print("输入无效,请重新输入。")

print(f"成功获取输入值: {user_value}")
在这个场景中,程序无法预判用户会输错一次、三次还是十次,因此无法构建一个确定长度的迭代对象。while循环直截了当地反映了业务含义:“当user_value依然为空时,持续询问”。
3. 数值逼近与收敛计算
在算法与科学计算中,很多迭代算法(如牛顿法求平方根、梯度下降法)是以误差小于容忍阈值作为终止标准的,循环次数取决于收敛速度:
# 场景:牛顿法求平方根,迭代至误差小于 1e-7
target = 25.0
guess = target / 2.0
tolerance = 1e-7

while abs(guess * guess - target) > tolerance:
    guess = (guess + target / guess) / 2.0

print(f"计算结果: {guess:.6f}")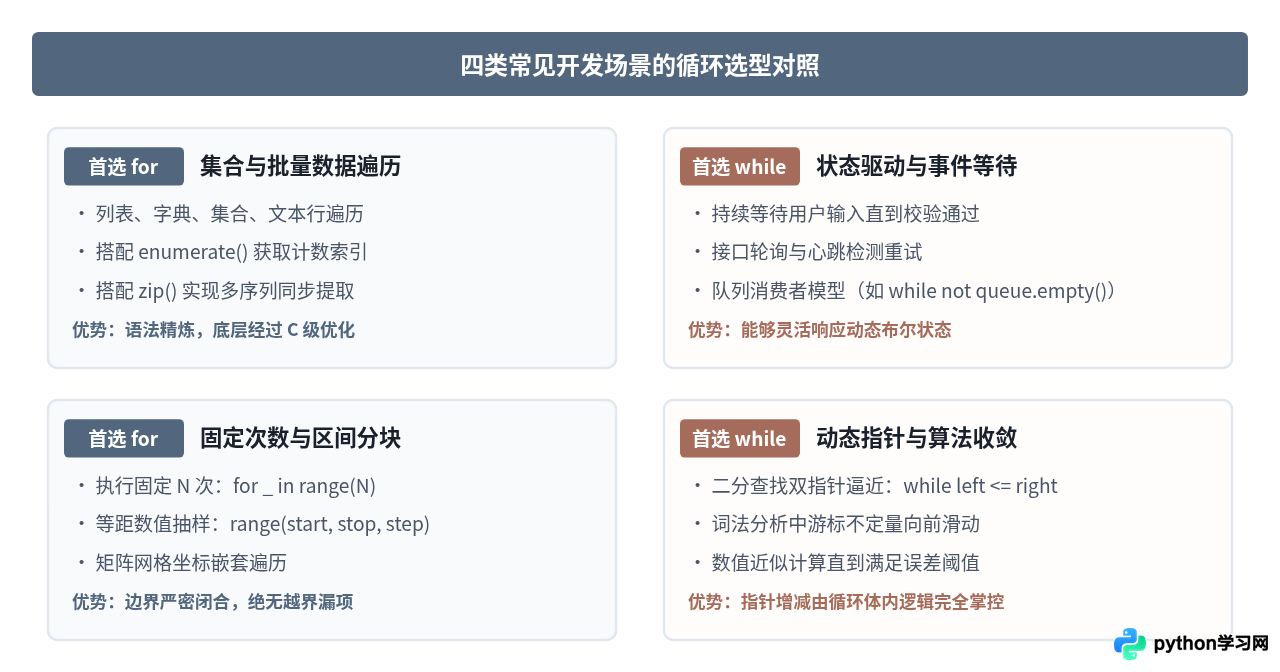
四、容易踩坑的边界与注意事项
避坑准则 1:谨防在 for 循环中修改正在遍历的列表
如果尝试在遍历列表的同时调用list.remove()或del,迭代器内部维护的索引会发生位移,导致部分元素被跳过。正确做法是遍历该列表的原型副本:for item in my_list[:]:,或改用列表推导式生成新列表。
避坑准则 2:编写 while 循环时先写步进语句
几乎所有非预期的死循环都是因为循环体内部的分支遗漏了步进代码。例如使用了continue却把递增语句放在了continue之后。在写下while condition:后,第一件事应当明确写出改变状态的逻辑。
性能差异提示:for 循环的速度通常更快
在CPython解释器中,for循环的迭代提取是在底层C代码中快速完成的;而while循环每一轮都需要在Python虚拟机字节码层面重新求值布尔表达式、增加Python整数对象,开销相对更大。因此在处理海量数据时,for循环不仅简洁,吞吐速度也更高。
五、全维度对比总结
为了帮助大家在日常编码中形成肌肉记忆,以下将两者的特性进行了横向梳理:
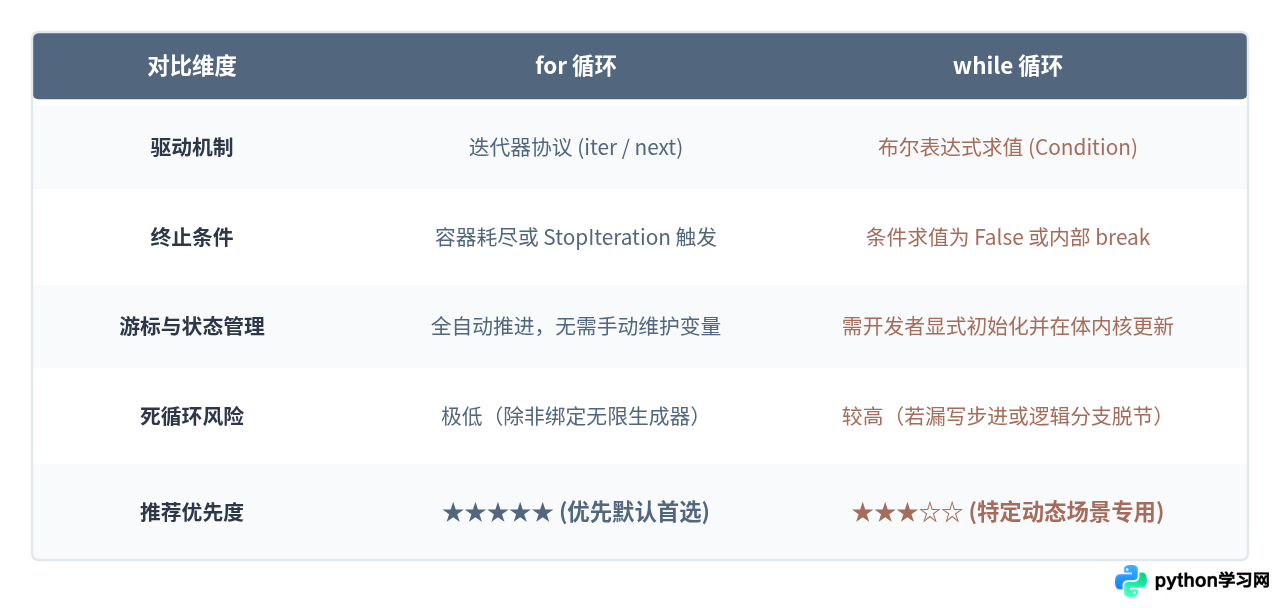
简而言之,只要能数得清次数、列得出对象,默认选for循环;只要是在等待某件事发生、按步长动态试探或维持后台常驻,再考虑while循环。掌握两者的分工边界,写出的Python代码自然会更加清晰、稳健且符合Pythonic的工程标准。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















