


不依赖第三方库手动实现Python中位数算法
中位数(Median)是统计学中用于度量一组数据集中趋势的重要指标。与算术平均数相比,中位数的一大优势是能够自然过滤极端偏离的异常值(Outliers)。在日常开发中,许多人习惯直接调用第三方科学计算库 numpy.median() 或标准库的 statistics.median()。但在无第三方依赖约束的极简部署环境、资源受限设备或算法能力考察场景下,手动编写中位数求解逻辑是一项基本功。本文将从核心数学逻辑出发,循序渐进演示从基础排序切片到平均时间复杂度达到 $O(N)$ 的快速选择(Quickselect)算法,彻底解决不依赖任何第三方库求中位数的问题。
一、中位数的数学定义与索引映射原理
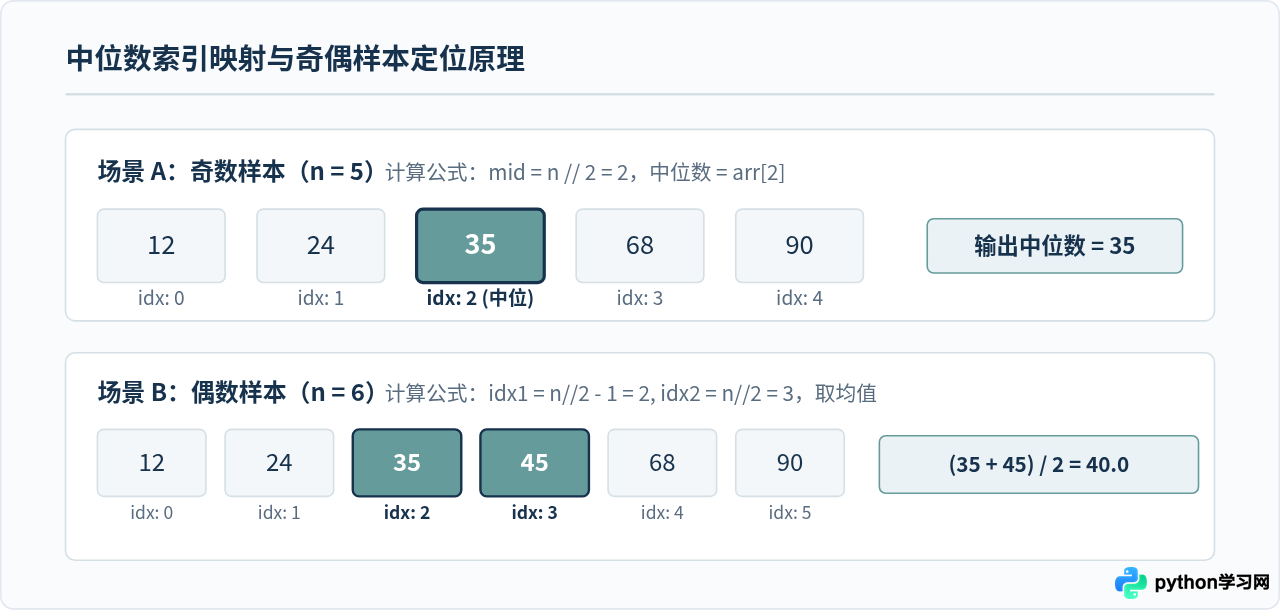
中位数是将有限数值集合升序排序后,处于最中间位置的数值。求解中位数的首要前提是对原始数据完成有序排列,随后根据序列长度的奇偶性采用不同的取值策略:
- 奇数样本量($n$ 为奇数):序列存在唯一的物理中心元素。设排序后列表为
arr,中心下标为mid = n // 2(例如长度为 5 时,中间下标为 2),中位数即为arr[mid]。 - 偶数样本量($n$ 为偶数):序列中央包含两个数值,分别位于下标
mid - 1与mid(其中mid = n // 2,例如长度为 6 时,中轴两数为下标 2 与 3),中位数为两者的算术平均值,即(arr[mid - 1] + arr[mid]) / 2。
二、标准操作流程与基础手写实现
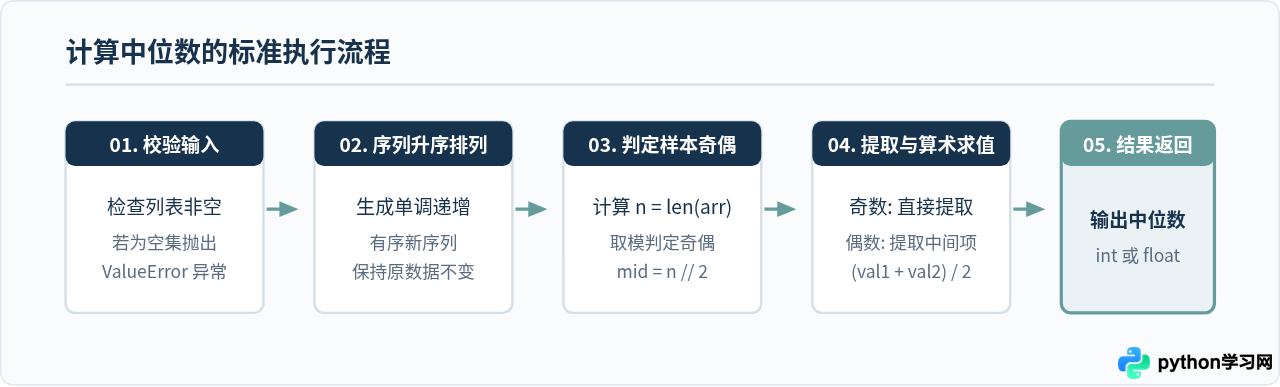
编写一个健壮的中位数函数,绝不能仅写两行切片逻辑,必须遵循规范的防御性编程流程。标准计算流程通常分为五个阶段:数据有效性校验、序列排序、求取样本长度、奇偶分支判断以及格式化输出。
1. 基于 Python 内置排序的基础实现
如果业务要求仅是“不引入任何第三方外置库(如 NumPy、Pandas)”,使用 Python 内置的高性能 sorted()(底层基于 TimSort)是综合代码行数与可靠性最高的方式:
def calculate_median(data):
    """
    不依赖第三方库计算数值列表的中位数
    :param data: 包含数字的可迭代序列(list 或 tuple)
    :return: int 或 float 类型的中位数
    """
    if not data:
        raise ValueError("输入序列不能为空序列")

    # 转为列表并升序排序,避免修改原序列
    sorted_data = sorted(data)
    n = len(sorted_data)
    mid = n // 2

    # 根据奇偶性返回对应值
    if n % 2 == 1:
        return sorted_data[mid]
    else:
        return (sorted_data[mid - 1] + sorted_data[mid]) / 2.0

# 示例验证
if __name__ == "__main__":
    odd_list = [7, 1, 3, 9, 5]
    even_list = [10, 2, 8, 4, 6, 12]

    print("奇数序列中位数:", calculate_median(odd_list))   # 排序后 [1, 3, 5, 7, 9],中位数为 5
    print("偶数序列中位数:", calculate_median(even_list))  # 排序后 [2, 4, 6, 8, 10, 12],中位数为 (6+8)/2 = 7.0
避坑提示:在处理偶数长度中位数时,请使用除法运算符 / 2.0 或 / 2(在 Python 3 中均为浮点除法),而不要使用整除符号 // 2。例如针对 [1, 2],正确中位数是 1.5,如果使用 // 2 会导致结果截断为 1,产生逻辑错误。
三、彻底脱离内置工具:手写纯排序算法
在部分严苛的面试或教学环境中,要求“不仅禁止第三方包,也禁止使用 Python 内置的 sorted() 与 .sort()”。此时,我们需要从底层手写一个基础排序算法。这里选用归并排序(Merge Sort)或快速排序(Quick Sort)实现完全无内建辅助的自包含逻辑。
def manual_sort(arr):
    """纯手写归并排序,时间复杂度稳定在 O(N log N)"""
    if len(arr) <= 1:
        return list(arr)

    mid = len(arr) // 2
    left = manual_sort(arr[:mid])
    right = manual_sort(arr[mid:])

    # 双指针合并两个有序列表
    merged = []
    i = j = 0
    while i < len(left) and j < len(right):
        if left[i] <= right[j]:
            merged.append(left[i])
            i += 1
        else:
            merged.append(right[j])
            j += 1

    merged.extend(left[i:])
    merged.extend(right[j:])
    return merged

def calculate_median_pure(data):
    """完全脱离任何内置排序实现的中位数求解"""
    if not data:
        raise ValueError("输入数据不可为空")

    ordered = manual_sort(data)
    n = len(ordered)
    mid = n // 2

    if n % 2 == 1:
        return ordered[mid]
    else:
        return (ordered[mid - 1] + ordered[mid]) / 2.0

# 运行验证
sample = [42, 17, 88, 8, 23]
print("纯手写排序求解中位数:", calculate_median_pure(sample))  # 结果为 23
四、进阶极致优化:$O(N)$ 快速选择算法(Quickselect)
上述全排序方案存在天然的算力浪费:为了获取第 $k$ 位的中位数,全排序算法对所有的 $N$ 个元素都排定了相对位置,耗费了 $O(N \log N)$ 的时间。然而,数学上我们只需要知道“排在正中间的那一个或两个数”,并不关心其余元素内部是否有序。
快速选择算法(Quickselect)由 Tony Hoare 提出,借用快速排序的 Partition(分区划分)机制:每次挑选一个基准值(Pivot),将小于基准的数移到左侧,大于等于的移到右侧。由于基准最终落在确切下标 p 上:
- 若
p == k,说明找到了第 $k$ 小的元素,直接返回; - 若
p > k,目标必定在左半区间,仅需递归左侧; - 若
p < k,目标必定在右半区间,仅需递归右侧。
每次只需深入单侧分支,搜索空间几何级数递减($N + N/2 + N/4 + \dots \approx 2N$),因此平均时间复杂度仅为 $O(N)$。
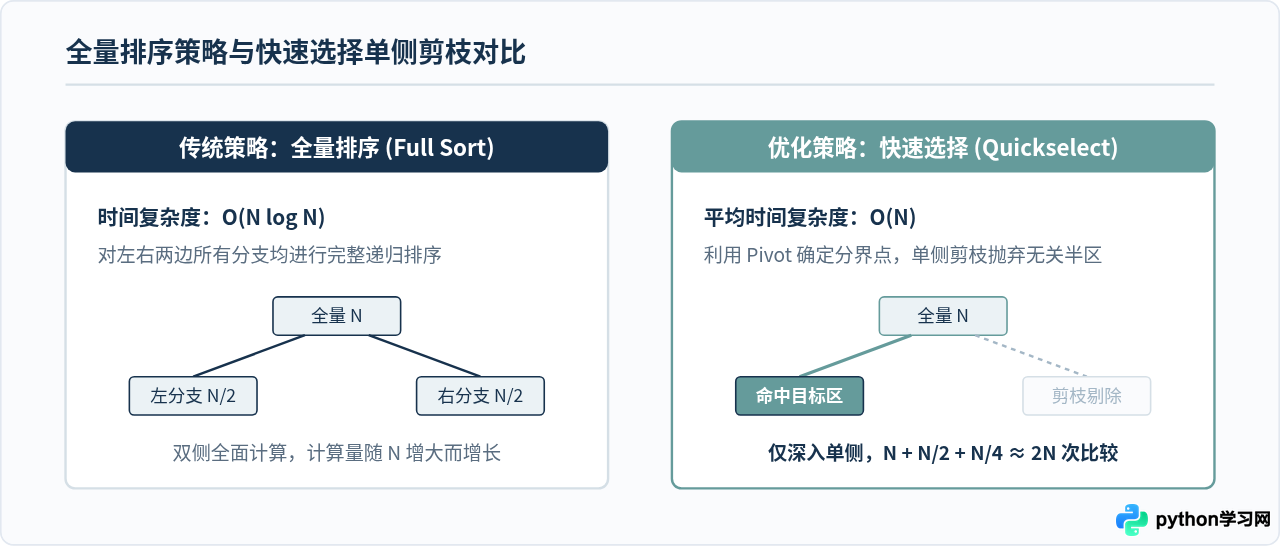
对于偶数列表,中位数依赖第 n//2 - 1 和第 n//2 两个位置的元素。我们在快速选择中分别查找这两个下标并求平均即可。以下是完整代码:
def _partition(arr, left, right):
    """Lomuto 分区法:以末尾元素为基准进行划分"""
    pivot = arr[right]
    i = left
    for j in range(left, right):
        if arr[j] < pivot:
            arr[i], arr[j] = arr[j], arr[i]
            i += 1
    arr[i], arr[right] = arr[right], arr[i]
    return i

def quickselect(arr, left, right, k):
    """
    寻找数组中第 k 小的元素(0-indexed)
    :param arr: 可变列表
    :param left: 搜索区间左边界
    :param right: 搜索区间右边界
    :param k: 目标下标
    """
    while left <= right:
        pivot_idx = _partition(arr, left, right)
        if pivot_idx == k:
            return arr[pivot_idx]
        elif pivot_idx > k:
            right = pivot_idx - 1
        else:
            left = pivot_idx + 1
    return arr[k]

def calculate_median_quickselect(data):
    """使用快速选择算法高效求中位数,平均时间复杂度 O(N)"""
    if not data:
        raise ValueError("输入数据不可为空")

    nums = list(data)
    n = len(nums)
    mid = n // 2

    if n % 2 == 1:
        return quickselect(nums, 0, n - 1, mid)
    else:
        # 偶数长度求两次选择
        v1 = quickselect(nums, 0, n - 1, mid - 1)
        v2 = quickselect(nums, 0, n - 1, mid)
        return (v1 + v2) / 2.0

# 运行验证
test_data = [105, 33, 55, 12, 90, 48, 77]
print("快速选择中位数结果:", calculate_median_quickselect(test_data))  # 排序后 [12, 33, 48, 55, 77, 90, 105],中位数 55
五、工程实践与边界异常处理
在实际生产中,手动实现算法必须考虑各种边界情况:
- 空集抛出:当传入
[]时,数学上中位数无定义。务必显式抛出ValueError("输入列表不可为空"),严禁隐式产生IndexError。 - 单元素特例:当
len(arr) == 1时,中位数即该元素本身。上述代码由于1 % 2 == 1且1 // 2 == 0,能无缝返回arr[0],无需特殊分支。 - 数据类型保持:当原数组为整数且为奇数长度时,返回
int保持精度;当偶数长度取平均时,通常返回float。若对整型有严格要求的场景,需与下游约定格式。 - 不可变输入原则:Python 传递列表引用时,若在函数内部使用原地排序或交换(例如
arr.sort()或 Lomuto Partition),会产生外部副作用,改变调用方原有的数组顺序。因此在算法入口处应当使用list(data)创建独立副本。
六、方案对比与技术选型总结
为了在实际开发中快速选用最合适的技术方案,各实现维度的对比如下:
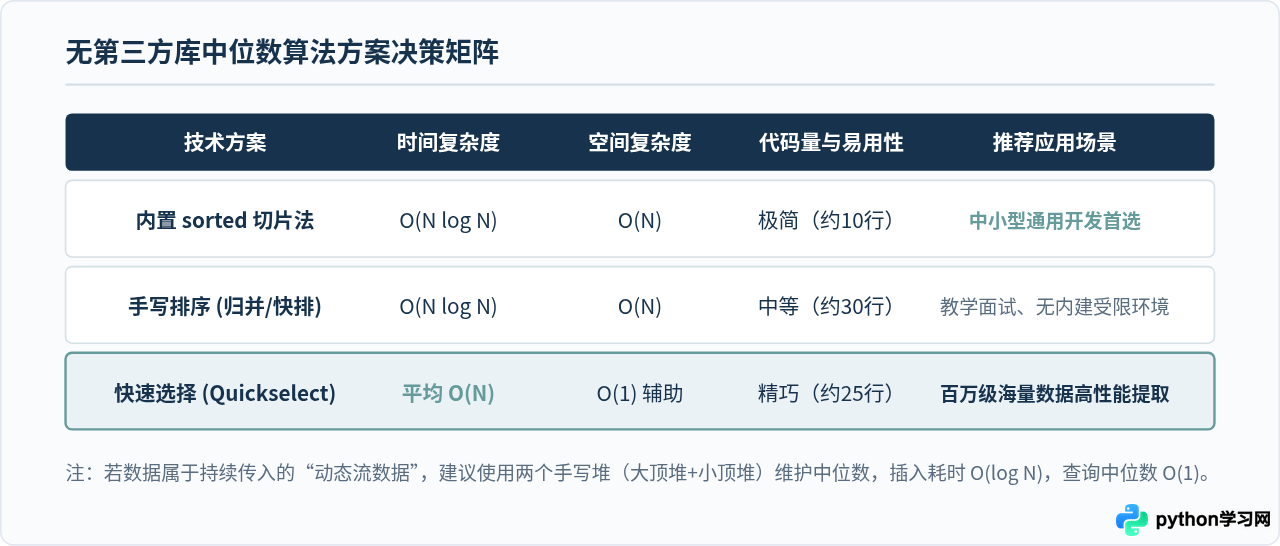
综上所述,在日常无第三方库约束的通用业务中,优先使用 sorted() 配合奇偶索引映射,实现代码短、易读且性能优异;在数据规模达到数十万至数百万的静态数据集场景下,使用手写快速选择(Quickselect)能够带来显著的运行耗时优化。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















