


Python大数据可视化怎么做?推荐支持高性能渲染的可视化工具
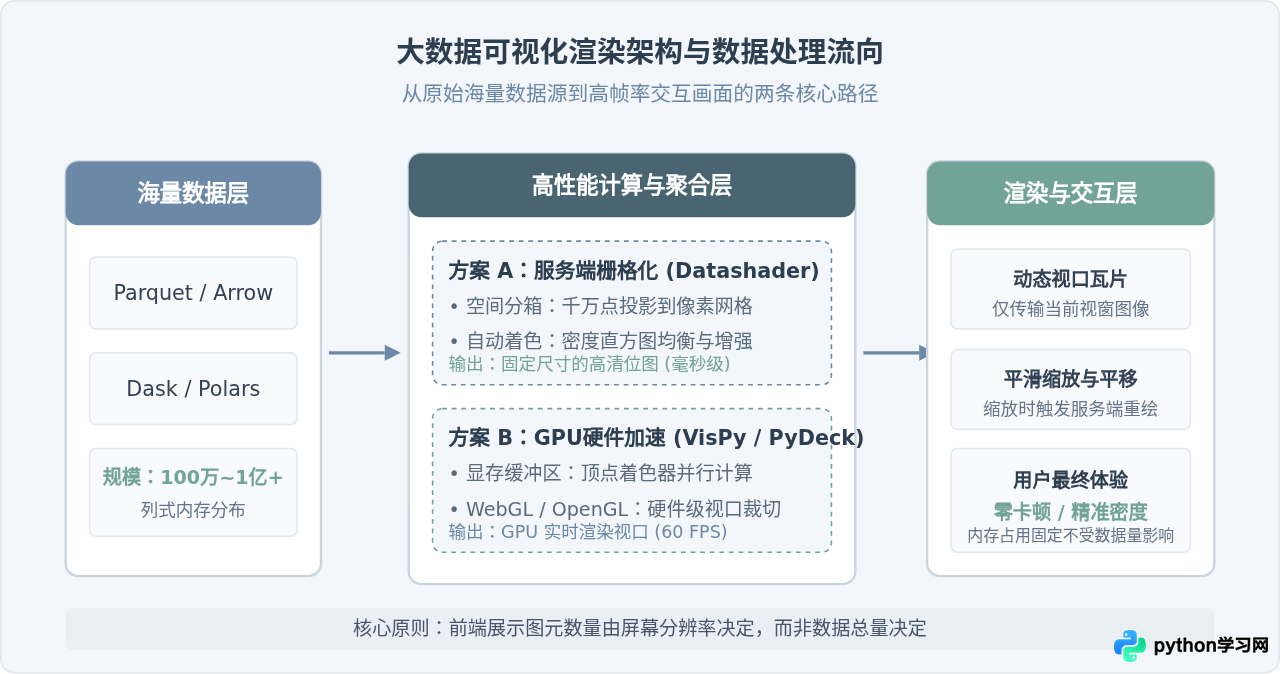
处理百万到千万级别的大规模数据时,传统的可视化库(如 Matplotlib、Seaborn)往往会因为绘制数百万个图形对象而导致内存爆满、界面彻底卡死。解决 Python 大数据可视化的核心路径是改变渲染范式:放弃“将每个数据点作为独立几何图元渲染到前端 DOM 或画布”的做法,转向“服务端聚合栅格化(如 Datashader)”或“GPU 硬件加速与着色器管线(如 VisPy、PyDeck、WebGL)”。本文将直接拆解大数据可视化的底层机制,对比推荐适合的主流高性能工具,并提供清晰落地的完整操作步骤。
一、为什么常规可视化工具在大数据下会卡死?
理解大数据可视化的第一步,是明确传统绘图工具的瓶颈究竟发生在哪里:
- DOM / 矢量对象爆炸:以常见的基于浏览器 SVG/HTML5 Canvas 的可视化库为例,如果试图向浏览器绘制 100 万个独立的
<circle>节点,内存消耗会直接飙升至数吉字节(GB),单次重绘耗时可达数秒乃至分钟级,导致浏览器标签页直接崩溃。 - 过度绘制与信息冗余(Overplotting):普通显示屏的分辨率一般在 1920×1080 到 3840×2160 之间,全屏有效像素仅在 200 万至 800 万之间。当你有 5000 万个数据点时,数十甚至上百个点会重叠在同一个物理像素中。强行绘制每一个点,不仅会遮蔽真实的数据密度分布,而且浪费了 99% 的计算与绘图性能。
- Python 单线程与数据传输开销:将海量原始数据经由 JSON 序列化传送到前端也会造成严重的性能瓶颈。
二、主流支持高性能渲染的 Python 可视化工具对比
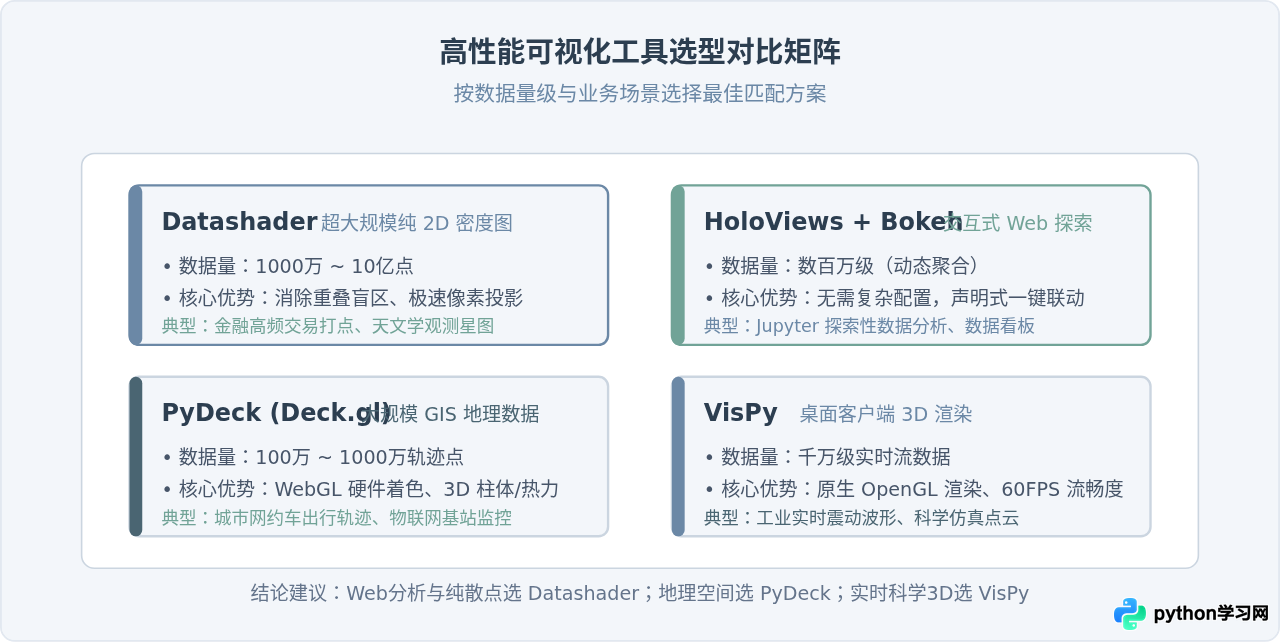
面对海量数据,社区已经发展出多款成熟的针对性方案。根据图形硬件利用方式与场景定位,主要推荐以下四款工具:
1. Datashader:超大规模数据聚合与栅格化事实标准
Datashader 是 Python 生态中处理超亿级数据散点、折线和网络图的最强大工具。它采用“服务端渲染”策略:首先根据显示区域的分辨率(例如 1000×600)建立网格,利用多核 CPU(Numba JIT 加速)或 GPU(CuPy)计算每个网格内落入的数据点数量或聚合指标,最后将聚合结果直接渲染为一张高质量位图传输给前端展示。无论原始数据是 100 万还是 1 亿,前端浏览器看到的都只是一张尺寸固定的图片,因此内存与交互开销完全可控。
2. VisPy:基于 OpenGL 的桌面级硬件加速渲染器
如果需要在本地 Python 客户端(或 PyQt、PySide 桌面程序)中实现数千万数据点的高帧率(60 FPS)实时 3D 渲染与动态交互,VisPy 是最佳选择。VisPy 通过 ctypes 直接调用底层 OpenGL 管道,让开发者能够利用 GPU 顶点着色器(Vertex Shader)和片段着色器高效绘制海量点云、网格与流体模拟数据。
3. Bokeh 与 HoloViews:具备交互体验的大数据展示组合
Bokeh 本身适合中等规模数据(数万至十万点),但当与 HoloViews 及 Datashader 组合使用(holoviews.operation.datashader)时,它能够提供现代化的交互体验:用户在网页中拖拽缩放时,前端将新的视口坐标范围发送到 Python 后端,Datashader 动态重新计算聚合切片,再实时刷新给 Bokeh。这种“动态重采样”机制让千万级数据也能支持缩放探索。
4. PyDeck (Deck.gl for Python):大规模地理空间与时空轨迹利器
对于地理信息、轨迹定位、三维柱状图等涉及 GIS 的大数据场景,由 Uber 开源的 Deck.gl Python 包装库 PyDeck 表现出色。它基于 WebGL 硬件加速,能在浏览器端直接流畅渲染数百万条带经纬度的 GPS 轨迹、热力图或 3D 建筑高程,且与 Pandas、GeoPandas 紧密无缝整合。
| 工具名称 | 底层渲染引擎 | 适用数据规模 | 典型场景 | 学习曲线 |
|---|---|---|---|---|
| Datashader | Numba/CuPy 像素级栅格化 | 1000万 ~ 10亿+ | 海量散点分布、密度热图、网络连接图 | 中等 |
| VisPy | 原生 OpenGL / 着色器 | 500万 ~ 5000万 | 科学计算、3D 点云、本地动态流式监测 | 较高 |
| HoloViews + Bokeh | HTML5 Canvas + 动态下采样 | 100万 ~ 1亿(配 Datashader) | Web 仪表盘、Jupyter 交互分析探索 | 较低 |
| PyDeck | WebGL (Deck.gl) | 100万 ~ 1000万 | 地理位置、轨迹热力、三维空间数据 | 中等 |
三、实战指南:使用 Datashader 与 HoloViews 实现千万级数据可视化
下面以最通用的 1000 万行经纬度坐标散点数据为例,展示从环境准备、数据生成到高性能交互渲染的完整操作过程。
步骤 1:安装必要依赖
推荐在独立 Python 虚拟环境中使用 conda 或 pip 进行安装。为了获得完整的动态渲染能力,我们需要 datashader、holoviews、bokeh 和用于色彩增强的 colorcet:
# 推荐使用 pip 或 conda 安装核心组件
pip install datashader holoviews bokeh colorcet pandas numpy
步骤 2:生成海量测试数据与构建渲染流水线
以下代码首先利用 NumPy 快速生成 1000 万个双变量正态分布点,然后使用 Datashader 的 Canvas 投影到固定像素网格并完成聚合上色:
import numpy as np
import pandas as pd
import datashader as ds
import datashader.transfer_functions as tf
from colorcet import fire

# 1. 准备数据:生成 10,000,000 个测试散点
print("正在生成 1000 万个数据点...")
n = 10_000_000
np.random.seed(42)

# 模拟两个中心的数据分布
x = np.concatenate([np.random.normal(0, 1, n // 2), np.random.normal(2, 1.5, n // 2)])
y = np.concatenate([np.random.normal(0, 1, n // 2), np.random.normal(2, 0.8, n // 2)])
df = pd.DataFrame({'x': x.astype('float32'), 'y': y.astype('float32')})

# 2. 创建 Datashader 画布(指定输出的像素分辨率)
cvs = ds.Canvas(plot_width=900, plot_height=600)

# 3. 聚合:计算每个像素网格内的数据点计数
print("正在进行网格栅格化聚合...")
agg = cvs.points(df, 'x', 'y')

# 4. 传输着色:使用直方图均衡与预设色彩表生成图片
img = tf.shade(agg, cmap=fire, how='eq_hist')

# 5. 保存结果或直接在 Jupyter 中展示
img.to_pil().save("datashader_10m_result.png")
print("渲染完成!耗时通常在 1 秒以内,已保存为 datashader_10m_result.png")cvs.points(df, 'x', 'y'):这是性能加速的关键。Datashader 内部通过 Numba 预编译机器码,直接并行遍历内存数组,数秒内即可完成上千万点的栅格计数。how='eq_hist':直方图均衡化(Equalized Histogram)。在极端稠密与极端稀疏并存的数据集中,线性插值会导致低密度点看不清。直方图均衡能自适应展开各区间的色彩阶数,清晰暴露细微的局部聚集特征。
步骤 3:与 Bokeh / HoloViews 结合实现平移缩放
如果希望在网页中直接拥有交互式平移与放大镜体验,可以使用 HoloViews 的 datashade 动态包装器:
import holoviews as hv
from holoviews.operation.datashader import datashade
hv.extension('bokeh')

# 将 Pandas DataFrame 声明为 HoloViews 点集
points = hv.Points(df, kdims=['x', 'y'])

# 使用 datashade 操作符包装:在视口发生变动时自动重新计算聚合网格
interactive_plot = datashade(points, cmap=fire).opts(width=900, height=600)

# 保存为独立 HTML 页面或在 Jupyter 中直接输出
hv.save(interactive_plot, 'interactive_bigdata.html')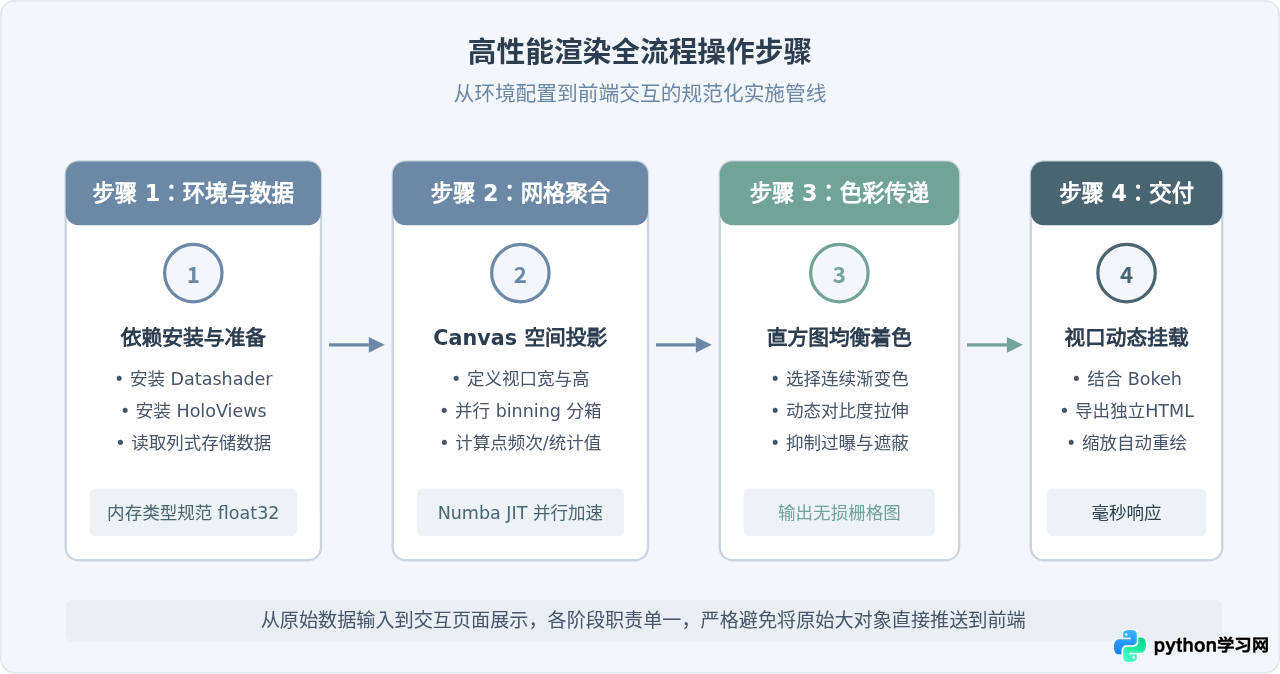
四、大数据可视化的关键优化技巧与注意事项
在工程实际落地中,仅仅更换绘图库还不足以保证系统的稳定性,还需要注意以下性能实践规则:
- 使用列式内存格式存储数据:避免使用体积臃肿且加载缓慢的 CSV 文件。在海量数据读取时,优先使用 Apache Parquet 或 Feather / Arrow 格式。它们不仅支持按需读取特定列,而且内存映射技术(Memory Mapping)允许在不把整个文件载入 RAM 的前提下直接进行切片与聚合计算。
- 降采样(Downsampling)与空间索引:对于折线图或时间序列图,可采用 LTTB(Largest-Triangle-Three-Buckets)降采样算法。该算法能在将 500 万个时序点缩减到 2000 个点的同时,完美保留肉眼可见的尖峰、低谷和趋势特征,使普通绘图库也能秒级完成渲染。
- 压缩数值精度:在不需要双精度浮点的场景下,主动将数据从
float64转为float32或float16,可以将内存占用直接减少 50% 到 75%,大幅减轻内存总线带宽负担并提升缓存命中率。 - 启用 GPU 计算后端:如果机器配备了 NVIDIA 显卡,可以配合 RAPIDS cuDF 和 CuPy,将 Datashader 的底层聚合过程直接放到 GPU 显存中执行,数据吞吐量可再提升一个数量级。
五、总结
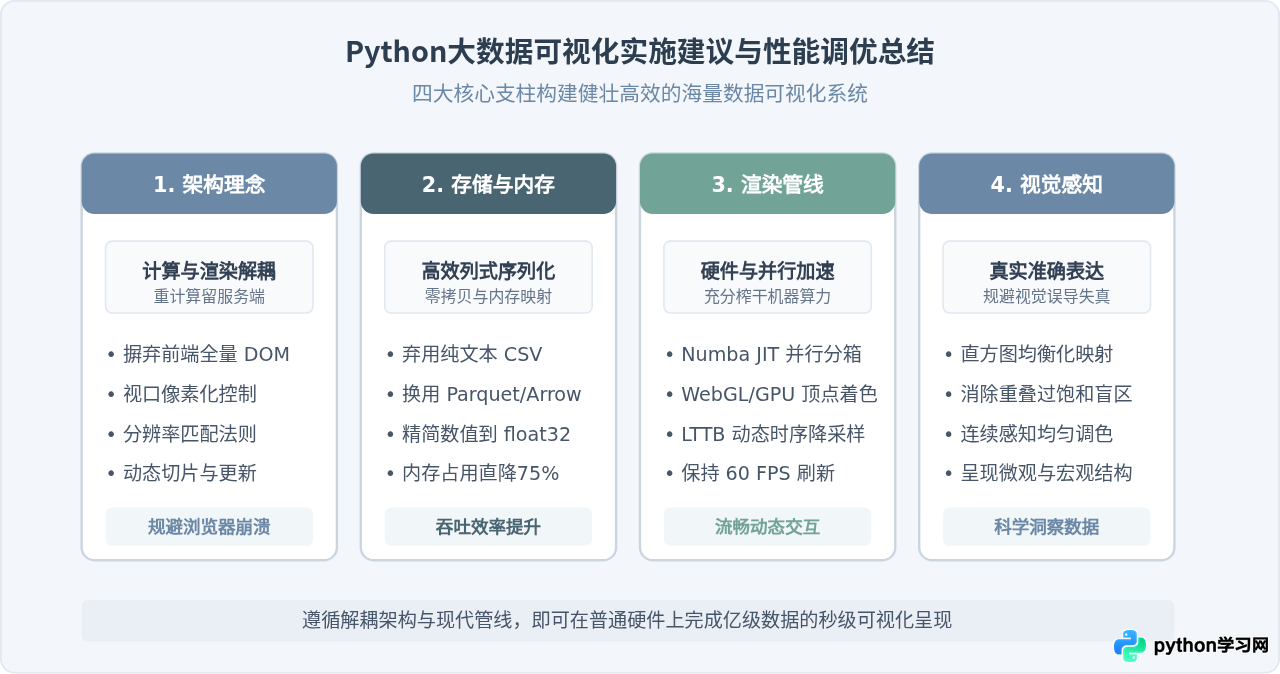
做 Python 大数据可视化的核心并不是寻找“绘制速度更快的 Matplotlib”,而是从根本上转变渲染思想。面对海量数据时:
- 如果是统计分析、科学探索或全量散点密度观测,首选 Datashader(可配合 HoloViews/Bokeh 提供动态交互);
- 如果是地理位置、轨迹热力图或三维空间网格,首选基于 WebGL 的 PyDeck;
- 如果是桌面端超高帧率 3D 点云与实时流式信号监控,选择基于原生 OpenGL 的 VisPy。
结合列式存储(Parquet)、降采样算法与合理的直方图均衡着色,开发者完全可以在普通计算机上稳定、流畅地洞察数千万甚至上亿规模的数据集。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















