


Python函数传参是传值还是传引用?
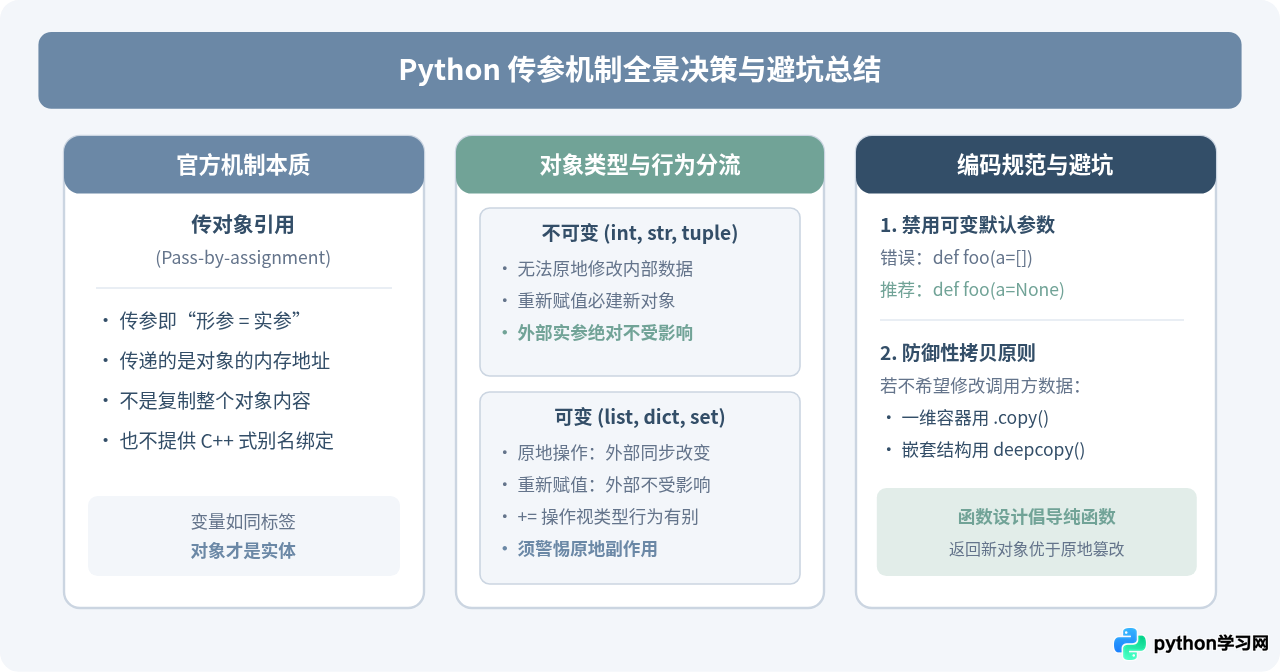
核心答案:Python 的函数传参机制既不是传统的“值传递”(Pass-by-value),也不是传统的“引用传递”(Pass-by-reference),其官方正式定义为“传对象引用”(Pass-by-object-reference)或“赋值传递”(Pass-by-assignment)。参数在传递时总是将实参所指对象的内存地址赋给形参变量名,而函数内部对参数的操作是否会影响外部实参,完全取决于该对象本身是不可变对象(如整数、字符串、元组)还是可变对象(如列表、字典、集合)。
一、为什么传统“传值”与“传引用”无法解释 Python?
很多开发者在刚学习 Python 时,常试图用 C、C++ 或 Java 中的“传值”和“传引用”概念来套用 Python 的参数传递,但很快就会遇到自相矛盾的现象:
- 看似“传值”的场景:向函数传入一个整数并在函数内增加数值,函数执行完毕后,外部变量的值完全没有改变。
- 看似“传引用”的场景:向函数传入一个列表并通过
append()追加元素,函数执行完毕后,外部变量引用的列表也被同步修改了。 - 令人困惑的转折:如果向函数传入一个列表,但在函数内执行
lst = [1, 2, 3]进行重新赋值,外部变量却又完好无损,没有发生任何改变。
如果 Python 是“传值”,那么列表被追加元素时外部不应变化;如果 Python 是“传引用”,那么列表被重新赋值时外部变量理应同步改变。这种看似矛盾的现象,根源在于传统分类的前提假设是“变量是存放数据的内存盒子”,而 Python 的变量模型本质上是“贴在对象上的标签”。
二、Python 的核心基石:变量与对象绑定模型
在 Python 中,所有数据(数值、字符串、列表、函数、类等)都是以对象(Object)的形式存放在内存堆中的。每个对象包含三个核心要素:身份标识(id)、类型(type)以及具体数值(value)。
而代码中所写的变量名,既不是内存容器,也不拥有类型。变量名仅仅是一个引用指针,就像一张写有名字的标签,随时可以贴到某个具体的对象上。赋值语句 a = 100 的本质并不是把数字 100 装进名为 a 的盒子里,而是在内存中创建整数对象 100,并将标签 a 贴到该对象上。
当调用函数 func(a) 时,Python 执行的动作是把实参标签 a 所指向的对象地址,赋值给函数内部的形参标签 x。此时,实参和形参同时指向内存中完全相同的对象。
三、不可变对象的传参机制:重新赋值导致指针重定向
不可变对象包括常见的:int、float、str、tuple、bool 以及 frozenset。这类对象一旦在内存中被创建,其内容和状态就永远无法被原地修改。
当把一个不可变对象传入函数并试图在函数内“修改”它时,Python 实际上做的是创建了一个全新的对象,并将局部形参标签重新指向该新对象。此时形参与外部实参彻底脱钩,外部实参仍然坚定地指向原有对象。
def increment(x):
    print("函数内部初始 x id:", id(x))
    x = x + 1  # 尝试修改:计算后生成新对象 11,形参 x 重新绑定
    print("函数内部赋值后 x id:", id(x))

a = 10
print("调用前 a id:", id(a))
increment(a)
print("调用后 a 的值:", a)  # 仍然输出 10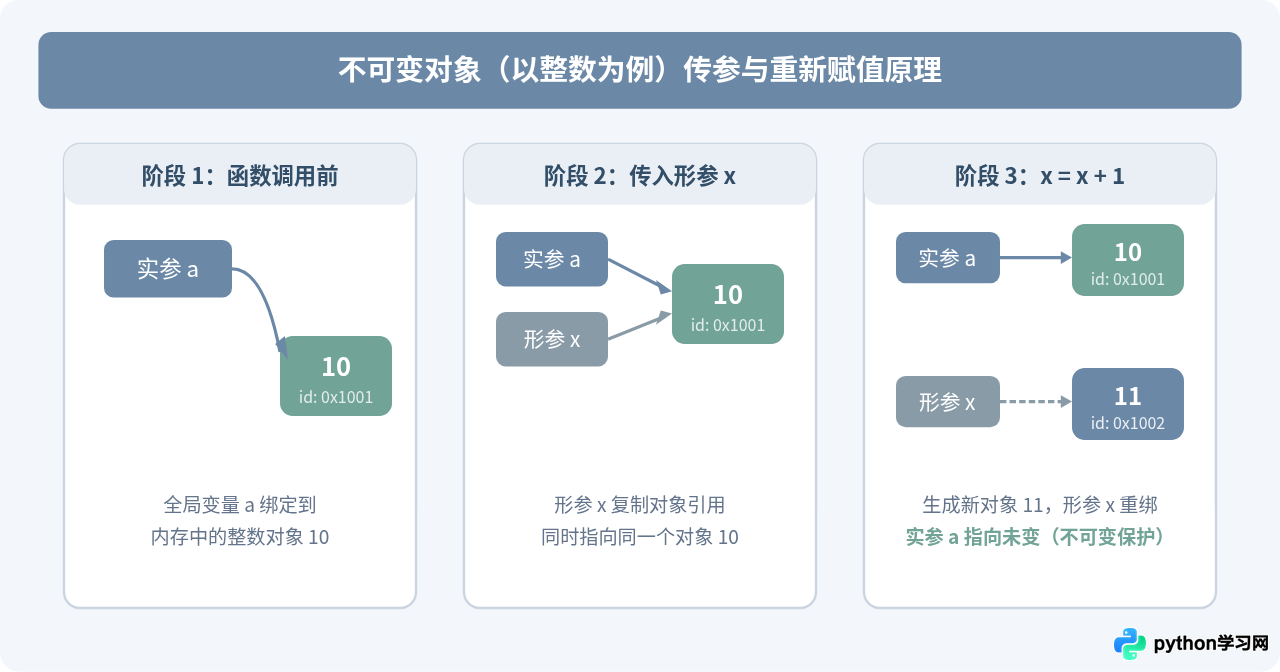
四、可变对象的传参机制:原地修改与重新赋值的双重表现
可变对象包括常见的:list、dict、set 以及自定义类的实例。这类对象的内部状态可以在原地发生修改,而对象的内存地址(id)保持不变。
在处理可变对象时,函数的具体行为取决于内部写的是原地方法调用还是重新赋值语句:
1. 原地修改(In-place Modification)
通过可变对象自带的原生变异方法(如 list.append()、list.pop()、dict.update()、切片赋值 lst[:] = ...),操作直接作用于底层共享的对象本身。由于实参和形参共同持有该对象的地址,调用方能立即感知到变化:
def modify_list(lst):
    lst.append(99)  # 原地修改,底层对象直接变动

nums = [1, 2]
modify_list(nums)
print(nums)  # 输出: [1, 2, 99],外部实参受到影响
2. 重新赋值(Re-binding)
如果在函数内部使用了赋值符号(如 lst = [99]),此时执行的是变量标签重定向。这只会让局部变量 lst 指向一个新的列表对象,并不会修改原列表对象的内容,更不会改变实参 nums 的指向:
def reassign_list(lst):
    lst = [99]  # 赋值操作:局部变量 lst 重定向到新对象

nums = [1, 2]
reassign_list(nums)
print(nums)  # 输出: [1, 2],外部实参保持不变!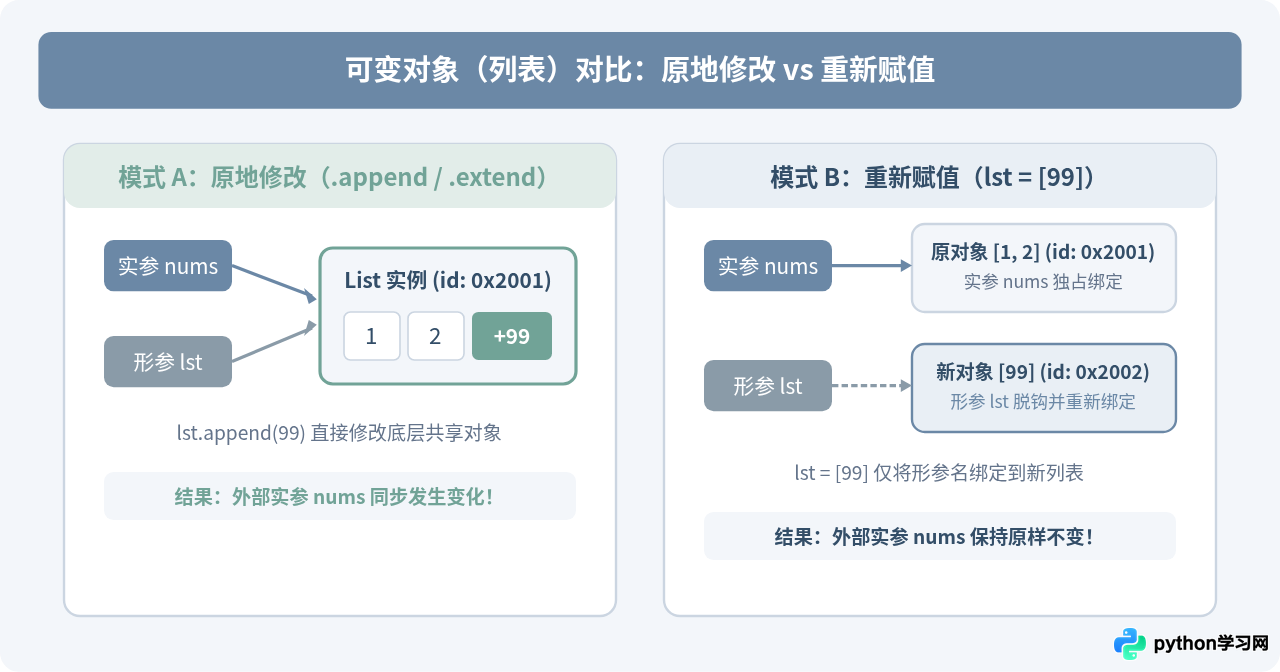
五、函数调用的完整执行推导步骤
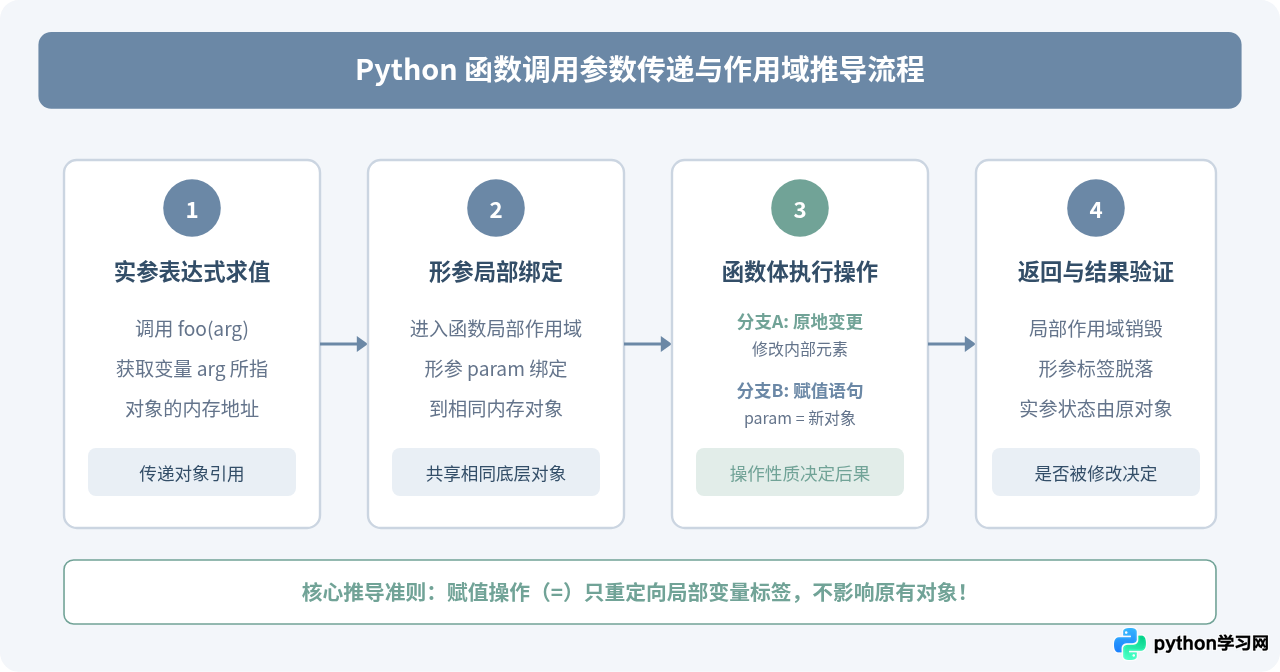
为了在脑海中建立精准无歧义的心智模型,我们可以将每一次函数调用的底层推导过程分解为四个连续步骤:
- 步骤一:实参求值并获取引用。调用
func(arg)时,解释器首先对表达式arg进行求值,取得对应对象的堆内存指针。 - 步骤二:创建局部命名空间并绑定形参。进入函数调用栈帧,创建函数的局部符号表(Local Namespace),并将形参名称
param作为键、实参对象的指针作为值存入符号表中。 - 步骤三:执行函数体内的语句。
- 若执行属性或方法修改(如
param.attr = val、param.append()),顺着指针直接操作堆对象本身。 - 若执行赋值语句(如
param = val),在局部符号表中更新param对应的新指针,原堆对象不受影响。
- 若执行属性或方法修改(如
- 步骤四:函数退出并销毁栈帧。函数执行结束,局部命名空间随之释放,形参名标签注销。留在调用方的实参变量能否看到改动,完全取决于第三步是否对原堆对象实施了原地修改。
六、经典实战陷阱与工程应对策略
深刻理解“传对象引用”的本质后,我们能轻松看透并防范两类在日常开发中高频出现的逻辑漏洞。
1. 默认参数陷阱:可变对象充当默认值
在 Python 中,函数定义语句 def 是可执行语句。函数的默认参数表达式只会在函数定义时求值一次,而不是在每次调用函数时求值。如果把列表或字典等可变对象作为默认参数,所有未传入该参数的调用都将共享同一个默认对象:
# 错误示例:默认参数共享陷阱
def add_item(item, target_list=[]):
    target_list.append(item)
    return target_list

print(add_item("苹果"))  # 输出: ['苹果']
print(add_item("香蕉")) # 输出: ['苹果', '香蕉'],产生跨调用的意外累积!None 作为默认占位符,并在函数体内通过 if target_list is None: target_list = [] 进行初始化。
2. 防御性拷贝:避免意外修改外部输入
如果函数只需要读取传入列表或进行内部临时计算,不希望调用方的数据被暗中篡改,应当在函数入口处进行主动复制:
- 浅拷贝(Shallow Copy):对于单层容器,使用
lst.copy()或list(lst)。浅拷贝创建新容器,但容器内的子元素仍指向原引用。 - 深拷贝(Deep Copy):对于多层嵌套结构(如字典内嵌列表),使用
copy.deepcopy(),将整个对象树及所有子对象完全递归复制一份。
七、总结与判定心智模型
回答“Python函数传参是传值还是传引用?”的最严谨表述:
Python 采用“传对象引用”(Pass-by-assignment)机制。变量是标签,对象是实体。传递参数时传递的是标签所指对象的内存引用;不可变对象无法原地修改,发生变动必定生成新对象使形参脱钩,外表呈现传值特性;可变对象支持原地修改,方法调用直接生效于原对象,外表呈现传引用特性;但任何显式赋值(=)都仅重绑定当前作用域变量名,不会改变原对象。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















