


Python 3数据分析常用库有哪些?NumPy、Pandas应用场景解析
在 Python 3 数据分析领域,完整的工具链通常由 NumPy、Pandas、Matplotlib/Seaborn、SciPy 和 Scikit-learn 等核心库协同构成。其中,NumPy 提供了底层的紧凑多维同质数组与高性能向量化矩阵运算,Pandas 则基于表格索引抽象构建了异质数据的清洗、转换与聚合分析工具。本文将系统梳理这些常用库的职责边界,深入解析 NumPy 与 Pandas 的核心设计、应用场景差异及协同实战模式。
一、Python 3 数据分析核心库生态体系
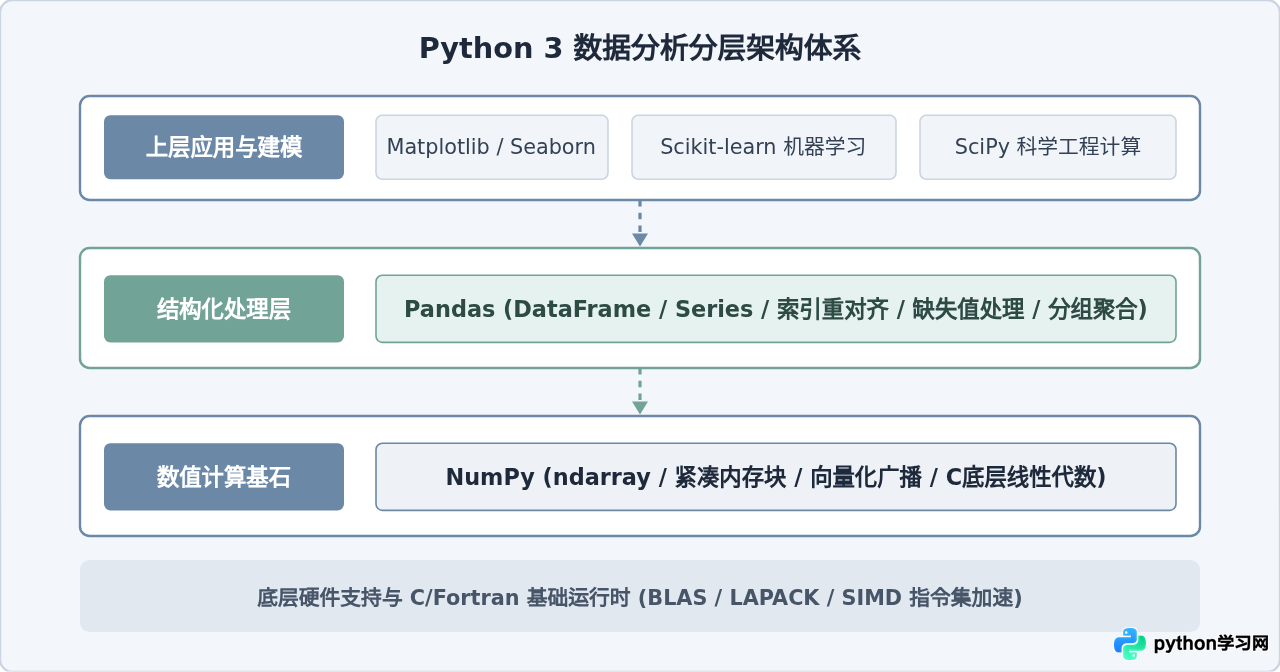
Python 能够成为数据分析与科学计算的主流语言,核心原因在于其层次分明、各司其职的开源算法库生态。开发者通常不需要从零编写底层数值计算逻辑,而是依据分析任务的不同阶段调用对应工具:
- NumPy(数值计算基石):提供
ndarray数据结构,支撑高效多维数值数组运算、线性代数解算、傅里叶变换与随机数生成。 - Pandas(表格数据处理核心):基于
Series与DataFrame,专门处理带有行列标签的异质结构化数据,提供清洗过滤、重塑拼接与统计汇总能力。 - Matplotlib & Seaborn(数据可视化):Matplotlib 负责底层精细化绘图控制,Seaborn 则封装了美观的统计分布图与多变量关联图。
- SciPy(科学工程计算):在 NumPy 基础上扩展了数值微积分、常微分方程求解、信号处理与高级统计检验算法。
- Scikit-learn(经典机器学习):提供分类、回归、聚类与降维模型,其输入输出接口深度依托 NumPy 数组与 Pandas 结构。
二、NumPy 核心能力与典型应用场景
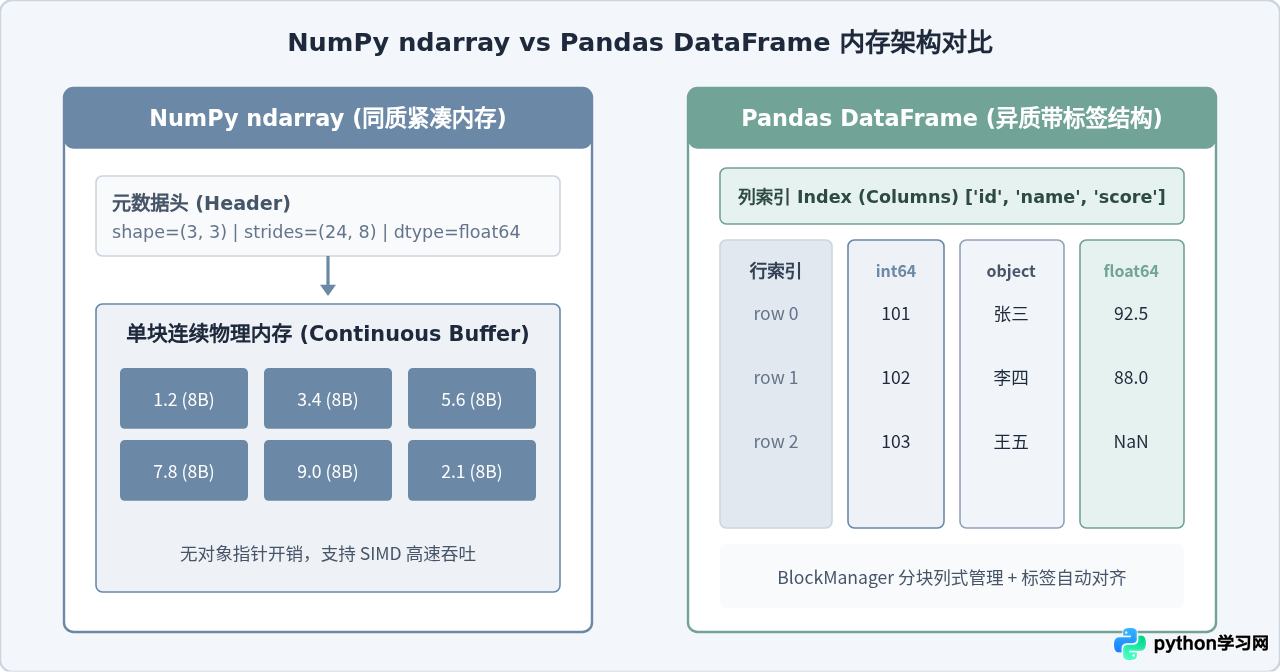
NumPy(Numerical Python)是整个 Python 科学计算体系的心脏。标准 Python 原生列表(list)保存的是对象的指针引用,每个元素均带有额外的元数据开销,且在内存中离散分布;而 NumPy 的核心数据结构 ndarray 是一块连续分配的物理内存,所有元素必须拥有完全一致的数据类型(Homogeneous)。这种结构消除了指针跳转与动态类型检查开销,能够充分利用 CPU 高速缓存和 SIMD 并行指令集。
1. 核心特性
- 向量化运算(Vectorization):无需编写显式
for循环,直接对整个数组应用算术运算符,底层直接调用 C 语言循环执行。 - 广播机制(Broadcasting):自动匹配不同形状的数组进行数学运算,避免产生不必要的全量数组拷贝。
- 通用函数(ufunc):提供元素级的极速数学计算,例如三角函数、指数对数与位运算。
2. 典型应用场景
- 大规模纯数值运算与矩阵求解:涉及高阶矩阵乘法、特征值分解、解线性方程组等数学计算。
- 图像与音频等无损多维张量处理:单通道或多通道图像数据天然表示为三维或四维数值张量,切片与滤波运算高度依赖 NumPy。
- 机器学习底层算法实现:深度学习网络参数权重矩阵、梯度下降优化算法等底层算子开发。
import numpy as np

# 1. 创建同质多维数组
data = np.array([[1.5, 2.8, 3.2], [4.1, 5.0, 6.7]], dtype=np.float64)

# 2. 向量化广播计算:每个元素加权并计算正弦值,无需显式循环
scaled_data = np.sin(data * 0.5 + 1.2)

# 3. 矩阵乘法与统计
matrix_a = np.random.randn(3, 4)
matrix_b = np.random.randn(4, 2)
product = np.matmul(matrix_a, matrix_b)  # 维度为 (3, 2)
row_mean = np.mean(product, axis=1)

print("矩阵运算结果形状:", product.shape)
print("各行均值:", row_mean)三、Pandas 核心能力与典型应用场景
真实世界中的业务数据几乎都是“脏”的:字段类型各异(既有数值,也有日期、用户姓名、布尔标签)、存在空值缺失、字段名和记录行需要带意义的标签进行定位。NumPy 难以优雅应对这类异质表格,而 Pandas 正是为此而生。
1. 核心特性
- 轴标签索引(Index & Columns):每行和每列都有明确标签,计算时会自动对齐标签,防止数据因顺序错位而算错。
- 结构化数据清洗能力:提供强大的
fillna()、dropna()、replace()和类型强制转换函数。 - 强大灵活的分组聚合(Split-Apply-Combine):通过
groupby()快速实现类似于 SQL 的分组汇总、透视表与时序滚动窗口运算。
2. 典型应用场景
- 多源数据摄入与清洗:从 CSV、Excel、Parquet、SQL 数据库导入异质表格,处理空值、格式转换与去重。
- 业务分析与探索性数据分析(EDA):快速统计用户行为、订单转化率、各维度销售额等指标。
- 时间序列分析:金融交易数据的时间对齐、重采样(例如将按秒数据重采样为日 K 线)、滑动均值计算。
import pandas as pd

# 构建模拟销售数据
df = pd.DataFrame({
    'order_id': [1001, 1002, 1003, 1004],
    'department': ['电子', '家居', '电子', '数码'],
    'revenue': [4500.0, 320.5, 7800.0, None],
    'is_completed': [True, True, False, True]
})

# 1. 缺失值填充与类型校验
df['revenue'] = df['revenue'].fillna(df['revenue'].median())

# 2. 分组聚合统计各部门总销售额与有效订单数
summary = df[df['is_completed']].groupby('department')['revenue'].agg(
    total_sales='sum',
    order_count='count'
).reset_index()

print("部门汇总结果:\n", summary)
四、NumPy 与 Pandas 内存机制与底层架构差异
理解两者的本质差异,关键在于看清其底层内存布局。NumPy 的 ndarray 仅由连续内存缓冲区、步幅(Strides)和数据类型描述符组成;而 Pandas 的 DataFrame 内部采用 BlockManager(在现代版本中逐步引入 Block-per-Column 机制)分别管理不同类型的列块,并在外层封装了行索引与列索引对象。
五、实战协同:端到端数据分析的标准推导流程
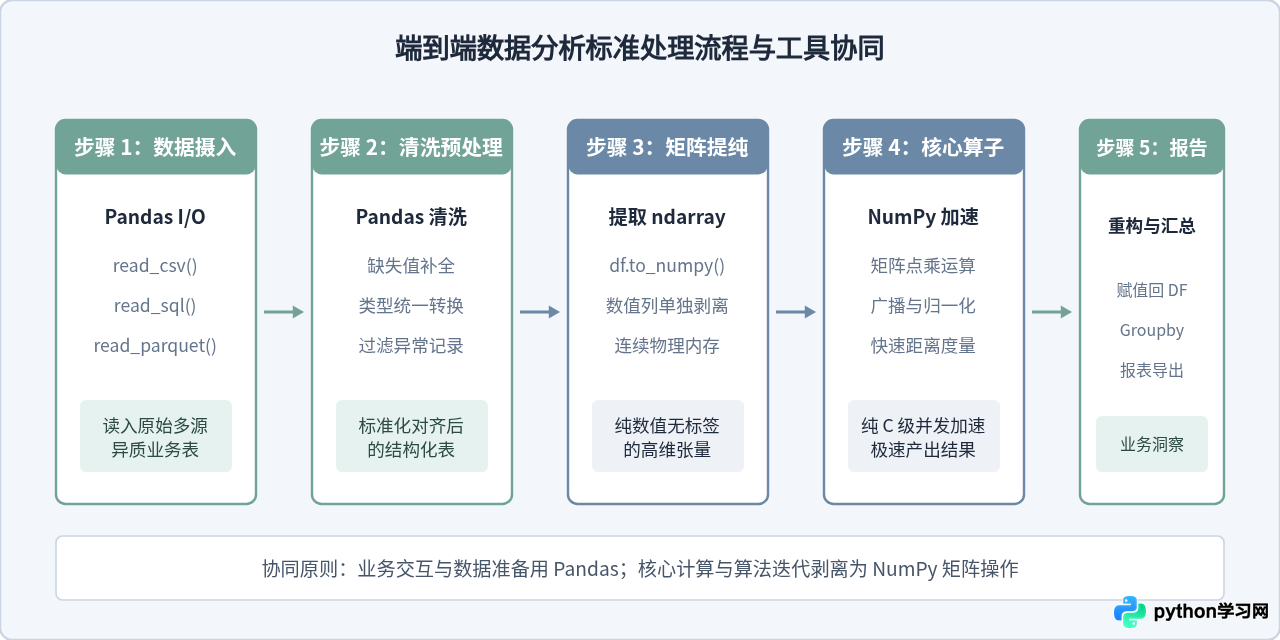
在实际生产环境中,NumPy 和 Pandas 绝非互斥关系,而是前后衔接的组合拳。标准的数据工程与分析管道往往遵循“Pandas 摄入清洗 -> 特征矩阵提取 -> NumPy 向量化算子加速 -> Pandas 结果重构”的闭环步骤。
协同代码演示:数据标准化与加权评分
import numpy as np
import pandas as pd

# 1. 模拟业务表格
raw_data = {
    'user_id': ['U101', 'U102', 'U103', 'U104'],
    'activity_days': [12, 28, 5, 19],
    'payment_amount': [350.0, 1200.0, 50.0, 680.0]
}
df = pd.DataFrame(raw_data)

# 2. 剥离特征数值矩阵(转换为 NumPy ndarray)
features = df[['activity_days', 'payment_amount']].to_numpy()

# 3. NumPy 向量化执行 Z-Score 标准化与权重矩阵乘法
mean = np.mean(features, axis=0)
std = np.std(features, axis=0)
normalized = (features - mean) / std

# 赋予权重:活跃天数权重 0.4,消费金额权重 0.6
weights = np.array([0.4, 0.6])
scores = np.dot(normalized, weights)

# 4. 计算结果挂载回 Pandas DataFrame 生成报表
df['composite_score'] = np.round(scores, 3)
df_sorted = df.sort_values(by='composite_score', ascending=False)

print(df_sorted[['user_id', 'composite_score']])
六、如何选型?NumPy 与 Pandas 应用场景对照与总结指南
在面临具体工程任务时,选用 NumPy 还是 Pandas 取决于输入数据的结构形态、计算模式以及性能瓶颈所在。
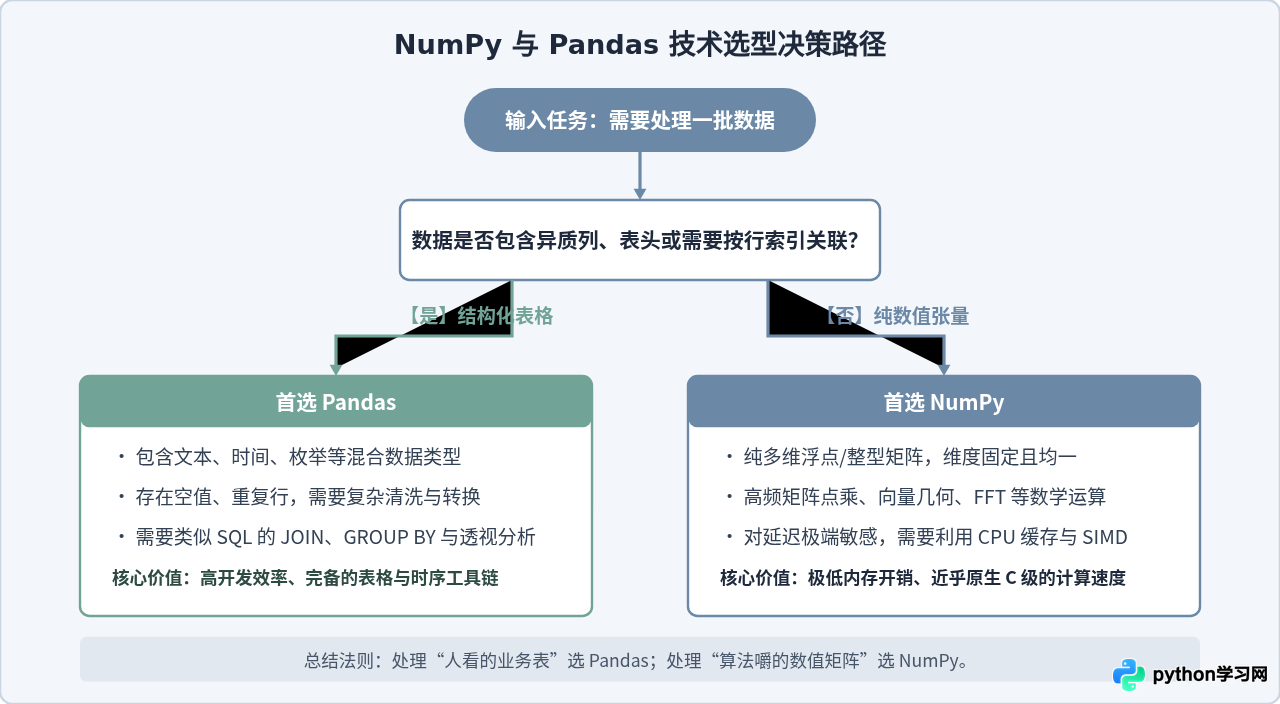
关键维度对照表
| 对比维度 | NumPy | Pandas |
|---|---|---|
| 核心数据结构 | ndarray(N 维同质数值数组) |
Series(一维标签序列)、DataFrame(二维异质表格) |
| 数据类型要求 | 严格同质(所有元素必须为完全相同类型) | 允许异质(同一张表内不同列可拥有不同类型) |
| 索引与元数据 | 仅基于整数偏移量切片,元数据极度轻量 | 拥有显式行标签(Index)与列标签(Columns) |
| 内存开销 | 极低,直接利用单块物理连续内存空间 | 较高,带有索引管理、对象封装与对齐开销 |
| 缺失值处理 | 对整型缺失值支持有限(主要使用 np.nan 浮点占位) |
提供原生可空的类型系统与全面的清洗补全 API |
| 典型运算模式 | 线性代数、广播算子、图像张量变换 | SQL 风格的过滤、JOIN 连接、透视与分组聚合统计 |
.to_numpy() 转换为 NumPy 数组释放底层运算性能,是工业级数据处理的最佳实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















