


Python跨模块共享全局变量:import导入机制与状态同步
深入解析Python跨模块共享全局变量的实现方案、底层import缓存机制、from-import重绑定陷阱以及多线程与并发场景下的状态同步规范。
在 Python 项目开发中,跨模块共享全局状态的核心解决路径是将全局变量集中放置在专用的配置模块中,并通过模块对象本身(如 import config; config.var = ...)或可变容器对象进行读写,而不能使用 from config import var 语法直接导入变量并对其重新赋值。Python 的模块导入机制基于全局单例字典 sys.modules,只要遵循对象属性引用规范,即可实现多模块间可靠的状态同步。
一、Python模块导入机制与 sys.modules 单例缓存
许多初学者在多模块协作时,常常遇到“A 模块修改了变量,B 模块读出来的还是初始值”的现象。要彻底理清这一问题,首先需要了解 Python 解释器是如何加载和组织模块的。
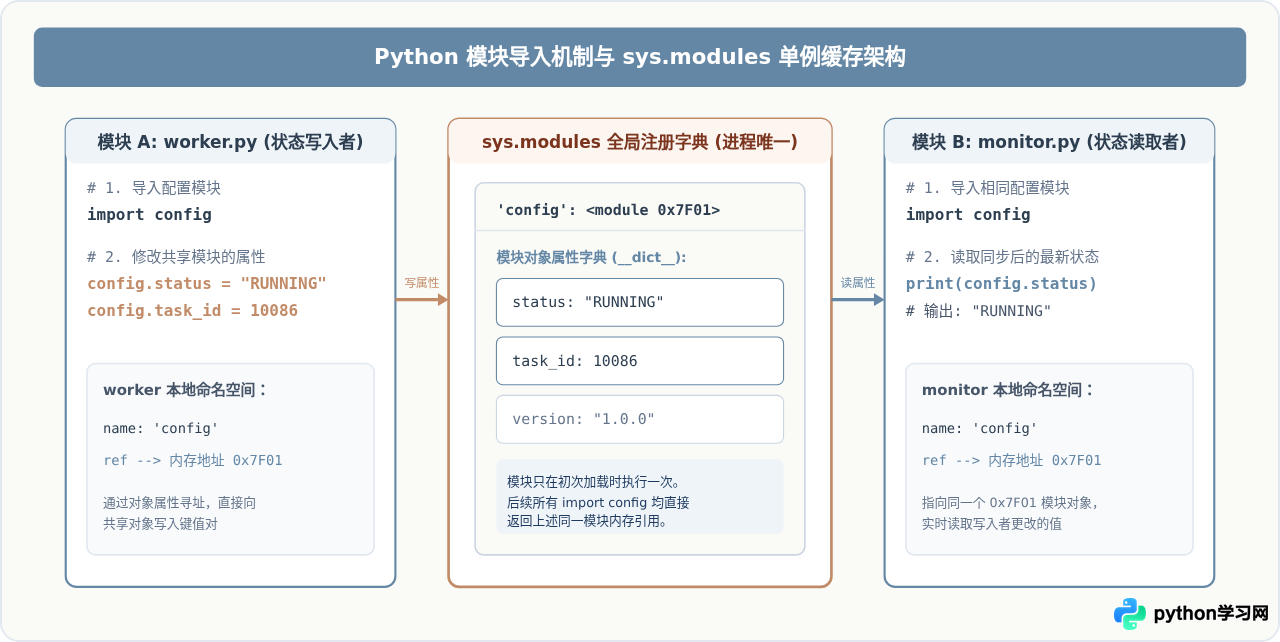
当 Python 首次执行 import foo 时,解释器会依次完成三个动作:在文件系统中检索 foo.py 文件、编译字节码并创建全新的 module 对象、最后将该模块对象登记在全局内置字典 sys.modules['foo'] 中。当其他文件再次执行 import foo 时,解释器并不会重新读取文件或重新执行模块代码,而是直接从 sys.modules 字典中提取已缓存的同一个模块对象。
这意味着:在同一个 Python 运行进程中,任何一个模块天然就是一个单例对象(Singleton)。所有针对该模块内部全局变量的访问,本质上都是在读写该模块对象自身的属性字典 __dict__。
二、底层陷阱剖析:import module 与 from module import var 的根本区别
许多开发者在跨模块共享状态失败时,最根本的诱因在于混淆了两种导入语法的机制差异。我们必须深刻区分“修改对象的属性”与“重新绑定本地变量名”。
1. from config import var 的重绑定陷阱
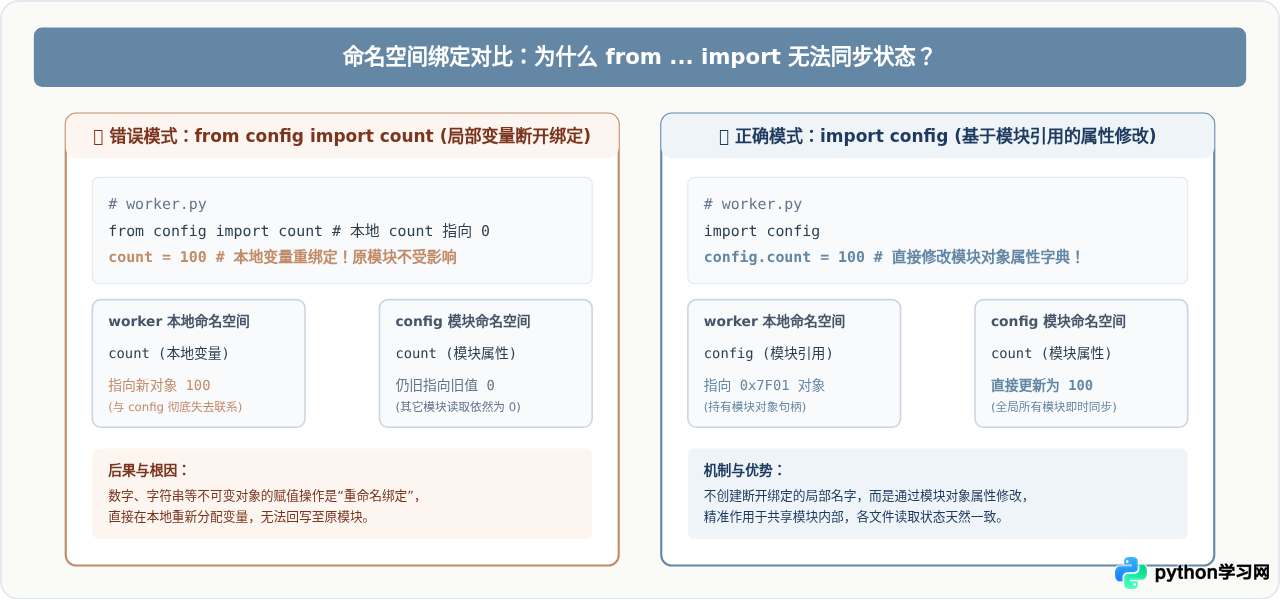
当执行 from config import count 时,Python 做的事情其实是两步:首先导入 config 模块,然后在当前模块的局部命名空间中创建一个名为 count 的变量,让它指向 config.count 当前所引用的对象(例如整数 0)。
如果随后在当前模块中执行 count = 1,这行代码并不会去修改 config 模块中的属性,而是仅仅把当前模块本地的 count 变量重新绑定到了新创建的整数对象 1 上。此时,config 模块内部的 count 依然指向 0,其他任何导入 config 的模块都无法感知这次修改。
2. import config 的属性寻址机制
而执行 import config 时,当前模块的局部命名空间中只存在一个变量 config,它直接指向 sys.modules['config'] 缓存的模块对象。当执行 config.count = 1 时,Python 触发的是对象的 __setattr__ 操作,真正修改了位于该模块内部的属性。所有其他持有 config 引用的模块,通过属性寻址读取 config.count 时,得到的都是最新的值。
三、规范实现步骤:构建高可靠的跨模块状态共享体系
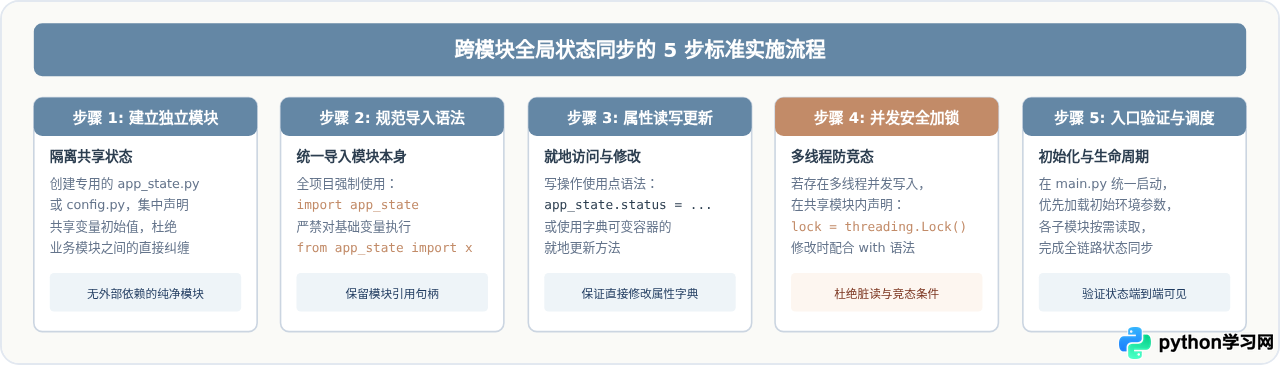
掌握了底层原理后,在实际工程中落地跨模块全局状态共享,推荐按照以下五个标准步骤进行规范化设计与编写:
完整代码实现示例
下面给出一个标准且可执行的跨模块多任务状态同步完整代码。整个项目分为三个文件:负责存储状态的独立模块 app_state.py、负责执行任务并更新状态的 worker.py,以及统一入口 main.py。
import threading

# 基础类型变量(记录系统主状态)
status = "INITIALIZING"
active_task_count = 0

# 容器类型变量(记录动态详情)
task_registry = {}

# 并发保护锁(多线程并发修改时必须使用)
state_lock = threading.Lock()

def update_task_progress(task_name: str, progress: int):
    """
    通过封装函数提供安全的可变状态写入,增强代码可读性与类型可控性
    """
    with state_lock:
        task_registry[task_name] = progress
        print(f"[app_state] 任务 '{task_name}' 进度已更新为 {progress}%")
import time
# 注意:务必导入模块本身,严禁使用 from app_state import status
import app_state

def run_worker():
    print(f"[worker] 启动时检测到初始状态: {app_state.status}")

    # 1. 直接更新模块层级的属性
    with app_state.state_lock:
        app_state.status = "PROCESSING"
        app_state.active_task_count += 1

    # 2. 执行具体业务逻辑
    for step in [25, 50, 75, 100]:
        time.sleep(0.1)  # 模拟实际耗时任务
        app_state.update_task_progress("DownloadDataset", step)

    # 3. 任务完成,标记最终状态
    with app_state.state_lock:
        app_state.status = "COMPLETED"
        app_state.active_task_count -= 1

    print("[worker] 任务执行完毕,全局状态已更新为 COMPLETED")
import threading
import time
import app_state
from worker import run_worker

def monitor_status():
    """
    在独立线程中持续监测共享模块状态
    """
    for _ in range(5):
        time.sleep(0.08)
        # 实时访问 app_state 模块中的最新值
        current_status = app_state.status
        active_count = app_state.active_task_count
        progress = app_state.task_registry.get("DownloadDataset", 0)
        print(f"[Monitor] 监听中 -> 状态: {current_status} | 活跃任务数: {active_count} | 进度: {progress}%")

if __name__ == "__main__":
    print("=== 开始执行跨模块全局状态测试 ===")

    # 启动工作线程与监控线程
    t_worker = threading.Thread(target=run_worker)
    t_monitor = threading.Thread(target=monitor_status)

    t_monitor.start()
    t_worker.start()

    t_worker.join()
    t_monitor.join()

    print("=== 测试结束 ===")
    print(f"最终主程序检查状态: {app_state.status}")
    print(f"最终注册表内容: {app_state.task_registry}")
运行
python main.py 后,monitor_status 线程能够平滑观察到 app_state.status 从 INITIALIZING 变更为 PROCESSING,再最终变更为 COMPLETED,且 task_registry 的进度实时按步递增。各个模块之间无需繁琐的参数传递,便达成了全局状态的精准同步。
四、进阶与防坑:避免跨模块共享的典型设计缺陷
在较大规模的项目中,单纯依靠模块变量还可能面临其他设计边界与潜在缺陷。以下是三项最容易引发严重 Bug 的关键要点:
1. 警惕循环导入(Circular Imports)
如果模块 a.py 导入了 b.py,而 b.py 顶部又试图通过 import a 来获取 a.py 中的某个全局标志,极易引发 AttributeError: partially initialized module 'a' has no attribute 'xxx'。这是因为当 b 执行时,a 的代码只执行了一半,尚未完成变量定义。
避坑准则:绝不要在具体的业务模块(如 a.py 或 b.py)中声明共享变量。永远将共享变量剥离在独立、纯净、无任何外部业务依赖的 config.py 或 state.py 中。所有业务模块只单向依赖该基础模块,彻底斩断循环依赖链条。
2. 明确进程隔离边界(multiprocessing 不共享内存)
必须清醒地认识到:sys.modules 是操作系统进程内部的缓存结构。如果你使用的是 Python 的 multiprocessing 模块,或者在部署 Web 服务时使用了 Gunicorn / uWSGI 的多 Worker 模式(多进程模型):
- 子进程会拷贝父进程的一份内存快照,拥有自己独立的
sys.modules。 - 在 Worker 进程 A 中修改
config.status,Worker 进程 B 绝不会同步更新。 - 解决方案:跨进程场景必须转用专门的进程间通信(IPC)机制,例如
multiprocessing.Value、multiprocessing.Manager,或工业级外部集中式状态存储(如 Redis、Memcached 或数据库)。
3. 不要使用 importlib.reload() 重置共享状态
某些开发者希望“重置”状态,因而尝试调用 importlib.reload(config)。这会导致极度隐蔽的灾难:reload 会在原有内存位置重新执行模块文件,但之前已经从该模块导入过对象的其他模块,可能仍然缓存着旧模块对象的旧属性;如果存在 C 扩展或全局文件句柄,甚至可能引发资源泄露。重置状态应通过显式定义 reset_state() 函数清理属性字典,而不是重新加载模块。
五、全景决策与选型总结
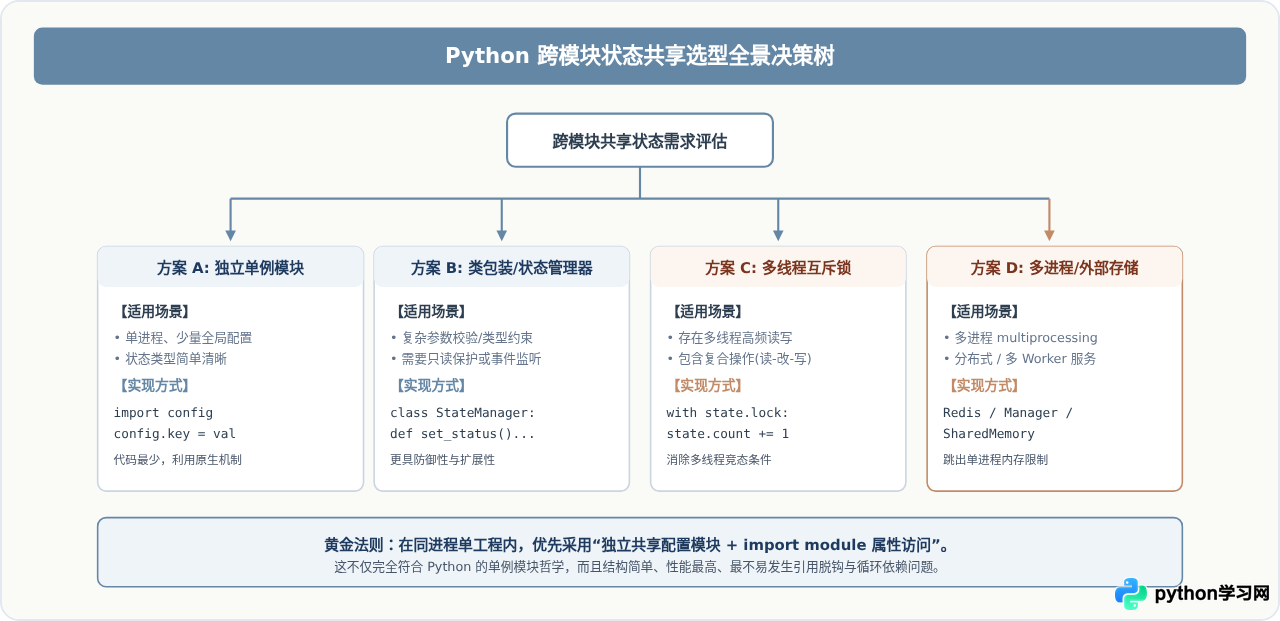
为便于在不同业务复杂度下准确选择合适的技术方案,下图总结了 Python 跨模块状态共享与管理的完整决策树:
核心要点速查表
| 维度 | import config (推荐) | from config import var (陷阱模式) | 单例类 / 容器对象 |
|---|---|---|---|
| 寻址方式 | 持有模块对象句柄,通过属性访问目标 | 在本地创建独立名称,直接指向初始值对象 | 持有管理器或容器引用,就地修改内部成员 |
| 不可变变量赋值 | config.val = 1直接修改模块属性字典,全局可见 |
val = 1本地重新绑定,与原模块彻底脱钩 |
通过 manager.set('val', 1) 统一更新 |
| 循环依赖风险 | 低(若将变量隔离在独立模块中) | 高(由于在加载期立即解析属性) | 低(依赖关系清晰) |
| 并发可控性 | 需配合全局锁或原子操作 | 不可控(甚至无法同步) | 可直接将锁封装进类方法内部 |
通过理解 Python 的 sys.modules 模块缓存与命名空间绑定机理,遵循“独立模块集中管理、统一保留模块引用、规避不可变对象本地重绑定”的设计准则,便能轻松编写出架构清晰、状态同步可靠的 Python 多模块系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















