


使用Seaborn简化Python统计图表绘制教程
本教程系统讲解如何使用Seaborn简化Python统计图表绘制,深入解析Figure-level与Axes-level架构、Tidy Data长表数据映射,并通过丰富实例掌握散点、分布、分类及热力图的高效绘制方法。
在 Python 数据科学与分析工作中,原生使用 Matplotlib 绘制含有统计聚合、置信区间、色彩语义映射以及多子图分面的图表,往往需要编写大量繁琐的分组循环、坐标轴定位与图例微调代码。Seaborn 作为构建在 Matplotlib 之上的高级统计绘图库,深度集成了 Pandas DataFrame,允许开发者仅需指定数据字段名与视觉通道,就能通过一行声明式代码绘制出符合统计规范、美观优雅的可视化成果。本文将从架构认知、数据规范、核心接口实战到标准工程流程,系统讲解如何使用 Seaborn 大幅简化统计图表的绘制。
一、Seaborn 与 Matplotlib:从底层命令到声明式统计制图
理解 Seaborn 的第一步,是明确它并不是要取代 Matplotlib,而是作为 Matplotlib 的高阶接口与统计扩展层存在。在传统的数据可视化工作流中,若要绘制一份“不同消费群体在周末与工作日的消费金额与小费关系,并按性别区分颜色与趋势回归线”,Matplotlib 用户必须依次完成以下琐碎工作:
- 手动对 Pandas DataFrame 进行
groupby或布尔切片筛选; - 遍历所有分组,逐个调用
ax.scatter()分配不同颜色和标记; - 使用 Scipy 或 Numpy 拟合一元线性方程,生成回归预测值并调用
ax.plot(); - 手动提取图例句柄与标签,调用
ax.legend()并排版图例位置; - 手动为不同图表单元计算坐标系统一的轴范围与网格间隔。
而在 Seaborn 中,上述全部操作被封装为一个函数调用 sns.lmplot(data=df, x="total_bill", y="tip", hue="sex", col="time")。Seaborn 在底层自动解析长表格式数据,自动计算分组统计量、置信区间(默认 95% Bootstrap 自助法抽样),并自动生成清晰的图例与对齐子图。
二、Seaborn 核心架构:Figure-level 与 Axes-level
许多初学者在使用 Seaborn 时遇到的混淆与报错(例如设置 plt.title() 不生效,或者子图无法排布到现有的 Axes 上),根本原因是没有理清 Seaborn 的两层 API 架构:Figure-level(图形级)与 Axes-level(轴级)。
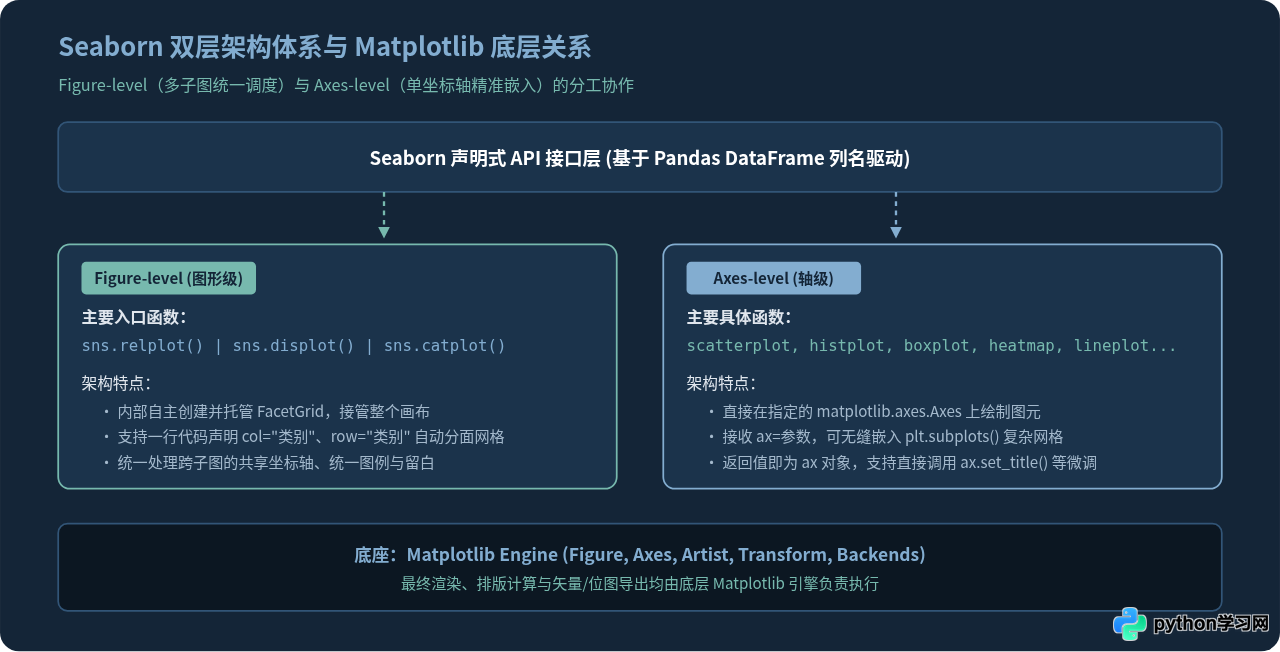
两类 API 各自具备清晰的职责边界:
- Figure-level 函数(如
relplot、displot、catplot)是面向高层探索的通用入口,其底层返回的是一个FacetGrid对象。你不需要提前创建画布,只需传入col="部门"或row="季度",它就会自动为你构建多子图网格; - Axes-level 函数(如
scatterplot、boxplot、kdeplot、heatmap)则专注于单个坐标轴内的图形构建。它们接收ax=ax参数,能与 Matplotlib 原生的fig, axes = plt.subplots(2, 2)紧密结合,适合混合排布完全不同类型的统计图形。
三、数据组织基石:Tidy Data 与语义映射机制
Seaborn 之所以能实现“一行代码完成分组统计”,核心在于其对 Tidy Data(整洁长表数据) 的依赖。在整洁数据中:
- 每个变量构成一列;
- 每个观测值构成一行;
- 每种类型的观测单元形成一个表格。
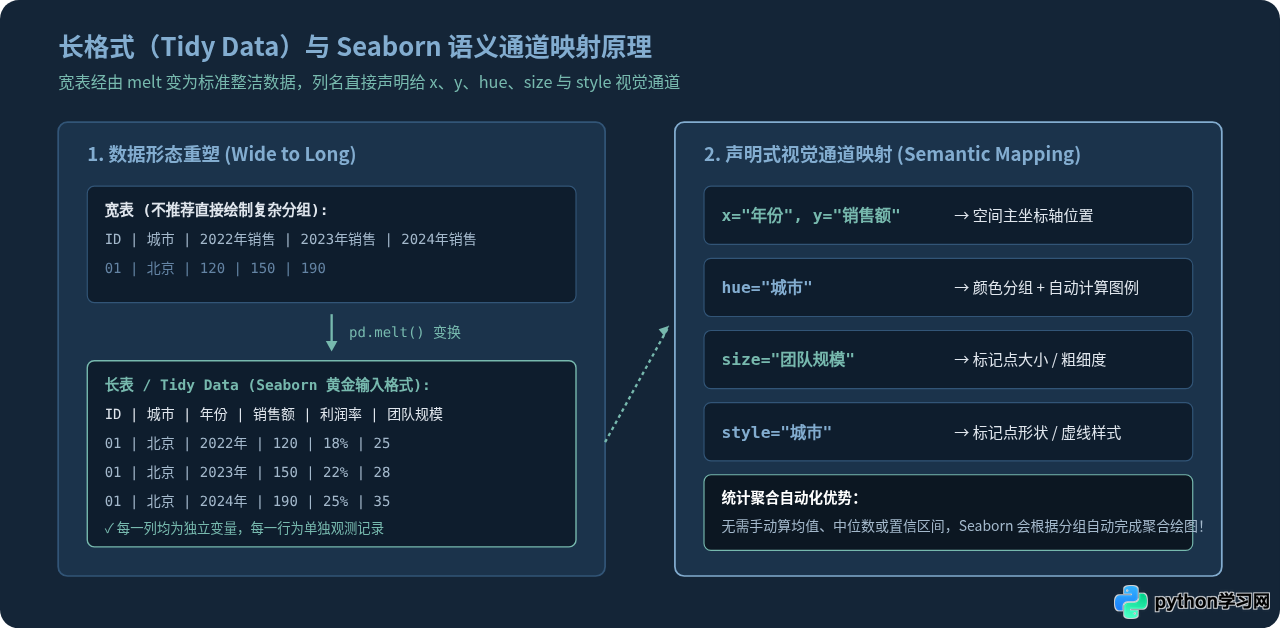
在宽表数据中,“2022年销售”、“2023年销售”被分散在不同的列名上,导致无法直接用单个变量名指定 Y 轴。通过 Pandas 的 melt() 方法转换为长表后,原本分散的度量值汇聚到同一列中,使得 Seaborn 可以直接将列名传递给 x、y、hue(颜色分类)、style(点型或线型分类)和 size(大小分类),完成高维统计信息的图元映射。
四、常用统计图表绘制场景与核心代码实战
掌握了架构与数据形态后,我们来看实际数据分析中最常见的 4 类统计制图场景。
1. 关系型图表:多维散点与时间趋势 (relplot / scatterplot / lineplot)
用于探索两个连续型数值变量之间的相关性、离群点分布或时间序列趋势。在绘制时间序列时,Seaborn 会对同一时间戳下的多个重复观测点自动计算均值与 95% 置信区间阴影带。
import seaborn as sns
import matplotlib.pyplot as plt

# 载入内置样例数据集
tips = sns.load_dataset("tips")

# 1. 探索消费金额与小费的关系,按是否吸烟区分颜色,按就餐时间分面
g = sns.relplot(
    data=tips,
    x="total_bill",
    y="tip",
    hue="smoker",
    style="time",
    size="size",
    palette="deep",
    col="day",
    col_wrap=2,
    height=4,
    aspect=1.2
)
g.set_axis_labels("账单总额 ($)", "小费金额 ($)")
plt.show()
2. 分布型图表:直方图、核密度估计与联合分布 (displot / histplot / kdeplot)
用于分析单个或多个连续变量的集中趋势、偏态与离散程度。sns.displot() 支持通过 kde=True 同时绘制直方图和核密度平滑曲线,并通过 hue 实现平滑分群对比。
# 绘制企鹅数据集的体长分布,对比不同品种并叠加 KDE 曲线
penguins = sns.load_dataset("penguins")

sns.displot(
    data=penguins,
    x="flipper_length_mm",
    hue="species",
    kind="hist",
    kde=True,
    stat="density",
    common_norm=False,
    palette="Set2",
    height=5,
    aspect=1.4
)
plt.title("各企鹅物种鳍肢长度分布与核密度估计")
plt.show()
3. 分类对比图表:箱线图、小提琴图与柱状图 (catplot / boxplot / violinplot / barplot)
当一个变量为离散分类(如部门、星期、性别),另一个为连续数值时,分类图表能够快速展示统计分位数与分布形状:
boxplot:展示中位数、四分位距(IQR)及离群值;violinplot:在箱线图基础上结合了核密度轮廓,直观呈现多峰分布;barplot:绘制各组均值,并自动附带误差棒(展示均值的估计不确定性)。
# 使用 catplot 统一接口绘制箱线图与点图叠加
g = sns.catplot(
    data=tips,
    x="day",
    y="total_bill",
    hue="sex",
    kind="box",
    palette="pastel",
    height=5,
    aspect=1.3
)
g.set_axis_labels("用餐日期", "账单金额 ($)")
plt.show()
4. 矩阵关联:相关系数热力图 (heatmap)
在特征工程与多元统计中,计算数值特征之间的相关系数矩阵是标准步骤。Seaborn 的 heatmap 可以在网格内自动填注数值、配置渐变色带并调整对角线展示。
# 计算数值特征皮尔逊相关系数并绘制热力图
numeric_cols = penguins.select_dtypes(include=["number"])
corr = numeric_cols.corr()

plt.figure(figsize=(8, 6))
sns.heatmap(
    corr,
    annot=True,          # 在格内显示数值
    fmt=".2f",          # 浮点保留两位小数
    cmap="Blues",        # 渐变配色方案
    vmin=-1, vmax=1,    # 固定色阶上下限
    linewidths=0.5,      # 单元格分割线
    cbar_kws={"label": "Pearson 相关系数"}
)
plt.title("企鹅体征指标相关系数矩阵热力图")
plt.tight_layout()
plt.show()
五、规范绘图步骤与最佳实践工作流
为了让图表兼具统计严谨性与排版规范性,在实际项目中应遵循结构化的 5 步工作流:
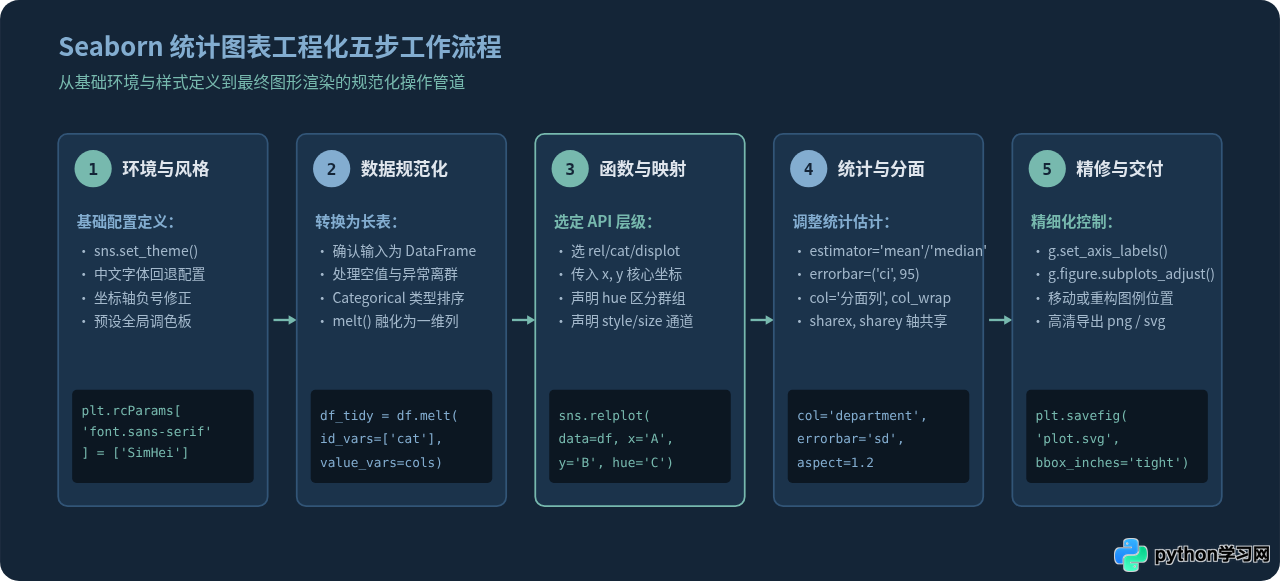
Seaborn 默认调用 Matplotlib 默认字体。若在绘制中文轴标题时出现方块乱码,必须在脚本开头显式声明字体,并在使用
sns.set_theme() 时避免被覆盖:
import matplotlib.pyplot as plt
import seaborn as sns

# 推荐在 set_theme 之后配置中文字体
sns.set_theme(style="whitegrid")
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False  # 正常显示负号
六、统计图表选型指南与总结
在面对具体的数据分析任务时,选择最贴合分析目标的 Seaborn 函数是高效成图的关键。下方的选型决策图与速查表格梳理了各类统计场景下的首选方案:
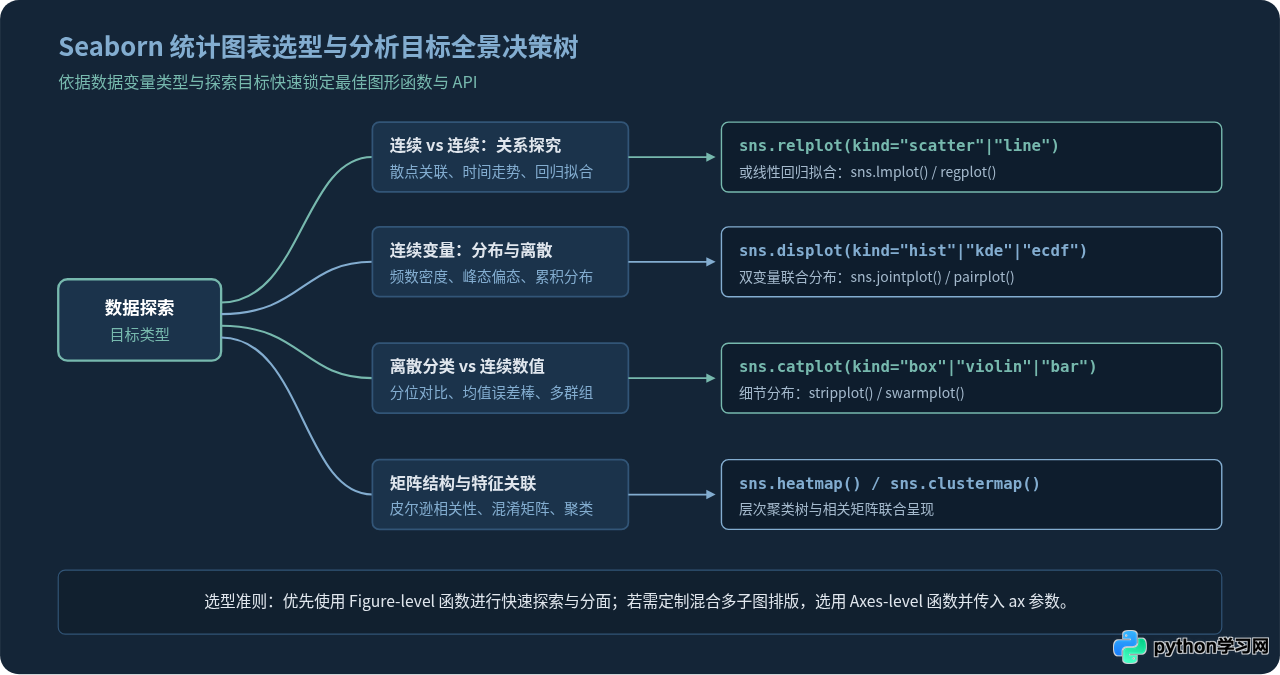
| 目标分析类型 | Figure-level 入口 | 常用 Axes-level 函数 | 典型统计应用场景 |
|---|---|---|---|
| 关系型 (Relational) | sns.relplot() |
scatterplot, lineplot |
两连续变量相关性、时序均值与置信区间走势 |
| 分布型 (Distribution) | sns.displot() |
histplot, kdeplot, ecdfplot |
观察变量分布偏态、双峰检测、分组密度重叠对比 |
| 分类对比 (Categorical) | sns.catplot() |
boxplot, violinplot, barplot |
不同部门/实验组的指标分位数对比与显著性观察 |
| 矩阵与相关性 (Matrix) | 无 (直接使用专用函数) | heatmap, clustermap |
多特征相关系数矩阵、混淆矩阵可视化、层次聚类热图 |
| 回归建模 (Regression) | sns.lmplot() |
regplot, residplot |
线性回归拟合、置信区间展示、残差分布检验 |
总结:Seaborn 的威力不仅在于提供了优雅统一的默认美学样式,更在于它深刻契合了现代数据分析的思维模式——以整洁数据(Tidy Data)为核心,将视觉映射与统计计算自动化。在日常开发中,建议先用 relplot、catplot、displot 等通用入口快速探索多维特征;当需要将图表嵌入复杂报告或仪表盘时,再结合 plt.subplots 与具体的轴级函数完成像素级排版,从而真正达到高效、优雅与专业的可视化效果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















