


Python文件读写完整代码示例:使用with语句处理文本与二进制数据
本文详细介绍Python中使用with语句安全读写文本文件与二进制文件的方法,涵盖open()核心参数、编码设置、逐行读取、二进制数据处理及异常处理机制,并附带完整可运行代码示例。
在Python开发中,文件输入与输出(I/O)是最基础且频繁的操作。标准库提供的 with open(...) as f: 语法基于上下文管理器协议(Context Manager),能够在代码执行完毕或中途发生异常时自动释放系统文件描述符,彻底避免资源泄漏。本文通过具体代码示例,系统讲解如何使用 with 语句可靠处理UTF-8文本文件与原始二进制文件,并提供工程实践中的核心判断规则。
一、with 语句的底层运行机制与安全价值
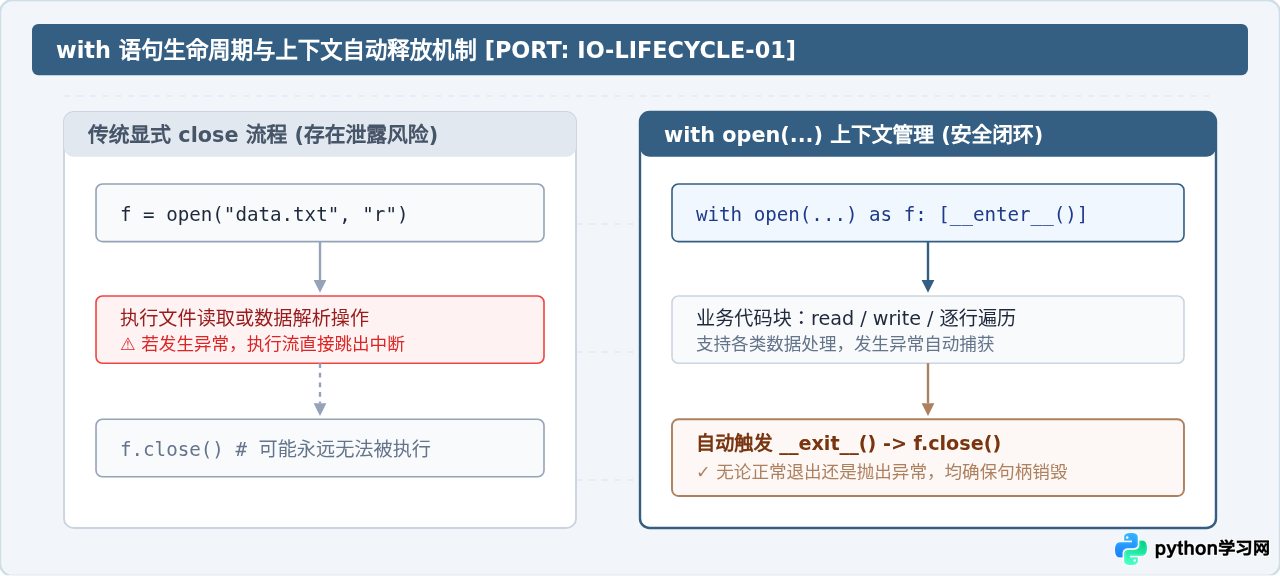
传统的文件操作通常依赖 f = open(...) 和显式调用 f.close()。如果程序在读写过程中遭遇除零、语法或网络中断等异常,显式关闭语句将直接被跳过,导致底层操作系统句柄持续处于占用状态。在高并发或长时间运行的服务中,这种句柄泄露最终会导致“Too many open files”(打开文件数超限)系统错误。
with 语句依托Python内部的 __enter__() 与 __exit__() 协议。进入 with 代码块时自动调用 __enter__() 获取文件句柄;无论块内逻辑是正常执行完毕,还是因异常抛出中断,解释器都会无条件执行 __exit__() 清理逻辑并触发 close()。
二、文本数据读写完整代码示例
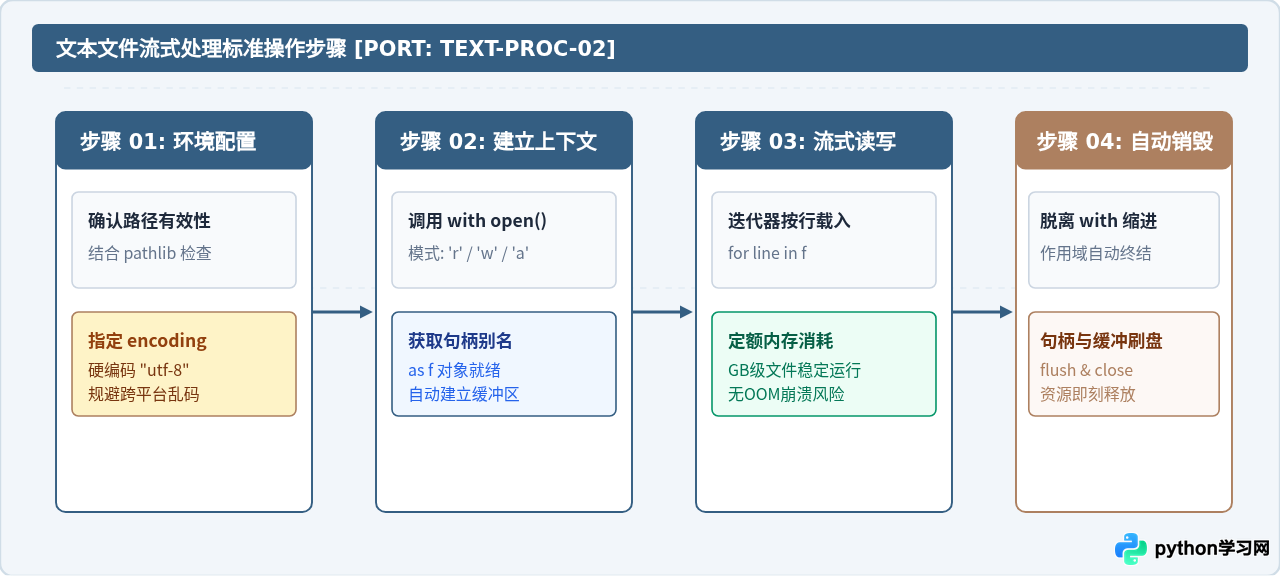
处理纯文本文件(如 .txt、.csv、.json、.log)时,核心关注点在于打开模式与字符编码(encoding)。在跨平台场景下,若未明确指定 encoding='utf-8',Python会默认采用操作系统当前环境编码(Windows上通常为GBK或ANSI,Linux/macOS通常为UTF-8),容易引发 UnicodeDecodeError。
1. 写入文本文件('w' 与 'a' 模式)
模式 'w'(Write)会覆盖已有文件;如果文件不存在则新建。模式 'a'(Append)会在文件末尾追加内容,不破坏旧数据。
# 示例1:以 UTF-8 编码写入文本文件
def write_text_data(file_path: str) -> None:
    content_lines = [
        "服务器初始化配置\n",
        "运行端口: 8080\n",
        "调试模式: False\n"
    ]

    # 使用 'w' 模式完全覆盖写入
    with open(file_path, mode="w", encoding="utf-8") as f:
        f.write("=== 系统配置文件 ===\n")
        f.writelines(content_lines)
    print("写入完成:", file_path)

# 示例2:追加日志记录
def append_text_log(file_path: str, message: str) -> None:
    with open(file_path, mode="a", encoding="utf-8") as f:
        f.write(f"[INFO] {message}\n")
    print("日志追加完成")

if __name__ == "__main__":
    target_file = "app_config.txt"
    write_text_data(target_file)
    append_text_log(target_file, "服务于 2026-10-26 正常启动")
2. 读取文本文件的三种方式
针对不同体积的文本,Python提供了三种读取方式:
f.read():一次性读取文件所有内容并返回单个字符串。只适用于小文件(几十兆字节以内),大文件会导致内存激增。f.readlines():一次性读取全部行并返回字符串列表。同样受制于内存。for line in f:(推荐):利用文件对象的迭代器协议,逐行从磁盘流式读取,内存占用几乎恒定,适合处理GB级别大日志。
# 示例3:流式逐行读取大文本文件
def read_text_safely(file_path: str) -> None:
    with open(file_path, mode="r", encoding="utf-8") as f:
        line_count = 0
        for line in f:
            line_count += 1
            # strip() 去除尾部换行符
            clean_text = line.strip()
            if clean_text:
                print(f"第 {line_count} 行: {clean_text}")

if __name__ == "__main__":
    read_text_safely("app_config.txt")
三、二进制数据读写完整代码示例
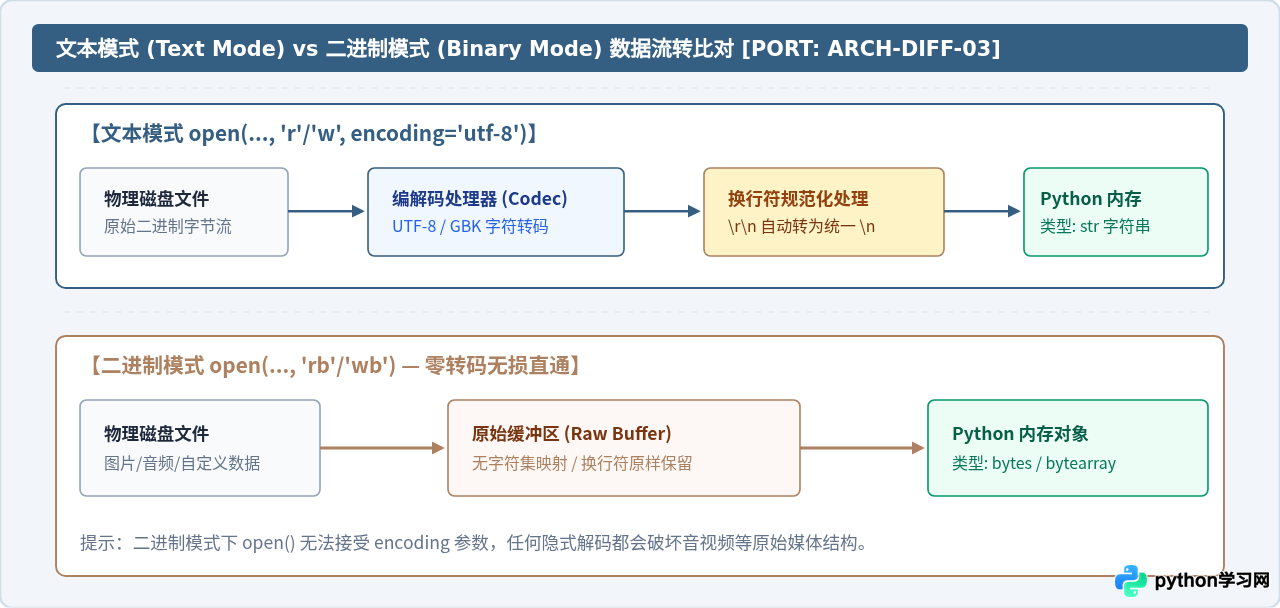
图像(PNG/JPEG)、音频、可执行文件、压缩包(ZIP)或自定义通信包均属于非文本的二进制数据。在处理此类数据时,模式字符串必须追加 'b'(例如 'rb'、'wb'、'ab')。
关键规则:在二进制模式下调用 open() 时,严禁传入 encoding 或 errors 参数,否则Python将直接抛出 ValueError: binary mode doesn't take an encoding argument。此外,读写的数据类型必须是 bytes 或 bytearray,而非 str。
1. 读取并分块处理大二进制文件(复制或哈希计算)
二进制文件不能按换行符划分。处理大体积二进制文件时,标准做法是设定固定的缓冲区大小(例如 64KB = 65536 字节),通过 while 循环不断读取块,直到返回空的 b''。
import hashlib

# 示例4:分块流式读取二进制文件并计算 SHA-256 哈希值
def calculate_file_sha256(file_path: str, chunk_size: int = 65536) -> str:
    hasher = hashlib.sha256()

    with open(file_path, mode="rb") as f:
        while True:
            # 每次读取固定字节数
            chunk = f.read(chunk_size)
            if not chunk:
                # 读至文件尾部 EOF
                break
            hasher.update(chunk)

    return hasher.hexdigest()

# 示例5:多文件上下文管理器实现大二进制文件无损复制
def safe_binary_copy(src_path: str, dst_path: str, chunk_size: int = 65536) -> int:
    total_bytes = 0
    # 同时打开源文件(读取)与目标文件(写入)
    with open(src_path, mode="rb") as src, open(dst_path, mode="wb") as dst:
        while True:
            chunk = src.read(chunk_size)
            if not chunk:
                break
            dst.write(chunk)
            total_bytes += len(chunk)

    return total_bytes

if __name__ == "__main__":
    # 模拟操作一个本地二进制文件
    # print("SHA256:", calculate_file_sha256("firmware.bin"))
    pass
2. 构造并直接写入二进制字节流
当需要将数值、文件头魔数或协议包写入文件时,可以使用 bytes 字面量(带 b 前缀)或 bytearray。
# 示例6:写入二进制魔数与原始字节序列
def create_custom_binary_file(output_path: str) -> None:
    # 构造 PNG 标准文件头标识: 89 50 4E 47 0D 0A 1A 0A
    png_magic_header = bytes([0x89, 0x50, 0x4E, 0x47, 0x0D, 0x0A, 0x1A, 0x0A])

    # 附加一些自定义二进制数据
    payload = b"\x00\x01\x02\xFF\xFE\xFD"

    with open(output_path, mode="wb") as f:
        f.write(png_magic_header)
        f.write(payload)

    print(f"二进制文件已生成,总写入字节数: {len(png_magic_header) + len(payload)}")

if __name__ == "__main__":
    create_custom_binary_file("sample_header.bin")
四、关键差异对比与选型原则
为方便开发过程中快速决策,下表归纳了两种模式在核心参数与运行表现上的本质区别:
| 比对维度 | 文本模式(Text Mode) | 二进制模式(Binary Mode) |
|---|---|---|
| 模式参数示例 | 'r', 'w', 'a', 'r+' |
'rb', 'wb', 'ab', 'rb+' |
| 操作数据类型 | str(Unicode 文本字符) |
bytes / bytearray(原始字节) |
| encoding 参数 | 强烈推荐显式传入(如 encoding='utf-8') |
严禁使用(传入会抛出 ValueError) |
| 换行符机制 | 自动翻译换行符(如 Windows \r\n 映射为 \n) |
严格保留底层字节,不发生任何替换 |
| 典型适用文件 | .txt, .csv, .json, .xml, .md, .py |
.jpg, .png, .mp4, .zip, .bin, 协议包 |
五、常见异常排查与防御式编程
即便使用了 with 语句,仍然需要针对可能发生的文件系统异常做好防御性处理。常见的异常场景包括:
- FileNotFoundError:读取模式下指定的文件路径不存在,或相对路径解析基准不符合预期。
- PermissionError:当前运行环境缺乏对目标路径的读取或写入权限,或者试图向一个受保护的系统目录写入。
- UnicodeDecodeError:文本模式下指定的文件编码(如 UTF-8)与文件实际编码格式(如 GBK)发生冲突。
import os
from pathlib import Path

# 示例7:结合 try-except 与 with 语句的健壮读写函数
def robust_read_text(file_path: str) -> str:
    path_obj = Path(file_path)

    # 步骤1:主动检查存在性与类型
    if not path_obj.exists():
        print(f"[警告] 文件未找到: {file_path}")
        return ""
    if not path_obj.is_file():
        print(f"[警告] 路径并非普通文件: {file_path}")
        return ""

    # 步骤2:安全尝试读取
    try:
        with path_obj.open(mode="r", encoding="utf-8") as f:
            return f.read()
    except UnicodeDecodeError:
        print("[重试] UTF-8 解码失败,正在尝试使用 GB18030 兼容读取...")
        try:
            with path_obj.open(mode="r", encoding="gb18030") as f:
                return f.read()
        except Exception as e:
            print(f"[错误] 无法解码文件内容: {e}")
            return ""
    except PermissionError:
        print(f"[错误] 权限不足,无法访问文件: {file_path}")
        return ""

if __name__ == "__main__":
    content = robust_read_text("app_config.txt")
    if content:
        print("成功读取字符长度:", len(content))
六、总结
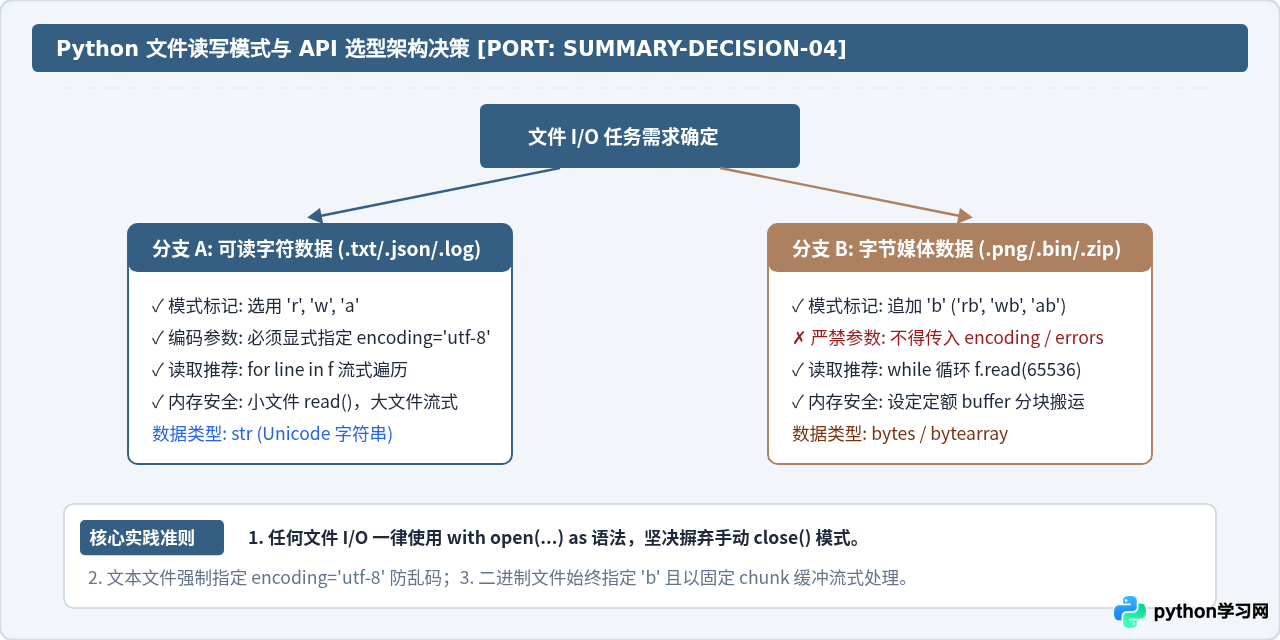
使用 with 语句管理文件资源是Python编写健壮代码的通用标准。掌握文本模式与二进制模式的差异在于:
- 处理文本数据时,必须时刻保持对字符集(
encoding='utf-8')的明确控制,优先使用迭代器(for line in f)按行处理以降低内存压力。 - 处理二进制数据时,务必使用带
b的模式,严格禁止传入encoding参数,并通过固定大小的缓冲区(chunk)实现高吞吐分块读写。
通过规范地将异常捕获、路径校验以及 with 上下文管理器结合,可以有效消除由于句柄泄漏、解码崩溃与内存溢出导致的生产环境隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















