


为什么Python大数据量成员检查推荐使用集合而非列表
深入解析Python中在大数据量场景下进行成员检查推荐使用集合而非列表的底层原因,对比线性扫描与哈希寻址机制、时空开销及工程实践要点。
在 Python 中,使用 in 关键字检查某个元素是否存在于容器中是极其常见的操作。当处理的数据规模达到成千上万乃至百万级别时,使用集合(set)进行成员检查的速度通常比列表(list)快成百上千倍。核心原因在于两者的底层数据结构存在本质差异:列表基于连续数组实现,查找必须进行线性顺序扫描,平均时间复杂度为 O(n);而集合基于开地址哈希表实现,能通过键的哈希值直接定位存储桶,平均查找时间复杂度达到 O(1)。
一、底层数据结构与查找机制对比
要理解为什么在大数据量下两者的性能差距会急剧放大,首先需要看 Python 虚拟机(CPython)在内存中如何组织这两种容器。
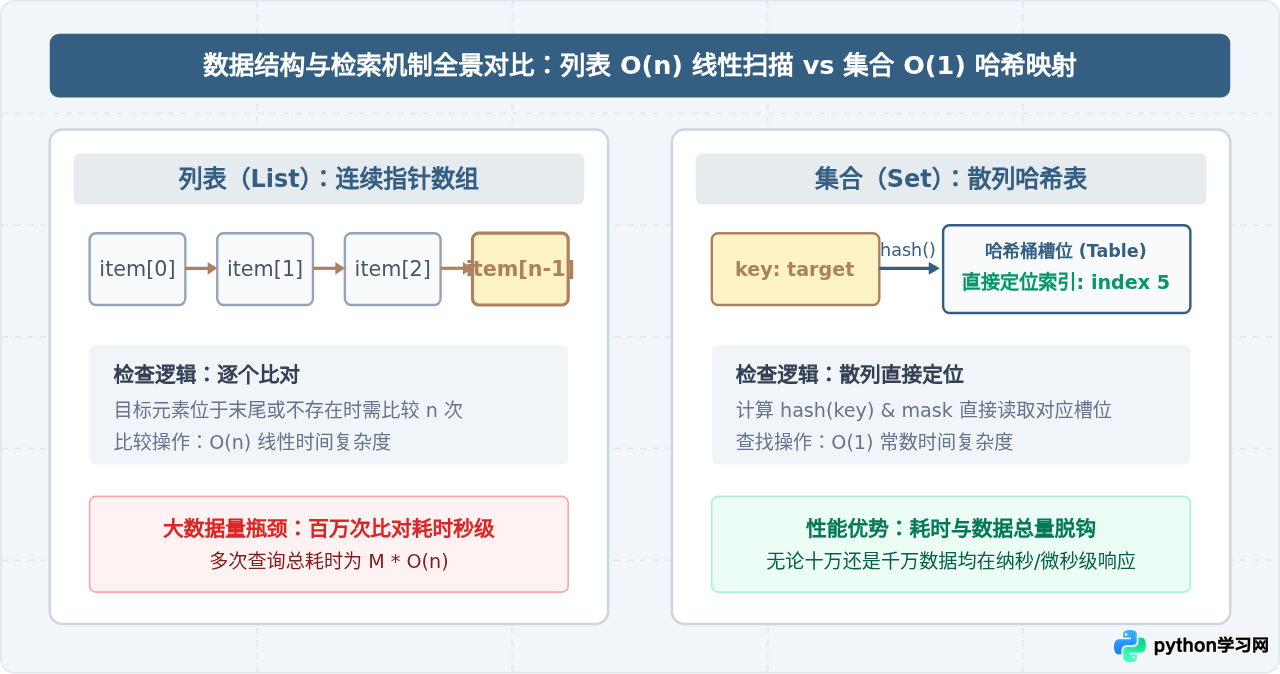
Python 的列表实质上是一个动态的指针数组(PyListObject)。当执行 target in my_list 时,解释器会从索引 0 开始逐个取出元素指针,调用比较操作判断是否与 target 相等。如果目标元素恰好在末尾或者根本不存在于列表中,程序就必须遍历整整 n 个元素。数据量越大,耗时呈线性同步增长。
与之相反,Python 的集合(PySetObject)是一个高度优化的紧凑型哈希表。执行 target in my_set 时,解释器先计算 target 的哈希值,通过位运算直接将哈希值映射为内部哈希桶数组的索引。这一过程不需要遍历其他无关元素,直接在常数时间内判定目标是否存在。
二、性能差异的实际验证
为了直观展现差异,我们编写一个针对包含 100 万个整数的容器进行成员检查的标准测试脚本。下面的示例在同等硬件环境下测试未命中的情况(最坏时间成本):
import time

# 准备 100 万个元素的列表与集合
DATA_SIZE = 1_000_000
data_list = list(range(DATA_SIZE))
data_set = set(data_list)

target = -1  # 挑选一个不存在的元素进行最坏情况检查

# 1. 测试列表查找耗时
start_time = time.perf_counter()
is_in_list = target in data_list
list_duration = time.perf_counter() - start_time

# 2. 测试集合查找耗时
start_time = time.perf_counter()
is_in_set = target in data_set
set_duration = time.perf_counter() - start_time

print(f"列表查找耗时: {list_duration:.6f} 秒")
print(f"集合查找耗时: {set_duration:.9f} 秒")
print(f"性能比率: 集合比列表快约 {int(list_duration / set_duration)} 倍")
在常规现代计算机上,上述测试输出结果通常如下所示:
# 示例输出(视具体 CPU 型号略有波动,但量级保持一致):
列表查找耗时: 0.012543 秒
集合查找耗时: 0.000000052 秒
性能比率: 集合比列表快约 241211 倍
单次检查可能看似只有 12 毫秒的差异,但如果业务场景需要对外部输入的 10,000 个 ID 在这 100 万数据中做白名单过滤,使用列表的总耗时将飙升至 10000 * 0.012s ≈ 120 秒(整整 2 分钟),而使用集合仅需几毫秒即可全部完成。这种由 O(M * N) 降至 O(M * 1) 的复杂度降维是任何硬件升级都无法替代的。
三、集合成员检查的内部执行流程与冲突处理
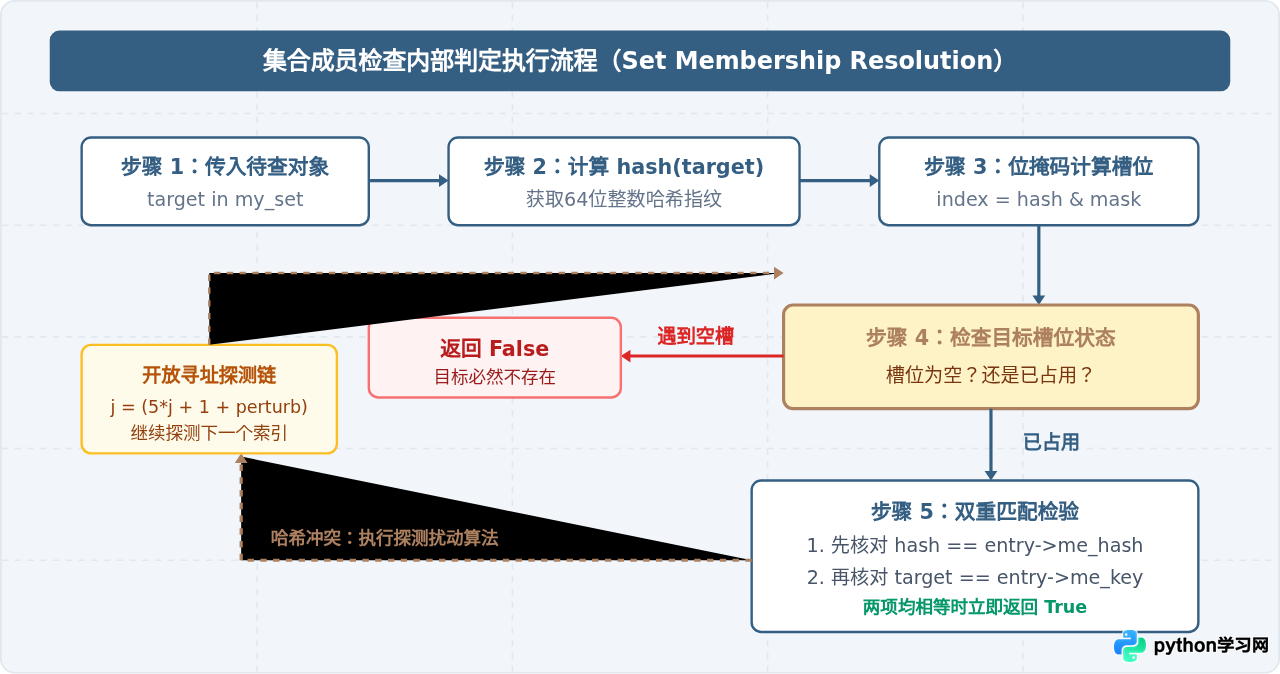
很多开发者知道集合查找快,但并不了解其背后的确切执行流程。集合的高效来自于以下几个标准步骤:
- 计算哈希值:调用内置的
hash(target)。若该对象不可哈希,直接抛出TypeError。 - 确定初始槽位:通过按位与运算
index = hash_value & mask映射到特定槽位。 - 探测槽位:
- 若槽位为
EMPTY,说明元素必定不在集合中,直接返回False。 - 若槽位存有元素,先比较两者的哈希值。若哈希值相等,再调用
==进行实质内容比较;若一致则返回True。
- 若槽位为
- 开放寻址处理冲突:如果遇到哈希冲突(不同对象的哈希映射到了同一个槽位或哈希值相同但内容不同),CPython 会使用扰动算法
perturb >>= 5; j = (5*j + 1 + perturb) & mask探测下一个可用槽位,直至找到匹配项或空槽。
四、权衡与代价:内存消耗与前置转换开销
虽然集合在时间复杂度上全面优于列表,但这种效率是通过牺牲空间换来的。在工程实践中需要注意以下两点:
1. 空间与内存占用
哈希表为了降低冲突概率、保持 O(1) 的查找效率,必须维持较低的装载因子(Load Factor,通常在 2/3 左右),内部会预留大量未使用的空槽位。因此,存储相同数量的元素,集合占用的内存通常是列表的 3 到 4 倍。
| 容器类型 | 1,000,000 整数内存占用 (约) | 成员查找时间复杂度 | 元素有序性 | 元素唯一性要求 |
|---|---|---|---|---|
| 列表 (List) | 约 8 MB (指针数组) | 平均 O(n),最坏 O(n) | 严格保留插入顺序 | 允许任意重复元素 |
| 集合 (Set) | 约 32 MB (稀疏哈希表) | 平均 O(1),最坏 O(n) | 无序(不保证顺序) | 自动去重,元素必须唯一 |
2. 常见反模式:循环内部重复转换
初学者容易写出如下低效代码:
# 错误示例:反模式
for item in query_items:
    # 每次循环都将拥有百万元数据的列表转换为 set!
    if item in set(big_data_list):  # 极其致命的性能杀手
        process(item)
将一个包含 N 个元素的列表转换为集合(set(big_data_list)),需要依次计算这 N 个元素的哈希并插入哈希表,该初始化操作本身的时间复杂度就是 O(N)。如果在 M 次循环中每次都转换,总耗时将变为 O(M * N),不仅没有享受到 O(1) 的收益,反而引入了巨额的内存分配与垃圾回收开销。
正确做法:在循环外部执行一次预处理转换,然后复用该集合对象:
# 正确示例:提前预处理转换
big_data_set = set(big_data_list)  # 仅做一次 O(N) 转换
for item in query_items:
    if item in big_data_set:       # 每次均为 O(1) 高速检查
        process(item)
五、集合的限制:可哈希性(Hashability)与解决方案
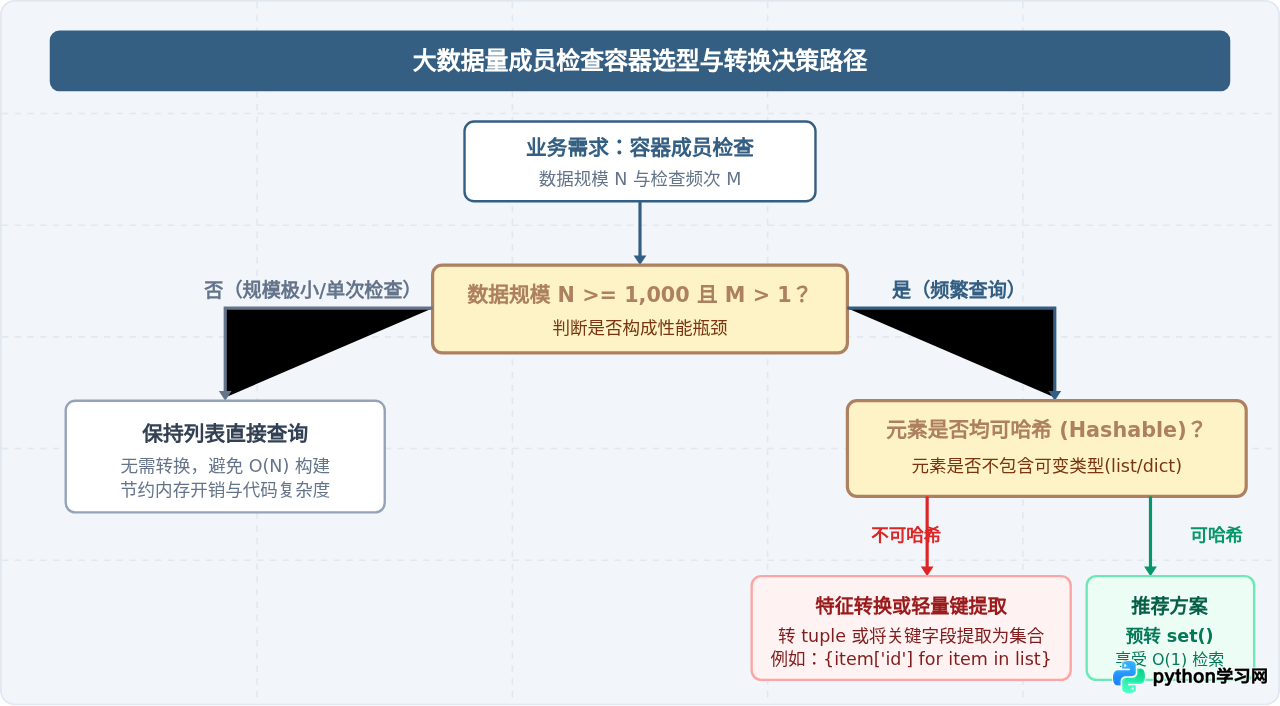
集合虽然高效,但并非所有数据类型都可以放入集合中。能够加入集合的元素必须满足可哈希协议(Hashable):
- 该对象必须实现
__hash__()方法,且在其生命周期内返回恒定不变的哈希值。 - 该对象必须实现
__eq__()方法,用于解决哈希碰撞时比对实质相等性。 - 若两个对象相等(
a == b),则其哈希值必须相等(hash(a) == hash(b))。
list、dict、set)默认是不可哈希的,直接将其加入集合会引发 TypeError: unhashable type: 'list'。
当面对包含复杂嵌套结构或可变对象的大数据列表时,推荐采用以下策略:
- 不可变替代:将内层可变列表转为不可变元组
tuple,将内层字典转为冻结项元组tuple(sorted(d.items()))。 - 提取唯一键(Unique Key):业务中往往只需要比对主键或唯一编码(例如用户 ID、订单号、UUID),仅需提取该唯一字段构建集合进行查找:
# 列表包含 10 万个用户字典
users = [{"id": 1001, "name": "Alice"}, {"id": 1002, "name": "Bob"}, ...]

# 提取 ID 构建集合,既可哈希又极大节省内存
valid_user_ids = {user["id"] for user in users}

# 成员检查:依然是超高速的 O(1)
if target_id in valid_user_ids:
    print("用户存在")
六、工程实践总结
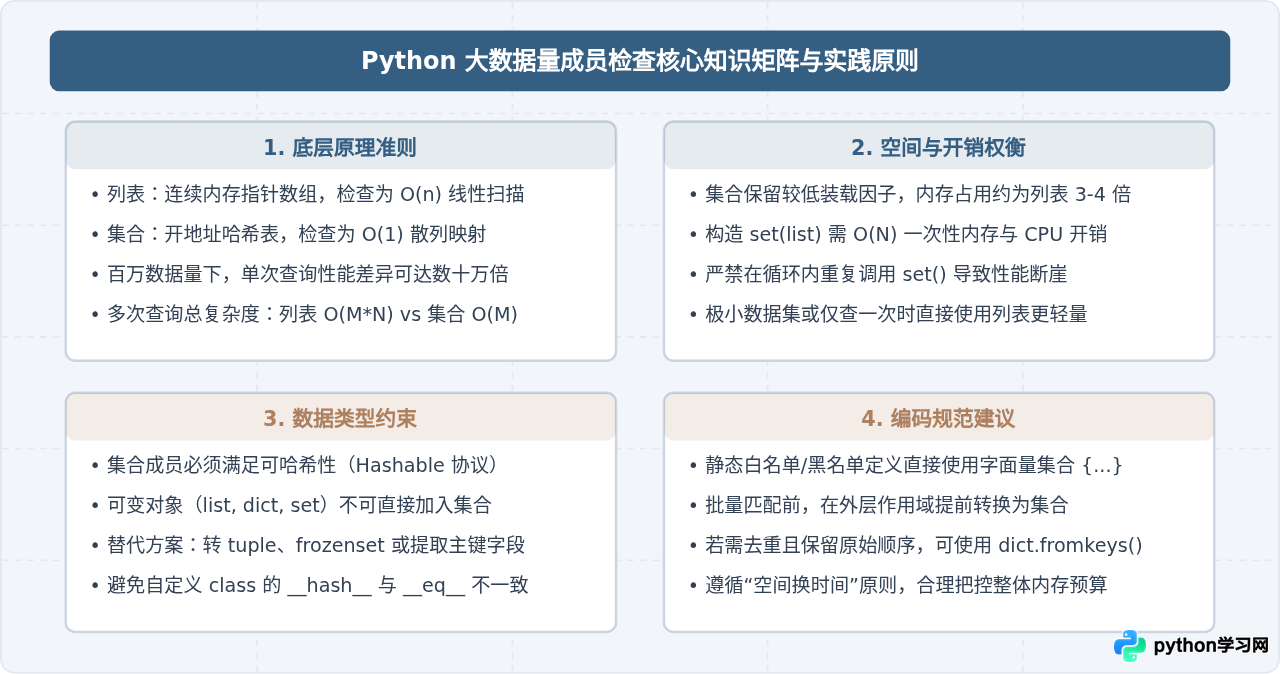
在大数据量场景下,将成员检查的目标容器由列表替换为集合,是提升 Python 程序性能最高效的手段之一。总结核心实践准则如下:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















