


Python中怎么实现GBK与UTF-8文件编码转换
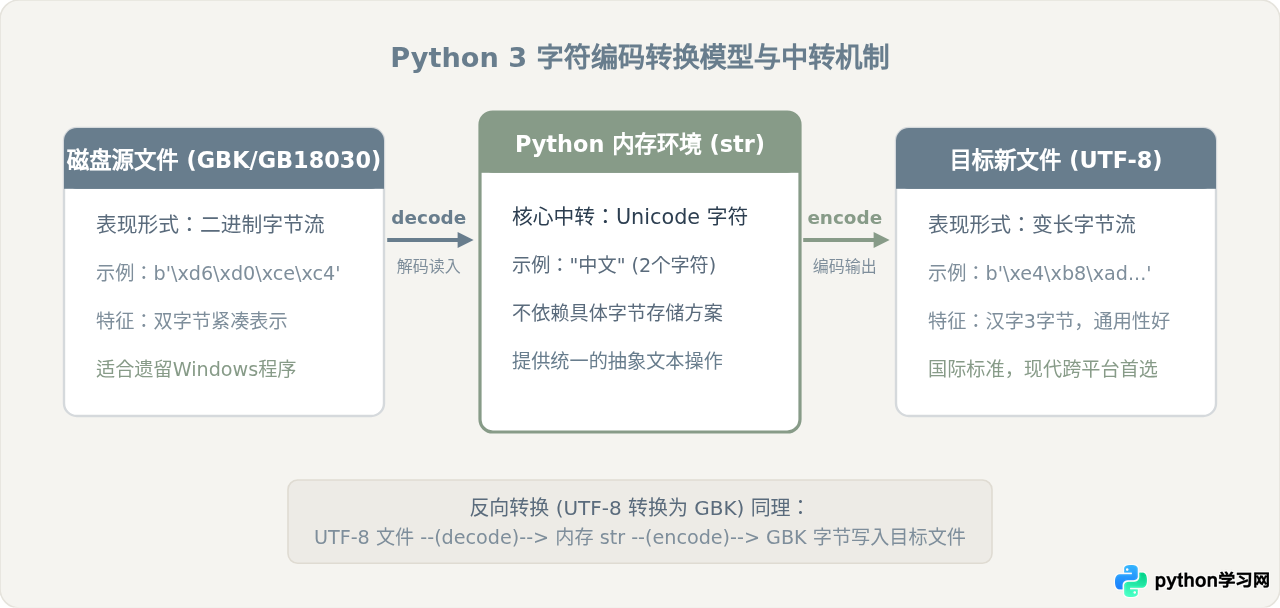
在Python中实现GBK与UTF-8文件编码转换的核心思路是以内存中的Unicode作为中转桥梁:先用源文件实际编码(GBK或更通用的GB18030)读取内容并解码为Python字符串对象,再指定目标编码(UTF-8)将其编码写入新文件中。针对不同体量的数据,分别采用一次性整体读写或流式分块写入即可安全完成转换。
一、编码转换的核心机制:为什么必须经过Unicode中转
计算机硬盘中保存的文件本质上只是一串由0和1构成的二进制字节(Bytes)。GBK和UTF-8是两套完全不同的编码规则:GBK属于双字节扩展编码,主要面向简体中文汉字;UTF-8则是变长编码方案,ASCII字符占1字节,常用汉字通常占用3字节。这两者之间并不存在直接按字节映射的换算公式。
在Python 3中,内存里的所有文本字符串类型(str)统一使用Unicode标准表示。因此,任何跨编码的转换过程,本质上都是先将输入字节串还原为抽象的字符对象,再将这些字符对象重新按目标规则序列化为输出字节流:
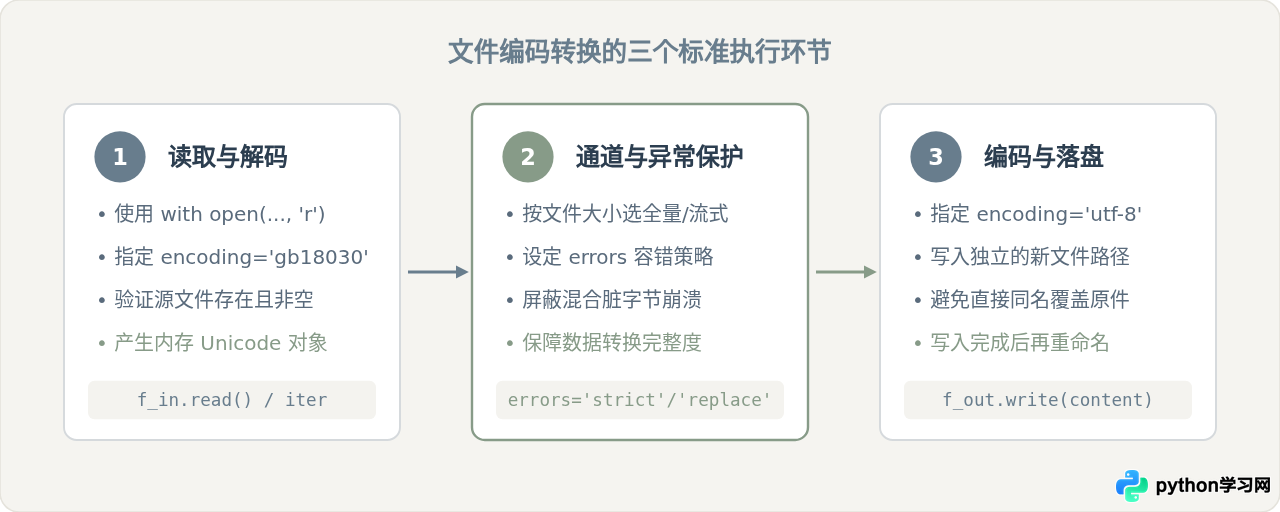
二、标准操作步骤:常规文件的一次性全量转码
对于几十兆字节以内的普通文档、配置文件或代码源文件,最直接稳妥的方式是使用Python内置的上下文管理器with open(),配合指定的encoding参数完成一读一写。
标准操作实现
def convert_file_encoding(src_file, dst_file, src_enc="gb18030", dst_enc="utf-8"):
    # 第一步:以源编码打开并读取全部文本
    with open(src_file, "r", encoding=src_enc) as f_in:
        content = f_in.read()

    # 第二步:以目标编码将解析出的文本写入新文件
    with open(dst_file, "w", encoding=dst_enc) as f_out:
        f_out.write(content)

# 示例调用:将GBK文件转换为UTF-8
convert_file_encoding("data_gbk.txt", "data_utf8.txt", src_enc="gb18030", dst_enc="utf-8")

# 反向调用:将UTF-8文件转换为GBK
convert_file_encoding("data_utf8.txt", "data_gbk_new.txt", src_enc="utf-8", dst_enc="gb18030")gb18030是国家强制标准的超集,它完全向后兼容gbk和gb2312,但收录了更多汉字和少数民族字符。很多包含生僻人名、地名或特殊符号的GBK文件在纯gbk模式下解码会抛出UnicodeDecodeError,而改用gb18030则能平滑解析。
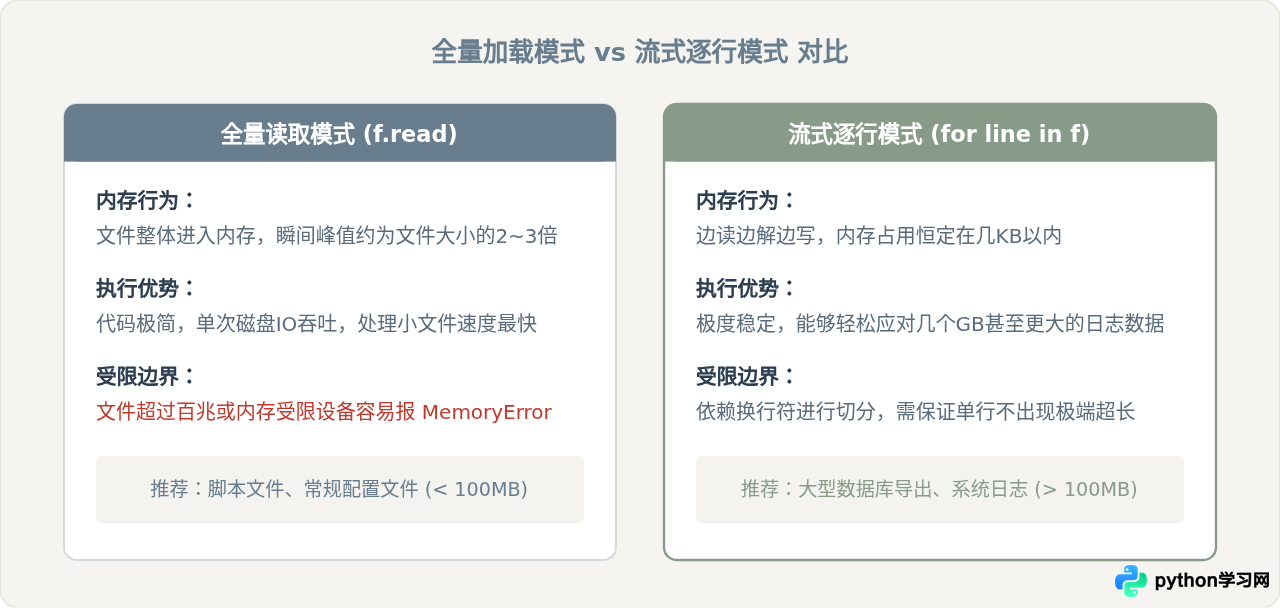
三、方案对比:全量读取与逐行流式转换
在实际生产环境中,面对不同大小的文件,采用的处理策略有明确的边界。理解这两种模式在内存占用和系统开销上的差异,对于编写稳健的批处理脚本至关重要。
流式转换的代码实现
借助文件对象的迭代器特性,可以在一个复合上下文中同时维持输入流和输出流,逐行完成转换:
def stream_convert(src_file, dst_file, src_enc="gb18030", dst_enc="utf-8"):
    # 同时打开输入与输出文件流
    with open(src_file, "r", encoding=src_enc, errors="replace") as f_in, \
         open(dst_file, "w", encoding=dst_enc) as f_out:
        for line in f_in:
            f_out.write(line)

# 执行大文件安全转换
stream_convert("large_log_gbk.csv", "large_log_utf8.csv")
四、常见问题与防御性处理
在编码转换过程中,最容易出现的是由于编码误判或脏数据引发的中断。妥善配置防御机制可以避免转码任务半途而废。
1. 正确使用 errors 参数
默认情况下,open()函数的errors参数值为"strict"。一旦遇到不符合当前编码规则的字节,Python会立刻抛出UnicodeDecodeError。在工业化批处理中,可以根据业务容忍度调整该参数:
errors="replace":遇到损坏或非法字节时,将其自动替换为Unicode通用替换字符\ufffd(显示为一个带问号的菱形),既保留了有效文本,又保证了进程不崩溃。errors="ignore":直接丢弃所有不符合规则的字节。注意:这会导致少量文字直接丢失且不留痕迹,通常不建议在重要数据中作为首选。
2. UTF-8的BOM标识问题
某些Windows程序(如早期的Excel或记事本)在保存UTF-8文件时,会在文件开头添加3个字节的标记(\xef\xbb\xbf,即BOM头)。如果直接用普通的utf-8解码,第一行开头的字符可能会带上一个不可见的\ufeff,导致解析异常。针对此类文件,读取时指定encoding="utf-8-sig",Python会自动检测并剥离该标识。
3. 避免原地直接覆盖原文件
不要使用open(path, "w")直接向正在读取的文件名写入。一旦读取或转码中途发生异常,原文件内容已经被清空或破坏。最佳实践是先写入临时文件,全部成功后再通过os.replace()完成原子替换:
import os

def safe_convert_in_place(file_path, src_enc="gb18030", dst_enc="utf-8"):
    temp_path = file_path + ".tmp"
    try:
        with open(file_path, "r", encoding=src_enc, errors="replace") as f_in, \
             open(temp_path, "w", encoding=dst_enc) as f_out:
            for line in f_in:
                f_out.write(line)
        # 转换无误后,原子性替换原文件
        os.replace(temp_path, file_path)
    except Exception as e:
        if os.path.exists(temp_path):
            os.remove(temp_path)
        raise e
五、总结与转码决策速查
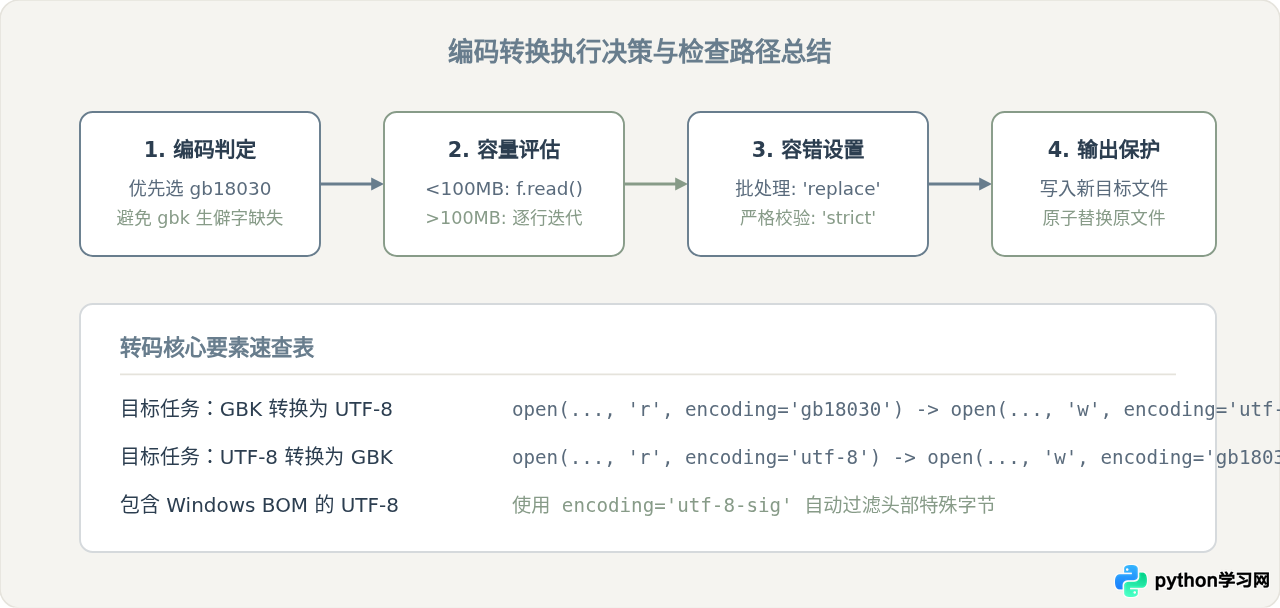
在Python中处理GBK与UTF-8的双向转换,核心要点可归纳为:认准Unicode中转模型、大文件采用流式迭代、源端优先声明gb18030以覆盖更多字符、并结合原子替换防范文件损坏。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















