


Python list和array模块有什么区别?内存占用与性能对比
深入对比Python内置list与标准库array模块的底层实现差异,通过内存布局解析、真实数据基准测试、操作耗时量化以及选型决策树,全面解析两者的内存占用与运行性能。
list 是基于指针数组实现的通用动态容器,能够存储任意异构对象,开发极其灵活但存在显著的内存与指针间接寻址开销;标准库的 array 模块则是基于 C 语言原生数据类型的紧凑单维连续数组,必须存储同构的基础数值类型。当存储数百万级基础数值时,array 占用的内存通常只有 list 的四分之一到十分之一,但在纯 Python 循环遍历时由于频繁的装箱与拆箱操作,其执行速度可能反而略慢于已解析的对象指针列表。
一、底层实现机制:指针数组与原生连续缓冲区的本质分歧
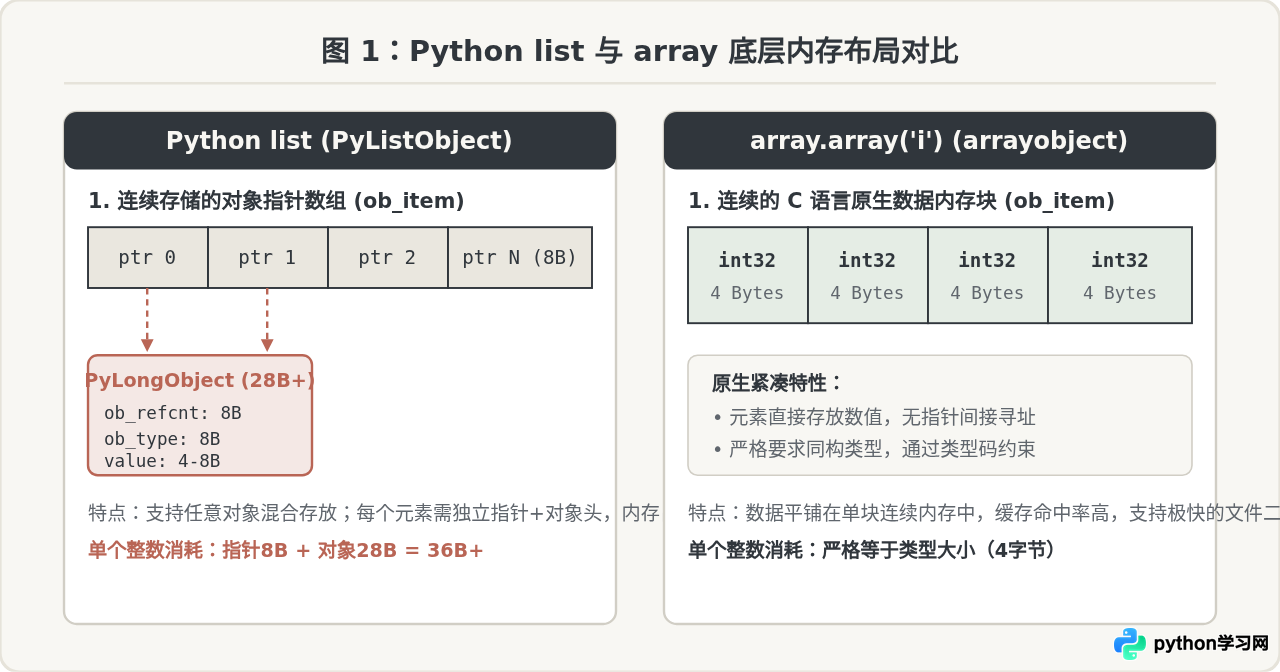
很多 Python 初学者容易将 list 当成普通数组看待,但从 CPython 解释器的底层 C 结构实现来看,两者存在根本性的架构差异:
- list(PyListObject):本质是一个存储
PyObject*对象指针的动态连续数组。无论向列表中存放整数、浮点数还是字符串,list内部直接存储的都不是具体的数值,而是指向各个对象在堆内存中独立分配位置的 64 位内存指针。每个 Python 整数本身都是一个完整的PyLongObject,包含引用计数、类型指针以及分块存储的数值,即使是最基础的整数 0,在 64 位系统上也额外背负着 28 字节的元数据开销。 - array(arrayobject):属于 Python 标准库内置模块,其内部开辟的是一块连续的原始 C 语言数据缓冲区(如同 C 语言的
int[]或double[])。如果在声明时指定类型码为'i'(带符号 4 字节整数),那么每个数组元素就实打实地只占用连续内存中的 4 个字节,没有任何额外的指针引用,也没有散落在堆上的独立对象头。
二、内存占用量化对比:1000 万个整数的实测分析
为了直观感受内存差异,我们设计一个量化测试:分别使用 list 和 array 存储 10,000,000(一千万)个 32 位整型数字,使用标准库的 sys.getsizeof() 观察容器自身及其所维护的数据开销。
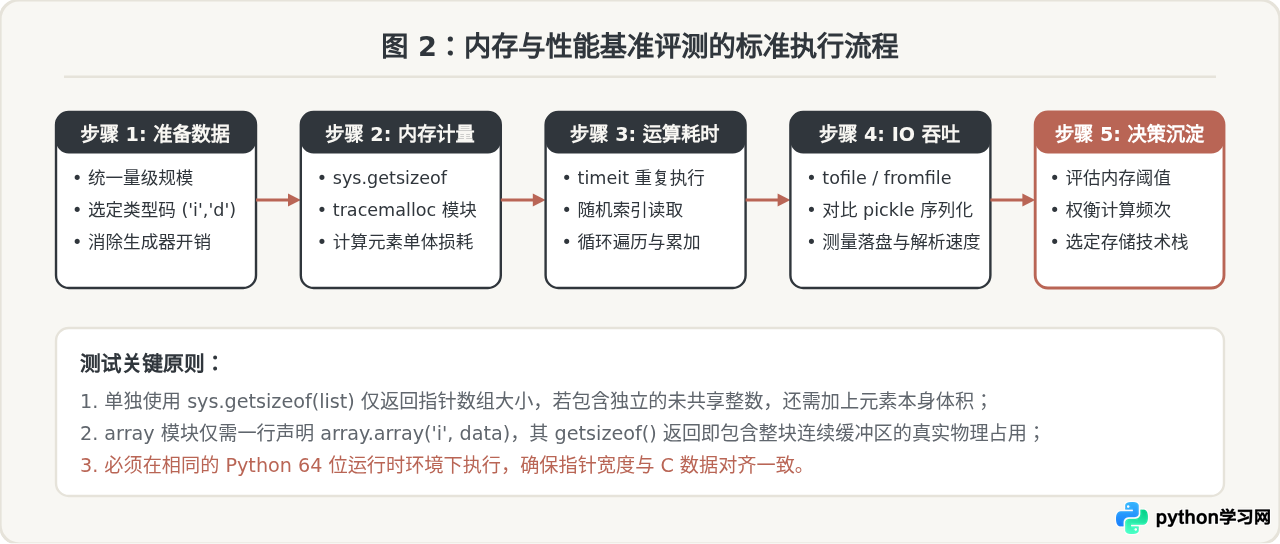
下面是可复现的测试脚本,用于量化 1000 万个整数的内存占用:
import sys
import array

N = 10_000_000

# 1. 测量 array.array('i') 的内存占用('i' 代表 4 字节 signed int)
arr = array.array('i', range(N))
arr_mem = sys.getsizeof(arr)

# 2. 测量 list 的指针数组占用
lst = list(range(N))
lst_ptr_mem = sys.getsizeof(lst)

# 单个独立整数(大于 256,避开小整数对象池)的开销
sample_int = 10_000_001
int_obj_size = sys.getsizeof(sample_int)

print(f"array('i') 自身总占用: {arr_mem / 1024 / 1024:.2f} MB")
print(f"list 自身指针数组占用: {lst_ptr_mem / 1024 / 1024:.2f} MB")
print(f"单个 int 对象大小: {int_obj_size} 字节")
print(f"list 若全为独立整数预估总内存: {(lst_ptr_mem + N * int_obj_size) / 1024 / 1024:.2f} MB")
在 64 位 CPython 3.11/3.12 环境下,输出结果如下(实际数字会随小版本微调):
# 示例输出:
array('i') 自身总占用: 38.15 MB
list 自身指针数组占用: 76.29 MB
单个 int 对象大小: 28 字节
list 若全为独立整数预估总内存: 343.32 MB
数据解读:
- array('i'):1000 万个 4 字节整数精确需要
10,000,000 * 4 = 40,000,000字节,加上结构体头部几十字节的元数据,最终占用约为 38.15 MB。 - list 指针数组:由于存放 1000 万个 64 位指针(每个指针 8 字节),再加上 list 自身的预分配冗余容量,仅存放指针就需要约 76.29 MB。这还没算任何整数数据本身的体积。
- 整体内存:如果这 1000 万个数据是运算过程中产生的独立非共享整数(每个 28 字节),
list加上所有被引用的整数对象,系统堆总内存占用将飙升至 340 MB 以上。相比之下,array实现了近 9 倍的内存节约。
三、性能表现与耗时对比:装箱与拆箱的双刃剑
许多开发者直觉认为“array 既然底层是连续 C 数组,那么计算和遍历速度一定比 list 快得多”。但在实际测试中,结论往往出人意料:在纯 Python 循环中遍历和累加元素,list 经常比 array 更快。
为什么会出现这种反直觉的现象?核心原因在于 Python 虚拟机的装箱(Boxing)与拆箱(Unboxing)开销。
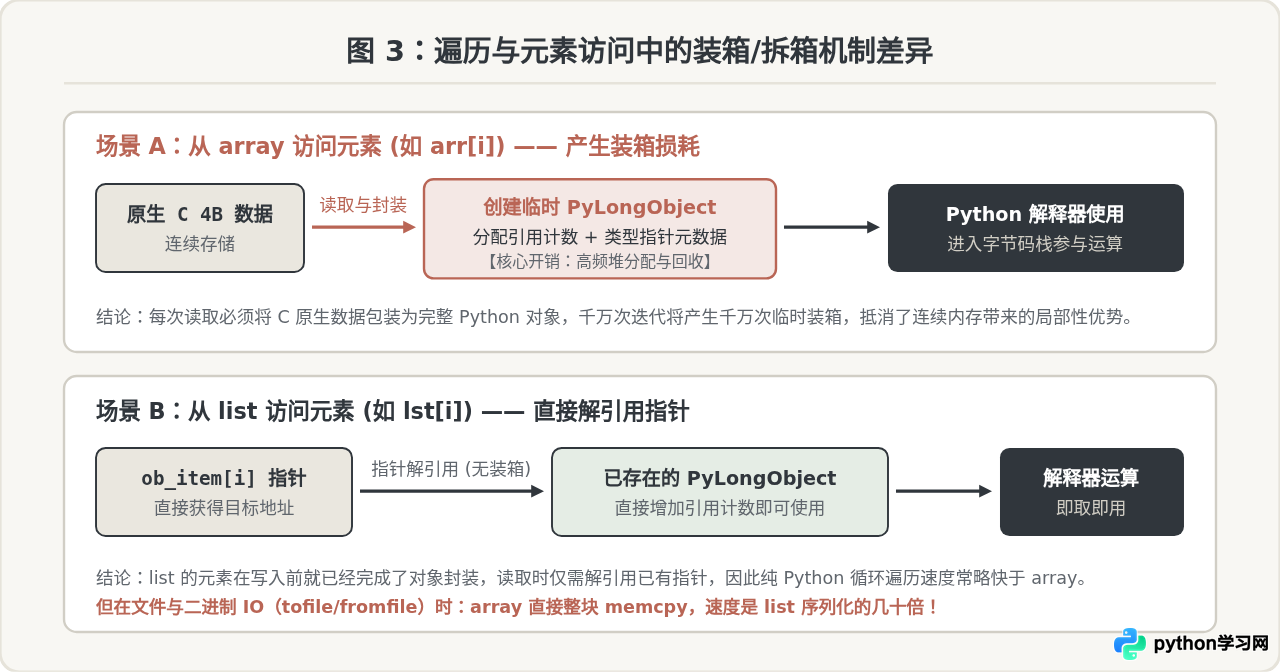
我们使用 timeit 针对常见操作进行量化基准测试:
import timeit
import array

setup_code = """
import array
N = 1_000_000
lst = list(range(N))
arr = array.array('i', range(N))
"""

# 1. 遍历并求和
t_list_sum = timeit.timeit("sum(lst)", setup=setup_code, number=30)
t_arr_sum = timeit.timeit("sum(arr)", setup=setup_code, number=30)

# 2. 索引读取
t_list_idx = timeit.timeit("[lst[i] for i in range(10000)]", setup=setup_code, number=100)
t_arr_idx = timeit.timeit("[arr[i] for i in range(10000)]", setup=setup_code, number=100)

print(f"30次 sum(lst) 耗时: {t_list_sum:.4f} 秒")
print(f"30次 sum(arr) 耗时: {t_arr_sum:.4f} 秒")
print(f"100次 循环索引读取 list 耗时: {t_list_idx:.4f} 秒")
print(f"100次 循环索引读取 array 耗时: {t_arr_idx:.4f} 秒")
运行结果(典型性能特征):
# 示例输出:
30次 sum(lst) 耗时: 0.1852 秒
30次 sum(arr) 耗时: 0.3120 秒
100次 循环索引读取 list 耗时: 0.0410 秒
100次 循环索引读取 array 耗时: 0.0768 秒
测试证实:在 Python 级别的 for 循环或内置函数迭代中,array 的元素必须临时经历 C 标量到 Python int 对象的构造过程,导致其耗时约为 list 的 1.5 到 2 倍。
然而,在二进制 IO 场景下 array 具备绝对优势:
如果业务涉及到将海量数值序列持久化到磁盘,或通过网络套接字传输:
list必须使用pickle序列化,或者遍历写入文本(CSV/JSON),伴随着巨大的序列化与字符串解析开销;array提供了原生的arr.tofile(f)和arr.fromfile(f, n)方法,其底层实现就是 C 标准库的fwrite和fread,直接将内存块与磁盘进行无损memcpy复制,速度通常比pickle快 10 倍以上,比文本解析快数十倍,生成的文件体积也严格紧凑。
import array
import time

arr = array.array('i', range(5_000_000))

# 快速二进制落盘
start = time.perf_counter()
with open("data.bin", "wb") as f:
    arr.tofile(f)
write_time = time.perf_counter() - start

# 快速二进制恢复
arr_in = array.array('i')
start = time.perf_counter()
with open("data.bin", "rb") as f:
    arr_in.fromfile(f, 5_000_000)
read_time = time.perf_counter() - start

print(f"500万个整数写入耗时: {write_time:.4f} 秒")
print(f"500万个整数读取耗时: {read_time:.4f} 秒")
# 示例输出:
500万个整数写入耗时: 0.0125 秒
500万个整数读取耗时: 0.0098 秒
四、功能特性与类型码支持
array 的紧凑性来源于强类型约束。在初始化 array 时,必须显式传入一个字符作为类型码(Type Code),指定每个元素在底层 C 结构中的数据类型:
| 类型码 | 对应 C 类型 | 标准字节大小 | 取值范围与适用说明 |
|---|---|---|---|
'b' / 'B' |
signed / unsigned char | 1 字节 | -128~127 或 0~255,常用于字节流、灰度像素 |
'h' / 'H' |
signed / unsigned short | 2 字节 | -32,768~32,767,音频 PCM 采样数据 |
'i' / 'I' |
signed / unsigned int | 4 字节 | 常用 32 位整型序列 |
'l' / 'L' |
signed / unsigned long | 4 或 8 字节 | 长整型数据(大小取决于系统架构与 C 编译器) |
'q' / 'Q' |
signed / unsigned long long | 8 字节 | 64 位超大整型时间戳、UUID 高低位等 |
'f' |
float | 4 字节 | 单精度浮点数,3D 顶点坐标、图形变换参数 |
'd' |
double | 8 字节 | 双精度浮点数,高精度科学计算与时间序列 |
array.array('i') 中添加浮点数或字符串,会立刻抛出 TypeError: integer argument expected, got float;如果插入的整数超出底层 C 类型的上下界,会抛出 OverflowError。这种即时校验可以在输入边界提早发现脏数据。
五、选型决策指南:list、array 与 NumPy 边界
面对这几种看似重叠的序列容器,在实际项目中该如何选择?核心取决于三个维度:数据同构性、数据规模、以及对第三方库的依赖限制。
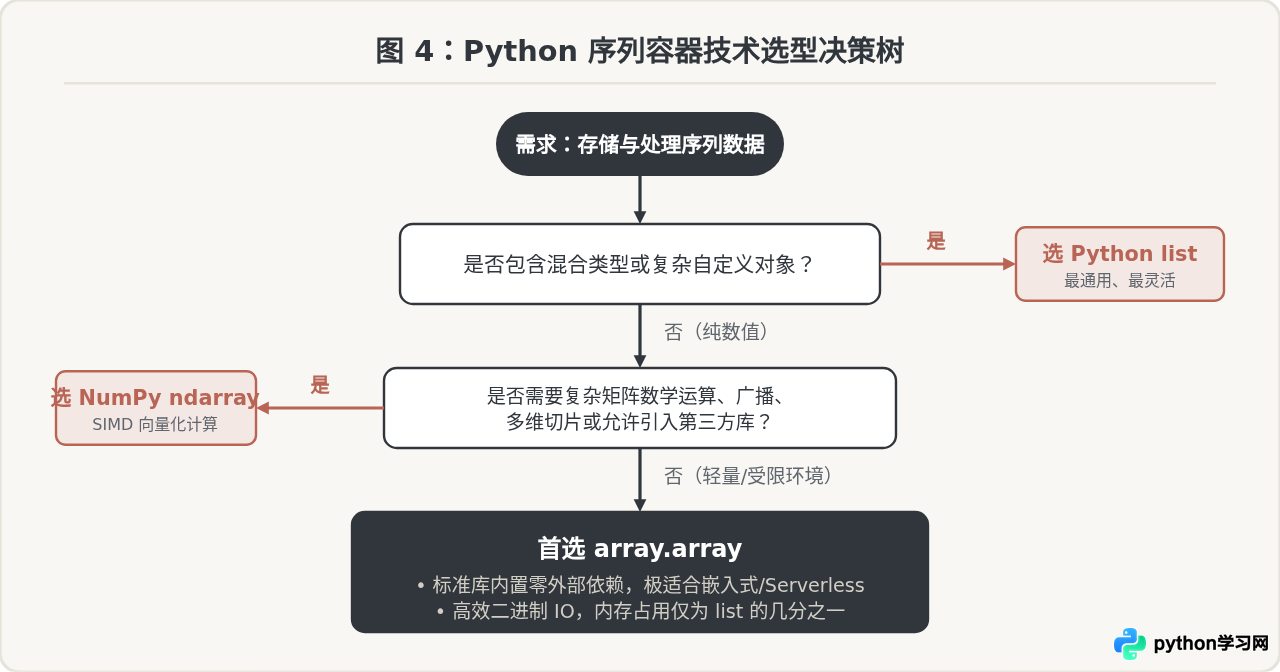
核心选型依据:
- 选用
list的场景:- 集合规模较小(例如万级以内),代码的可读性和开发便捷度优先;
- 需要存放异构数据(如字典、对象、字符串与数值混合);
- 需要频繁调用诸如
sort(key=...)、切片拼接等高度灵活的内置方法。
- 选用
array的场景:- 在受限环境或纯标准库环境(如 AWS Lambda 纯净运行环境、打包体积受限的 CLI 工具、嵌入式 MicroPython)中处理数百万乃至上千万的基础数值;
- 关注常驻内存占用,机器内存资源吃紧,不能承受 list 的指针冗余;
- 核心任务是二进制数据读写或网络流通信(如直接读写传感器采样点、音频帧数据流),通过
tofile()/fromfile()获取极高吞吐。
- 为何不直接用 NumPy?
- NumPy 是科学计算的行业标准,但它是一个体积庞大的 C/Fortran 外部二进制库。在轻量级脚本、无编译链的精简容器或对冷启动时间敏感的云函数中,引入 NumPy 会显著增加依赖体积和维护复杂度;如果你的代码仅仅需要“紧凑存储一列数字并存盘”,标准库自带的
array是最轻量的纯天然选择。
- NumPy 是科学计算的行业标准,但它是一个体积庞大的 C/Fortran 外部二进制库。在轻量级脚本、无编译链的精简容器或对冷启动时间敏感的云函数中,引入 NumPy 会显著增加依赖体积和维护复杂度;如果你的代码仅仅需要“紧凑存储一列数字并存盘”,标准库自带的
六、常见使用注意事项
- 不支持多维数组:
array模块仅支持一维连续结构。如果需要二维或多维矩阵,需要自行计算一维展平索引(如index = row * width + col),或者直接引入 NumPy。 - 内存视图零拷贝:如果需要对
array的子区间进行切片而不发生内存复制,请配合memoryview使用(如mv = memoryview(arr)),这能实现完全零拷贝的底层切片访问与缓冲传递。 - 不能在 Python 级别向量化加速:不要期望写
arr * 2能够像 NumPy 那样直接让所有元素乘以 2;对array执行乘法只会像list一样将数组自身重复拼接成双倍长度。数学运算仍需依赖循环或高阶函数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















