


Node.js怎么调用Python脚本并获取返回值
详细讲解在 Node.js 中通过 child_process 模块(spawn 与 execFile)调用 Python 脚本并可靠获取返回值的完整方法,涵盖数据传递、Buffer 处理、错误捕获与常见避坑指南。
假设你正在使用 Node.js 开发一个 Web 后端服务,当前业务需要调用已有的 Python 数据分析模型或第三方算法库,并等待其处理完毕后将结构化结果返回给前端。这种多语言协同在现代开发中非常普遍。核心解决路径是利用 Node.js 官方内置的 child_process 模块创建子进程,运行 Python 脚本并通过标准流(stdout/stderr)实时捕获输出内容与退出状态。推荐使用 JSON 格式组织传输数据,以确保复杂数据结构的准确还原。
一、核心通信机制与架构理解
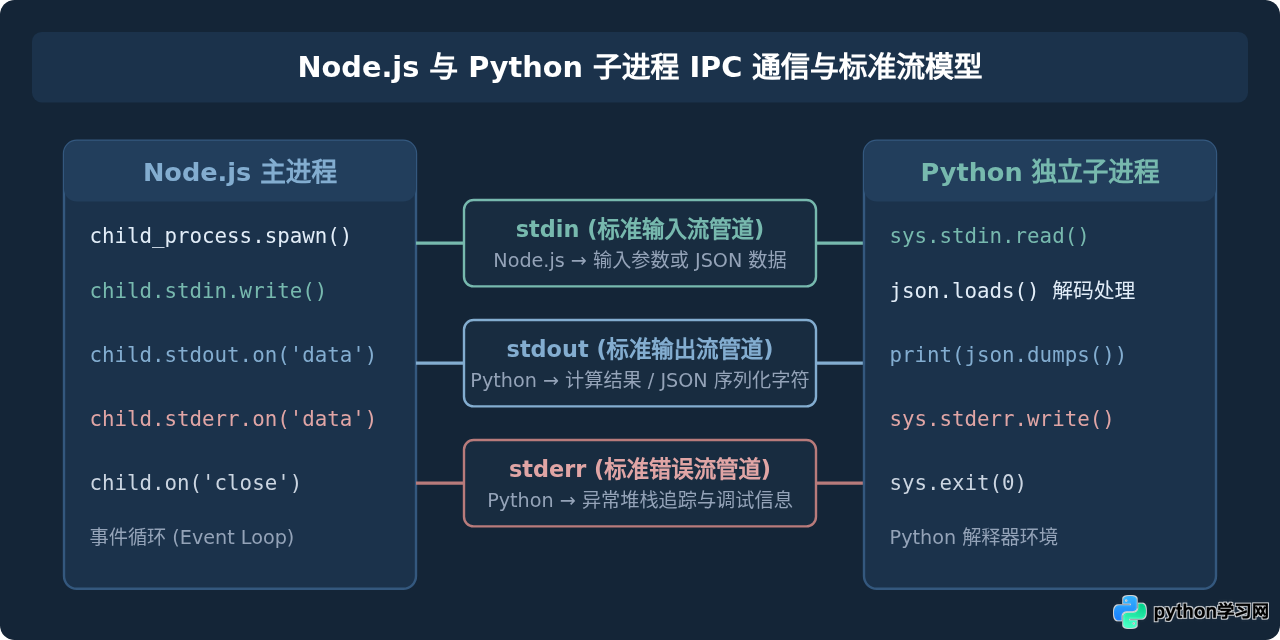
在操作系统层面,Node.js 主进程与 Python 脚本属于两个相互独立的系统进程。Node.js 并不直接“导入”Python 函数,而是通过派生(spawn)子进程,利用操作系统的匿名管道(Pipes)建立数据链路。主要包含三个数据流通道:
- 标准输入(stdin):Node.js 向 Python 进程写入数据的数据流。
- 标准输出(stdout):Python 执行
print()或sys.stdout.write()时,输出结果流向 Node.js 的通道。 - 标准错误(stderr):Python 产生异常追踪栈或日志时输出的通道,用于故障排查。
二、推荐实践:使用 child_process.spawn 流式调用
child_process.spawn 以流(Stream)的形式传输数据,在 Python 执行过程中实时传输输出,没有预设的最大缓冲区限制,是生产环境中处理较大数据量或耗时任务的首选方法。
1. 编写 Python 脚本
创建名为 calculator.py 的文件。在这个示例中,脚本接收来自命令行的参数,计算其总和与均值,并将结构化结果序列化为 JSON 字符串打印到标准输出:
# calculator.py
import sys
import json

def process():
    try:
        # sys.argv[0] 是脚本自身名称,传入参数从索引 1 开始
        raw_inputs = sys.argv[1:]
        if not raw_inputs:
            raise ValueError("未接收到有效数值参数")

        numbers = [float(x) for x in raw_inputs]
        result = {
            "status": "success",
            "count": len(numbers),
            "sum": sum(numbers),
            "average": sum(numbers) / len(numbers)
        }
        # 输出序列化 JSON 字符串到 stdout
        print(json.dumps(result, ensure_ascii=False))
        sys.exit(0)
    except Exception as err:
        # 异常信息输出到 stderr,保持 stdout 纯净
        sys.stderr.write(f"Python Execution Error: {str(err)}\n")
        sys.exit(1)

if __name__ == "__main__":
    process()
2. 编写 Node.js 调用代码
在同级目录下创建 caller_spawn.js。我们需要监听 stdout 的 data 事件累加二进制数据块(Chunks),并在进程退出的 close 事件中将其拼接并解析为 JavaScript 对象:
// caller_spawn.js
const { spawn } = require('child_process');
const path = require('path');

function runPythonScript(scriptPath, args = []) {
  return new Promise((resolve, reject) => {
    // 实例化子进程:建议使用绝对路径指定 Python 解释器与脚本
    const pyProcess = spawn('python3', [scriptPath, ...args]);

    const stdoutChunks = [];
    const stderrChunks = [];

    // 监听标准输出流的分块数据
    pyProcess.stdout.on('data', (chunk) => {
      stdoutChunks.push(chunk);
    });

    // 监听标准错误流的数据
    pyProcess.stderr.on('data', (chunk) => {
      stderrChunks.push(chunk);
    });

    // 监听子进程关闭事件
    pyProcess.on('close', (code) => {
      const stderrOutput = Buffer.concat(stderrChunks).toString('utf-8').trim();

      if (code !== 0) {
        return reject(new Error(`Python 进程退出,错误码 ${code}:${stderrOutput}`));
      }

      const rawResult = Buffer.concat(stdoutChunks).toString('utf-8').trim();
      try {
        const parsedData = JSON.parse(rawResult);
        resolve(parsedData);
      } catch (parseError) {
        reject(new Error(`解析 Python 返回结果失败: ${parseError.message},原始内容: "${rawResult}"`));
      }
    });

    // 监听进程创建失败等底层错误(例如命令不存在)
    pyProcess.on('error', (err) => {
      reject(new Error(`无法启动 Python 进程: ${err.message}`));
    });
  });
}

// 执行测试
async function main() {
  const targetScript = path.resolve(__dirname, 'calculator.py');
  try {
    const data = await runPythonScript(targetScript, ['10', '25.5', '64.5']);
    console.log('成功获取 Python 返回值:');
    console.log(data);
  } catch (error) {
    console.error('调用失败:', error.message);
  }
}

main();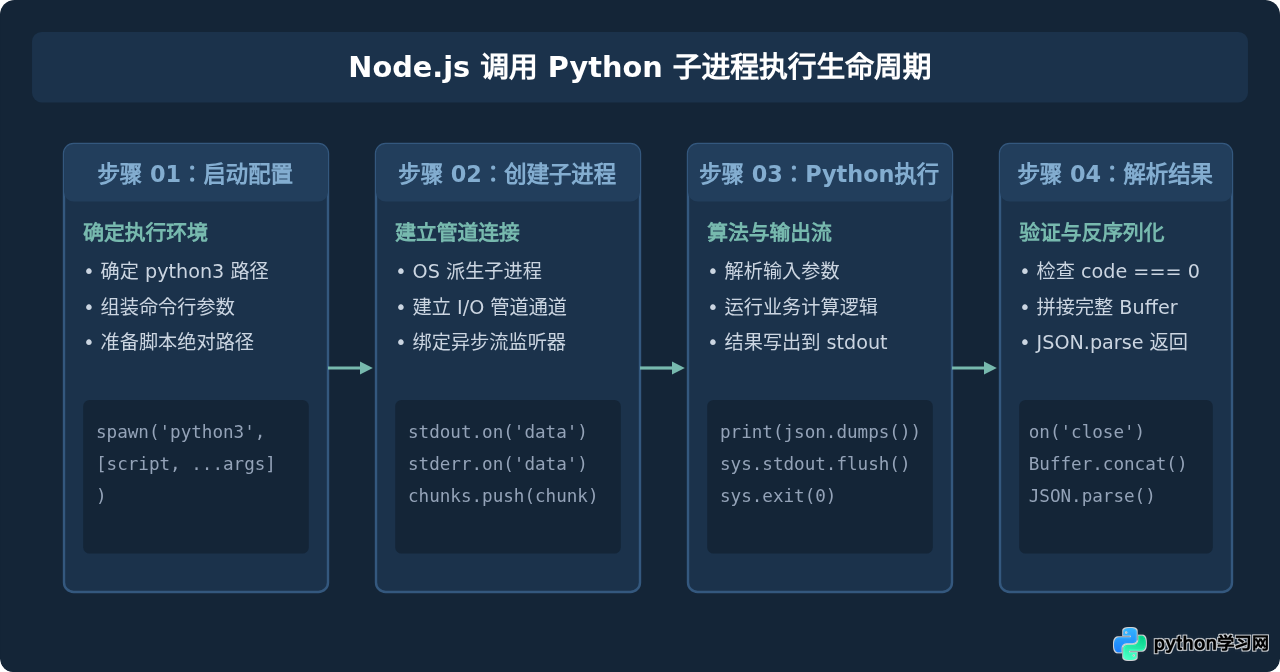
三、轻量选择:使用 child_process.execFile
对于执行时间较短、返回结果体积可控(默认小于 1MB)的脚本,使用 execFile 可以简化代码结构。它会自动缓冲全部输出,并在执行结束后通过回调函数提供完整的 stdout 和 stderr。
// caller_execfile.js
const { execFile } = require('child_process');
const path = require('path');

const scriptPath = path.resolve(__dirname, 'calculator.py');
const args = ['12', '48', '36'];

// 注意:execFile 直接执行可执行文件,不衍生 shell,比 exec 更安全
execFile('python3', [scriptPath, ...args], { maxBuffer: 1024 * 1024 * 5 }, (error, stdout, stderr) => {
  if (error) {
    console.error('执行出错,退出码:', error.code);
    console.error('stderr 详情:', stderr);
    return;
  }

  try {
    const result = JSON.parse(stdout.trim());
    console.log('通过 execFile 获取结果成功:', result);
  } catch (parseErr) {
    console.error('JSON 反序列化失败:', parseErr.message);
  }
});child_process.exec,因为 exec 会派生一个完整的系统 Shell(如 /bin/sh 或 cmd.exe)来执行命令,不仅存在命令注入漏洞风险,还会增加不必要的系统开销。execFile 与 spawn 均直接调用二进制程序,更加安全高效。
四、双向传输:通过 stdin 传递复杂或超长数据
如果 Node.js 需要向 Python 传递体积较大(例如上兆字节的文本、多维矩阵或多层嵌套配置),命令行参数(sys.argv)会受到操作系统 ARG_MAX 长度限制,并且特殊字符(空格、引号、换行)容易在传递中出现转义丢失。此时最佳做法是通过 stdin 管道流式写入数据。
1. Python 脚本读取 stdin
# process_large_data.py
import sys
import json

def main():
    try:
        # 一次性读取标准输入中的所有内容
        input_raw = sys.stdin.read()
        if not input_raw.strip():
            raise ValueError("stdin 未接收到有效输入")

        payload = json.loads(input_raw)
        items = payload.get("items", [])

        # 模拟业务处理:统计字数与排序
        processed_items = [
            {"id": item["id"], "length": len(item.get("content", ""))}
            for item in items
        ]

        response = {
            "status": "success",
            "total_items": len(items),
            "data": processed_items
        }
        print(json.dumps(response, ensure_ascii=False))
        sys.exit(0)
    except Exception as e:
        sys.stderr.write(f"处理失败: {str(e)}\n")
        sys.exit(1)

if __name__ == "__main__":
    main()
2. Node.js 写入 stdin 并读取结果
// caller_pipe.js
const { spawn } = require('child_process');
const path = require('path');

function sendDataToPython(scriptPath, complexPayload) {
  return new Promise((resolve, reject) => {
    const pyProcess = spawn('python3', [scriptPath]);
    const stdoutChunks = [];
    const stderrChunks = [];

    pyProcess.stdout.on('data', chunk => stdoutChunks.push(chunk));
    pyProcess.stderr.on('data', chunk => stderrChunks.push(chunk));

    pyProcess.on('close', (code) => {
      if (code !== 0) {
        const err = Buffer.concat(stderrChunks).toString('utf-8');
        return reject(new Error(`Python 脚本执行异常(code ${code}): ${err}`));
      }
      try {
        const output = JSON.parse(Buffer.concat(stdoutChunks).toString('utf-8'));
        resolve(output);
      } catch (e) {
        reject(new Error(`解析返回值失败: ${e.message}`));
      }
    });

    // 将结构化对象序列化并通过 stdin 写入 Python 进程
    const jsonString = JSON.stringify(complexPayload);
    pyProcess.stdin.write(jsonString, 'utf-8');
    // 写入结束必须调用 end() 发送 EOF,否则 Python 的 sys.stdin.read() 会无限等待阻塞
    pyProcess.stdin.end();
  });
}

// 模拟发送数据
const testPayload = {
  task: "batch_analyze",
  items: [
    { id: 101, content: "你好,Node.js与Python协同工作" },
    { id: 102, content: "通过管道双向传输结构化数据" }
  ]
};

sendDataToPython(path.resolve(__dirname, 'process_large_data.py'), testPayload)
  .then(res => console.log('处理成功:', res))
  .catch(err => console.error('处理失败:', err));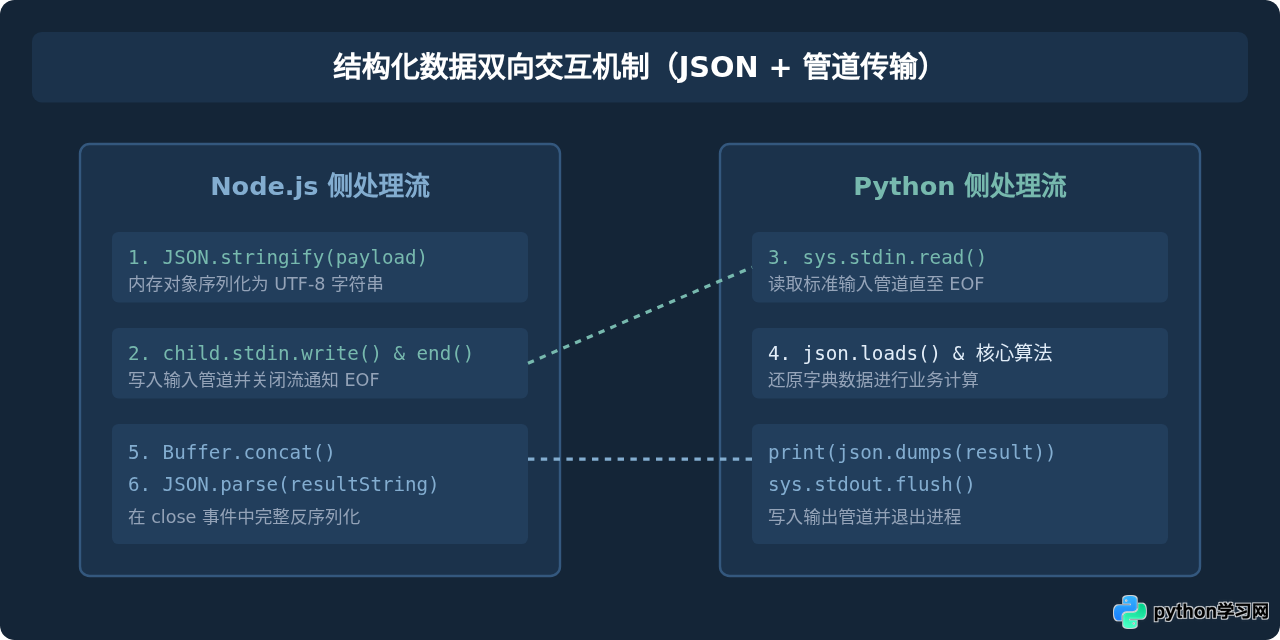
五、常见避坑指南与排查要点
1. 为什么不能在 data 事件里直接 JSON.parse?
当 Python 输出的数据量超过操作系统的单个管道缓冲区(通常为 64KB)时,Node.js 的 pyProcess.stdout.on('data') 会分多次触发。如果在单次 data 事件中直接调用 JSON.parse(chunk),收到的只是半截未闭合的 JSON 字符串,必然抛出 SyntaxError: Unexpected end of JSON input。必须将全部分块暂存到数组中,待 close 事件触发时统一用 Buffer.concat() 拼接。
2. 解释器路径与跨平台差异
在不同操作系统或容器镜像中,Python 命令可能是 python 或 python3。更为常见的是项目依赖特定虚拟环境(venv / conda)。如果直接使用相对路径或系统默认命令,经常因找不到第三方模块而报 ModuleNotFoundError。最佳方案是使用绝对路径指定虚拟环境内的 Python 解释器:
// 明确指定虚拟环境中的解释器路径
const isWin = process.platform === 'win32';
const pyExecutable = isWin
  ? path.resolve(__dirname, 'venv/Scripts/python.exe')
  : path.resolve(__dirname, 'venv/bin/python3');
3. 中文编码与换行符问题
在 Windows 平台上,Python 默认的标准流编码可能跟随本地代码页(如 GBK),导致 Node.js 接收中文字符串出现乱码。建议在 Python 脚本开头明确重置标准输出编码:
import sys
if sys.platform.startswith('win'):
    sys.stdout.reconfigure(encoding='utf-8')
    sys.stderr.reconfigure(encoding='utf-8')
4. 杂质输出污染 stdout
很多开发者习惯在 Python 业务代码中使用 print("正在加载模型...") 进行调试。这个行为会导致调试文字直接混入 stdout,使得原本合法的 JSON 字符串前缀被破坏。原则:所有调试或状态日志必须写入 sys.stderr 或专用日志文件,stdout 只输出最终的机器可读结果。
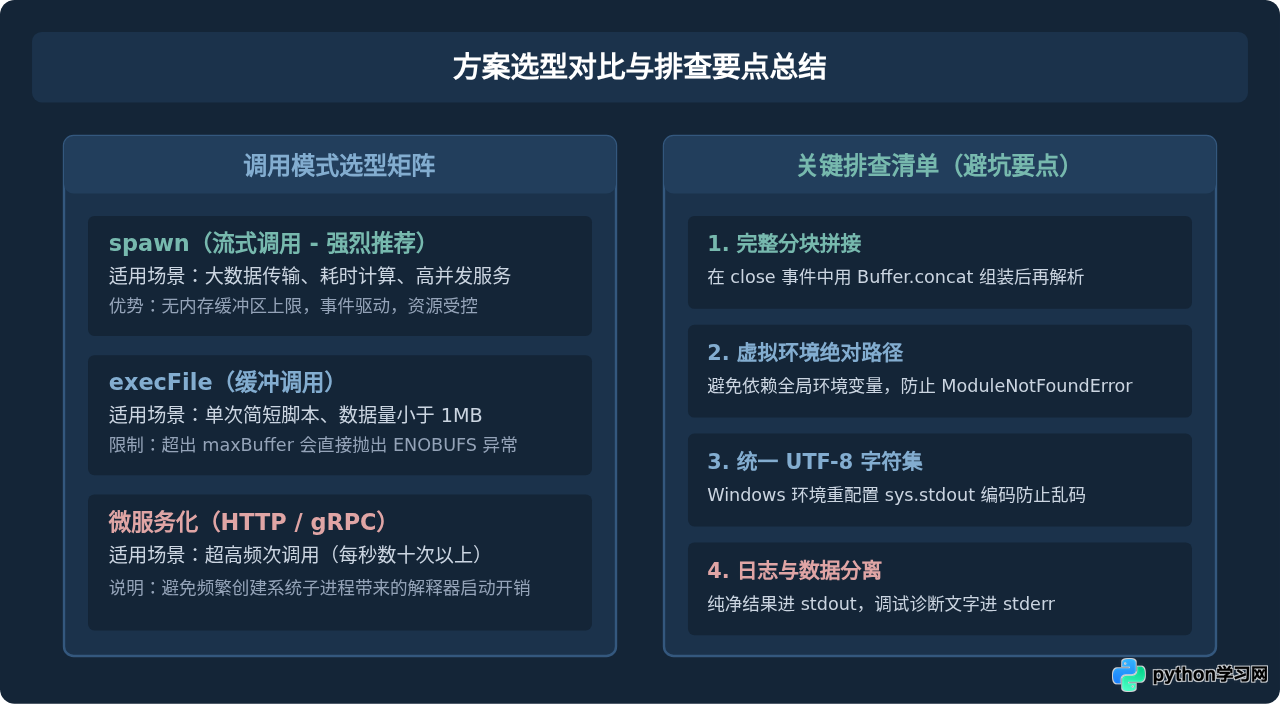
六、总结与决策建议
实现 Node.js 调用 Python 脚本并获取返回值的核心步骤如下:
- 通道选择:推荐优先使用
child_process.spawn,通过事件驱动方式分别监听stdout、stderr和close事件。 - 数据格式:统一采用 JSON 字符串进行序列化与反序列化,避免自定义文本解析带来的边界错误。
- 复杂输入:数据量大或结构复杂时,使用
stdin.write()写入输入流,并在写入完成后调用stdin.end()。 - 性能边界:每次执行 Python 脚本都会启动一个全新的操作系统进程和 Python 解释器。若场景属于毫秒级高并发接口调用,应考虑将 Python 端封装为常驻的 HTTP 服务(如 FastAPI)或 RPC 服务,以消除进程反复创建的冷启动耗时。对于定时任务、批量计算或异步后台队列,
spawn方式轻便且足够可靠。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















