


Python csv模块与Pandas读取CSV的区别与选择
深入对比Python内置csv模块与第三方库Pandas在读取CSV文件时的底层机制、内存占用、数据结构与性能差异,并提供详细代码示例与选型决策指南。
在Python开发与数据处理任务中,读取CSV格式文件是最基础的操作之一。针对这项任务,开发者通常有两种主流途径:使用Python标准库内置的csv模块,或者使用第三方数据分析库pandas提供的read_csv()函数。两者的核心区别在于设计定位与资源开销:csv模块是一个轻量级的流式纯文本解析工具,逐行读取且无第三方依赖,内存消耗极低;而Pandas是一个功能完备的重型数据科学框架,通过一次性载入整表并自动完成类型推断与二维矩阵构建,提供了强大的向量化分析与计算能力,但伴随着较高的内存占用和外部依赖。理解这两者的技术分水岭,是写出高效、稳定Python程序的关键基础。
一、核心机制与底层数据结构的区别
要做出合理的技术选型,首先需要理解两者在底层解析机制、数据模型以及内存管理方式上的根本差异。
1. 数据模型与类型推断
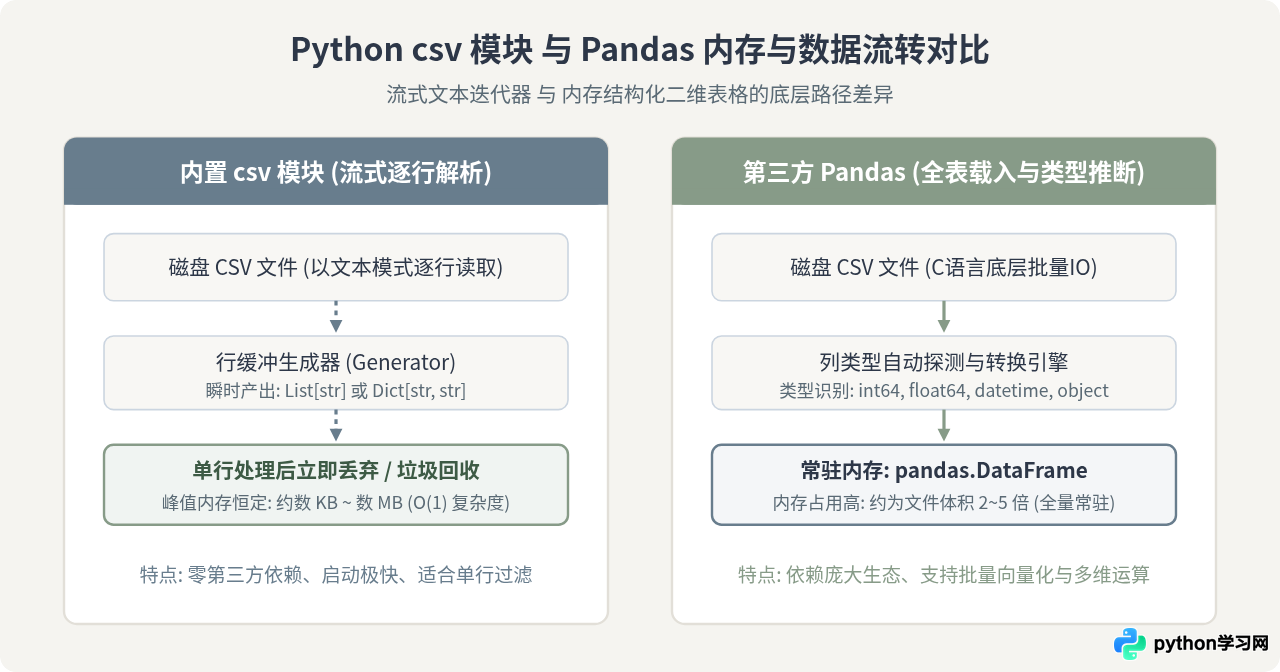
内置的csv模块将CSV文件视为纯文本数据流。无论字段内容在字面上是数字、布尔值还是日期,csv.reader或csv.DictReader都会统一将其作为原生Python字符串(str)返回。它不进行任何隐式类型转换,类型转换完全由开发者根据业务规则在循环中显式完成。
相比之下,pandas.read_csv()内部封装了高度优化的C/Cython语言解析引擎。在读取文件时,Pandas会自动扫描前部数据并对每一列执行自动类型探测,将整数字符串转换为int64、浮点数转换为float64,并将符合日期格式的文本转换为时间戳序列。读取后生成的产物不是简单的列表或字典,而是具有多维索引(Index)、支持列式连续内存存储的DataFrame对象。
2. 内存生命周期与加载方式
csv模块天然支持流式迭代(Streaming)。通过迭代器机制,它在任意时刻都仅将当前行的数据缓存在内存中。即使处理大小达100GB的巨型CSV文件,只要在循环处理单行后不保留全局引用,内存峰值常数级可控(通常仅数兆字节)。
pandas.read_csv()在默认情况下会将整个CSV文件一次性解析并全部装载进内存。由于DataFrame需要维护列对象元数据、多维索引以及结构对齐缓冲,实际常驻内存通常为原始磁盘文件大小的2至5倍。如果文件大小超过物理内存上限,程序将直接触发系统级OOM(Out of Memory)崩溃。
二、实际读取操作与代码示例
为了直观展现两者的操作差异,我们以一个包含用户行为的 orders.csv 示例文件为例:包含 order_id(订单编号)、user_id(用户ID)、amount(订单金额)与 status(状态)四个字段。演示如何完成文件读取并统计总交易金额。
1. 使用内置 csv 模块的标准步骤
使用 csv 模块时,通常搭配内置的 open() 上下文管理器使用。为避免因平台差异出现多余空行,官方文档明确要求在打开文件时指定 newline='' 参数。
import csv

# 示例 1: 使用 csv.reader (基于行索引)
total_amount = 0.0
with open('orders.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    header = next(reader)  # 跳过表头: ['order_id', 'user_id', 'amount', 'status']
    for row in reader:
        # row 是字符串列表,需手动将索引为 2 的金额转换为浮点数
        if row[3] == 'completed':
            total_amount += float(row[2])

print(f"有效订单总额 (reader): {total_amount:.2f}")

# 示例 2: 使用 csv.DictReader (基于表头字典)
total_amount_dict = 0.0
with open('orders.csv', mode='r', encoding='utf-8', newline='') as f:
    dict_reader = csv.DictReader(f)
    for row in dict_reader:
        # row 是 OrderedDict 或 dict,字段以表头名为键
        if row['status'] == 'completed':
            total_amount_dict += float(row['amount'])

print(f"有效订单总额 (DictReader): {total_amount_dict:.2f}")避坑要点:csv.reader依赖硬编码的列索引(如row[2]),如果上游CSV新增或调换了列顺序,代码容易产生不可预期的逻辑错误;而csv.DictReader通过字段名读取,健壮性明显更好,代价是每次迭代都要额外构造字典对象,执行速度略微逊色于csv.reader。
2. 使用 Pandas 读取的标准步骤
使用 Pandas 时,不需要手动调用 open()。调用 pd.read_csv() 直接一步完成加载并生成 DataFrame。
import pandas as pd

# 读取 CSV 文件并自动推断类型
df = pd.read_csv('orders.csv', encoding='utf-8')

# 过滤已完成的订单,并通过底层向量化累加
completed_orders = df[df['status'] == 'completed']
total_amount = completed_orders['amount'].sum()

print(f"有效订单总额 (Pandas): {total_amount:.2f}")
print("列类型信息:")
print(df.dtypes)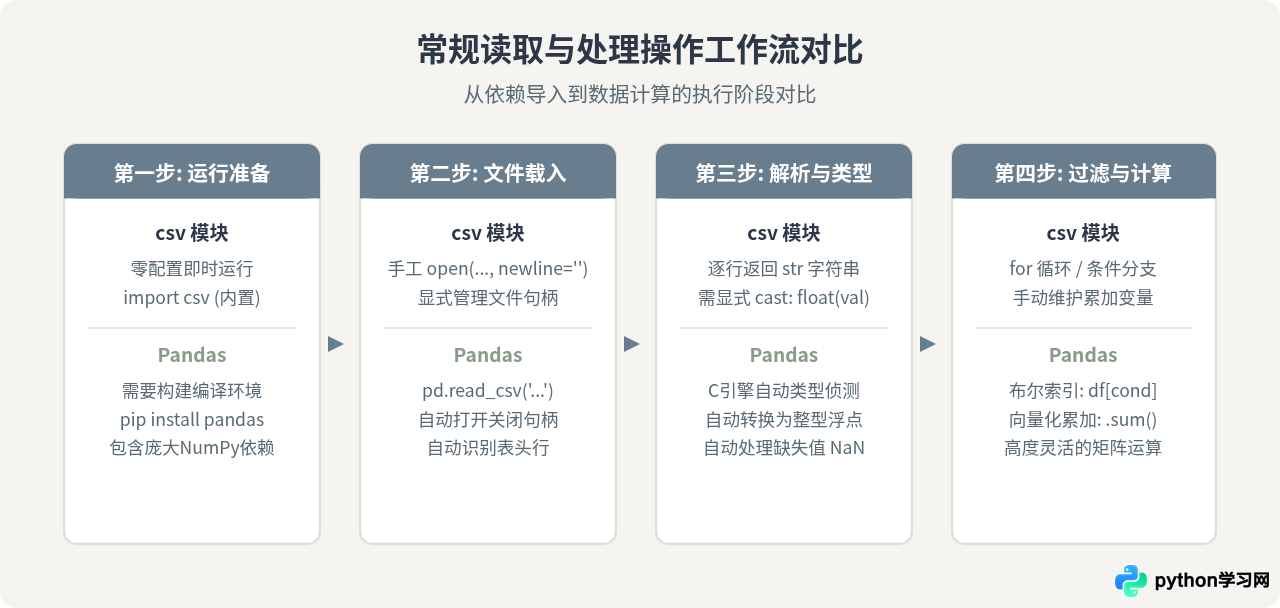
三、全方位特性对比与性能权衡
为了在实际项目中做出恰当的选择,我们需要从依赖性、解析速度、内存占用、数据分析能力等关键指标进行客观对比:
| 对比维度 | Python 内置 csv 模块 | Pandas (read_csv) |
|---|---|---|
| 环境依赖 | 无任何外部依赖,Python环境自带 | 依赖庞大(需安装 pandas、numpy 等 C 依赖) |
| 启动与冷启动开销 | 近乎零耗时(毫秒级启动) | import 耗时较长(冷启动约 0.2~0.5 秒) |
| 内存占用机制 | 流式逐行解析,瞬时内存极低(O(1)) | 全表入内存,占用原文件的 2~5 倍内存(O(N)) |
| 类型支持与处理 | 纯文本(全为 str),需手工类型转换 | 底层自动推断(int, float, datetime, bool等) |
| 复杂分析与运算 | 较弱,需编写原生循环或结合列表推导式 | 极强,支持切片、聚合、分组、关联、透视表 |
| 文件异常容错性 | 针对字段数不一致时报错或原样输出 | 自动填充 NaN,支持灵活的 on_bad_lines 控制 |
| 多核心与底层加速 | 纯 Python 解释器单线程执行 | C 引擎优化,支持通过 PyArrow 引擎多核加速 |
四、选型依据与场景决策指南
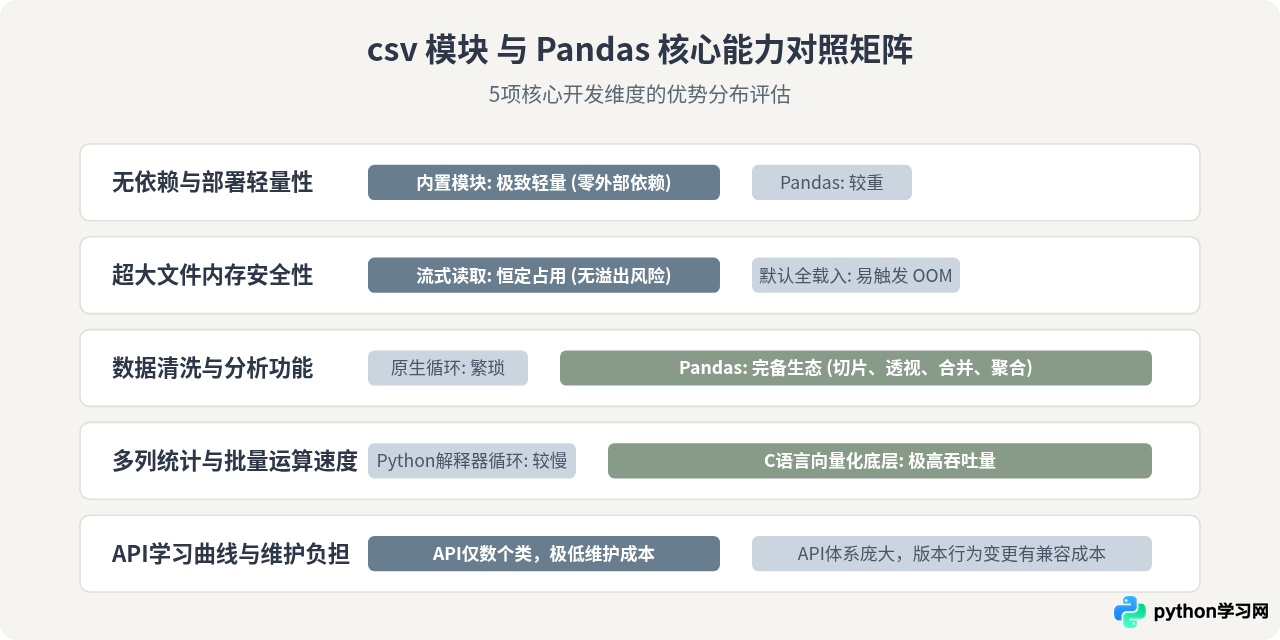
没有绝对优胜的工具,只有最契合工程约束与处理目标的选型。根据工程实践经验,可以按照以下决策路径进行选择:
1. 坚决选择内置 csv 模块的场景
- 轻量级运维或CLI命令行工具:代码需要分发给没有安装复杂科学计算包环境的用户,或者运行在精简的 Docker 容器、Serverless(云函数)中。引入几百兆的 Pandas 和 NumPy 会极大增加镜像体积和冷启动时延。
- 超大文件的简单行过滤与格式转换:例如读取几十GB的Web服务访问日志或流水CSV文件,只需提取其中包含特定状态码的行写入新文件。使用
csv.reader进行流式扫描,内存常驻只需几兆,性能高且绝不爆内存。 - 仅做简单的数据导出或逐行管道:作为 ETL 流程中的单个文本输入节点,仅读取少量字段后直接写入消息队列或数据库。
2. 毫不犹豫选择 Pandas 的场景
- 探索性数据分析(EDA)与统计建模:需要快速查看均值、中位数、分位数、标准差,调用
df.describe()一键概览。 - 复杂数据清洗与格式规整:需要处理各种缺失值填充(
fillna)、空值剔除(dropna)、字符串正则拆分以及跨列类型转换。 - 多表关联与分组聚合(GroupBy):需要执行类似 SQL 的
JOIN、GROUP BY、PIVOT运算,使用原生 Python 编写这些逻辑需要数百行且容易出错,Pandas 仅需一两行高度优化的链式调用。
3. 特殊折中方案:Pandas 的分块读取(chunksize)
如果既需要 Pandas 强大的清洗转换功能,又面临几GB文件超出内存的困境,可以使用 read_csv 的 chunksize 参数,实现兼顾功能与内存的分块迭代处理:
import pandas as pd

# 每次仅载入 50,000 行作为一个 DataFrame 数据块
chunk_size = 50000
total_revenue = 0.0

for chunk in pd.read_csv('massive_data.csv', chunksize=chunk_size):
    # 对当前块执行向量化清洗与聚合
    valid_chunk = chunk[chunk['is_valid'] == True]
    total_revenue += valid_chunk['revenue'].sum()

print(f"累计收益: {total_revenue:.2f}")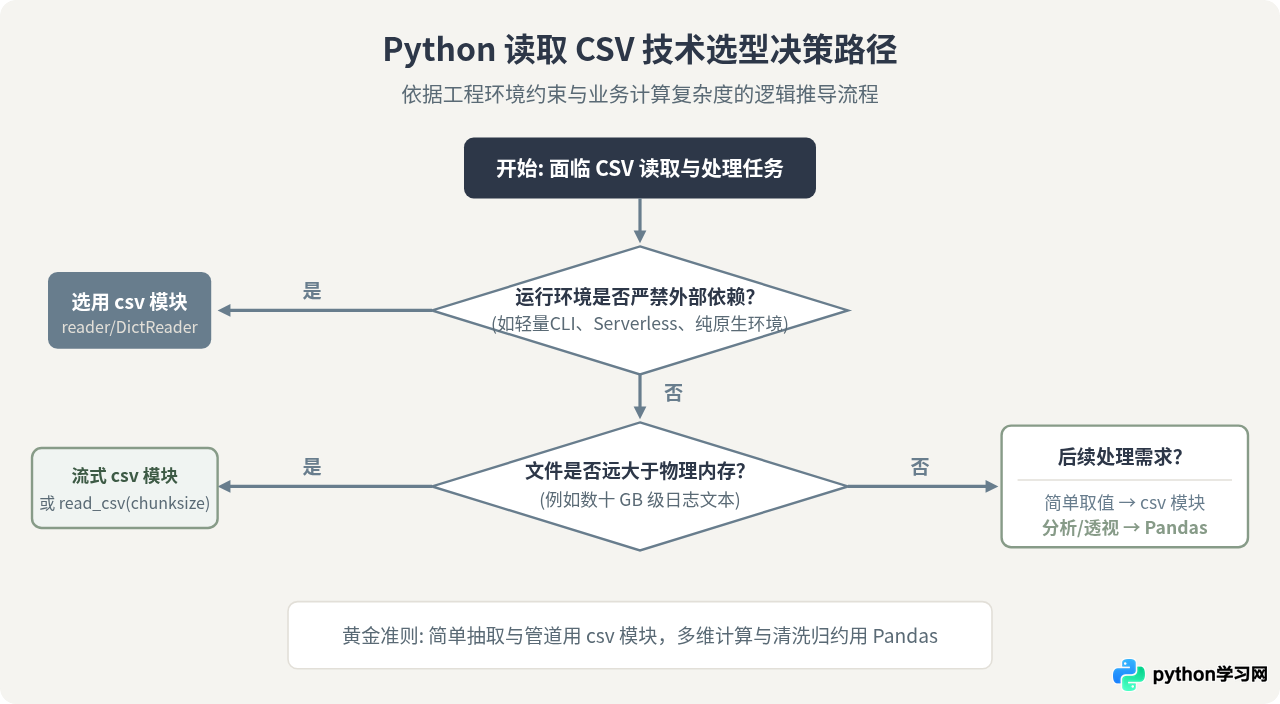
五、工程落地的核心注意事项
无论最终决定采用哪个库,在处理真实生产环境中的CSV时,都需特别注意以下常见陷阱:
1. 字符编码与 BOM 头
Windows系统(特别是Excel导出的CSV)经常采用 GBK 或带有 UTF-8-SIG(带有不可见BOM标记)编码。如果直接使用默认的 utf-8 读取,第一个字段名前可能会出现乱码字符 \ufeff,导致 row['order_id'] 产生 KeyError。在打开文件或调用 read_csv 时显式传入 encoding='utf-8-sig' 可彻底规避此问题。
2. 缺失值推断与数据类型污染
在 Pandas 中,如果一个原本是整数的列中夹杂了缺失值(空字符串),Pandas 默认会为了容纳 NaN(浮点数)而强制将整列降级为 float64,使得 1001 变成 1001.0。若需要保持整数语义,应在 Pandas 1.0+ 中显式指定可为空整数类型 dtype={'user_id': 'Int64'}(注意大写 I)。而在内置 csv 模块中,空值始终保持为空字符串 '',需在类型转换逻辑中自行防御:int(val) if val else None。
3. 引号转义与分隔符不标准
并非所有 CSV 都是严格以英文半角逗号分隔的。海外部分系统可能采用制表符 \t(TSV)或分号 ; 分隔。csv.reader(f, delimiter=';') 和 pd.read_csv('...', sep=';') 都支持灵活配置分隔符。对于字段内包含换行或双引号的情况,两者均遵循 RFC 4180 标准,但需确保生成方使用了标准成对转义引号。
总结
Python内置的 csv 模块与第三方 Pandas 并非替代关系,而是分工鲜明的两类工具。在追求极高部署便捷性、单行管道流式过滤或对运行环境资源极度敏感的场景下,csv 模块凭借轻巧与零内存压力成为首选;而在面对数据清洗、特征提取、多表关联和复杂矩阵运算时,Pandas 丰富的生态功能与底层的 C 加速能力能够成倍提升开发效率。在架构设计时结合数据量级与计算深度进行合理选型,是保障系统稳健运行的关键。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















