


做数据分析和机器学习需要什么样的电脑配置?Python硬件选购参考
做Python数据分析和机器学习需要什么样的电脑配置?本文系统解析内存(RAM)、处理器(CPU)、显卡(GPU)和固态硬盘(SSD)的核心选购逻辑,按轻度分析、传统机器学习与深度学习场景提供清晰的配置参考。
选购用于数据分析与机器学习的电脑,核心取决于你实际执行的计算任务,而不是盲目追求昂贵显卡或被营销参数误导。如果是处理几十万行表格、运行 SQL 查询或编写常规自动化脚本,一台配备高主频处理器与 16GB 以上内存的主流轻薄本就能流畅应对;如果是训练结构化树模型(如 XGBoost、LightGBM)或清洗数千兆字节的数据集,大容量内存(32GB 起步)和多核 CPU 才是关键瓶颈;而只有在深入图像、自然语言处理和本地大语言模型等深度学习训练时,带有充足显存的 NVIDIA 独立显卡才具备不可替代的必要性。厘清各项硬件在 Python 工作流中的具体分工,才能用最合理的预算搭建高效顺畅的工作平台。
一、核心硬件在Python工作流中的角色与瓶颈分析
许多初学者容易产生一个认知误区:只要听到“人工智能”或“机器学习”,就认为必须先配一张万元级游戏显卡。实际上,在典型的数据科学流程中,各硬件组件承担的职责截然不同,任何一个环节的短板都会直接导致卡顿甚至程序崩溃。
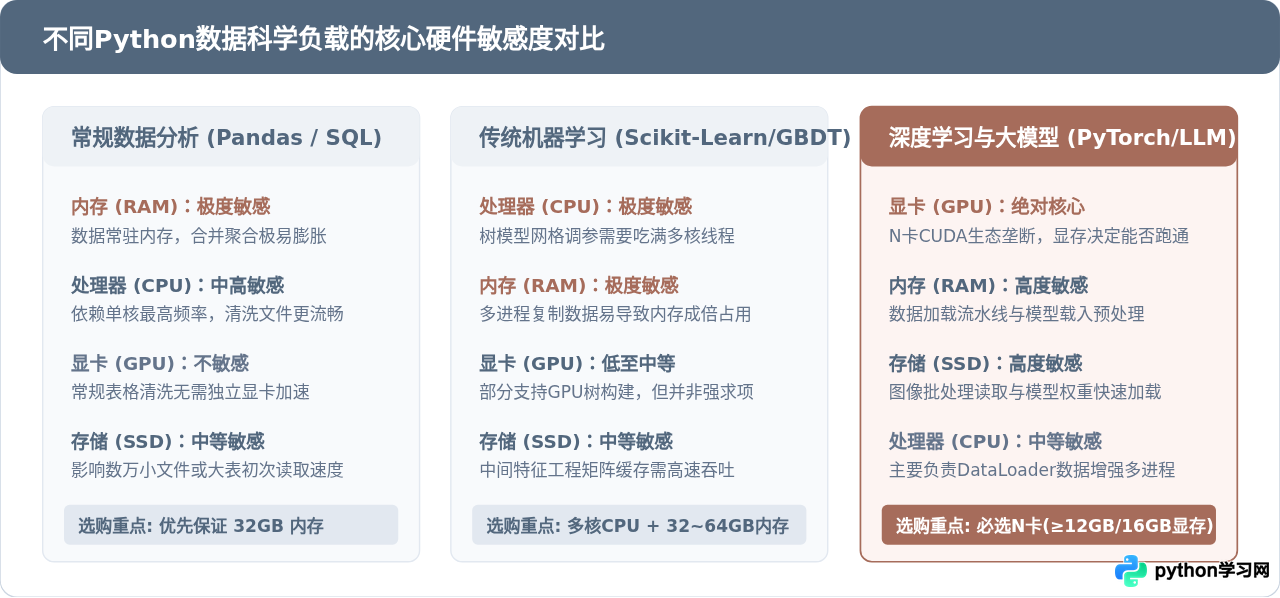
1. 内存(RAM):数据分析中最容易踩坑的刚性瓶颈
在 Python 数据分析中,最常见的工具库是 Pandas。Pandas 采用纯内存计算模式,所有数据结构(DataFrame)都需要完整加载到物理内存中才能展开操作。这里存在一个显著的“内存膨胀效应”:一个在磁盘上仅占用 1GB 大小的 CSV 纯文本文件,被 Pandas 加载后,由于 64 位整型/浮点型对齐、Python 对象封装以及字符串索引指针开销,常驻内存往往会膨胀到 3 至 5 倍(即 3GB~5GB)。
更为关键的是,当你执行诸如 merge()、groupby()、pivot_table() 或特征工程扩展时,Python 会生成大量的临时计算副本,瞬时内存占用甚至可能达到原始数据的 8 到 10 倍。一旦物理内存耗尽,操作系统将被迫启动虚拟内存分页(Swap / Page File),将内存数据不断倒换到硬盘中,导致运行速度瞬间下降数百倍,程序处于极度卡死状态,甚至直接抛出 MemoryError 闪退。
2. 处理器(CPU):单核清洗与多核并行训练
Python 语言本身受制于全局解释器锁(GIL),常规的数据预处理脚本、单行循环和标准 Pandas 操作大多只运行在单个 CPU 核心上。这意味着处理器的单核最高主频与单核 IPC 性能直接决定了日常数据清洗、文本匹配和加载文件的响应流畅度。
而在模型训练阶段,主流机器学习库(如 Scikit-Learn、XGBoost、LightGBM)底层使用高度优化的 C/C++ 与 OpenMP 实现,在设置 n_jobs=-1 时能够充分调动 CPU 的每一个物理核心进行多线程并行计算与交叉验证网格搜索。因此,一颗具备 8 核心以上、高单核主频的现代处理器是保证机器学习训练效率的核心基石。
3. 显卡(GPU):CUDA生态垄断与显存绝对优先级
在涉及深度学习(PyTorch、TensorFlow)时,显卡的选型几乎没有自由发挥的空间:必须优先选择 NVIDIA 独立显卡。这并不是商业偏好,而是因为整个深度学习开源生态(算子库、加速包、开源模型脚本)绝大多数基于 NVIDIA CUDA 与 cuDNN 开发并做长期优化。AMD 显卡(ROCm)与苹果 Apple Silicon(Metal / MPS)虽然持续跟进,但在遇到特定第三方库、量化工具或特殊算子时,调试排错成本极大。
而在挑选 NVIDIA 显卡时,第一核心指标是显存容量(VRAM),其次才是核心算力。深度学习模型在前向传播和反向传播中,模型参数、梯度、优化器状态和批量数据(Batch Data)必须整体放入显存。如果显存不足,程序将直接弹出不可挽回的 CUDA out of memory 报错并中断。哪怕算力再高,只要显存放不下模型,一切都是空谈。
4. 固态硬盘(SSD):数据加载与缓存读写
现代数据工程往往需要解压数万个小图片、分块处理上百吉字节的日志文本或反复保存训练检查点(Checkpoint)。采用 PCIe 4.0 NVMe 协议的高速固态硬盘能够成倍缩短冷启动时的数据加载时间。建议至少配置 1TB 到 2TB 固态,并尽量避免将密集计算的缓存目录放在机械硬盘上。
二、选购决策逻辑:按业务场景明确硬件取舍
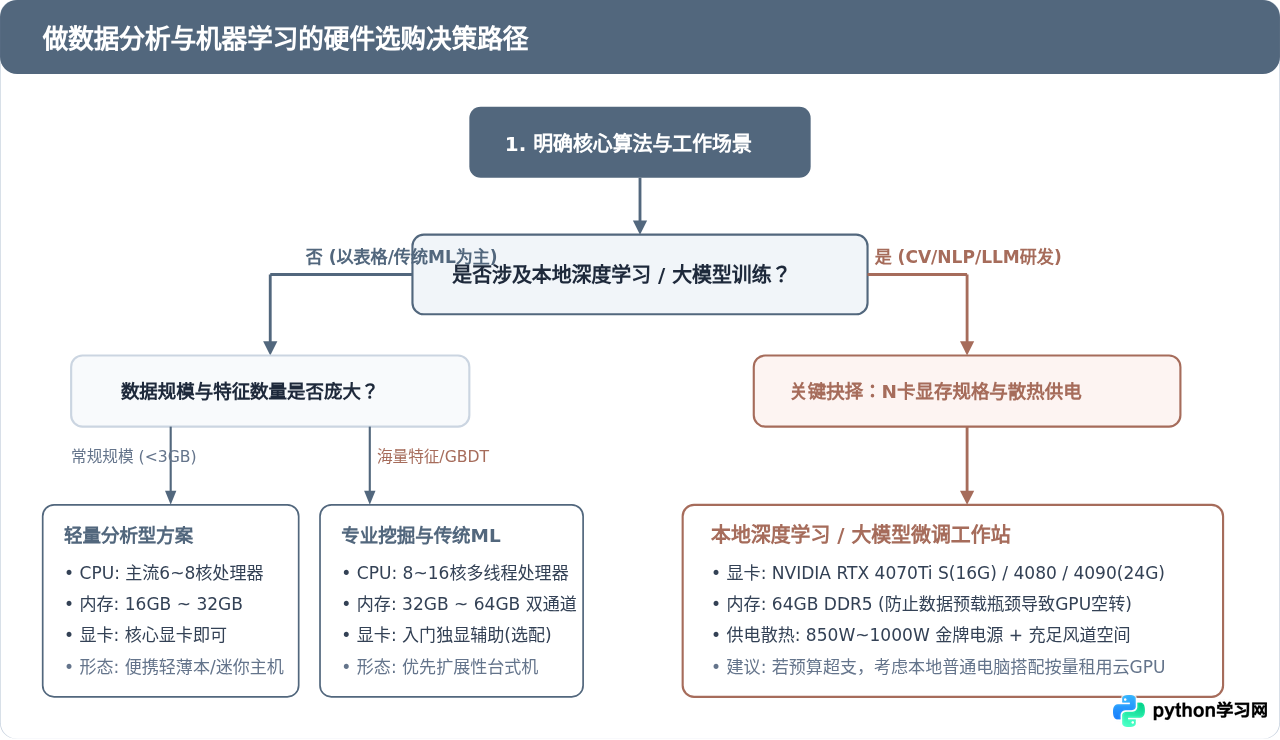
在面对纷繁复杂的硬件规格时,最清晰的做法是按照你未来半年至一年的核心学习或工作目标展开排查:
- 第一步:是否需要本地训练深度学习或微调大语言模型?
如果答案是“否”,完全可以将昂贵显卡的预算全部省下,优先投入到 32GB 甚至 64GB 内存和更高规格的显示器上;如果答案是“是”,则必须从预算中单列出 NVIDIA 独显的费用,并以“显存 ≥ 12GB(如 RTX 3060 12G、RTX 4070Ti Super 16G、RTX 4080 16G、RTX 4090 24G)”为硬性筛选门槛。 - 第二步:日常处理的数据集有多大?
若单表 CSV 或 Parquet 文件常年小于 1GB,16GB 内存即可应对日常学习;若频繁需要对 3GB~10GB 以上的数据集进行合并关联,32GB 是最起码的起步配置,64GB 能够带来极高的操作容错率。 - 第三步:选择笔记本电脑还是台式机?
笔记本电脑提供出色的移动便携性,适合高校自习、通勤会议使用;但笔记本受限于狭窄的机身空间,散热上限低,在长时间跑满 CPU 或显卡时容易过热降频,且绝大多数笔记本的显卡和内存(部分板载)无法升级。台式机在相同预算下能获得高出 30%~50% 的持续计算性能,拥有充裕的散热风道,且未来加装内存条或更换更强显卡极为方便。
三、深入核心瓶颈:数据规模与内存膨胀机制
为了让读者直观理解为什么内存是很多数据分析新手的“第一道硬墙”,我们可以看一个日常非常普遍的真实处理场景:
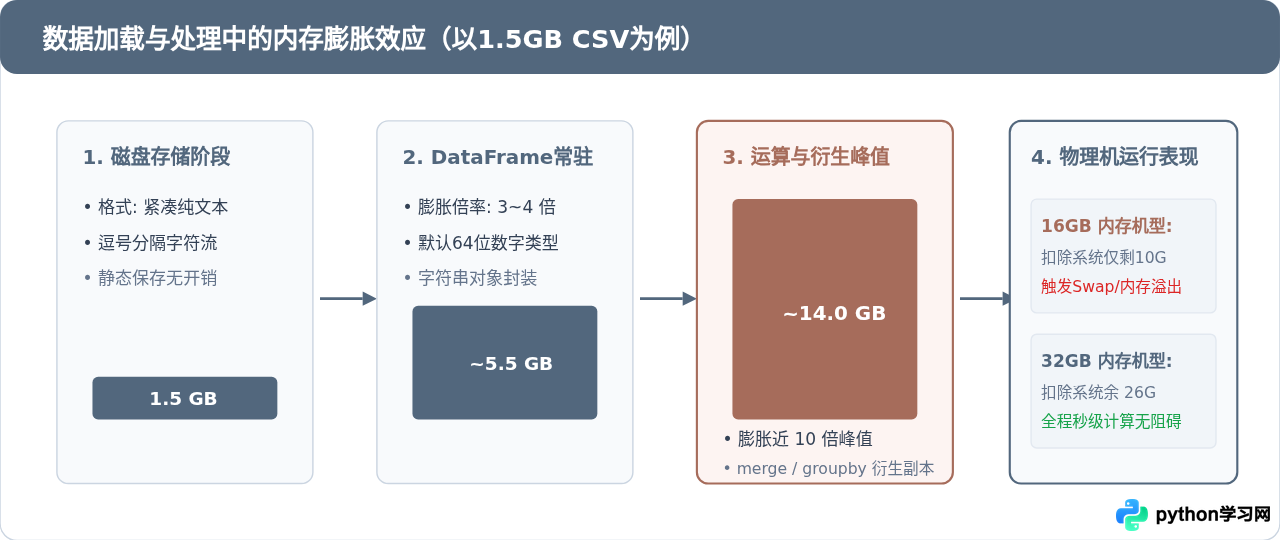
假设你从业务系统导出了一份约 1.5GB 的用户交易明细 CSV 文件。当你在 Python 中使用 df = pd.read_csv('orders.csv') 进行读取时:
- 磁盘存储形态:数据在磁盘中以逗号分隔的纯文本格式压缩存放,不包含额外对象头信息,体积仅 1.5GB。
- 内存加载形态:读取为 Pandas DataFrame 后,字符串列会被解析为庞大的 Python 字符串对象集合,整型列常默认分配 64 位宽空间(
int64),此时常驻内存迅速飙升至 5.5GB 左右。 - 特征工程衍生阶段:为了计算特征,你执行了
df.merge()关联商品表,并做了groupby().agg()统计运算。在这些链式操作完成垃圾回收之前,底层必须临时开辟新的连续内存块存放计算中间体,此时瞬时内存开销轻松突破 14GB。
在仅有 16GB 物理内存的电脑上,操作系统自身和后台浏览器、代码编辑器往往已经占去 4GB~6GB 空间,剩余可用内存只有 10GB~12GB。一旦计算峰值达到 14GB,系统便会强制触发虚拟内存交换(Swap),磁盘读写灯狂闪,鼠标操作迟缓,最终极易以 MemoryError 宣告失败。而如果拥有 32GB 内存,整个过程甚至不会出现任何感知上的迟滞。
四、三档具体配置方案与选型参考
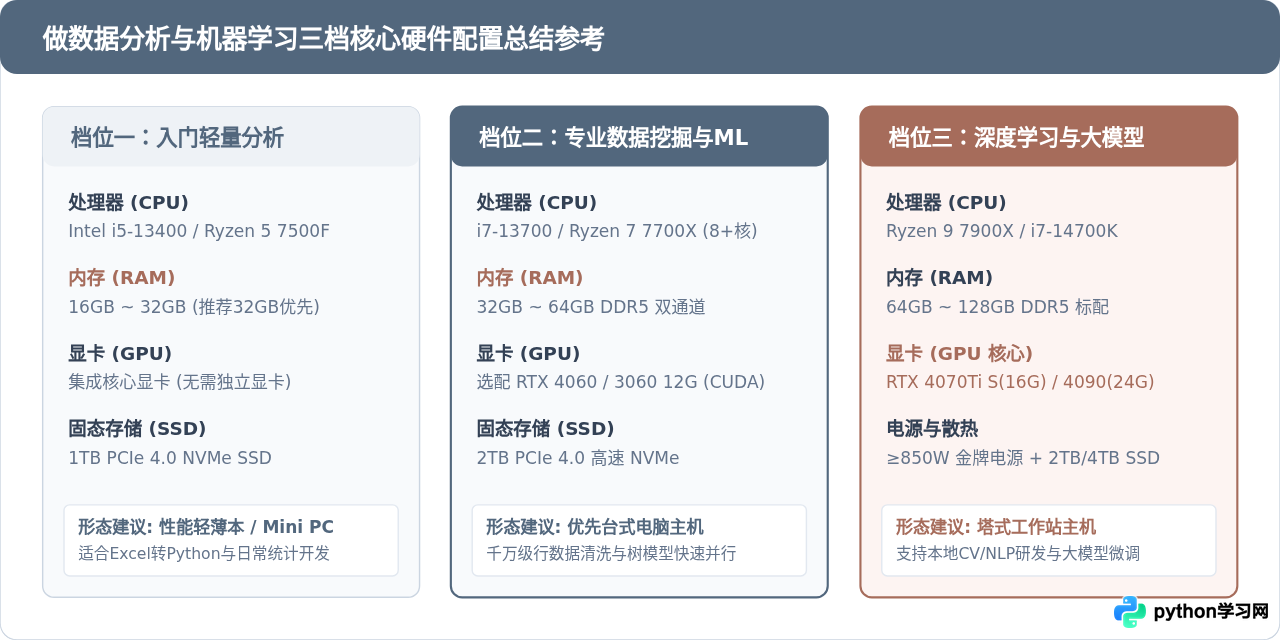
结合当前主流硬件生态与具体使用预算,我们将配置分为三档参考,读者可根据自身所处的实际阶段对号入座:
档位一:入门与轻量日常数据分析(适合自学基础、办公自动化、百万行内数据处理)
- 适用人群:高校学生自学 Python、业务分析师做 Excel/SQL/Pandas 数据看板、爬虫与报表自动化。
- 处理器(CPU):主流 6 核 12 线程处理器,如 Intel Core i5-13400 / i5-14400,或 AMD Ryzen 5 7500F / 8600G。移动端推荐 AMD Ryzen 7 7840HS / 8845HS 或 Intel Core Ultra 5。
- 内存(RAM):16GB ~ 32GB。若是选购轻薄本,强烈建议直接选配 32GB 内存版本(很多现代轻薄本为板载内存,后期不可加装)。
- 显卡(GPU):现代处理器内置的核心显卡即可,无需购买独立显卡,省下的大量预算可用于改善显示器色彩与分辨率。
- 固态硬盘(SSD):1TB PCIe 4.0 NVMe SSD。
档位二:专业数据科学与传统机器学习进阶(适合中大型企业分析师、GBDT/XGBoost重度调参)
- 适用人群:处理千万级行数据、参加 Kaggle / 天池结构化表格竞赛、高频构建特征与训练集成树模型。
- 处理器(CPU):8 核心以上高性能处理器,如 Intel Core i7-13700 / i7-14700,或 AMD Ryzen 7 7700X / 9700X。多核心并行能够显著缩短超参数网格搜索耗时。
- 内存(RAM):32GB ~ 64GB DDR5 双通道。32GB 为标准起步,如果有大量文本挖掘与图特征提取任务,64GB 能彻底免除后顾之忧。
- 显卡(GPU):选配 NVIDIA GeForce RTX 4060 或 RTX 3060 12G(在台式机上)。此时显卡主要用于部分支持 GPU 的机器学习库(如 XGBoost
tree_method='hist'、LightGBM GPU 支持、cuDF 等加速工具)。 - 固态硬盘(SSD):2TB 高性能 PCIe 4.0 NVMe SSD(如读取速度 7000MB/s 级别)。
档位三:本地深度学习与大模型微调工作站(适合CV、NLP、本地大语言模型量化与Lora微调)
- 适用人群:计算机视觉与多模态研究、NLP 对话模型开发、本地部署与微调 7B~14B 开源大语言模型。
- 处理器(CPU):8~16 核高端处理器(如 AMD Ryzen 9 7900X / 9900X 或 Intel i7-14700K)。
- 显卡(GPU):核心中的核心。根据预算在以下型号中选择:
- 入门门槛:RTX 3060 12GB(老一代性价比较高,具备 12GB 显存)。
- 甜点生产力:RTX 4070 Ti Super 16GB / RTX 4080 16GB(16GB 显存可流畅运行并微调主流 7B/8B 模型的 4-bit / 8-bit 版本)。
- 旗舰工作站:RTX 4090 24GB 或二手 RTX 3090 24GB(24GB 完整显存是本地调试主流前沿架构的黄金规格)。
- 内存(RAM):64GB ~ 128GB DDR5。深度学习数据加载流水线(DataLoader 开启多进程 num_workers)以及加载全精度模型权重转换时极其消耗系统内存。
- 供电与散热:额定 850W~1000W 80PLUS 金牌认证电源,机箱具备良好的前后贯通散热风道,确保显卡满载数小时不发生过热保护。
五、常见选购误区与避坑建议
在实际装机或购置笔记本的过程中,有几个极其高发的设计误区需要特别留意:
误区一:把 70% 的预算砸在显卡上,却搭配了 16GB 内存
这是最典型的“头重脚轻”配置。许多人买了配备 RTX 4070 的笔记本或台式机,却舍不得多花几百元升级内存。在实际运行时,数据预处理还没进入 GPU 显存,前置的 Pandas 清洗与特征矩阵生成阶段就已经因为 16GB 内存耗尽而频繁卡死,导致昂贵的显卡绝大部分时间处于完全空转状态。
误区二:盲目购买超薄游戏本作为“深度学习训练机”
轻薄游戏本在外观和便携性上确实吸睛,但深度学习模型的训练通常是持续数小时甚至整夜的持续高负荷运算。超薄机身的散热风道狭窄,显卡在达到 85℃ 以上温度墙后会主动触发降频,实际算力输出经常缩水 30% 到 50%,且长期高温高负荷对主板元件寿命带来严峻考验。如果要进行高强度的本地模型训练,台式主机是无论在性价比、散热可靠性还是静音体验上都更合理的选择。
误区三:忽略本地配置与云端算力的组合打法
对于个人开发者或刚起步的学习者来说,花费两三万元购置顶级双卡或 4090 工作站并不一定是最高效的投入。最理性的硬件策略往往是:“本地重内存在线,轻显卡兼顾便携;重度大模型训练直接上云”。你在本地拥有一台运行流畅、内存充裕(如 32GB/64GB)、方便查阅资料和调试代码的中端电脑,保证本地开发丝滑顺畅;当真正需要对几十吉参数的大模型跑几天全量微调时,以每小时几元钱的成本按需租用云端 A100 / H100 算力实例,既能节省巨大的硬件折旧成本,又能随时调用业界最新的算力集群。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















