


Python怎么修改文本文件的前几行内容
详细讲解在Python中如何修改文本文件的前几行内容。从底层存储原理、内存切片替换法,到生产级临时文件原子替换法与fileinput模块,提供清晰完整的代码示例与注意事项。
一、为什么不能像文本编辑器一样直接“就地插入”
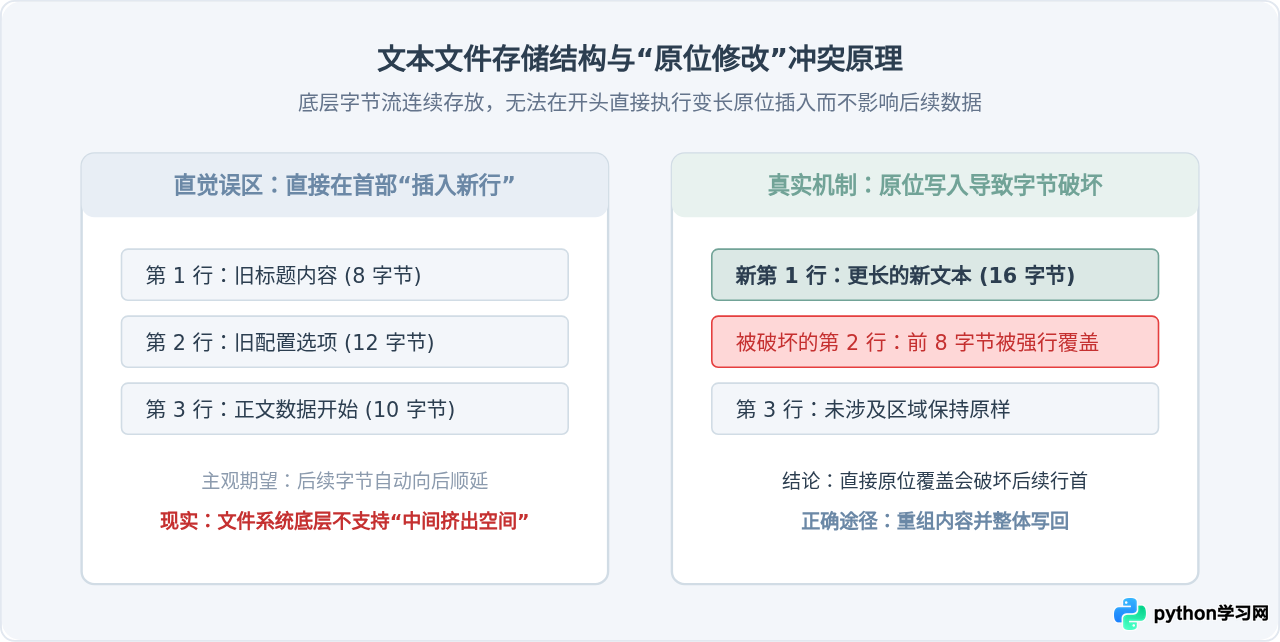
初学者在面对这个问题时,往往会联想到在编辑器中光标移到第一行打字的过程,认为可以直接通过文件指针 seek(0) 跳转到文件开头,写入新内容即可。然而,计算机底层对磁盘文本文件的存储机制决定了这种方式并不可行。
在文件系统中,文本文件是由连续的字节流(Byte Stream)顺序存放的。如果在以 r+ 模式打开的文件头部直接写入新内容,文件指针会从第 0 个字节开始直接覆盖对应位置的原有字节。如果新行的字节长度与旧行完全相同,原位覆盖能够生效;但只要新内容与旧内容长度不一致,就会引发数据灾难:
- 新内容比旧内容短:旧行的后半截残留字符仍然留在文件中,导致内容粘连甚至乱码;
- 新内容比旧内容长:新内容溢出的字节会直接覆盖紧随其后的下一行开头,破坏后续的有效文本。
磁盘文件本身不支持无重写的中间挤压或拉伸。因此,修改文件前几行的标准解决思路,必然是“读取现有内容 → 替换目标头部行 → 完整重建文件”。
二、方法一:内存切片替换法(最推荐的中小文件方案)
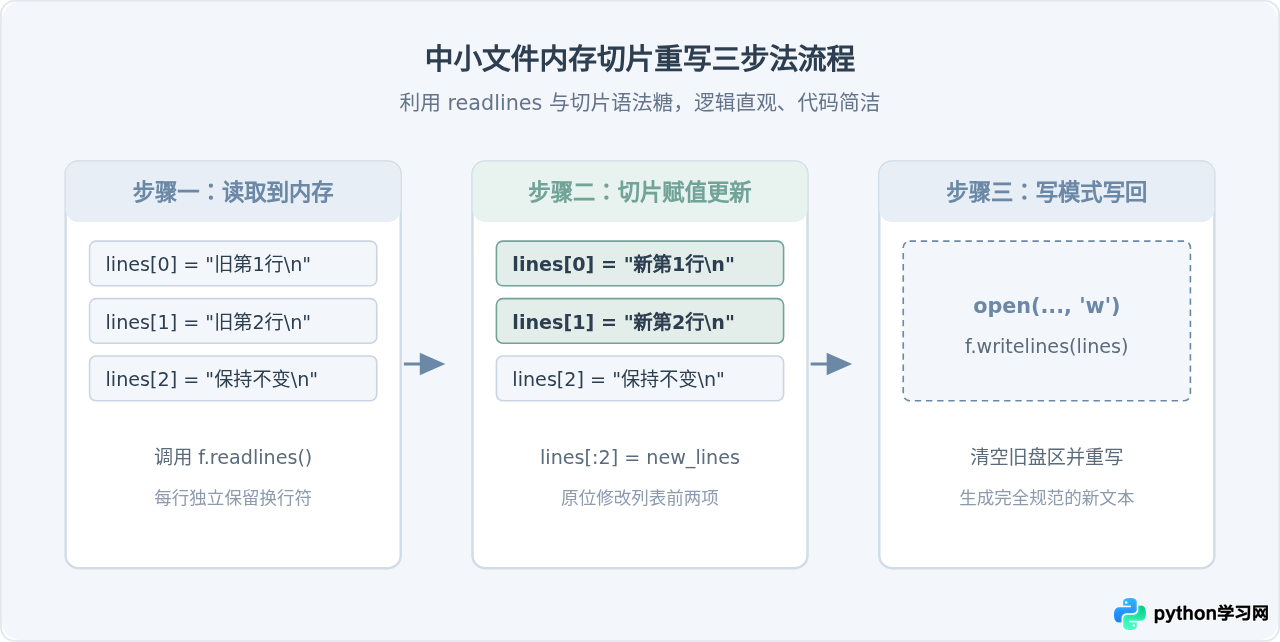
对于绝大多数日常场景(配置文件、代码脚本、几万行以内的日志数据等),文件大小通常只有几 KB 到几十 MB。此时将文件完整读入内存列表,利用 Python 原生列表切片操作替换前几行,再写回原文件,是最简洁高效的实现方式。
1. 操作步骤说明
- 使用
with语句以读模式打开:调用f.readlines()将文件中的每一行读取为一个字符串列表,列表中的每个元素均保留了末尾的换行符\n; - 使用列表切片赋值:例如需要修改前 2 行,直接将
lines[:2]替换为准备好的新字符串列表; - 以写模式重新打开并写回:在
with open(filename, 'w', encoding='utf-8')上下文中,调用f.writelines(lines)覆写文件。
2. 完整代码示例
假设我们有一个名为 config.txt 的文件,我们需要将前 2 行替换为新的元数据信息:
def modify_first_lines_slice(file_path, new_lines):
    """
    使用内存切片替换文件前几行
    :param file_path: 目标文件路径
    :param new_lines: 用于替换前几行的新内容列表(需自带换行符)
    """
    # 步骤一:读取全部内容
    with open(file_path, 'r', encoding='utf-8') as f:
        lines = f.readlines()

    # 步骤二:替换前 N 行
    n = len(new_lines)
    lines[:n] = new_lines

    # 步骤三:写回原文件
    with open(file_path, 'w', encoding='utf-8') as f:
        f.writelines(lines)

# 使用示例
if __name__ == '__main__':
    target_file = 'config.txt'

    # 准备替换前两行的新内容(务必包含换行符 \n)
    replacement = [
        "# Updated: 2026-10-28\n",
        "# Version: 2.5.0\n"
    ]

    modify_first_lines_slice(target_file, replacement)
    print("前两行已成功修改!")
len(new_lines),Python 列表的切片赋值特性不会抛出索引越界异常(IndexError),而是会自动把现有所有行替换掉,并将剩余的新行追加上去。
三、方法二:临时文件与原子替换(生产级安全方案)
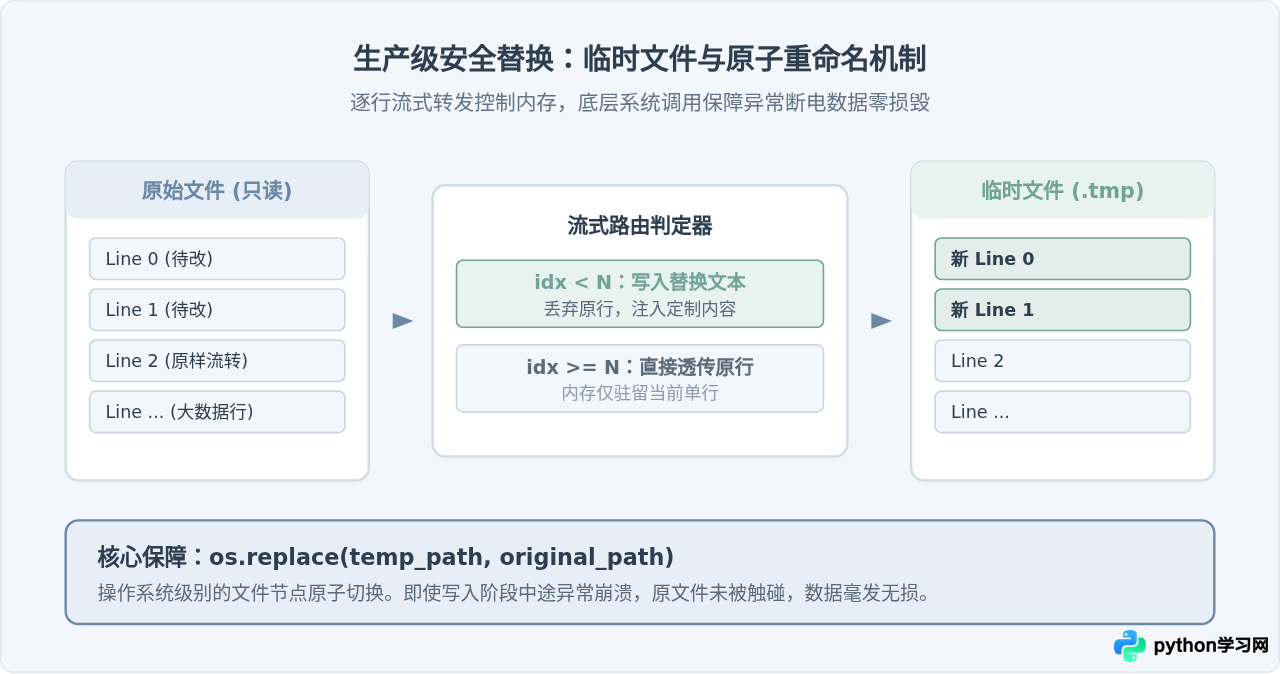
方法一虽然简单,但在生产环境中存在一个潜在风险:在以 'w' 模式打开文件的那一瞬间,旧文件会被立即清空。如果恰好在此刻程序遭遇断电、强制退出(如 OOM 被杀或机器关机),原文件的数据就会永久丢失。此外,面对数百 MB 或几 GB 的大文件,一次性 readlines() 会占用大量内存。
生产环境中处理该问题的标准做法是“逐行读取 + 写入临时文件 + 原子重命名(Atomic Rename)”:
- 以只读方式打开原文件,同时在相同目录下创建临时文件;
- 使用
enumerate()逐行遍历原文件。在前几行时写入新内容,超出前几行后原样复制旧内容; - 文件写完后关闭两个文件流,调用标准库
os.replace(temp_path, original_path)进行原子替换。
生产级完整实现代码
import os
import tempfile

def modify_first_lines_safe(file_path, new_lines):
    """
    通过临时文件流式重写并原子替换文件前几行
    :param file_path: 目标文件路径
    :param new_lines: 准备替换前几行的新内容列表
    """
    dir_name = os.path.dirname(file_path) or '.'
    n = len(new_lines)

    # 在同级目录创建临时文件(确保处于同一个文件系统分区,以支持原子 rename)
    with open(file_path, 'r', encoding='utf-8') as src_file, \
         tempfile.NamedTemporaryFile('w', dir=dir_name, delete=False, encoding='utf-8') as tmp_file:

        tmp_path = tmp_file.name

        # 逐行遍历原文件
        for idx, line in enumerate(src_file):
            if idx < n:
                # 处于前 N 行时,写入新内容
                tmp_file.write(new_lines[idx])
            else:
                # 超出前 N 行后,原样透传
                tmp_file.write(line)

        # 处理边界:如果原文件总行数少于 N 行,把剩余的新行全部补齐
        total_original_lines = idx + 1 if 'idx' in locals() else 0
        if total_original_lines < n:
            for extra_idx in range(total_original_lines, n):
                tmp_file.write(new_lines[extra_idx])

    # 执行原子替换(POSIX 系统与 Windows 均支持)
    os.replace(tmp_path, file_path)

# 测试执行
if __name__ == '__main__':
    data_file = 'large_log.txt'
    updates = [
        "LOG_HEADER_V2\n",
        "ENCODING: UTF-8\n"
    ]
    modify_first_lines_safe(data_file, updates)
    print("大文件前两行安全替换完毕!")
四、方法三:利用标准库 fileinput 实现就地修改
Python 官方标准库提供了一个专门用于就地修改文本的模块:fileinput。通过设置参数 inplace=True,可以在保留类似脚本批处理语法的体验下完成就地替换。
import fileinput

def modify_first_lines_fileinput(file_path, new_lines):
    n = len(new_lines)
    # inplace=True 内部会自动劫持 sys.stdout 并通过临时文件中转
    with fileinput.input(files=(file_path,), inplace=True, encoding='utf-8') as f:
        for line in f:
            line_no = f.filelineno() - 1  # filelineno 从 1 开始计算
            if line_no < n:
                # print 输出的内容将被直接写入重构的文件中
                print(new_lines[line_no], end='')
            else:
                print(line, end='')

# 使用示例
if __name__ == '__main__':
    modify_first_lines_fileinput('app.env', ['ENV=production\n', 'DEBUG=False\n'])
fileinput 模块在进入上下文后,会将标准输出 sys.stdout 重定向到目标文件的写入缓冲中。因此在循环体内如果随意调用了用于调试的 print(),这些打印信息也会被直接写进文件里。
五、核心注意事项与避坑指南
-
必须显式处理换行符
\n:无论是writelines()还是流式write(),Python 都不会自动在字符串末尾追加换行符。如果替换列表写成["Title", "Subtitle"],最终写入文件的就会变成TitleSubtitle并与原有第 3 行直接连成一行。 -
明确指定编码格式
encoding='utf-8':Windows 系统的默认代码页通常是 GBK,若不显式指定encoding='utf-8',遇到中文字符时很容易报UnicodeDecodeError或产生乱码。 -
0 索引与行数对齐:Python 列表是 0 索引的。若需要修改前 3 行,对应的索引为
0, 1, 2,切片表达式应为lines[:3]。 -
跨盘符重命名限制:使用方法二的临时文件方案时,
tempfile.NamedTemporaryFile的dir参数必须指向与目标文件相同的目录或同一磁盘挂载分区,否则跨分区执行os.replace会抛出Invalid cross-device link错误。
六、方案选择对比与全流程总结
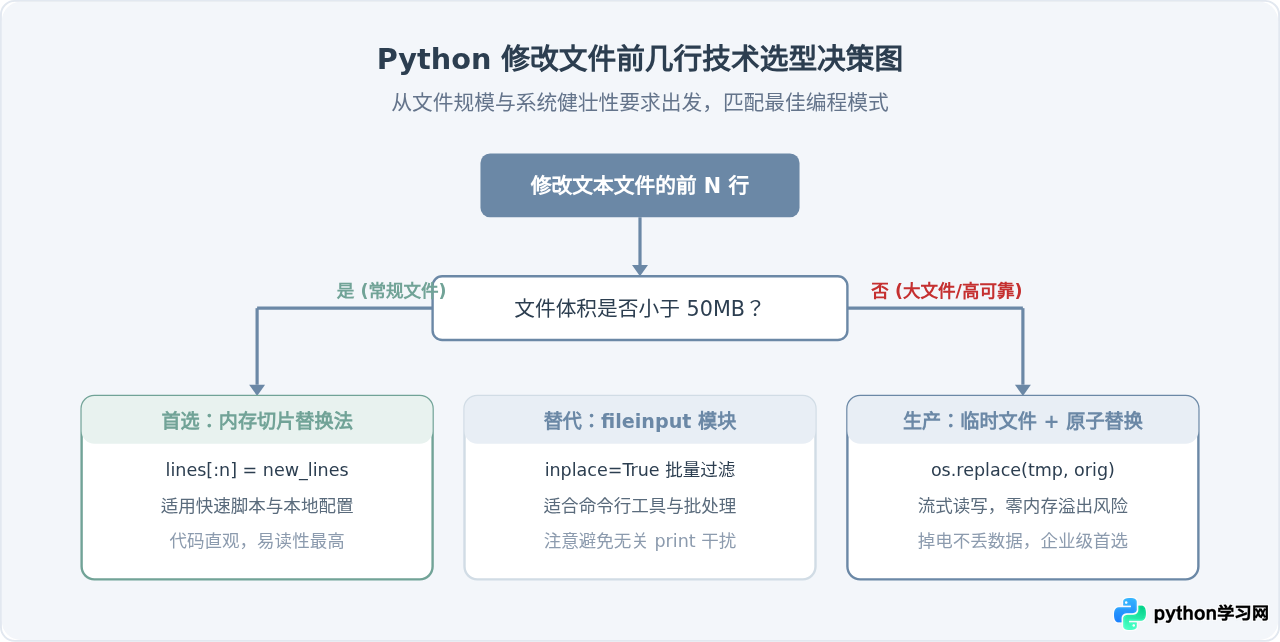
针对不同的业务环境与文件特征,三种主流修改方案的对比如下:
| 方案名称 | 内存消耗 | 异常安全性 | 代码复杂度 | 最适场景 |
|---|---|---|---|---|
| 内存切片法 (readlines) | 与文件体积相当 | 一般(若写入中断原文件会受损) | 极低(5 行代码) | 日常开发、常规配置文件、中小文本 |
| 临时文件原子替换法 | O(1) 极低(仅单行缓存) | 极高(断电保证原文件完好) | 中等 | 生产服务器、核心资产数据、百兆以上大文件 |
| fileinput 模块 | 较小 | 较高(内部带备份机制) | 较低 | CLI 运维批处理脚本、数据清洗工作流 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















