


Python open()文件操作内置函数基础教程
全面讲解Python内置函数open()的基本用法、核心参数解析、文件打开模式矩阵、with语句上下文管理机制、编码规范及常见报错排查。
open(),无需导入任何第三方模块即可直接使用。本文将从 open() 的基本语法讲起,详细梳理文件操作的标准流程、打开模式的具体差异、安全关闭文件的上下文管理器(with 语句),以及开发中必知的字符编码和常见报错排查技巧。
一、open() 函数核心语法与最简示例
open() 函数的核心职责是打开指定路径的文件,并返回一个能够执行读取或写入操作的文件流对象(File Object)。如果打开失败,解释器会直接抛出对应的异常(例如文件不存在时抛出 FileNotFoundError)。
该函数的完整参数签名如下:
open(file, mode='r', buffering=-1, encoding=None, errors=None, newline=None, closefd=True, opener=None)在绝大多数日常开发中,我们不需要接触全部参数,重点关注前三个参数即可:
- file:要打开的文件路径(字符串或
Path对象),可以是相对路径(如"data.txt")或绝对路径。 - mode:文件打开模式,默认为只读文本模式
'r'。 - encoding:字符编码格式,操作文本文件时强烈建议始终显式写明
encoding="utf-8",避免因操作系统默认编码不同引发乱码。
下面是一个最基本的文件写入与读取范例:
# 写入内容到 demo.txt
with open("demo.txt", mode="w", encoding="utf-8") as f:
    f.write("你好,Python 文件操作!\n这是第二行内容。")

# 从 demo.txt 读取刚才写入的内容
with open("demo.txt", mode="r", encoding="utf-8") as f:
    content = f.read()
    print("读取到的内容:")
    print(content)
二、文件读写生命周期与 with 语句
对文件的操作在底层遵循操作系统分配系统句柄(File Handle)的机制。任何文件交互都包含三个核心步骤:请求系统句柄(打开)、数据交换(读写)、释放系统句柄(关闭)。
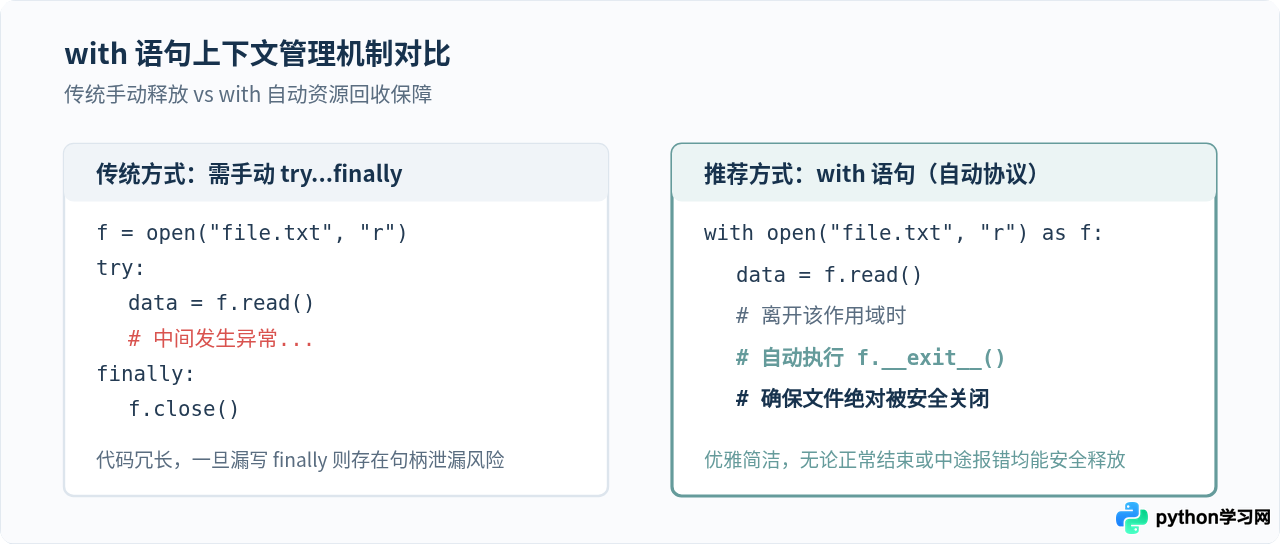
早期的 Python 代码常常采用 f = open(...) 搭配 f.close() 的手动关闭方式。这种做法存在显著的隐患:如果中间的代码抛出了异常,或者开发者疏忽忘记调用 close(),文件句柄就会一直被进程占用,在并发场景或循环处理大量文件时极易造成句柄耗尽错误。
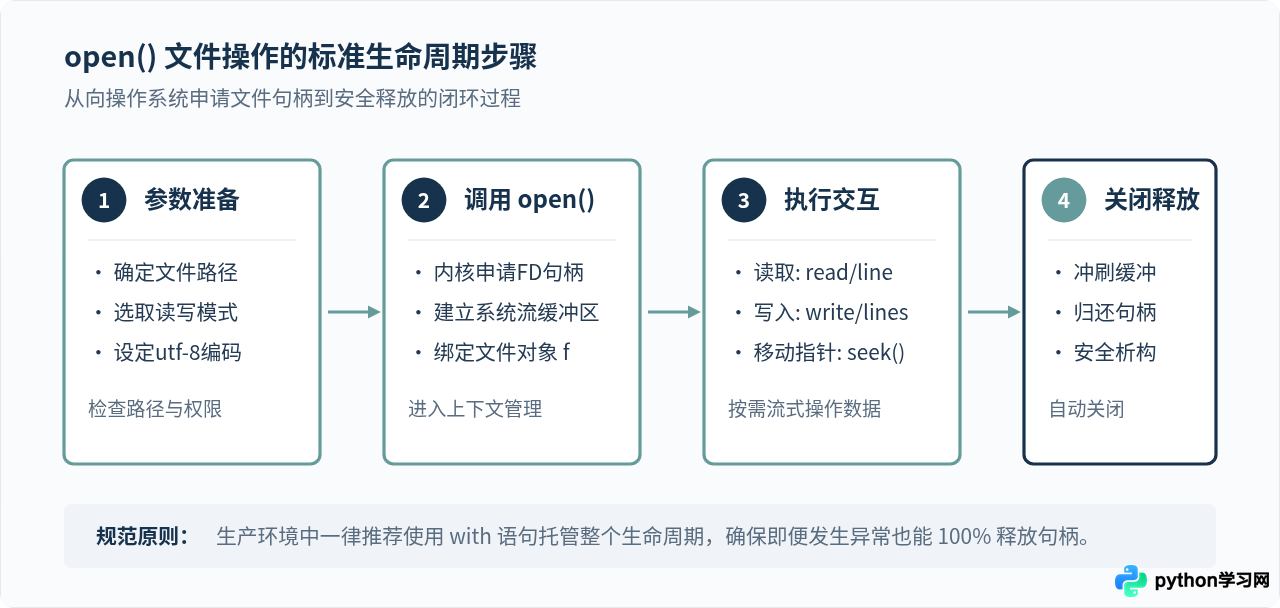
在现代 Python 中,官方推荐且唯一的标准写法是配合 上下文管理器(with 语句)。当代码执行到 with 块外部(无论正常执行完毕还是因为发生异常中断)时,Python 会自动调用文件对象的 __exit__() 方法,从底层安全执行 close() 并清理缓存。
三、全方位理清文件打开模式(mode)
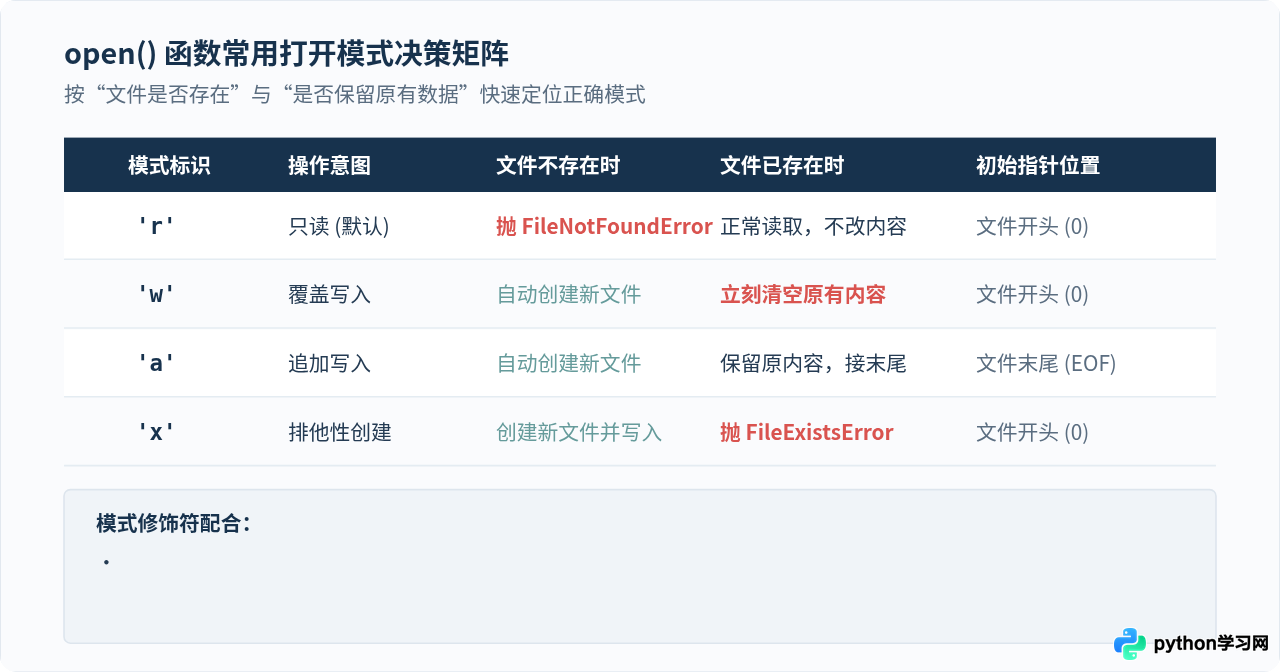
mode 参数决定了 Python 与文件建立连接时的读写权限和文件指针初始位置。初学者最容易在覆盖写入('w')与追加写入('a')之间产生混淆。
1. 覆盖写入 'w' 与 追加写入 'a' 的差别
请务必注意:使用 mode="w" 打开一个已存在的文件时,一旦 open() 执行成功,文件原本的内容会被瞬间截断清空为 0 字节,无论之后有没有实际调用 write()。
如果你的需求是向日志或数据表中追加新行,必须使用 mode="a":
# 追加模式示例:记录运行日志
with open("app.log", mode="a", encoding="utf-8") as f:
    f.write("[INFO] 系统启动完成\n")
    f.write("[INFO] 正在监听端口 8080\n")
2. 防止误覆盖的 'x' 模式
如果你想生成一个配置文件,且绝不能覆盖已有的老文件,使用 mode="x" 是最安全的方案。如果文件已存在,Python 会直接抛出 FileExistsError,从而保护已有数据。
四、常用读取与写入方法实操
1. 四种常用读取方式
打开文件后,文件对象 f 提供了多种读取数据的方式,应根据文件体积合理选用:
f.read(size=-1):一次性读取全部内容(或指定字符数)。适用于体积小、能全部装入内存的文件。f.readline():每次仅读取单行,遇到行尾换行符\n停止。f.readlines():一次性读取所有行,并将它们组织成一个字符串列表[line1, line2, ...]。- 推荐:直接迭代文件对象
for line in f:。这是处理大文件的最佳实践。Python 在底层使用生成器逐行读取,内存占用极小。
# 大文件遍历读取的最佳实践:节省内存且性能最优
with open("large_data.txt", mode="r", encoding="utf-8") as f:
    for line_num, line in enumerate(f, start=1):
        # strip() 移除行尾的换行符
        clean_text = line.strip()
        if "ERROR" in clean_text:
            print(f"第 {line_num} 行发现异常: {clean_text}")
2. 写入与刷新机制
使用 f.write(string) 写入字符串时,不会自动在末尾添加换行符,如果需要分行,必须显式写入 \n。
另外,write() 数据并非立刻落盘,而是先暂存在内存缓冲区(Buffer)中。在 with 块结束或显式调用 f.flush() 时,数据才会真正同步到物理磁盘。
五、编码规范与跨平台注意事项
encoding 是很多初学者在 Windows 环境下遇到 UnicodeDecodeError 的根源所在。
在 Linux 和 macOS 上,Python 默认的系统编码通常为 UTF-8;而在中文 Windows 系统上,默认编码往往是 GBK(CP936)。如果代码中只写
open("data.txt", "r"),在 macOS 上能正常打开的 UTF-8 文件,移动到 Windows 机器运行就会立即报错 UnicodeDecodeError: 'gbk' codec can't decode byte...。因此,养成显式写明 encoding="utf-8" 是跨平台开发的基本准则。
二进制文件处理
当读取图片、PDF、音视频或预编译字节流时,必须使用带有 b 的模式(如 'rb' 或 'wb')。在二进制模式下,禁止传入 encoding 参数,读写的数据类型为 Python 的 bytes 对象而非 str:
# 复制二进制图片文件示例
with open("source.png", "rb") as src_file:
    data = src_file.read()

with open("copy.png", "wb") as dst_file:
    dst_file.write(data)
六、open() 核心要素速查与常见报错排查
下面将日常开发中必须遵循的四个核心法则与最常见的四大报错进行汇总,供日常排查与速查。
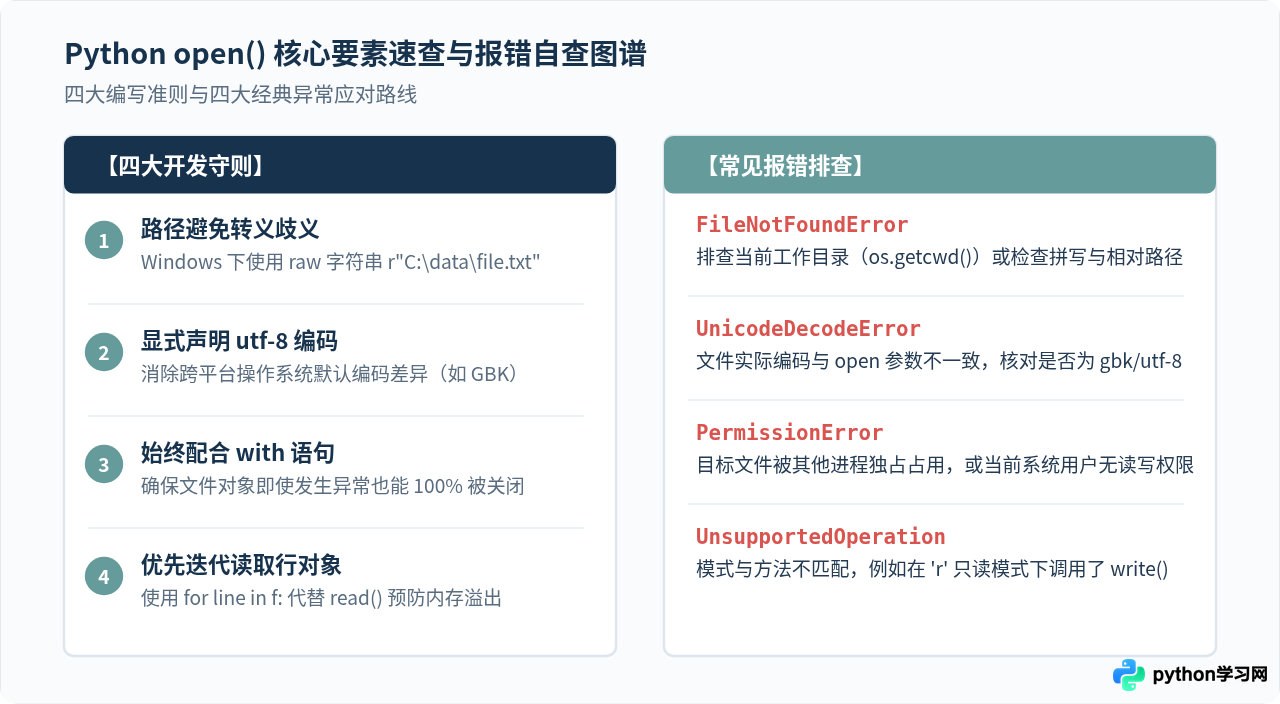
总结
Python 的 open() 函数虽然简单易用,但规范的使用习惯直接决定了程序的健壮性与跨平台兼容性。在实际开发中,请牢记三个核心要点:
- 使用
with语句管理上下文,摆脱繁琐的手动close(),杜绝句柄泄露。 - 显式传递
encoding="utf-8",消除不同操作系统带来的文本乱码风险。 - 严谨区分模式,明晰
'w'的清空特性与'a'的追加特性,根据数据量选择按行迭代遍历,实现高效低耗的文件读写。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















