


Python Web框架数据模型对比:Django ORM vs SQLAlchemy
深入对比 Python 主流数据模型 Django ORM 与 SQLAlchemy:从 Active Record 与 Data Mapper 架构哲学,到模型定义、查询接口、事务管理、异步生态及迁移工具的深度实践差异,提供严谨明确的选型决策依据。
假设你正在主导一个新 Python 业务系统的技术选型:如果团队要在两周内上线包含用户管理、后台审核和内容发布的闭环应用,Django ORM 几乎能让你以最少代码直接交付;但如果你的系统涉及分库分表、复杂报表透视、与异步微服务(如 FastAPI)协同,或者需要对每一条生成的 SQL 执行计划做精细调优,SQLAlchemy 则是更为坚实的底层支柱。本文从设计哲学、模型定义、查询构建、事务机制、异步与迁移生态五个维度展开全面对比,帮助读者在具体工程场景中做出明确的技术选型。
一、架构设计理念:Active Record 与 Data Mapper 的本质分野
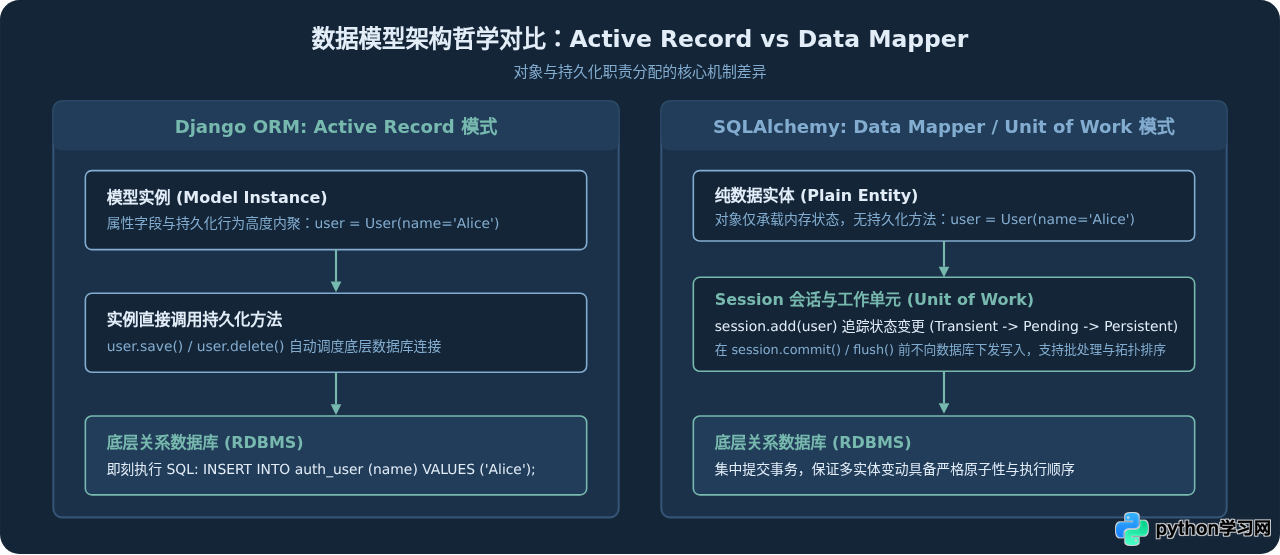
Django ORM 与 SQLAlchemy 最核心的差异,源于两者所遵循的企业级架构模式不同。前者采用 Active Record(活动记录) 模式,后者则践行 Data Mapper(数据映射器)与 Unit of Work(工作单元) 模式。
在 Django 的 Active Record 体系中,一个模型类对应数据库中的一张表,而该类的一个实例直接对应表中的一行数据。业务属性与数据库存取操作紧密耦合在同一个对象上——调用 user.save() 即执行持久化,调用 user.delete() 即执行删除。这种高度内聚的设计让 CRUD 操作直观流畅,降低了心智负担,同时与 Django 的 Admin 管理后台、ModelForm 表单校验系统实现了开箱即用的深度联动。
与此相对,SQLAlchemy 采用 Data Mapper 模式,主张将内存中的业务实体与持久化层彻底解耦。模型对象在本质上是纯粹的数据承载实体(Plain Old Python Object),它既不知道、也不直接负责如何把自己写入数据库。所有的状态跟踪、增删改查以及事务协调,全部委托给独立的 Session 及内部的 Unit of Work 引擎处理。当你在应用中修改对象字段时,仅改变了内存数据;只有向 Session 显式注册并触发 Flush/Commit 时,ORM 才会自动计算变更集并批量下发最优的 SQL 语句。
二、模型定义与对象生命周期对比
在代码声明层面,Django ORM 强调规范统一与开箱即用的便利性,而现代 SQLAlchemy(2.0+)则深度融合了 Python 的类型提示(Type Annotations),为现代 IDE 提供了极为友好的静态类型检查与重构体验。
1. Django ORM 模型定义示例
Django 通过继承 models.Model 构建数据表,字段类型(如 CharField、ForeignKey)直接反映数据库列定义与校验规则:
from django.db import models

class Department(models.Model):
    name = models.CharField(max_length=100, unique=True, verbose_name="部门名称")
    created_at = models.DateTimeField(auto_now_add=True)

    class Meta:
        db_table = "sys_department"
        ordering = ["-created_at"]

class Employee(models.Model):
    department = models.ForeignKey(
        Department,
        on_delete=models.CASCADE,
        related_name="employees"
    )
    name = models.CharField(max_length=64, verbose_name="员工姓名")
    salary = models.DecimalField(max_digits=10, decimal_places=2)
    is_active = models.BooleanField(default=True)

    class Meta:
        db_table = "sys_employee"
2. SQLAlchemy 2.0+ 模型定义示例
SQLAlchemy 2.0 推荐使用 DeclarativeBase 搭配 Mapped 类型注解,不仅具备完备的类型推断,还可以自由与 Pydantic、dataclass 方案整合:
from datetime import datetime
from decimal import Decimal
from typing import List
from sqlalchemy import String, Numeric, Boolean, DateTime, ForeignKey
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, relationship

class Base(DeclarativeBase):
    pass

class Department(Base):
    __tablename__ = "sys_department"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    name: Mapped[str] = mapped_column(String(100), unique=True)
    created_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.utcnow)

    employees: Mapped[List["Employee"]] = relationship(
        back_populates="department", cascade="all, delete-orphan"
    )

class Employee(Base):
    __tablename__ = "sys_employee"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    department_id: Mapped[int] = mapped_column(ForeignKey("sys_department.id"))
    name: Mapped[str] = mapped_column(String(64))
    salary: Mapped[Decimal] = mapped_column(Numeric(10, 2))
    is_active: Mapped[bool] = mapped_column(Boolean, default=True)

    department: Mapped["Department"] = relationship(back_populates="employees")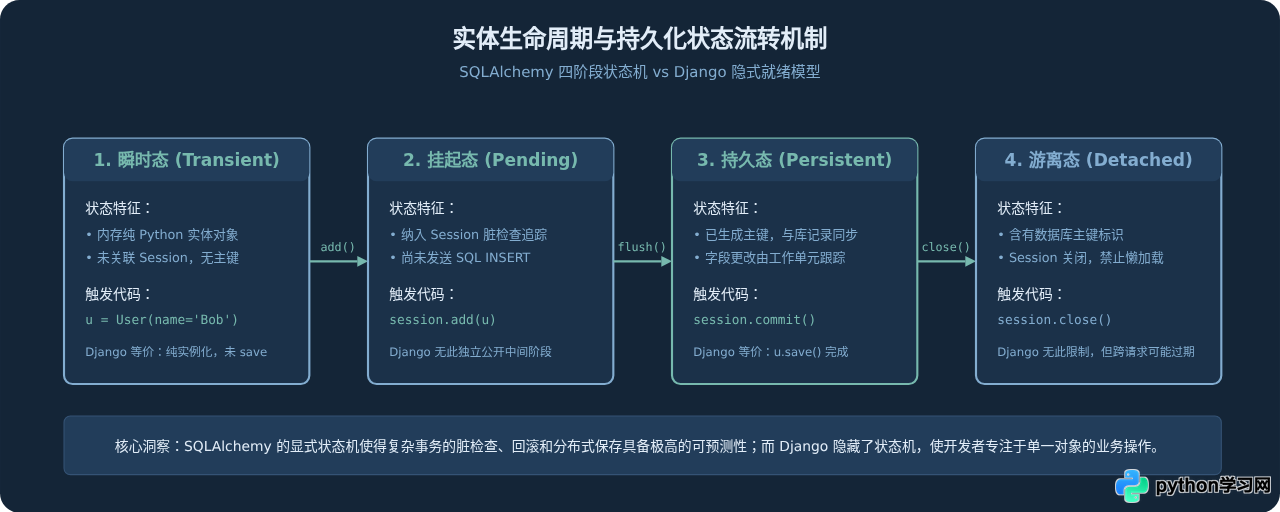
三、查询 API、性能优化与事务控制对比
查询构建是开发者日常编码耗时最多的部分。Django ORM 强调高抽象度、链式调用的简洁性;SQLAlchemy 则提供了一套完整的 SQL 代数表达系统,其 API 设计几乎与原生 SQL 标准 1:1 对齐。
1. 查询语法与表现力对比
以一个典型的统计场景为例:“查询技术部(IT)下所有激活状态员工,按薪资降序排列并分页”:
# Django ORM: 链式 QuerySet 风格,下划线语法表达关联跨表
employees = (
    Employee.objects
    .filter(department__name="IT", is_active=True)
    .order_by("-salary")[0:10]
)

# SQLAlchemy 2.0: 显式 Select 表达式,类型安全的比较与执行
stmt = (
    select(Employee)
    .join(Employee.department)
    .where(Department.name == "IT", Employee.is_active.is_(True))
    .order_by(Employee.salary.desc())
    .limit(10)
)
employees = session.scalars(stmt).all()
2. N+1 查询问题与加载策略对比
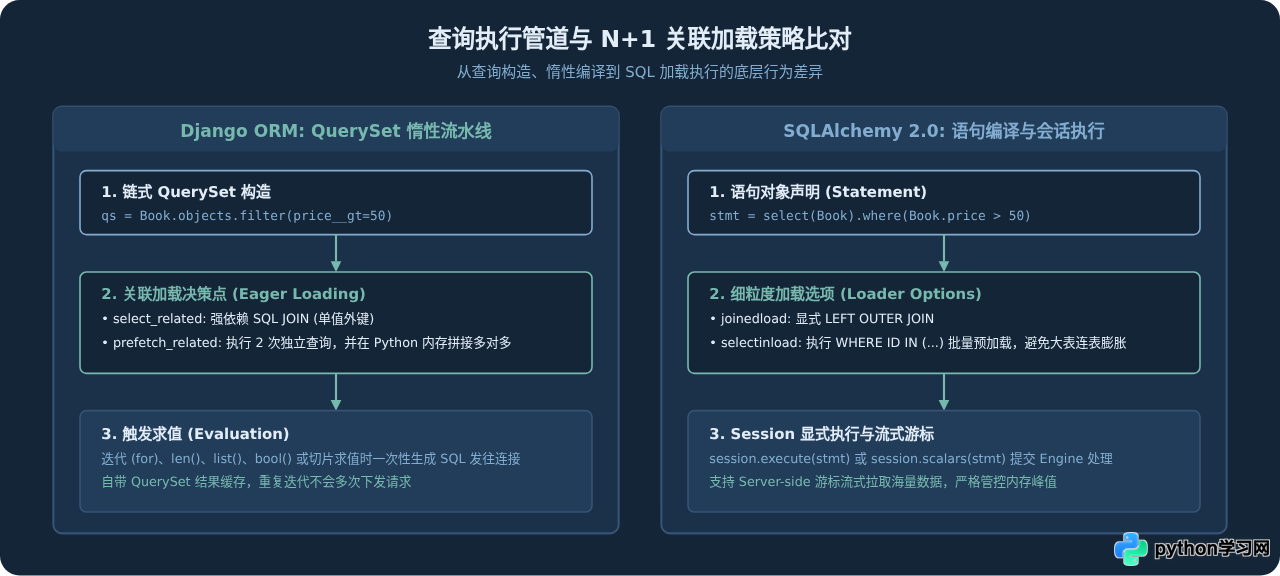
ORM 开发者不可避免会遭遇 N+1 查询 性能陷阱。在处理 1 对多关联数据时,两者的解决机制呈现不同的设计路径:
- Django ORM:
select_related(*fields):使用 SQLINNER JOIN或LEFT OUTER JOIN一次性将单值关联对象(一对一、多对一的外键)查出,生成单条宽表 SQL。prefetch_related(*lookups):使用单独的查询分别抓取主表与多值关联表(多对多、一对多的反向引用),并在 Python 内存中按照外键关系完成关联对象的拼接拼装。
- SQLAlchemy:
joinedload():类似select_related,使用外连接在单条 SQL 中载入关联数据。selectinload():现代推荐策略,类似prefetch_related,执行主查询后提取所有 ID,通过WHERE id IN (...)批量抓取关联数据,对集合类型数据效率极高且避免笛卡尔积膨胀。contains_eager():当你在手动写的JOIN和WHERE条件中已经包含了关联表列时,通知 ORM 直接从结果集中填充关联实体,无任何多余开销。
四、数据库迁移与工程生态适配
数据模型的定义只是起点,在长期的软件工程维护中,数据库结构迁移(Migration)与异步框架(Async I/O)的兼容性同样至关重要。
1. 数据库迁移:Django Migrations vs Alembic
| 对比维度 | Django 内置 Migrations | SQLAlchemy + Alembic |
|---|---|---|
| 集成度 | 框架内置核心组件,无需任何额外配置,开箱即用。 | 独立第三方库,需在项目中初始化 alembic.ini 与 env.py。 |
| 检测与生成 | python manage.py makemigrations 自动比对模型状态并生成有序依赖图。 |
alembic revision --autogenerate 比对数据库 MetaData 生成差异脚本。 |
| 变更控制力 | 抽象度高,但处理表重命名、复杂数据回填(RunPython)时需遵守特定约束。 | 提供纯 Python 代码控制,可直接嵌入任意复杂的 DDL/DML 操作与条件逻辑。 |
| 边界风险 | 非常稳定,外键及联合约束的重构由 Django 内部拓扑算法自动保证执行顺序。 | 自动检测有时会遗漏未命名的唯一约束、PostgreSQL 枚举值变动,上线前必须人工 Code Review。 |
2. 异步生态(Asyncio)与现代微服务
随着 FastAPI、Litestar、Sanic 等基于 ASGI 的异步 Web 框架流行,ORM 对 async/await 的原生支持成为高并发系统的核心指标:
- SQLAlchemy 2.0+: 提供了工业级且完全原生的一流异步驱动方案。通过
create_async_engine配合AsyncSession,无缝兼容asyncpg(PostgreSQL)、aiomysql(MySQL)等高性能异步驱动。由于它的 Data Mapper 设计天然解耦,在异步微服务架构中几乎是事实上的标准。 - Django ORM: Django 长期建立在同步 WSGI 根基上。尽管近年来 Django 逐步引入了
sync_to_async适配层并推出了afirst()、acount()、asave()等异步接口,但在深层关联查询、懒加载属性访问时仍可能无意中触发同步阻塞。在纯异步、高吞吐的微服务中,Django ORM 仍显繁重。
五、选型决策指南与对比总结
技术选型没有绝对的优劣,只有与团队技能、交付周期和系统架构约束之间的匹配度。以下决策树可作为评估的标准参考:
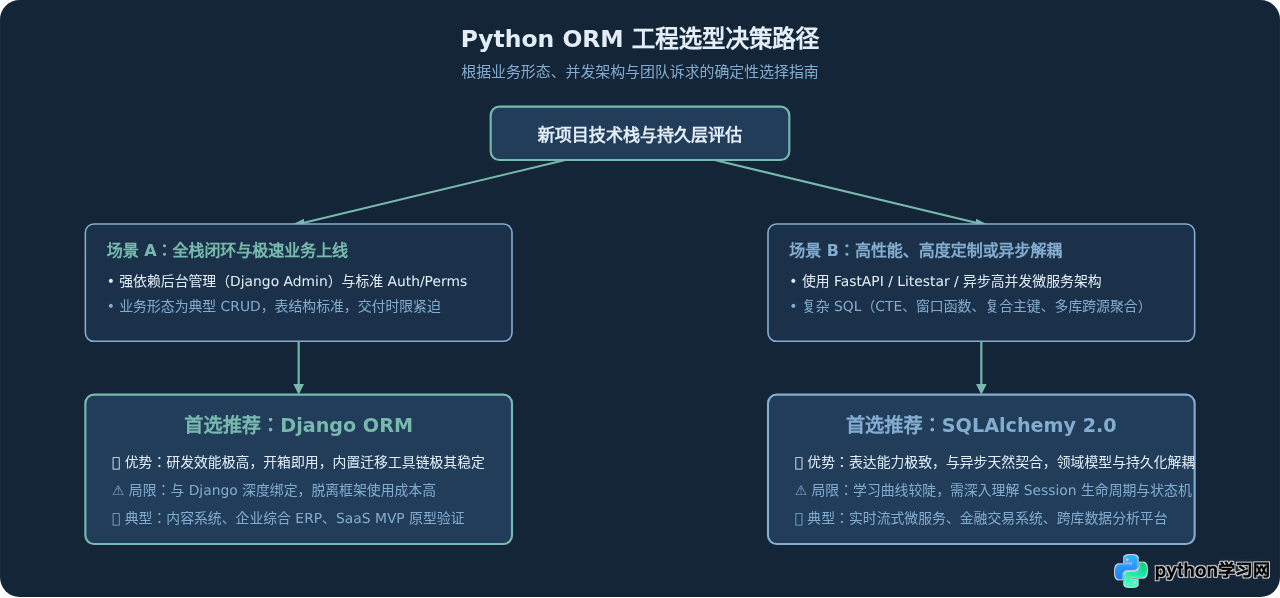
如果你的应用骨架是标准的 Django Web 体系,请毫不犹豫地拥抱 Django ORM,它与 Django Admin、表单、信号及鉴权机制构成的生产力闭环无可替代;如果你的技术栈基于 FastAPI、Flask 或独立异步任务系统,或者团队正在实践领域驱动设计(DDD)并需要对底层 SQL 和连接池实施极致掌控,那么遵循 Data Mapper 哲学的 SQLAlchemy 2.0 则是更具扩展性与工程深度的长期选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















