


Python内置数据结构详解:列表、元组、字典与集合
系统讲解Python四大核心内置数据结构(列表、元组、字典与集合)的定义语法、底层实现机制、常用操作方法、性能特征及选型策略,帮助开发者写出高效规范的Python代码。
编写高质量 Python 代码的基础在于合理组织与处理数据。Python 在语言核心内置了四种最基本的数据容器:列表(list)、元组(tuple)、字典(dict)与集合(set)。它们在可变性、有序性、唯一性及底层存储结构上各有侧重,分别服务于序列存储、不可变快照、快速映射以及集合去重运算。理解它们的运作机制与性能边界,是避免性能陷阱、编写地道 Python 程序的前提。
一、列表(List):动态有序的通用序列
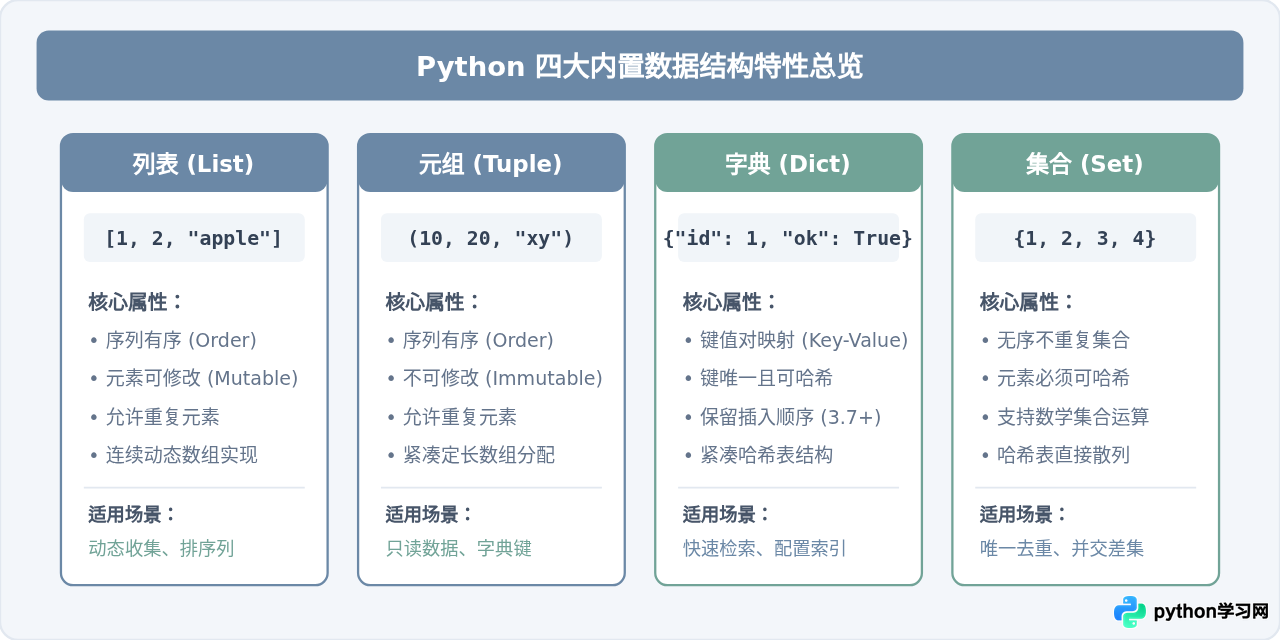
列表是 Python 中最灵活、最常用的序列类型。用方括号 [] 声明,允许存储不同类型的数据项,并保留元素插入的绝对物理次序。
1. 常见操作与常用方法
列表提供了丰富的原位(in-place)修改方法与切片能力。常见的操作如下:
# 创建与初始化
fruits = ["apple", "banana", "cherry"]

# 索引访问与切片
first_item = fruits[0]        # "apple"
sub_list = fruits[1:3]        # ["banana", "cherry"]

# 尾部增添与扩展
fruits.append("date")         # 追加单个元素:["apple", "banana", "cherry", "date"]
fruits.extend(["fig", "grape"]) # 批量扩展序列

# 指定位置插入与移除
fruits.insert(1, "blueberry") # 在索引1插入
removed_val = fruits.pop()    # 弹出末尾元素,并返回该值
fruits.remove("banana")       # 移除首次出现的指定元素
2. 底层实现与性能考量
在 CPython 解释器底层,列表并非单向链表,而是基于动态指针数组(连续内存块)实现的。这意味着:
- 按索引访问(
list[i]):时间复杂度为稳定的O(1),计算偏移量即可直接寻址。 - 尾部追加(
append):采用过量分配(Over-allocation)策略,平摊时间复杂度为O(1)。 - 首部或中间插入/删除(
insert / pop(0)):需要将后续所有元素指针集体向后或向前移动,时间复杂度高达O(n)。当需要高频双端操作时,应使用collections.deque。
二、元组(Tuple):轻量可靠的不可变序列
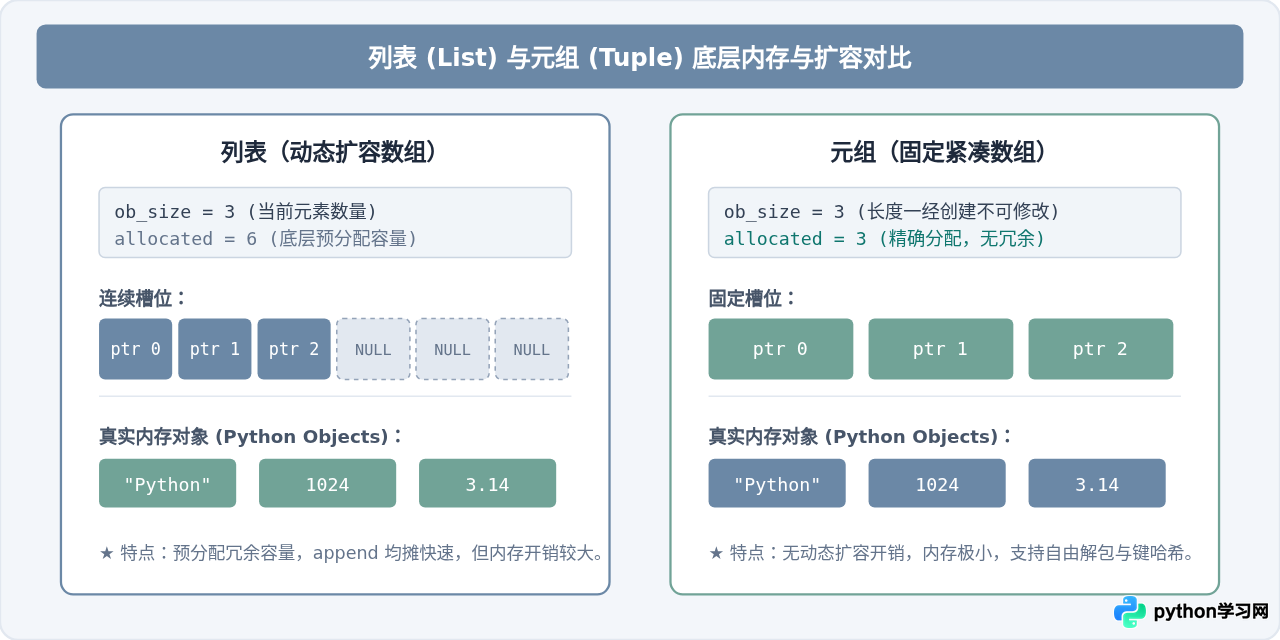
元组用圆括号 () 声明,表面上看像是一个只读列表。但其“不可变性”(Immutability)赋予了它独特的结构稳定性与内存优势。
1. 声明语法与易错陷阱
当声明仅包含一个元素的元组时,尾部的逗号是语法强制要求,否则括号只会被视作数学运算优先级符号:
single_tuple = (42,)      # 正确:单元素元组,类型为 tuple
not_a_tuple = (42)        # 错误:普通的整数,类型为 int

empty_tuple = ()          # 空元组
coords = 10, 20, 30       # 省略括号的元组打包(Tuple Packing)
2. 元组解包(Unpacking)与多元赋值
元组是 Python 实现优雅赋值的核心基础:
# 基础解包
x, y, z = (1, 2, 3)

# 变量交换(无须临时中间变量)
x, y = y, x

# 星号解包(收集剩余所有元素)
first, *middle, last = [10, 20, 30, 40, 50]
# first=10, middle=[20, 30, 40], last=50不可变性的真实边界:元组的不可变性仅指其存储的指针列表不可改变。如果元组内部嵌套了可变对象(如列表 t = (1, [2, 3])),列表内部的值依然可以被原地修改:t[1].append(4) 是完全合法的。但在这种情况下,该元组将丧失可哈希性,无法作为字典的键。
三、字典(Dictionary):高效的键值对散列表
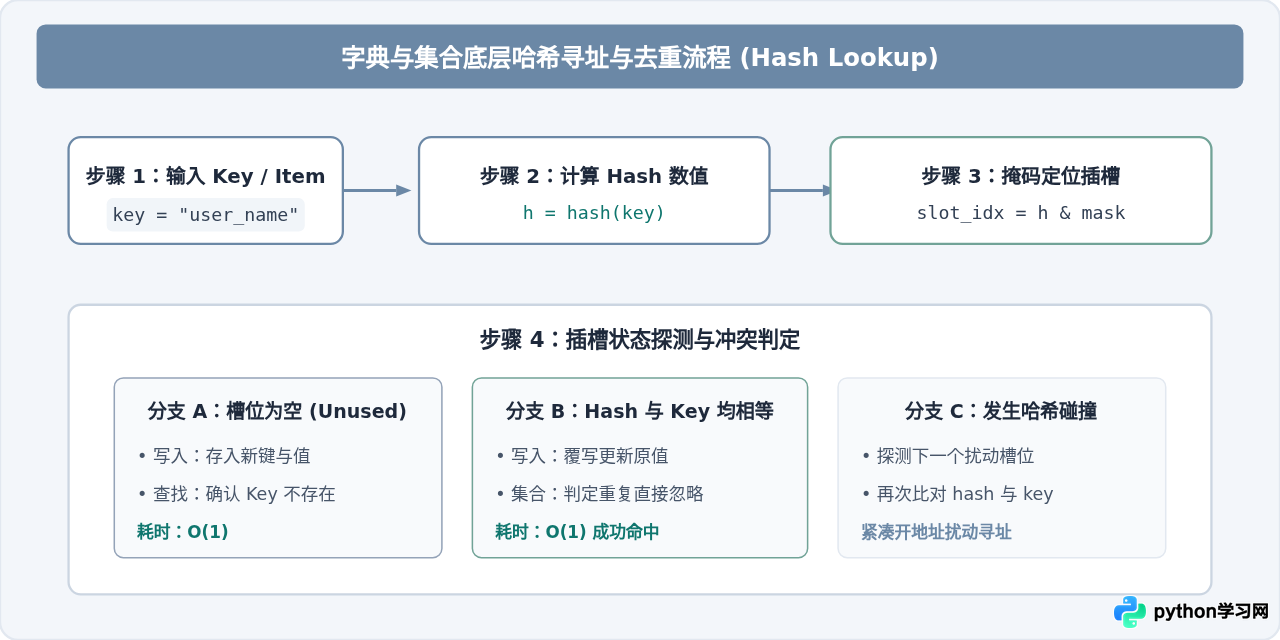
字典使用花括号 {key: value} 声明,是 Python 建立快速映射关系的核心工具。在 Python 3.7 及更高版本中,官方正式保证字典具备维持元素插入顺序的特性。
1. 常用读取与更新模式
user = {"id": 101, "name": "Alice", "role": "admin"}

# 安全访问(推荐使用 get,避免触发 KeyError)
email = user.get("email", "default@example.com")

# 设值与默认初始化
user.setdefault("tags", []).append("developer")

# 批量更新合并(Python 3.9+ 支持 '|' 运算符)
user.update({"role": "superadmin", "status": "active"})
merged = user | {"ip": "127.0.0.1"}

# 字典推导式快速构建
squared_map = {x: x**2 for x in range(5)}
# {0: 0, 1: 1, 2: 4, 3: 9, 4: 16}
2. 键的可哈希要求(Hashability)
并不是所有对象都能作为字典的键。作为字典的键,对象必须满足两个条件:
- 在其生命周期内具有不变的哈希值(通过
__hash__()返回)。 - 可以与其他对象进行相等性比较(通过
__eq__()实现)。
不可变的基础类型(如字符串、整数、浮点数、纯不可变元素的元组)均可哈希;而列表、字典或集合等可变类型因内容可改,无法作为键。
四、集合(Set):唯一性检验与数学运算
集合使用花括号 {1, 2, 3} 声明,也可以通过内置函数 set() 构造。在底层机制上,集合可以视为一个“没有存储值的特殊字典”,其核心优势是天然保持元素的唯一性并具备高效的成员判定能力。
1. 集合创建注意项与元素增删
# 创建空集合的唯一正确语法(使用 {} 会被识别为字典)
empty_set = set()

# 从列表批量去重
raw_data = [1, 2, 2, 3, 4, 4, 5]
unique_data = set(raw_data) # {1, 2, 3, 4, 5}

# 元素增删操作
unique_data.add(6)          # 添加元素
unique_data.discard(99)     # 安全移除(若不存在不报错)
# unique_data.remove(99)    # 危险:若元素不存在会抛出 KeyError
2. 高效的集合代数运算
在对比多批次数据差异时,集合提供了直观的高性能操作符:
set_a = {1, 2, 3, 4}
set_b = {3, 4, 5, 6}

# 并集 (Union):合并两集合所有元素
print(set_a | set_b)        # {1, 2, 3, 4, 5, 6}

# 交集 (Intersection):获取公共元素
print(set_a & set_b)        # {3, 4}

# 差集 (Difference):保留在 A 但不在 B 中的元素
print(set_a - set_b)        # {1, 2}

# 对称差集 (Symmetric Difference):保留仅属于单侧的元素
print(set_a ^ set_b)        # {1, 2, 5, 6}
五、四大数据结构深度选型与决策决策指南
在实际工程场景中,选择恰当的数据结构能从根本上避免性能瓶颈和维护成本。下图提供了清晰的排查决策流程,帮助在不同场景下迅速选定最优解:
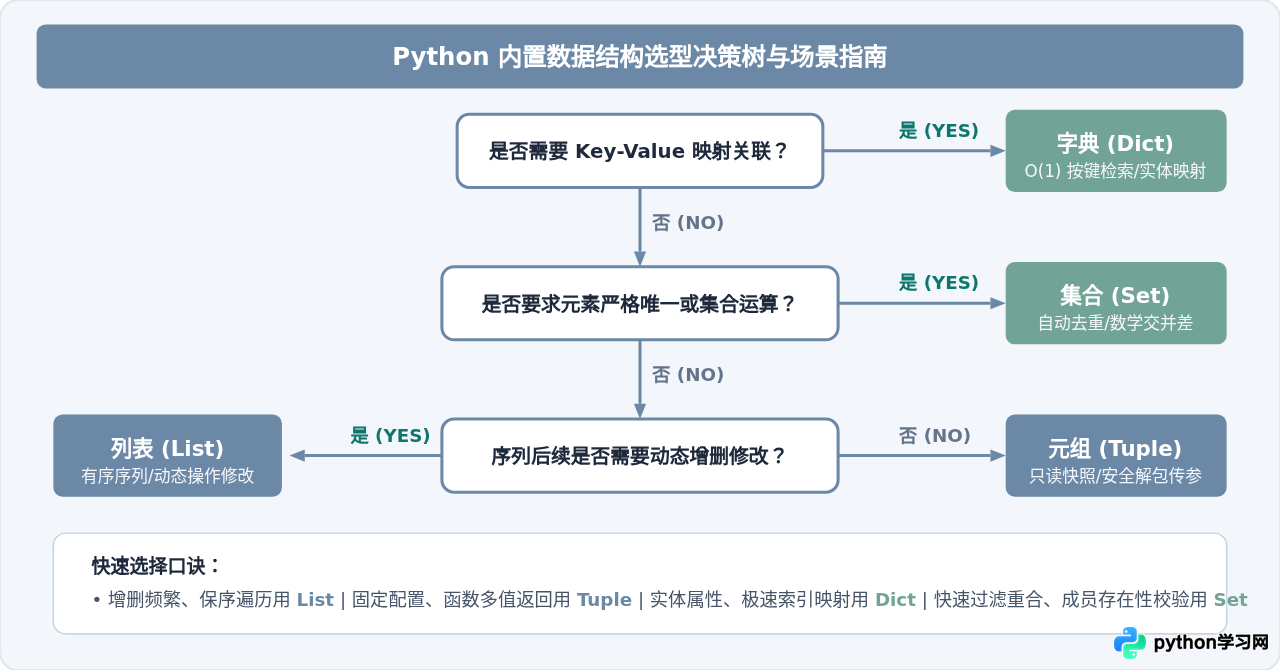
核心技术指标横向对比
| 数据结构 | 语法表示 | 有序性 | 可变性 | 元素唯一性 | 按值查找复杂度 | 典型应用场景 |
|---|---|---|---|---|---|---|
| 列表 (list) | [1, 2, 3] |
有序 | 可变 | 允许重复 | O(n) | 动态批处理、数据队列、排序集合 |
| 元组 (tuple) | (1, 2, 3) |
有序 | 不可变 | 允许重复 | O(n) | 多返回值、不可变配置、字典的键 |
| 字典 (dict) | {"k": "v"} |
有序 (3.7+) | 可变 | 键唯一 / 值可重 | O(1)(按键查找) | 对象实体建模、高频缓存、索引表 |
| 集合 (set) | {1, 2, 3} |
无序 | 可变 | 元素强制唯一 | O(1) | 数据去重、白名单过滤、集合交并差运算 |
六、高频陷阱与开发建议
-
不可将可变对象作为函数默认参数:
在 Python 中,函数的默认参数在函数定义时完成一次性求值。如果使用
def append_item(val, target=[]),后续的所有调用都将共享同一个列表实例。正确的做法是使用None作为占位符,并在函数体内动态判断:def append_item(val, target=None): if target is None: target = [] target.append(val) return target -
高频成员检测避免使用列表:
执行
if x in container时,列表需要从头至尾遍历整个序列,耗时为O(n);而集合与字典借助哈希散列,判定时间为常数级O(1)。面对海量数据的过滤场景,务必预先将候选池转化为集合。 -
循环遍历中直接修改容器长度的风险:
在遍历列表或字典的同时直接执行
pop()或del操作,会导致内部指针错位或抛出RuntimeError: dictionary changed size during iteration。修改时应遍历副本(如list[:]或list(d.keys())),或使用推导式生成全新容器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















