


数据科学项目选择Python版本的建议:兼顾库支持与性能
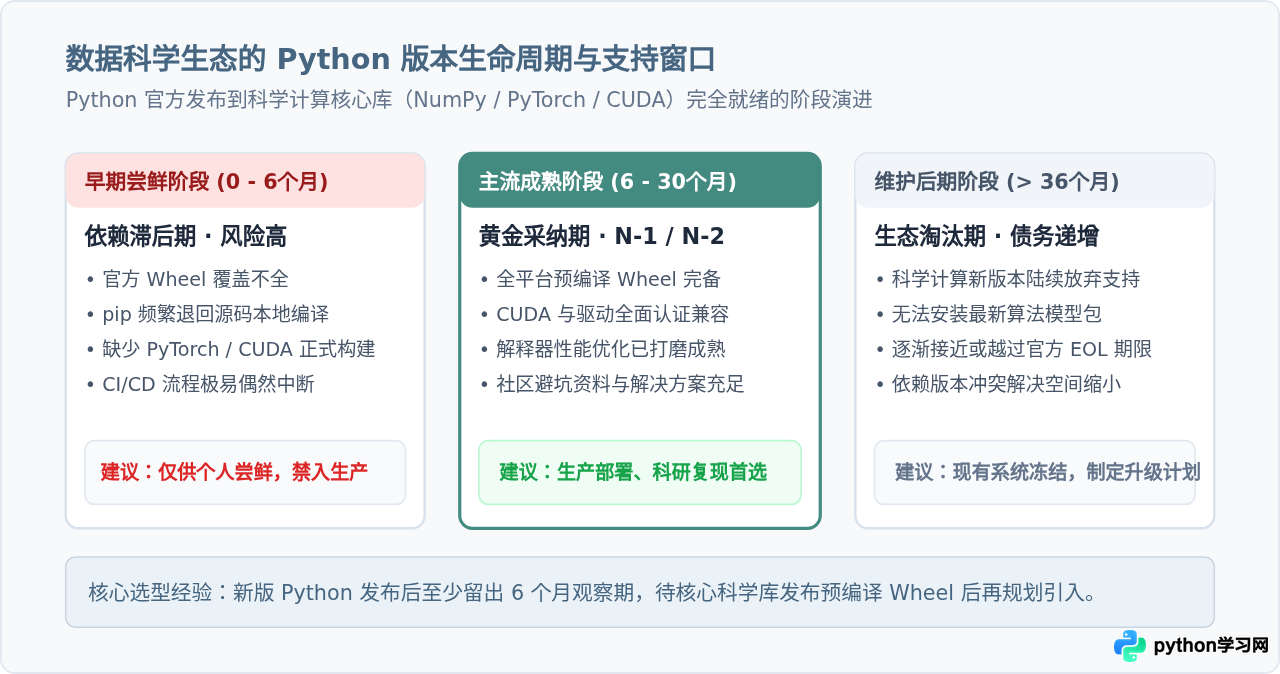
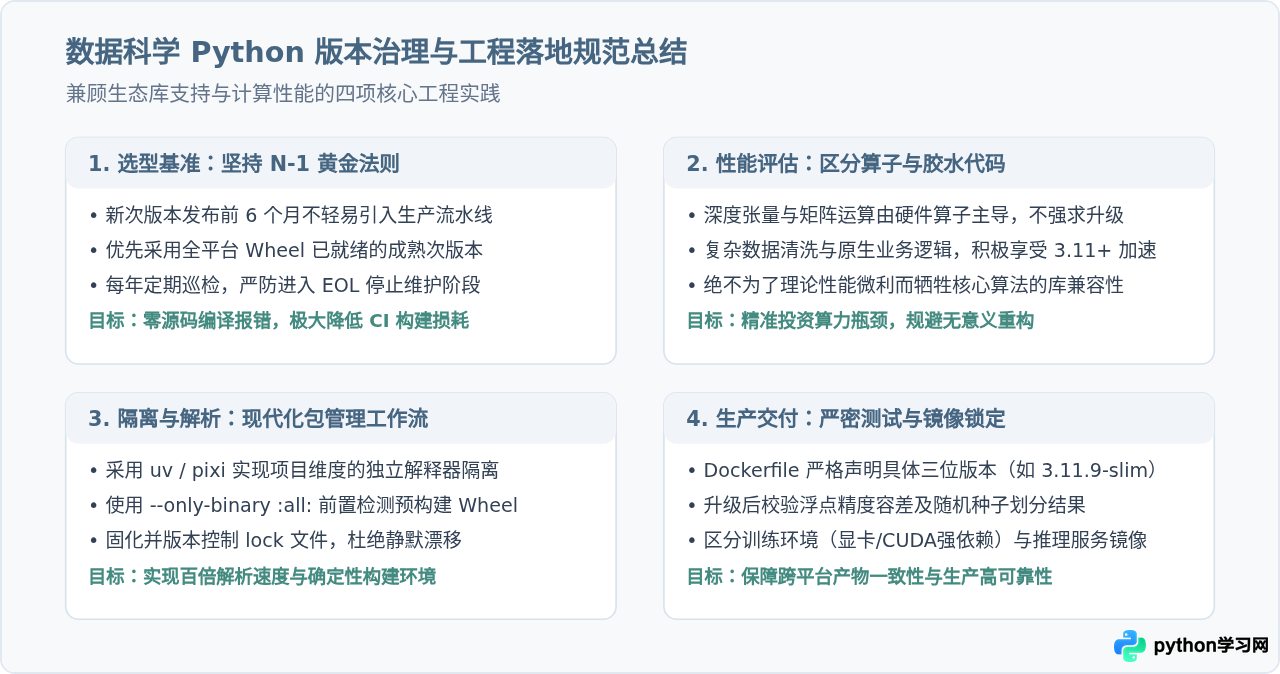
在搭建数据科学和机器学习工作环境时,选择 Python 版本的基准原则不是盲目追求最新发布的次版本,也不是无限期固守旧版本,而是在第三方核心库的预编译二进制包支持与解释器原生执行性能之间取得平衡。对于生产环境和科研协作,最稳健的选型策略是保持在当前最新次版本的后退一位或两位(即 N-1 或 N-2 原则)。这一策略既能避开新版本发布初期的依赖编译困境与底层算子缺失,又能充分享受解释器持续迭代带来的性能收益。
一、为什么数据科学项目不能直接追逐最新 Python 版本?
与纯 Web 开发或轻量脚本开发不同,现代数据科学的核心基石并非纯 Python 代码,而是一个高度依赖底层硬件加速的混合语言生态。NumPy、SciPy、Pandas、PyTorch、TensorFlow 等主流库的底层大量采用 C、C++、Fortran 以及 CUDA 编写,其在 Python 层面的易用性依赖于官方预先构建分发的二进制包(Wheel,遵循 PEP 513 / 600 等 manylinux 标准)。
当 Python 官方发布一个新的次版本(例如从 3.12 迈向 3.13)时,C-API 的微调以及内部数据结构的变动,意味着所有包含底层扩展模块的三方库都需要重新编译、适配并测试。这直接导致了新版本发布后必然存在的“生态滞后窗口”:
- 预编译 Wheel 缺失导致的编译失败: 如果 PyPI 上尚未发布针对该 Python 版本和当前操作系统的二进制 Wheel,
pip install会退回到源码构建模式(Source Distribution / sdist)。此时本地必须安装对应版本的 MSVC/GCC/Clang 编译器、BLAS/LAPACK 线性代数库以及匹配的 CUDA Toolkit,稍有环境不一致便会抛出冗长的编译报错。 - 硬件加速库与深度学习框架的适配节奏: 像 PyTorch、TensorFlow 以及 Triton 这类深度集成 GPU 硬件算子的框架,其构建矩阵极其庞大。框架团队往往需要数月时间来验证新解释器与不同 CUDA/ROCm 版本的协同工作,导致其对最新 Python 次版本的适配往往明显滞后于纯 Python 库。
二、Python 解释器性能优化:哪些场景能真正获益?
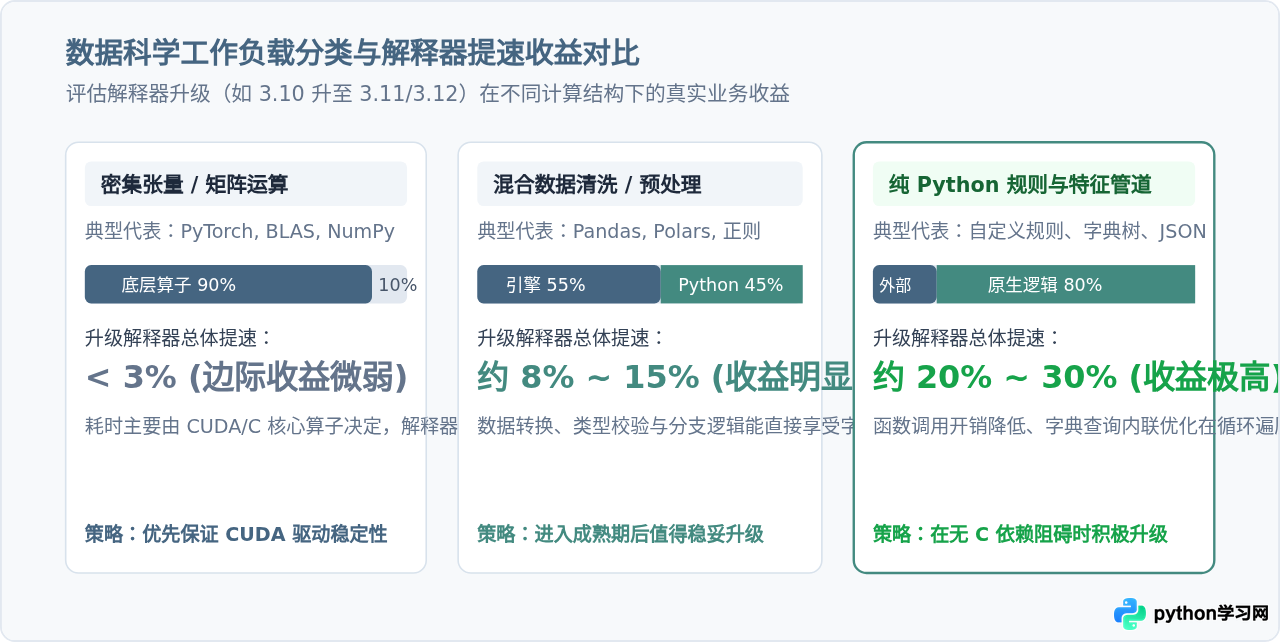
自 Python 3.11 启动“Faster CPython”项目以来,解释器在字节码特化(Specializing Adaptive Interpreter)、更轻量的帧栈、内存布局优化以及微指令管道方面取得了连续的性能提升。许多常规基准测试表明,Python 3.11 及后续版本较 3.10 具有 10% 到 25% 的综合运行提速。
然而,在评估是否为了性能而升级 Python 时,必须具体剖析数据科学任务的实际耗时分布:
- 高强度矩阵计算与模型训练(低收益场景): 当代码主要在执行
torch.matmul、np.linalg.solve或卷积神经网络前向反向传播时,90% 以上的 CPU/GPU 周期都消耗在底层的 OpenBLAS、MKL、cuBLAS 或 Tensor Core 硬件算子中。此时 Python 仅仅充当“任务调度指令的派发器”,升级 CPython 解释器对整体训练或推理耗时的影响通常低于 2% 到 4%。 - 数据清洗、管道转换与特征工程(中高收益场景): 如果任务包含大量的 Pandas 复杂聚合、逐行循环检查(如
apply配合自定义逻辑)、复杂 JSON 解析、字典查找及文本预处理,代码的大部分时间实际上是在执行原生 Python 虚拟机操作。在此类场景下,从 Python 3.10 升级至 3.11 或 3.12 能够直接带来 15% 到 30% 的显著加速。
三、数据科学项目版本选型决策路径
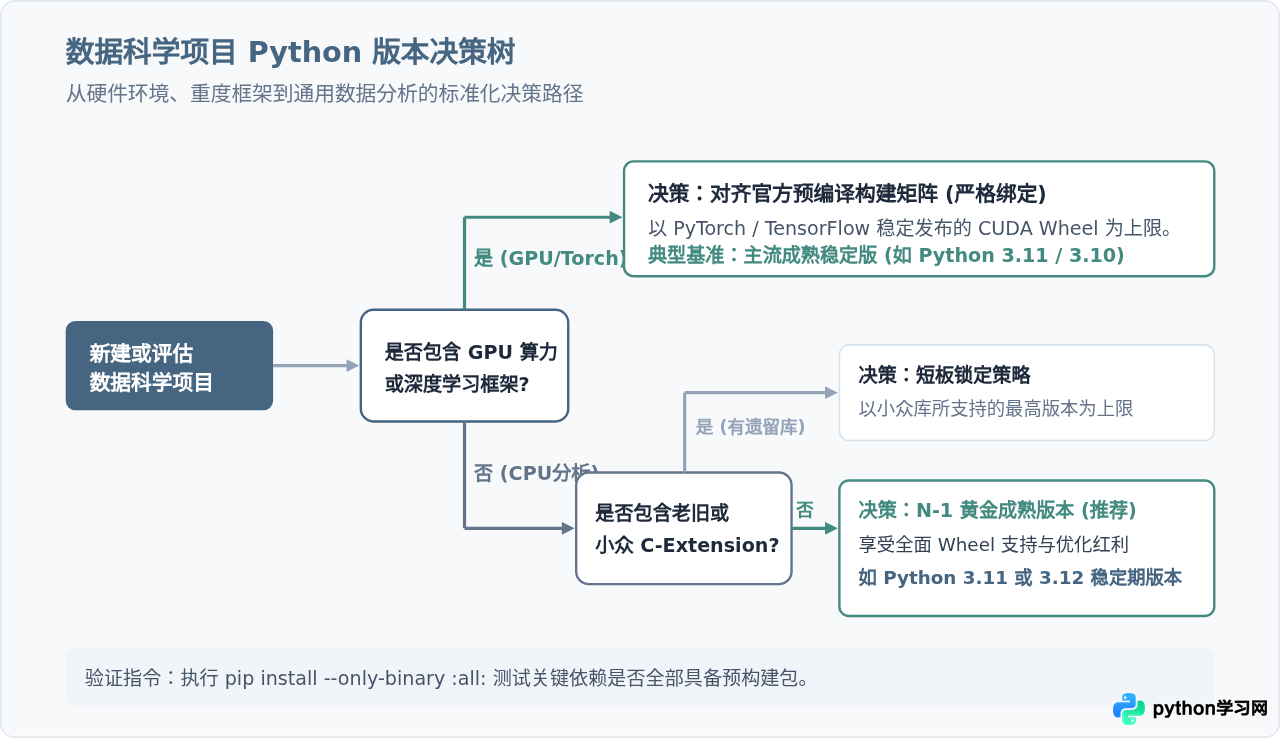
为帮助团队在项目立项或周期性依赖维护时做出客观决策,建议按照硬件约束、核心算法框架、周边依赖支持度三个层级依次推演:
核心原则: 永远由“最脆弱、构建难度最高”的依赖来决定 Python 版本的上限。如果项目中包含 PyTorch 与特定硬件加速库,那么应当以该框架官方稳定镜像或预编译 Wheel 支持的版本为准,切勿为了提升外围数据清洗的一点速度而导致核心算法无法调用 GPU。
四、工程落地:多版本隔离、验证与依赖固化实践
明确了目标版本后,必须通过现代化的环境管理工具将版本锁定,并在实际投产前进行严密的预构建包完整性校验与数值一致性测试。
1. 现代化多版本管理工具的选择
在过往实践中,频繁切换系统全局 Python 容易引发系统级工具损坏。现代数据科学项目推荐使用声明式的轻量级工具(如 uv)或同时接管非 Python 系统库的方案(如 pixi / conda):
- 针对以纯 Python 和常规 Wheel 构成为主的项目: 优先推荐使用
uv,它内置了快速下载和管理不同版本 Python 独立解释器的能力,且其解析器速度比传统 pip 快 10 到 100 倍。 - 针对深度绑定特定 CUDA 驱动与非 Python 共享库的项目: 推荐使用
pixi或conda,能够一并隔离 libc、CUDA runtime 和 OpenBLAS 动态链接库。
2. 实操步骤:以 uv 初始化并验证 Python 3.11 环境
# 步骤 1:下载并指定创建基于 Python 3.11 的虚拟环境(自动下载官方独立构建的 Python)
uv venv --python 3.11 .venv

# 步骤 2:激活隔离环境(macOS/Linux)
source .venv/bin/activate
# Windows 环境下请执行: .venv\Scripts\activate

# 步骤 3:强制仅允许安装预编译 Wheel,验证关键依赖是否存在可用二进制包
# 若缺少 wheel 则会直接报错中断,防止本地触发隐式 C 编译
uv pip install --only-binary :all: numpy pandas scikit-learn torch

# 步骤 4:生成精确锁定文件(提交至 Git 仓库以确保团队成员与 CI 环境一致)
uv pip compile pyproject.toml -o requirements.lock
3. 投产前结果一致性测试
跨 Python 版本升级(例如由 3.9 升级到 3.11)时,尽管代码语法保持兼容,仍需警惕潜在的底层数值变化:
- 浮点精度微调: 新版底层数学库(如新版 OpenBLAS/MKL)的指令集优化可能会导致极端情况下浮点数末几位产生微小偏差,对敏感的金融计算或特征打分需设置相对容差(如
np.isclose)校验。 - 随机种子与排序哈希: 升级后验证全局随机数生成器(Random Generator)产生的数据划分是否与旧版保持可复现性。
- 容器化镜像锁定: 在 Docker 交付时,严禁使用
python:3.11或python:latest,必须使用形如python:3.11.9-slim-bookworm的完整明确小版本,防止上游更新静默改动底层依赖。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















