


Python数据类型分为哪两大类:可变类型与不可变类型
深入解析Python数据类型的两大核心类别:可变类型与不可变类型。通过内存引用模型、代码对比与实际避坑指南,全面掌握两者的本质差异与应用场景。
在 Python 中,所有数据均以“对象”形式存在于内存中。根据对象创建后其内部存储的数据内容是否允许被就地修改,Python 的数据类型被划分为两大核心类别:不可变类型(Immutable Types)与可变类型(Mutable Types)。理解这一分类是掌握 Python 变量传参、内存优化以及规避逻辑隐患的基石。
一、核心分类:什么是可变与不可变类型
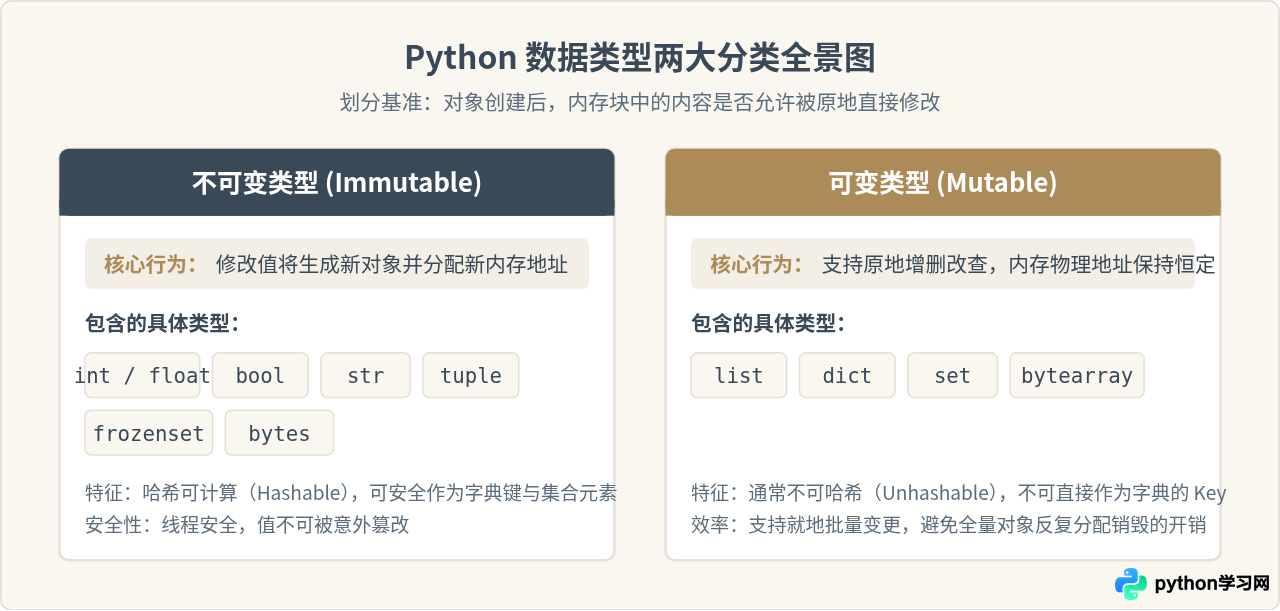
判断一个数据类型属于可变还是不可变,核心依据在于:当对其执行修改操作时,Python 是在原内存地址上就地更新内容,还是开辟新的内存空间生成一个全新的对象。
- 不可变类型(Immutable Types):数值类型(
int、float、bool、complex)、字符串(str)、元组(tuple)、不可变集合(frozenset)以及二进制序列(bytes)。一旦在内存中分配,其所占内存块中的值便终生固定。 - 可变类型(Mutable Types):列表(
list)、字典(dict)、集合(set)以及可变字节数组(bytearray)。这些类型的对象在内存中开辟空间后,其内部包含的元素或键值对可以被随时新增、修改或移除,而对象本身的内存物理标识保持不变。
二、底层机制:变量绑定与内存引用探秘
为了透彻理解这两大类别,我们需要借助 Python 内置函数 id()。在 CPython 实现中,id(obj) 返回的是对象在内存中的虚拟内存地址。
在 Python 中,变量名本质上是一个指针标签(Name Binding),它贴在具体的内存对象上。以下代码清晰展示了不可变对象与可变对象在面对操作时对内存地址的不同处理:
# 1. 验证不可变对象 (以 int 和 str 为例)
x = 100
print("x 初始地址:", id(x))

x += 1
print("x 加 1 后的地址:", id(x))  # 地址发生了改变,生成了新的整型对象 101

# 2. 验证可变对象 (以 list 为例)
items = [1, 2]
print("items 初始地址:", id(items))

items.append(3)
print("items 追加元素后的地址:", id(items))  # 地址完全相同,原对象被原地修改
输出示例(具体数值因运行环境而异):
x 初始地址: 4321980832
x 加 1 后的地址: 4321980864
items 初始地址: 4323602624
items 追加元素后的地址: 4323602624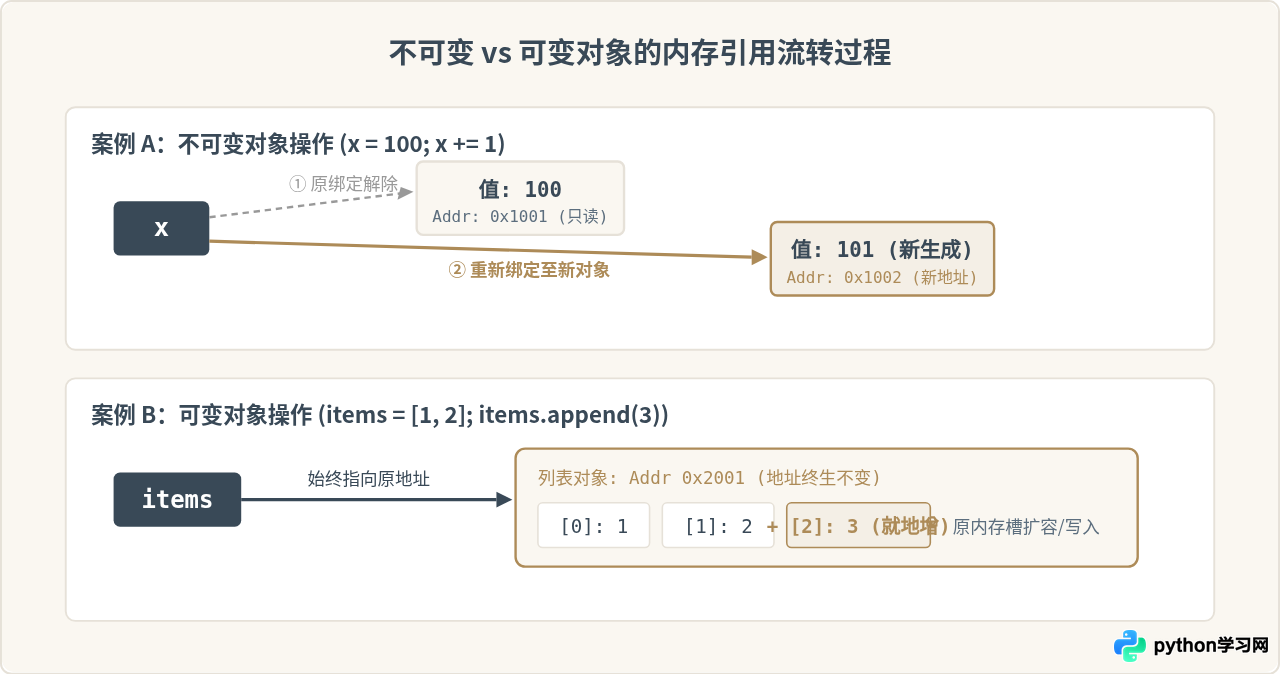
三、进阶辨析:不可变容器中的可变元素
初学者最容易产生误解的场景之一是“元组是不可变的,但为什么元组里的数据变了?”。
请牢记:不可变类型所维护的不可变性,仅严格约束该容器内存储的直接引用的内存地址(指针),而不约束被引用对象内部的状态。
# 创建一个包含列表的元组
mixed_tuple = (10, [20, 30])

print("元组地址:", id(mixed_tuple))
print("内部列表地址:", id(mixed_tuple[1]))

# 尝试替换整个列表会抛出 TypeError,因为元组的引用槽不可修改
# mixed_tuple[1] = [99, 99]  # TypeError: 'tuple' object does not support item assignment

# 但是对列表内部进行修改是完全合法的
mixed_tuple[1].append(40)
print("修改后的元组内容:", mixed_tuple)
print("内部列表地址:", id(mixed_tuple[1]))  # 列表自身地址未变,元组引用的指针并未改变
输出结果:
元组地址: 4323630272
内部列表地址: 4323602688
修改后的元组内容: (10, [20, 30, 40])
内部列表地址: 4323602688__hash__ 且具有不可变性)。若允许可变对象作为键,一旦修改其内容,计算出的哈希值与存储桶位置将发生漂移,导致数据无法检索。因此,dict 键必须为不可变对象。如果元组内部包含了可变对象(如上述 (10, [20, 30])),调用 hash(mixed_tuple) 同样会报错 TypeError: unhashable type: 'list'。
四、工程避坑:可变对象引发的两大高频 Bug
在实际 Python 开发中,忽视可变类型的就地修改特性会导致严重的隐式逻辑漏洞。以下是最典型的两大陷阱及修复方案。
1. 函数默认参数使用可变对象(陷阱之王)
在 Python 中,def 语句是可执行代码。函数的默认参数是在模块加载(即函数定义时)进行求值与绑定的,而不是在每次调用时重新创建。
# 错误示例:默认参数定义为可变列表
def collect_data(item, cache=[]):
    cache.append(item)
    return cache

print(collect_data("A"))  # 输出: ['A']
print(collect_data("B"))  # 读者预期是 ['B'],但实际输出: ['A', 'B']!跨调用污染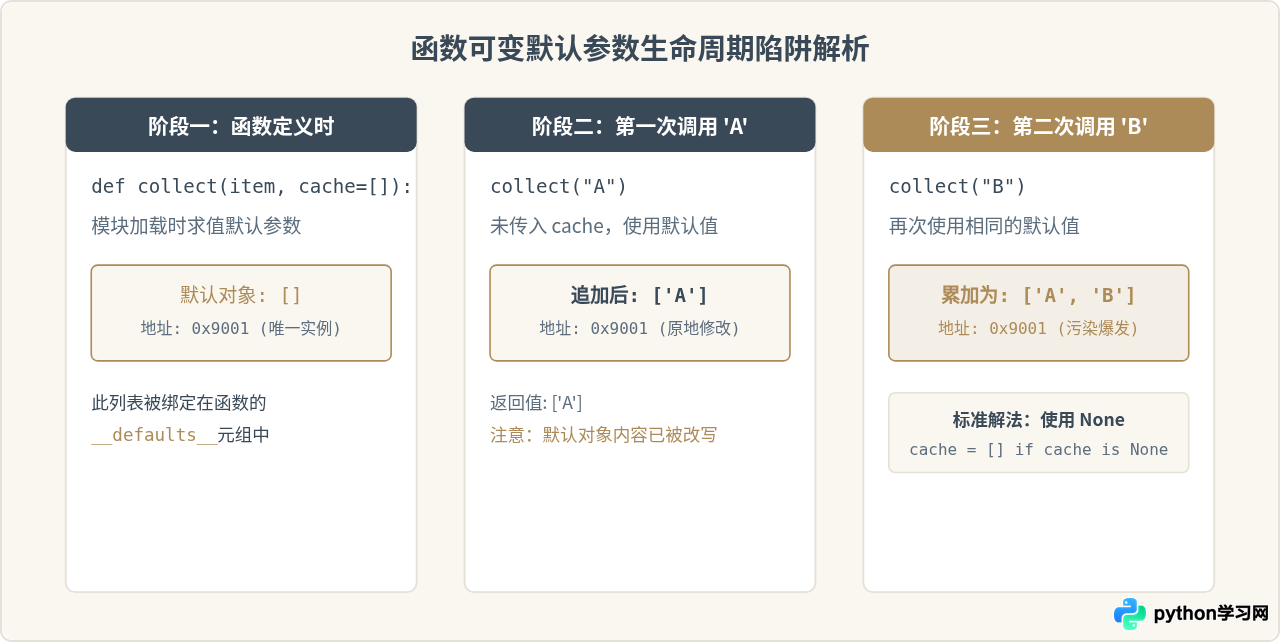
工程标准规范解法:使用不可变对象 None 作为占位符,并在函数体内部进行惰性初始化:
def collect_data_safe(item, cache=None):
    if cache is None:
        cache = []  # 每次调用独立创建全新的局部列表对象
    cache.append(item)
    return cache
2. 引用赋值与深浅拷贝混淆
对可变对象使用简单的 = 赋值并不会复制数据,仅仅是创建了指向同一内存对象的新别名;若要复制,必须使用 copy() 或深拷贝 deepcopy()。
import copy

origin = [[1, 2], [3, 4]]
alias = origin           # 别名引用:完全指向同一地址
shallow = origin.copy()  # 浅拷贝:外层新建,内层列表仍然共用引用
deep = copy.deepcopy(origin)  # 深拷贝:内外层完全递归新建

origin[0].append(999)

print("alias:", alias[0])      # [1, 2, 999] (受影响)
print("shallow:", shallow[0])  # [1, 2, 999] (内层可变对象受影响)
print("deep:", deep[0])        # [1, 2] (完全独立,不受任何影响)
五、总结与选型指南
为了在日常工程架构中做出准确的技术选型,可参考下方的核心特性对比矩阵:
| 对比维度 | 不可变类型 (Immutable) | 可变类型 (Mutable) |
|---|---|---|
| 核心成员 | int, float, bool, str, tuple, frozenset, bytes |
list, dict, set, bytearray |
| 修改操作 | 开辟新内存生成新对象,原对象不变 | 在原内存地址上就地修改内容 |
| 哈希性 (Hashable) | 支持(只要内部元素均可哈希) | 通常不支持(抛出 TypeError) |
| 可作字典键/集合元素 | 是(完全合法且高效) | 否 |
| 内存与性能特点 | 常量池小整数/短字符串缓存,高并发读安全 | 高频动态追加、修改性能优越,无重复分配开销 |
| 工程选型指导 | 用于状态配置、函数入参防篡改、哈希映射键 | 用于批处理集合、累加器、动态状态字典 |
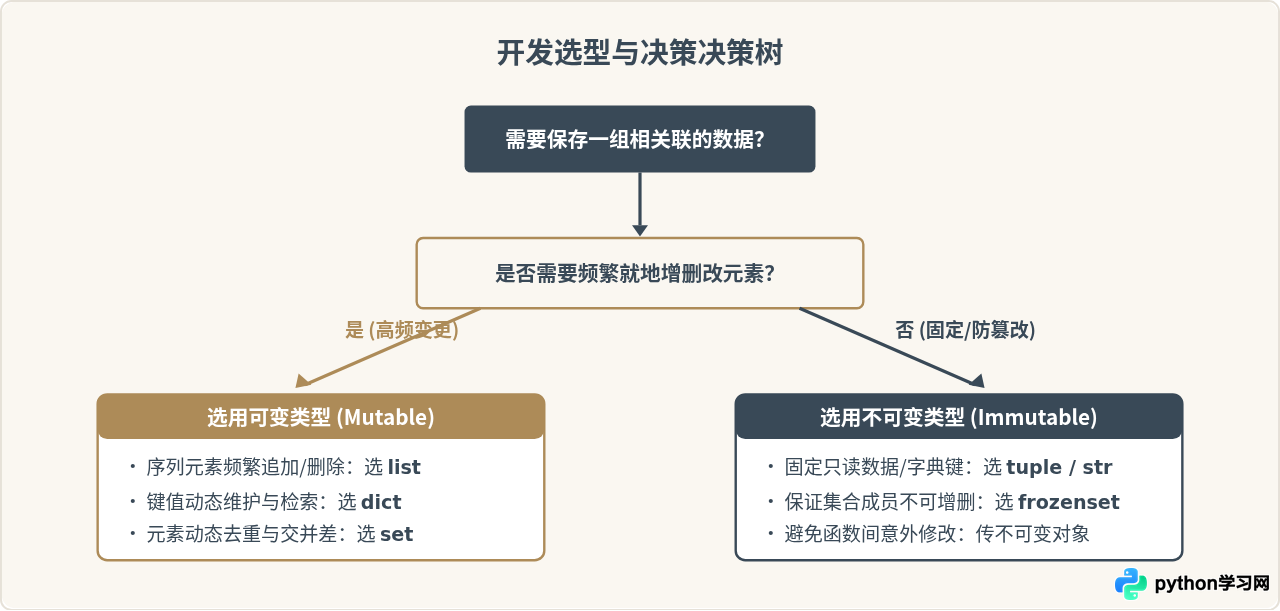
总结而言,区分可变与不可变类型的关键,在于看清变量名与底层内存对象之间是指针的重定向还是原地的状态重塑。在编写代码时,优先采用不可变类型能够增强代码的防篡改性与安全性;在涉及频繁变动的数据集时,合理借助可变类型的高性能就地修改能力,同时规范使用深浅拷贝与默认参数,就能在保证程序正确性的同时写出优雅高效的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















