


Python三引号是注释还是字符串
深入解析Python三引号的语法本质,对比其与井号注释的区别,详解Docstring文档字符串的运行机制与字节码表现,提供规范的工程编码建议。
核心结论:在 Python 官方语法定义中,三引号(''' 或 """)在语法上始终是多行字符串字面量(String Literal),而不是注释。Python 中唯一的真正注释语法是井号(#)。三引号之所以常被误认为“多行注释”,是因为未赋值的三引号字符串在独立成行时不会产生可观测的副作用,并且在函数或类首部会被解释器提取为文档字符串(Docstring)。
一、为什么会有“三引号是多行注释”的误解
许多初学者在接触 Python 时,常听人说“单行注释用 #,多行注释用三引号”。这种说法在编程教学中流传甚广,主要是因为 Python 语法本身没有像 C/Java 的 /* ... */ 那样专门的多行注释符号。
当开发者需要在代码中临时屏蔽多行代码,或者编写较长的文字说明时,随手用三对单引号或双引号包裹起来,程序运行确实不会报错,也不会输出这段文字。从表面效果来看,它确实起到了“注释”的作用。然而,从 Python 解释器的底层语法规范来看,两者的运行机制完全不同。
二、从解释器内部看:词法分析与 AST 的分水岭
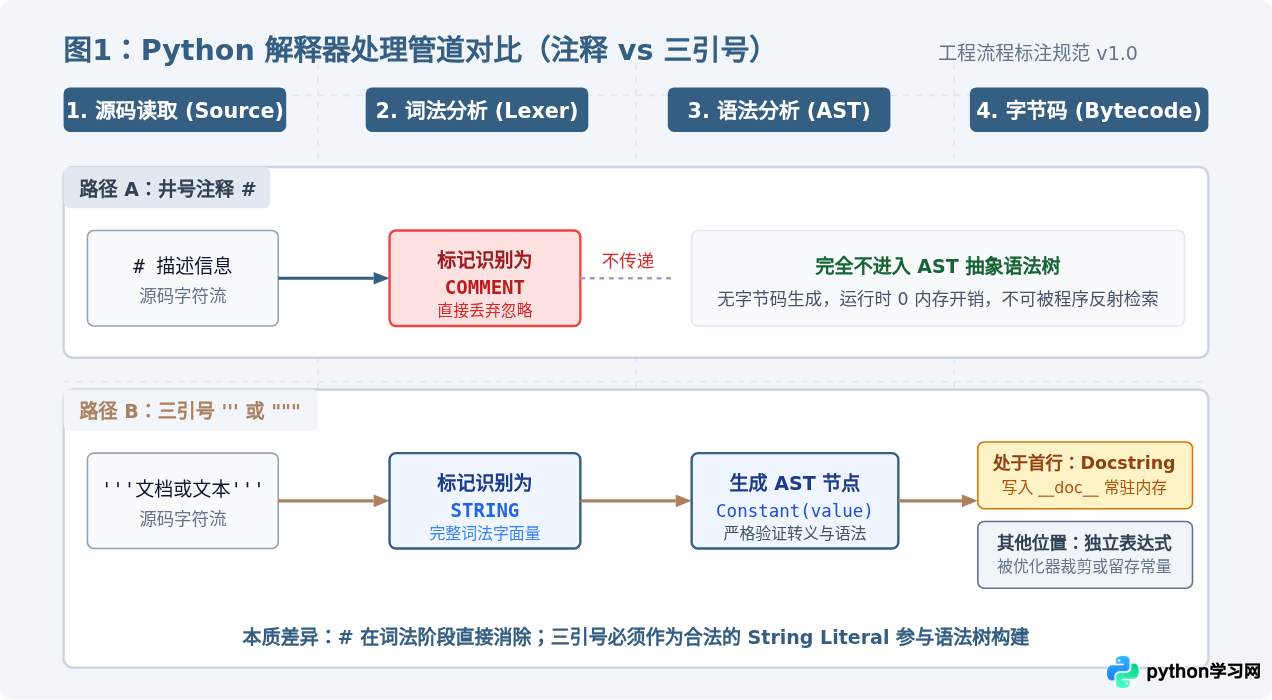
要真正搞清楚两者的区别,需要看 Python 是如何把源码翻译成机器可执行指令的:
- 词法分析(Tokenizing):当解释器逐字符扫描代码时,遇到
#会将整行后续内容打上COMMENT标记。在进入语法分析之前,所有的COMMENT标记都会被直接过滤抛弃,不会参与后续任何语意解析。 - 语法分析与抽象语法树(AST Parsing):三引号由连续的三个单引号
'''或双引号"""构成,词法分析器将其识别为多行字符串字面量(STRINGToken)。它必须进入语法解析器,并构建为一个表达式语句节点(Expr(value=Constant(value='...')))。
这意味着:写在三引号里的内容必须符合 Python 字符串语法规则。如果你在三引号字符串中写了不合法的反斜杠转义,或者引号未闭合,解释器会在编译期直接抛出 SyntaxError。而写在 # 注释里的任何内容,哪怕是语法完全崩坏的伪代码或未闭合符号,解释器都视而不见。
三、三引号在 Python 中的三种真实角色
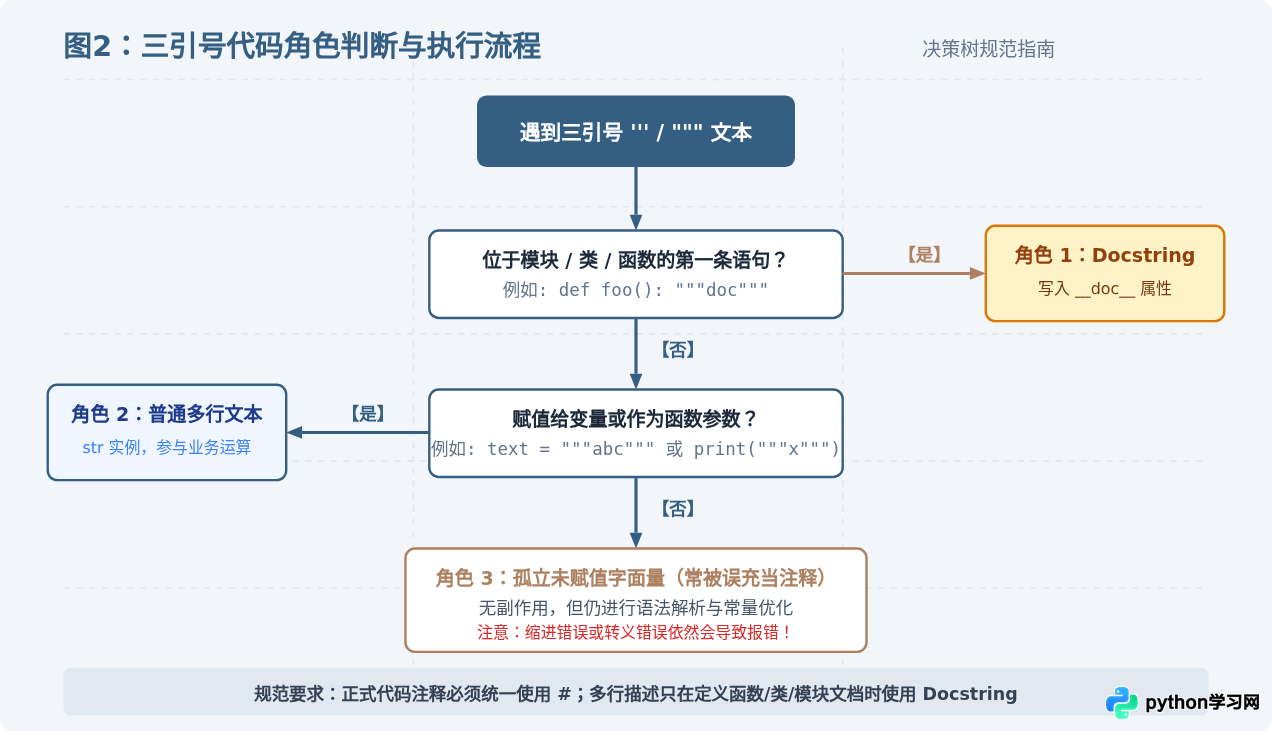
在实际代码中,三引号字符串会根据其所处的上下文位置,被 Python 解释器赋予三种完全不同的身份。我们可以通过以下决策流程进行准确判断:
1. 文档字符串(Docstring)
当三引号字符串紧跟在 def、class 或模块最开头时,Python 解释器会做特殊处理:它不仅将其识别为一个常量字符串,还会自动将其绑定到该对象的 __doc__ 特殊属性中。
def calculate_tax(amount: float) -> float:
    """计算指定金额的含税总额。

    参数:
        amount: 未税金额
    返回:
        含税总额
    """
    return round(amount * 1.13, 2)

# 在代码运行期可通过属性直接访问
print(calculate_tax.__doc__)
文档字符串具有可反射性,能够被内置函数 help()、IDE 智能提示工具以及 Sphinx 等文档生成器读取。这是 Python 官方专为“自解释代码与接口文档”设计的语言特性,绝非普通注释。
2. 普通多行字符串(Multiline String)
如果三引号字符串被赋值给一个变量,或者作为实参传递给函数,它就是一个标准的 str 对象,支持所有的字符串方法(如 .strip()、.replace()):
query_sql = """
    SELECT user_id, username, email
    FROM app_users
    WHERE status = 'ACTIVE'
    ORDER BY created_at DESC;
    """
print(type(query_sql))  # 输出: <class 'str'>
3. 孤立未赋值的表达式语句(Expression Statement)
当三引号字符串出现在函数体内部某处,既不是首行文档,也没有赋值给任何变量时,它在语法树中被归类为一个独立的“表达式语句”:
def process_data(items):
    validated = []

    """
    这里是一段临时说明:
    下面的循环仅做初步清洗,排除了空值。
    """
    for item in items:
        if item is not None:
            validated.append(item)
return validated在这个场景中,解释器创建了这个字符串常量,但由于没有对它执行任何操作,它不产生任何副作用。许多人因此误以为“这就是多行注释”。但必须明确:这只是“未被使用的字面量”,并不是语言规范中的注释语法。
四、通过字节码验证三引号的行为
要彻底看清两者的差异,最直观的方法是使用 Python 内置的 dis 模块来查看编译生成的字节码指令。我们在命令行或脚本中对比以下两个函数的反汇编结果:
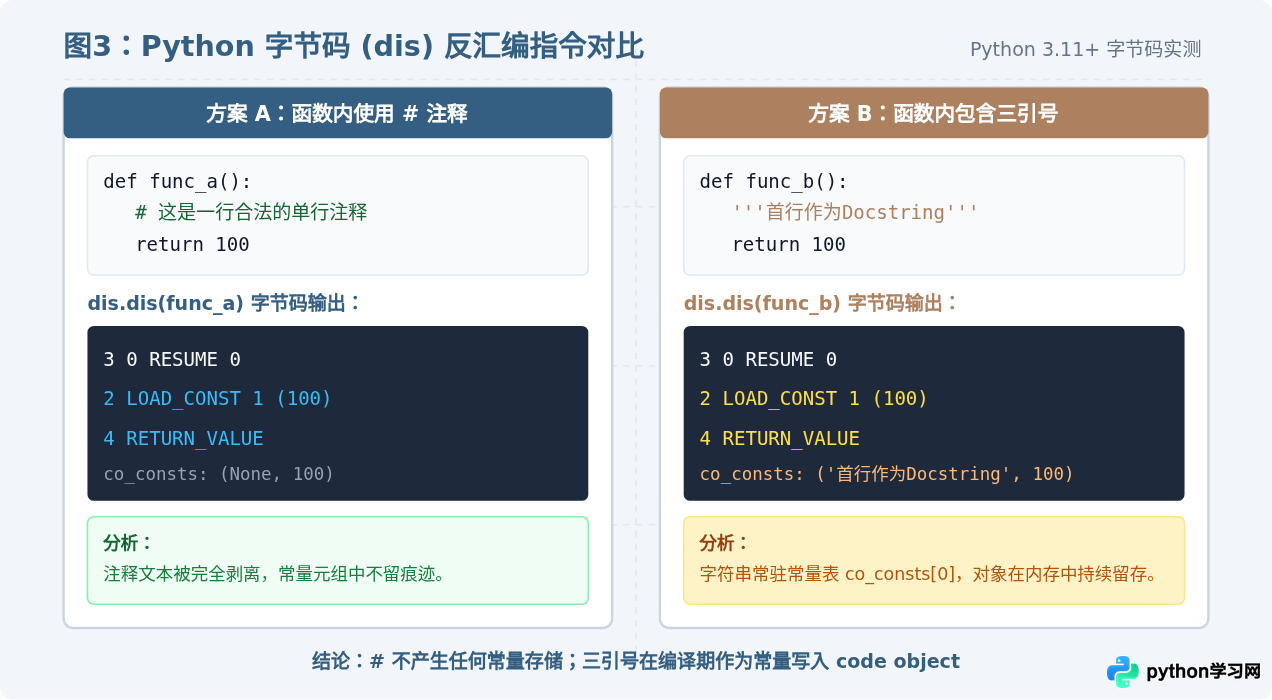
从字节码结果可以清晰地看到:
- 在
func_a中,井号注释在编译后完全消失,代码对象的常量元组__code__.co_consts仅包含默认返回值与实际数值。 - 在
func_b中,首部的三引号字符串被确切地记录在函数代码对象的co_consts[0]中,并与func_b.__doc__关联,伴随整个程序生命周期常驻内存。
五、将三引号当“多行注释”的潜在隐患
如果在日常编写业务逻辑时,习惯把三引号当成多行注释来用,可能会引发以下几种意外问题:
井号注释 # 可以放在一行的任何位置,甚至顶格写,解释器都不关心缩进。但独立的三引号字符串是一个语句(Statement),它必须遵循当前代码块的缩进级别!如果在需要缩进的 if 或 for 块内顶格写三引号,会立刻抛出 IndentationError。
# 错误示例:三引号缩进错误导致语法崩溃
def validate_token(token):
    if not token:
"""
这里试图用顶格三引号解释为什么拒绝空值
"""
        return False
    return True
# 运行报错: IndentationError: unexpected indent如果你在三引号中屏蔽了一段包含正则表达式或文件路径(如 Windows 路径 C:\new_folder\test)的代码,未转义的反斜杠 \ 会被解释器作为转义符解析。在 Python 3.8+ 之后,非法的反斜杠序列会触发 SyntaxWarning,在严格模式下甚至会直接抛出语法错误。
如果你在函数定义之后想写一段多行注释说明内部临时逻辑,由于写在了第一行,它会被直接当成该函数的对外公开文档 __doc__。调用 help(func) 或 IDE 悬停提示时,内部临时笔记就会被暴露出来,污染接口元数据。
六、三种标注方式的特性对比与工程实践
为了让项目代码整洁、安全且符合 PEP 8 规范,我们对 Python 中的三种文本与注释形式进行归纳对比:
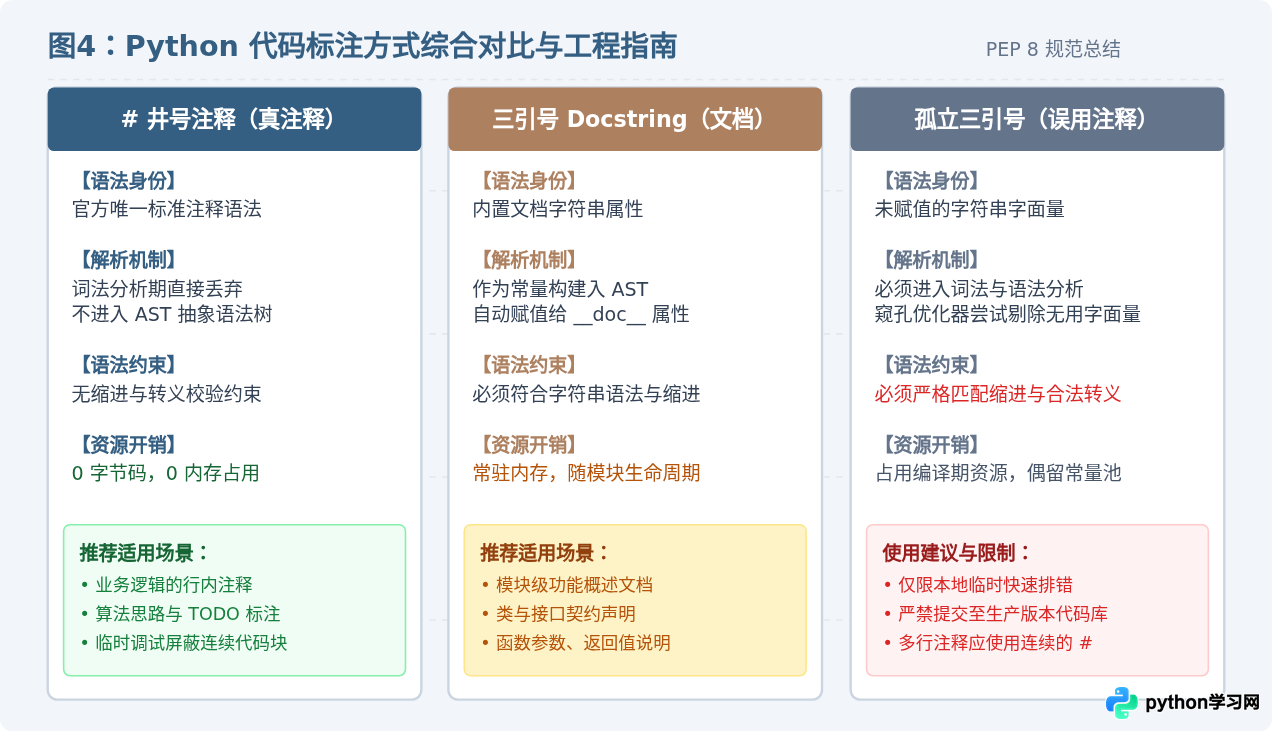
根据 Python 官方的 PEP 8 代码风格指南:
- 真正的多行注释规范:当需要书写长篇逻辑说明或多行注释时,推荐的做法是在每一行开头都使用一个
#符号和单个空格进行缩进对齐,而不是偷懒使用三引号包裹。主流 IDE(如 VS Code、PyCharm)均支持Ctrl + /或Cmd + /一键注释/反注释多行代码。 - 文档必须使用 Docstring:所有公开的模块、函数、类和方法都应该编写规范的三引号文档字符串,说明其入参含义、返回类型及可能抛出的异常。
- 多行文本常量:对于 SQL 语句、长 HTML 模板、格式化邮件内容等长文本,优先使用赋值给变量的三引号字符串,并搭配
textwrap.dedent()清理多余的前导空格。
总结一句话:Python 三引号始终是字符串字面量;井号 # 才是 Python 官方唯一的注释语法。理解这一本质差异,能帮助你在排查语法错误、编写规范接口文档以及优化字节码性能时保持思路清晰。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















