


Python轻量级数据库框架推荐:适合小型项目与脚本的ORM工具
针对Python小型项目、自动化脚本与微型服务,精选推荐Peewee、TinyDB与原生sqlite3等轻量级数据库工具,深入对比核心架构、操作示例与选型边界。
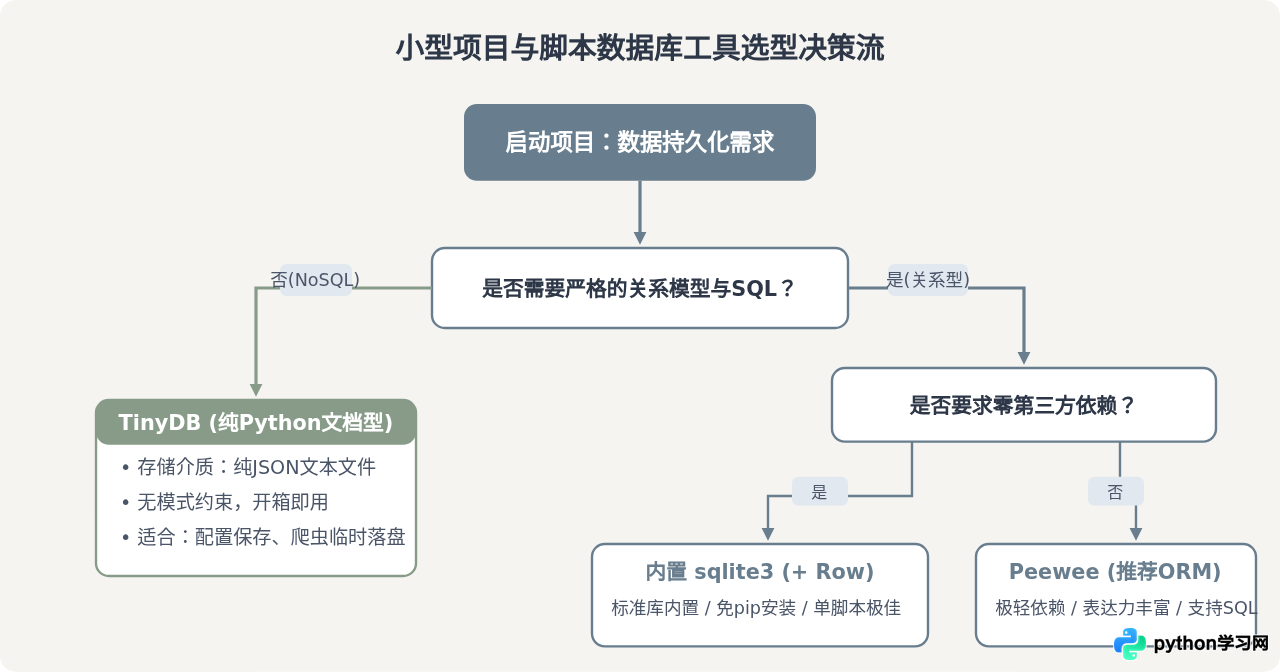
对于自动化脚本、中小型数据处理工具或微型Web服务,引入重量级ORM框架往往伴随着复杂的环境配置与沉重的心智负担。本文聚焦于解决轻量场景下的数据持久化问题,核心推荐Peewee、TinyDB以及标准库sqlite3三款工具,通过具体的语法示例、关键机制对比与选型决策路径,帮助开发者在无需臃肿依赖的前提下完成可靠的数据存取。
一、为什么小型项目与脚本需要轻量级工具
在大型企业级应用中,SQLAlchemy或Django ORM等重型框架是标准配备。然而在小型项目、CLI命令行脚本、定时爬虫或轻量级微服务中,这些重量级工具的优势往往会转变为阻碍:
- 样板代码与认知负担繁重:定义Engine、Session生命周期、ScopedSession、Unit of Work模型等机制,仅建立可用环境就需要数十行代码。
- 调试阻抗与间接层过厚:重型ORM为了兼容复杂事务与高级映射,堆叠了深厚的抽象层。当SQL执行发生细微偏差时,定位底层问题耗费大量时间。
- 依赖链与分发限制:利用PyInstaller或Docker对脚本打包时,大型依赖会显著增加体积与构建耗时。
因此,小型任务所寻求的“轻量”,核心在于:单文件可运行、直观的数据映射、快速的CRUD能力以及极低的学习维护成本。
二、首选关系型轻量ORM:Peewee
Peewee是一个小巧而表达力出色的Python ORM框架,核心代码结构非常紧凑,却完整支持SQLite、MySQL、PostgreSQL与CockroachDB。其API设计理念与Django ORM类似,学习曲线极其平缓。
1. 核心模型定义与数据库绑定
使用Peewee仅需定义一个基础Model并声明字段,即可完成映射:
from peewee import SqliteDatabase, Model, CharField, IntegerField, DateTimeField
import datetime

# 1. 建立轻量级数据库连接(支持本地文件)
db = SqliteDatabase('app_tasks.db')

# 2. 基础模型基类
class BaseModel(Model):
    class Meta:
        database = db

# 3. 业务模型定义
class TaskItem(BaseModel):
    title = CharField(max_length=120)
    priority = IntegerField(default=1)
    created_at = DateTimeField(default=datetime.datetime.now)

# 4. 自动创建数据表(安全操作:已存在时不重复创建)
db.connect()
db.create_tables([TaskItem], safe=True)
2. 常见增删改查(CRUD)操作
Peewee的语法直观明了,不需要处理复杂的会话提交或回滚样板:
# 插入记录
task = TaskItem.create(title="清理缓存日志", priority=2)

# 条件查询与遍历
pending_tasks = TaskItem.select().where(TaskItem.priority >= 2).order_by(TaskItem.created_at.desc())
for item in pending_tasks:
    print(f"[{item.id}] {item.title} (优先级: {item.priority})")

# 更新数据
TaskItem.update(priority=3).where(TaskItem.id == task.id).execute()

# 删除记录
TaskItem.delete().where(TaskItem.id == task.id).execute()

# 脚本结束时显式释放连接
db.close()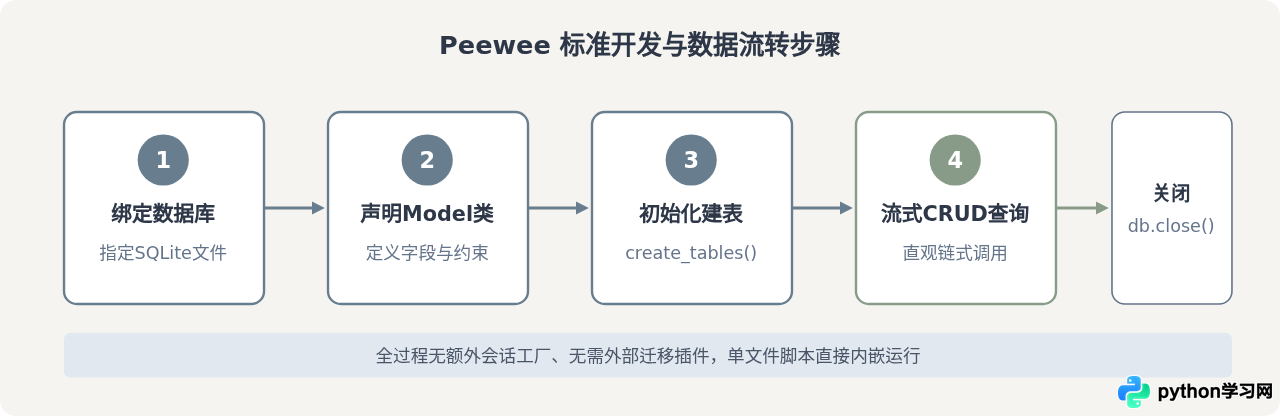
三、无需SQL的文档型存储:TinyDB
如果项目不需要严格的关系约束与表关联(例如爬虫采集抓取、用户个人设置存储、小规模离线分析),TinyDB是极其理想的轻量选择。它是纯Python编写的面向文档型数据库,原生以人类可读的JSON文件持久化。
1. TinyDB 快速上手
from tinydb import TinyDB, Query

# 初始化数据库(文件不存在则自动创建)
db = TinyDB('user_config.json')

# 插入结构化字典记录
db.insert({'name': 'alice', 'role': 'admin', 'login_count': 12})
db.insert({'name': 'bob', 'role': 'editor', 'login_count': 5})

# 构建查询逻辑
User = Query()
admin_users = db.search(User.role == 'admin')
print("管理员用户:", admin_users)

# 更新记录
db.update({'login_count': 13}, User.name == 'alice')

# 条件删除
db.remove(User.login_count < 10)四、架构层次与运作机制对比
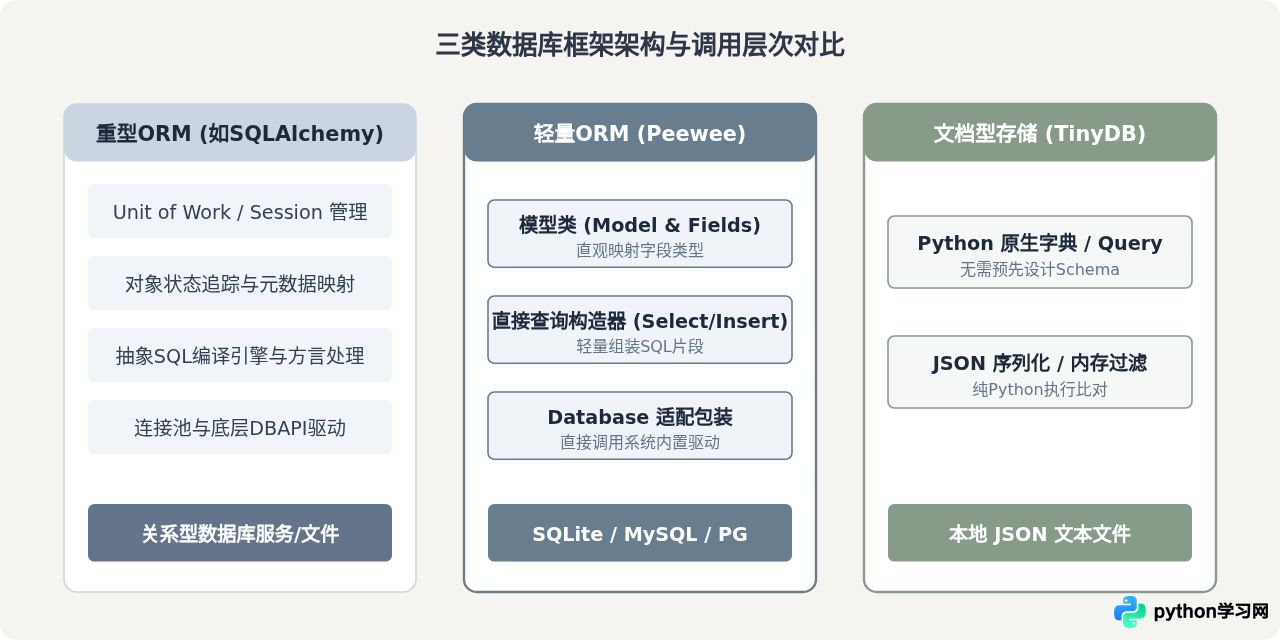
为了理解为什么不同工具在轻量级场景下体验差异巨大,我们需要观察它们与底层物理介质之间的交互层次:
五、零依赖兜底方案:标准库 sqlite3 的进阶轻量用法
如果项目受到严格的部署限制,完全不能使用 pip install 引入任何外部第三方包,Python内置的 sqlite3 模块是可靠的基石。很多开发者排斥原生 sqlite3 是因为默认返回的元组不易阅读,其实只需设置 row_factory,即可获得类字典访问体验:
import sqlite3

# 连接数据库并开启自动字典映射
conn = sqlite3.connect('local_store.db')
conn.row_factory = sqlite3.Row
cursor = conn.cursor()

# 创建表
cursor.execute('''
    CREATE TABLE IF NOT EXISTS notes (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        content TEXT NOT NULL,
        is_archived INTEGER DEFAULT 0
    )
''')

# 插入数据
cursor.execute('INSERT INTO notes (content) VALUES (?)', ('记录今日待办事项',))
conn.commit()

# 按字段名访问查询结果
cursor.execute('SELECT id, content, is_archived FROM notes WHERE is_archived = 0')
for row in cursor.fetchall():
    print(f"ID: {row['id']} -> 内容: {row['content']}")

conn.close()
这种做法既保持了标准库零外部依赖的优势,又显著降低了解析多列元组的繁琐程度。
六、选型总结与落地对比
为了帮助你在具体编码时快速做出取舍,以下将关键工具的属性与边界整理如下:
| 工具名称 | 依赖类型 | 存储底层 | 数据模式 (Schema) | 适合项目规模 |
|---|---|---|---|---|
| Peewee | 轻量第三方库 | SQLite / MySQL / PG | 静态严格定义 | 微型Web应用、自动化运维工具、多表关联分析 |
| TinyDB | 纯Python无C扩展 | 本地 JSON 文件 | 动态无模式 (NoSQL) | 小脚本状态记录、本地CLI配置、爬虫抓取落盘 |
| 内置 sqlite3 | 标准库零依赖 | SQLite 引擎文件 | 原生 SQL 表 | 受限生产环境脚本、PyInstaller高压缩打包分发 |
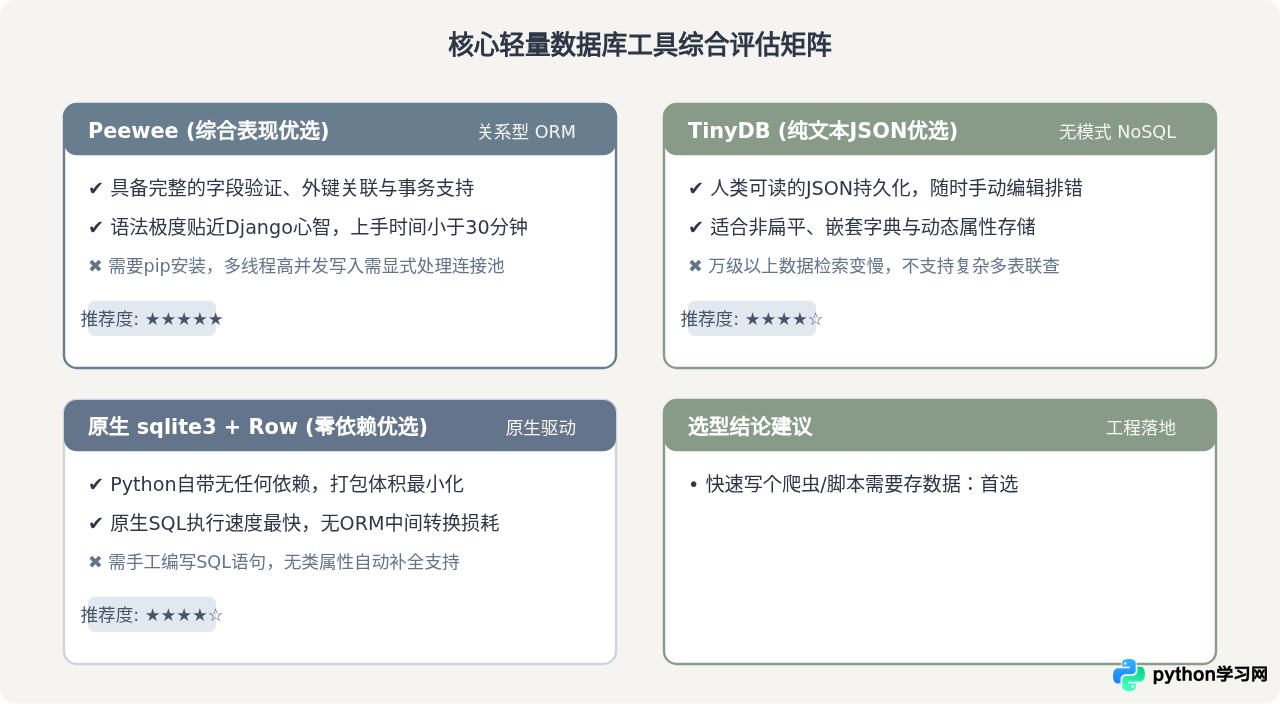
在工程实践中,选择数据库工具的核心依据是数据形态、依赖约束与长期维护成本。针对个人小项目与自动化脚本,无需一开始就引入复杂的ORM生命周期控制;合理使用Peewee或TinyDB,既能保持代码清爽直观,也能在业务需要扩充时保证良好的平滑迁移能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















