


Python生成不重复随机数列表的方法
介绍在Python中生成不重复随机数列表的几种常用且可靠的方法,详细解析random.sample、洗牌算法以及处理海量数据时的场景选择与避坑指南。
在Python中生成不重复随机数列表,最直接且推荐的标准做法是使用标准库内置的 random.sample() 函数。本文将详细讲解这一核心方案的运作逻辑、代码写法,并深入剖析基于洗牌算法(random.shuffle)、集合累加法以及NumPy扩展方案在不同规模和场景下的选择标准与注意事项。
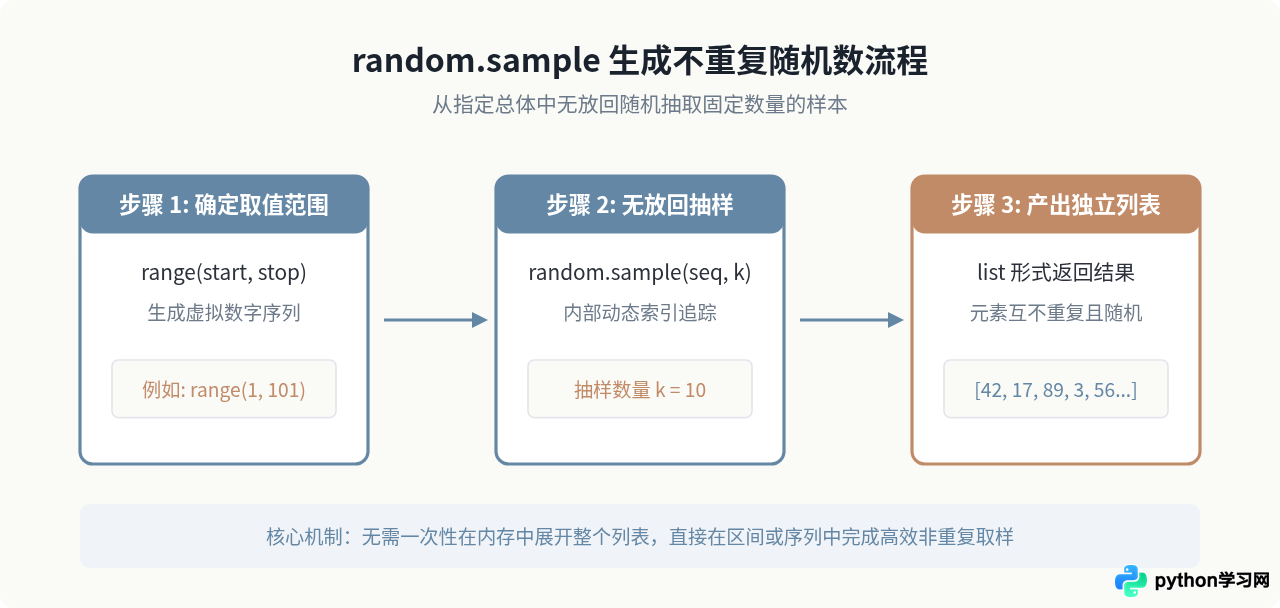
方法一:使用标准库 random.sample(推荐首选)
在绝大多数业务开发与数据处理中,random.sample() 是最优雅且性能最平衡的方案。该函数属于无放回随机抽样,天生能够保证抽取到的元素互不相同。
1. 基本语法与调用示例
假设我们需要在 1 到 100 之间随机抽取 10 个互不相同的整数,直接结合 range() 对象即可完成:
import random

# 在 [1, 100] 区间内无放回抽取 10 个整数
result = random.sample(range(1, 101), 10)

print(result)
示例输出:
[47, 12, 85, 3, 91, 28, 64, 19, 73, 55]2. 原理与内存优势
在 Python 3 中,range(1, 101) 是一个惰性计算的序列对象,不会预先在内存中分配包含 100 个整数的真实列表。random.sample() 会直接基于 range 对象的索引进行计算,在内部通过追踪已抽取位置的方式保证不重复。这意味着即使是从 range(1, 100000000) 中抽取 20 个数,也仅占用极微小的内存空间。
k 超过了候选池的总元素个数,random.sample() 会直接抛出 ValueError: Sample larger than population or is negative。因此在调用前需确保 k <= len(population)。
方法二:使用洗牌算法 random.shuffle(适合全量重排)
如果目标不仅是获取若干不重复数字,而是需要将某个连续区间的所有数字全部打乱并按序取出,或者数据源本身就是一个既有列表,采用原地洗牌算法 random.shuffle() 会更为直观。
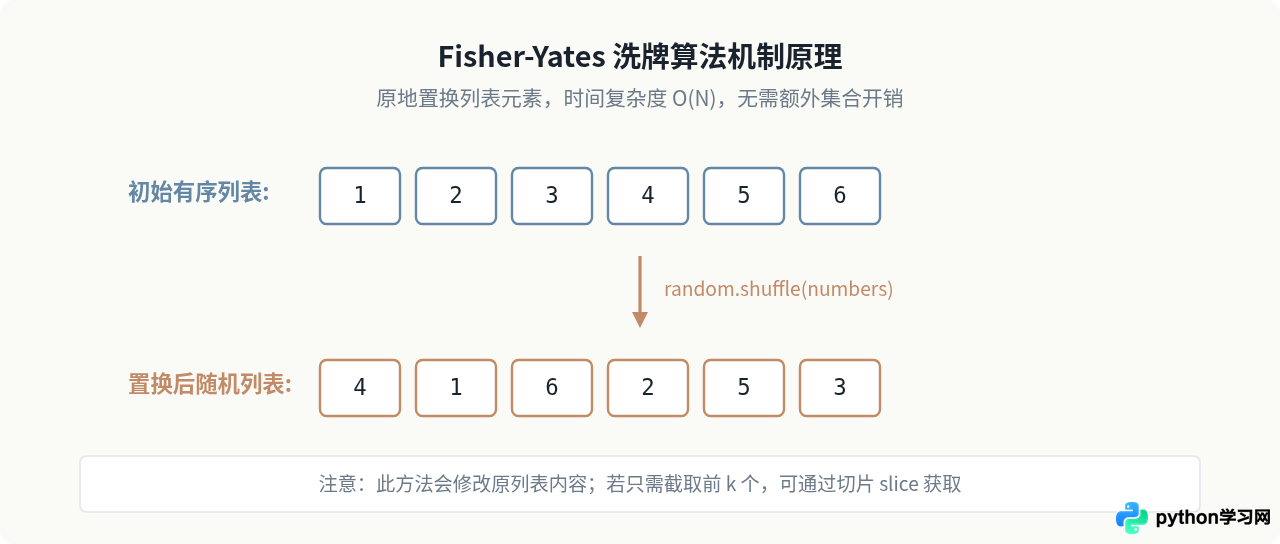
代码实现与截取
import random

# 创建完整连续数字列表
numbers = list(range(1, 11))

# 原地打乱元素顺序
random.shuffle(numbers)

# 获取打乱后的完整列表或前 N 个元素
shuffled_all = numbers
sub_selection = numbers[:5]

print("打乱后的列表:", shuffled_all)
print("截取前5个不重复数:", sub_selection)
示例输出:
打乱后的列表: [8, 2, 5, 1, 9, 3, 10, 4, 7, 6]
截取前5个不重复数: [8, 2, 5, 1, 9]适用场景限制:此方法需要首先在内存中生成完整的候选列表。当数字范围极大(例如从 1 到 10 亿中选 10 个数字)时,创建 list(range(1, 1000000001)) 会瞬间耗尽系统内存,因此该方案仅适用于候选总体规模相对较小或已有物理列表的场景。
方法三:循环加集合过滤法(初学者常见陷阱与分析)
初学者常常会尝试使用 while 循环结合 set 或 list 查重来生成不重复随机数。理解其弊端有助于避免生产环境中的性能陷阱。
import random

def generate_unique_by_set(count, min_val, max_val):
    unique_numbers = set()
    while len(unique_numbers) < count:
        unique_numbers.add(random.randint(min_val, max_val))
    return list(unique_numbers)

result = generate_unique_by_set(10, 1, 100)
print(result)
为什么不推荐在通用场景使用此方法?
- 碰撞概率剧增:当要抽取的数量
count接近取值范围区间的大小时,产生重复数字的概率急剧上升。例如在 1~100 中抽取 99 个数,最后几个数字可能需要成百上千次随机碰撞才能命中,导致执行时间不可预测。 - 死循环风险:若传入的
count > (max_val - min_val + 1),循环条件永远无法满足,程序将陷入彻底的死循环。 - 返回结果无序性:转换为
set后会丢失原有的生成随机顺序,再次转为list时往往表现为半有序状态。
方法四:海量数据与科学计算环境(NumPy Choice)
在涉及科学计算、机器学习或高并发大数据场景时,Python 内置的 random 模块由于是基于 Python 对象的循环抽样,执行速度可能无法满足毫秒级批量需求。此时可以借助 numpy.random.choice。
import numpy as np

# replace=False 表示无放回抽样,确保不重复
numbers = np.random.choice(100, size=10, replace=False)

# 转换回标准 Python 列表
result_list = numbers.tolist()
print(result_list)
示例输出:
[82, 34, 15, 96, 4, 53, 27, 71, 9, 60]在底层的 C 语言向量化实现加持下,NumPy 可以在毫秒级完成数百万个不重复数字的高速抽取,且语法非常直接。
各种生成方法的特性对比
为帮助读者根据实际项目需求做出准确选择,下表对四种主要方法的性能、内存占用与典型适用场景进行了全方位归纳。
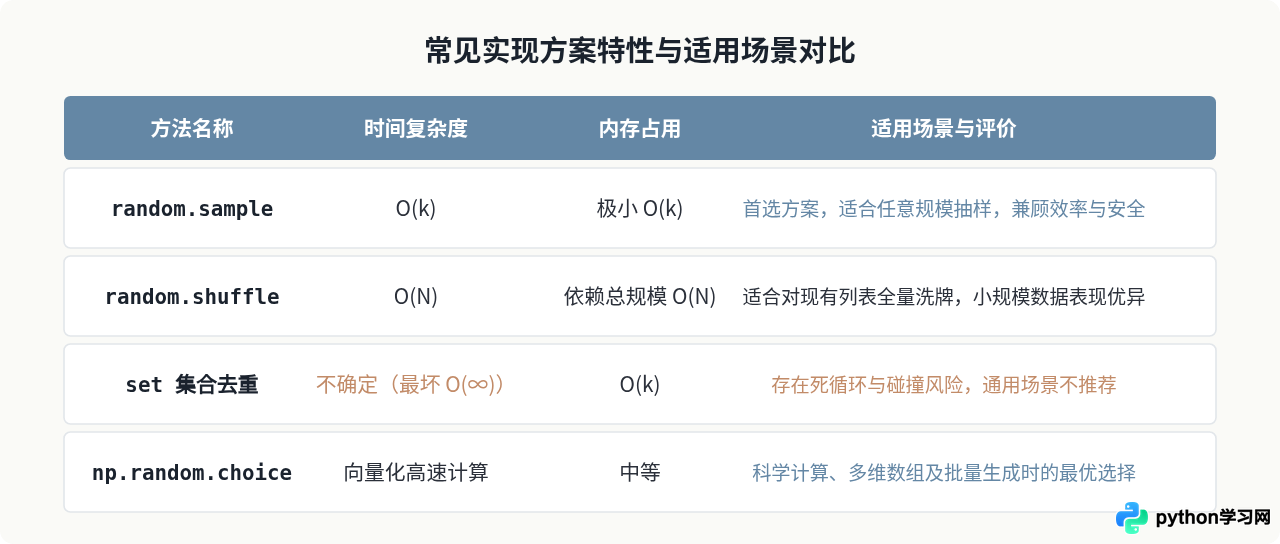
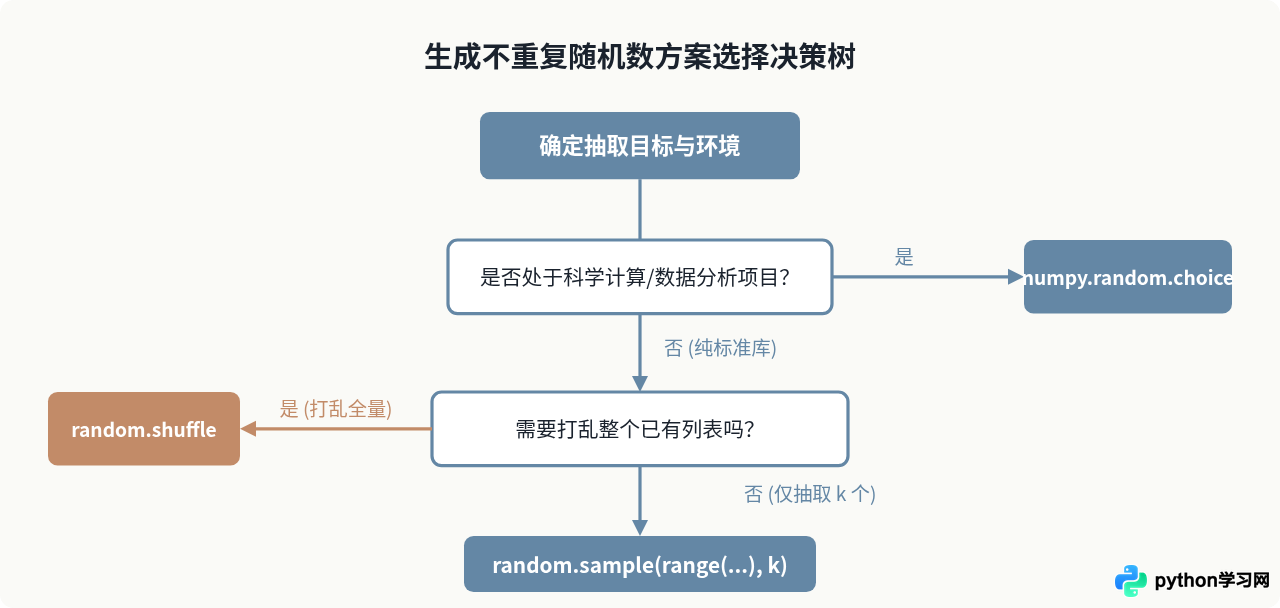
工程选型决策逻辑
在日常开发构建功能时,可以根据以下决策路径确定应使用的具体方案:
总结
在日常 Python 开发中生成不重复随机数列表,记住以下核心准则即可:
- 对于常规业务和脚本,始终优先选用
random.sample(range(start, end), k),其内存友好、速度快且安全可靠; - 对于需要完整重排已有列表的场景,使用
random.shuffle(); - 在数据科学与百万级以上抽样场景,优先采用
numpy.random.choice(..., replace=False); - 避免使用
while循环追加集合的自制算法,以防止碰撞性能退化与死循环隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















