


Python类实战:怎么用class封装学生信息管理功能
本文通过一个完整的学生信息管理系统实战,深入讲解如何利用Python中的class进行对象建模与功能封装。从数据实体类到业务管理类,层层拆解类与方法的设计思路、属性校验及核心业务逻辑。
Student 封装单个学生的学号、姓名、成绩和统计方法;再用一个业务管理类 StudentManager 封装数据的增、删、改、查与集合维护。本文将从类的职责边界切入,逐步写出完整可运行的代码实现与健壮性校验。
一、为什么用类而不是字典或列表管理数据?
很多初学者在编写管理类程序时,习惯用嵌套字典或列表来保存数据,例如使用 {"id": "101", "name": "张三", "scores": [85, 90]}。这种写法虽然在前期起步很快,但随着功能扩展,往往会暴露出明显的维护问题:
- 键名拼写无约束:代码中各处硬编码字符串键,一旦某处将
"scores"误写成"score",Python 只有在运行时才会抛出KeyError,排查极为费时。 - 数据与行为割裂:计算学生总分、求平均成绩或更新状态的函数散落在各个模块中。数据只负责存值,函数四处传递,缺少统一边界。
- 数据合法性缺乏屏障:任何地方都能直接修改字典内容,无法阻止误填负分或超出 100 分的不合规数据。
使用 class 的核心价值,就是将“数据本身(属性)”与“针对这些数据的操作(方法)”紧密捆绑为一个整体,对外暴露清晰规范的调用接口,对内守住数据的有效性。
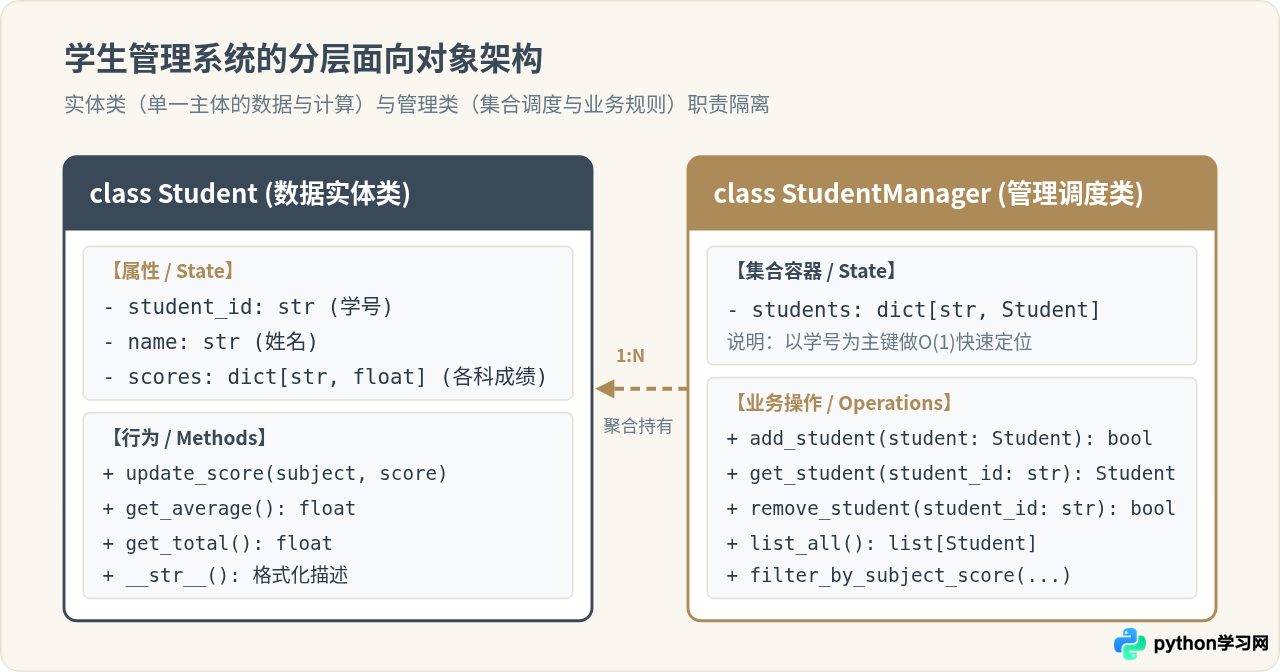
二、第一步:构建学生实体类(Student)
实体类的首要任务是表示系统中的“最小业务单元”。在学生信息中,学号具有唯一性,姓名是基础标识,而科目成绩则可以用一个键值对字典动态维护。
在这个类中,我们不仅通过 __init__ 初始化基本属性,还内置了平均分计算和字符串转换魔术方法 __str__,使打印单个对象时更加直观。
# student.py
class Student:
    """表示单个学生信息的数据实体类"""

    def __init__(self, student_id: str, name: str, scores: dict = None):
        self.student_id = str(student_id).strip()
        self.name = str(name).strip()
        # 避免可变对象作为默认形参引发的引用共享问题
        self.scores = scores if scores is not None else {}

    def set_score(self, subject: str, score: float):
        """设置或更新某科目的成绩,增加基础数值合法性校验"""
        if not (0 <= score <= 100):
            raise ValueError(f"成绩必须在 0 到 100 之间,输入值为: {score}")
        self.scores[subject] = float(score)

    def get_total_score(self) -> float:
        """计算该学生的各科总成绩"""
        return sum(self.scores.values())

    def get_average_score(self) -> float:
        """计算该学生的平均成绩(保留一位小数)"""
        if not self.scores:
            return 0.0
        return round(self.get_total_score() / len(self.scores), 1)

    def __str__(self) -> str:
        """对象字符串化,方便在终端或界面中清晰展示"""
        score_info = ", ".join(f"{sub}: {sc}" for sub, sc in self.scores.items())
        score_display = score_info if score_info else "暂无成绩"
        return (
            f"学号: {self.student_id} | "
            f"姓名: {self.name} | "
            f"成绩: [{score_display}] | "
            f"总分: {self.get_total_score()} | "
            f"平均分: {self.get_average_score()}"
)def __init__(self, ..., scores={}),所有未传成绩的学生实例将共享内存中的同一个字典,修改其中一个学生的成绩会导致其他学生的数据也被意外篡改。使用 None 并在方法体内新建字典是标准的防御性写法。
三、第二步:构建管理系统类(StudentManager)
单个学生类完成后,需要一个管理者来负责全局集合操作。管理类负责增、删、查、改以及输出统计报表。
在底层数据结构上,我们选择 Python 字典 self.students = {},将 student_id 作为键,将 Student 实例作为值。这样在依据学号查询、修改或删除时,时间复杂度仅为 \(O(1)\),相比列表轮询大幅提高了检索效率。
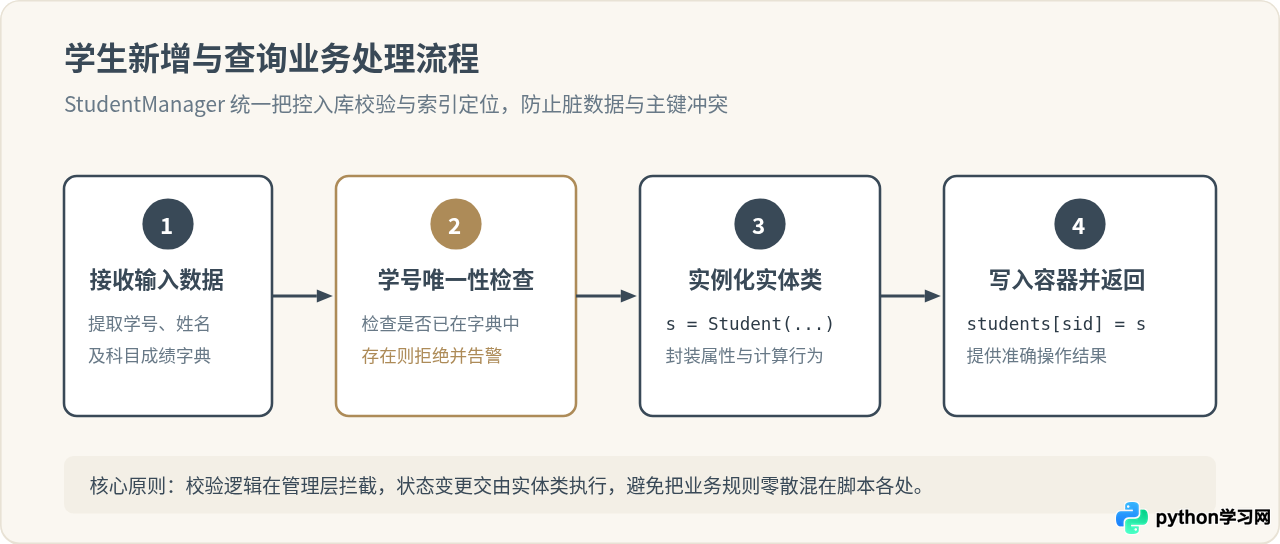
以下是 StudentManager 的完整实现代码,涵盖增、查、改、删与报表展示:
# manager.py
class StudentManager:
    """管理学生对象集合的核心业务类"""

    def __init__(self):
        # 键为 student_id (str),值为 Student 实例
        self.students = {}

    def add_student(self, student_id: str, name: str, scores: dict = None) -> bool:
        """添加新学生;若学号已存在则拒绝添加并返回 False"""
        sid = str(student_id).strip()
        if not sid:
            print("[错误] 学号不能为空。")
            return False
        if sid in self.students:
            print(f"[警告] 学号 {sid} 已存在,无法重复添加。")
            return False

        # 创建 Student 实例并写入管理器容器
        new_student = Student(student_id=sid, name=name, scores=scores)
        self.students[sid] = new_student
        print(f"[成功] 学生 {name} (学号: {sid}) 添加成功。")
        return True

    def find_student(self, student_id: str) -> Student:
        """根据学号查询学生对象,未找到返回 None"""
        return self.students.get(str(student_id).strip())

    def update_student_score(self, student_id: str, subject: str, score: float) -> bool:
        """更新指定学生的某一科目成绩"""
        student = self.find_student(student_id)
        if not student:
            print(f"[错误] 未找到学号为 {student_id} 的学生。")
            return False
        try:
            student.set_score(subject, score)
            print(f"[成功] 学号 {student_id} 的 {subject} 成绩更新为 {score}。")
            return True
        except ValueError as err:
            print(f"[错误] {err}")
            return False

    def remove_student(self, student_id: str) -> bool:
        """根据学号删除学生"""
        sid = str(student_id).strip()
        if sid in self.students:
            removed = self.students.pop(sid)
            print(f"[成功] 已移除学生 {removed.name} (学号: {sid})。")
            return True
        print(f"[错误] 未找到学号为 {sid} 的学生,无法删除。")
        return False

    def list_all_students(self):
        """格式化列出所有学生信息"""
        if not self.students:
            print("--- 当前管理系统中暂无学生数据 ---")
            return

        print("\n" + "=" * 50)
        print(f"学生信息汇总表(共 {len(self.students)} 人)")
        print("-" * 50)
        for student in self.students.values():
            print(student)
        print("=" * 50 + "\n")
四、第三步:进阶属性封装与数据安全防御
在基础面向对象设计中,外部代码仍可以直接访问甚至覆盖对象的属性,例如执行 student.name = ""。在企业开发或严谨项目中,通常借助 Python 内置的 @property 装饰器实现字段私有化与访问保护。
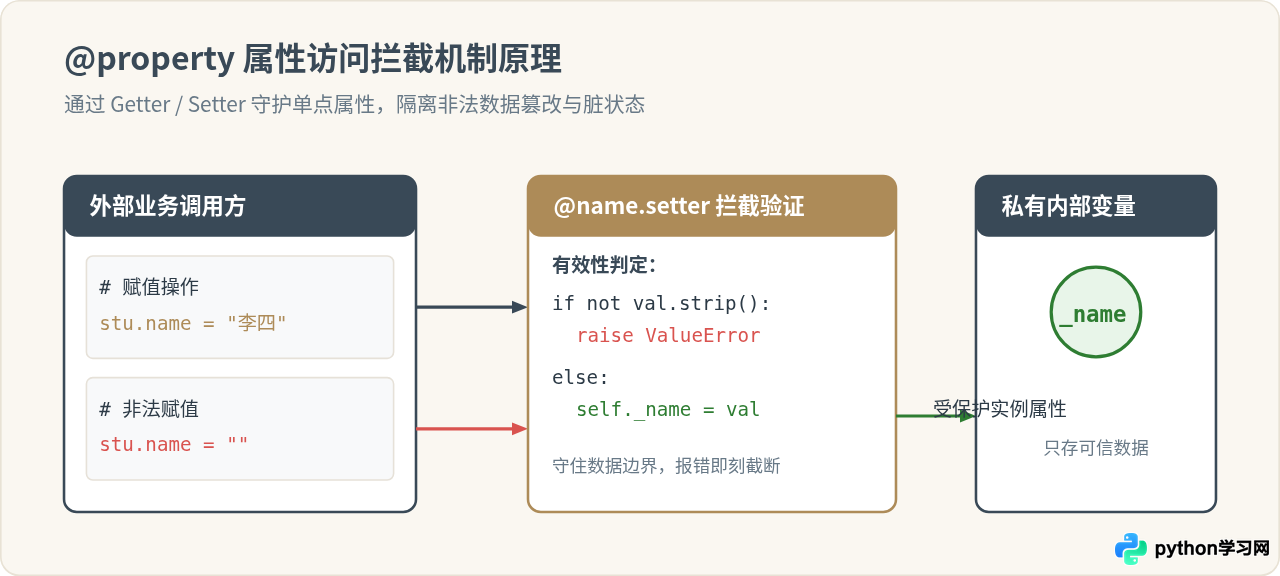
通过添加属性防护,改写后的学生类可以在外部尝试赋予空字符串名字时直接抛出异常,杜绝“空姓名”或“格式错误学号”进入管理系统:
class RobustStudent:
    """具备属性有效性防御机制的学生类"""

    def __init__(self, student_id: str, name: str):
        self._student_id = str(student_id).strip()
        self.name = name  # 这里会自动触发 @name.setter
        self._scores = {}

    @property
    def student_id(self) -> str:
        """学号只读,不允许外部随意修改"""
        return self._student_id

    @property
    def name(self) -> str:
        return self._name

    @name.setter
    def name(self, value: str):
        cleaned = str(value).strip()
        if not cleaned:
            raise ValueError("学生姓名不能为空或全空格")
        self._name = cleaned
五、第四步:完整组装与运行验证
将上述各个组件整合在一起,编写一段端到端的验证脚本,观察从对象创建、修改、冲突检测到最终汇总的运行结果:
# main.py
def run_demo():
    # 1. 实例化管理器
    manager = StudentManager()

    # 2. 批量录入初始学生数据
    manager.add_student("202601", "周敏", {"Python": 92.0, "数学": 88.5})
    manager.add_student("202602", "陈浩", {"Python": 78.0, "数学": 82.0})
    manager.add_student("202603", "赵蕾", {"Python": 95.0, "英语": 91.0})

    # 3. 测试主键冲突校验
    print("\n[测试] 尝试添加已存在的学号:")
    manager.add_student("202601", "周某某")

    # 4. 测试成绩更新与合法性约束
    print("\n[测试] 更新学生成绩:")
    manager.update_student_score("202602", "Python", 85.0)
    manager.update_student_score("202602", "英语", 120.0)  # 预期触发超限报错

    # 5. 查看特定学生详情
    print("\n[测试] 查询单个学生:")
    stu = manager.find_student("202601")
    if stu:
        print(f"查得学生信息: {stu}")

    # 6. 删除一个学生
    print("\n[测试] 删除学生:")
    manager.remove_student("202603")

    # 7. 输出最终全量报表
    manager.list_all_students()

if __name__ == "__main__":
    run_demo()
示例运行输出
[示例输出]
[成功] 学生 周敏 (学号: 202601) 添加成功。
[成功] 学生 陈浩 (学号: 202602) 添加成功。
[成功] 学生 赵蕾 (学号: 202603) 添加成功。

[测试] 尝试添加已存在的学号:
[警告] 学号 202601 已存在,无法重复添加。

[测试] 更新学生成绩:
[成功] 学号 202602 的 Python 成绩更新为 85.0。
[错误] 成绩必须在 0 到 100 之间,输入值为: 120.0

[测试] 查询单个学生:
查得学生信息: 学号: 202601 | 姓名: 周敏 | 成绩: [Python: 92.0, 数学: 88.5] | 总分: 180.5 | 平均分: 90.2

[测试] 删除学生:
[成功] 已移除学生 赵蕾 (学号: 202603)。

==================================================
学生信息汇总表(共 2 人)
--------------------------------------------------
学号: 202601 | 姓名: 周敏 | 成绩: [Python: 92.0, 数学: 88.5] | 总分: 180.5 | 平均分: 90.2
学号: 202602 | 姓名: 陈浩 | 成绩: [Python: 85.0, 数学: 82.0] | 总分: 167.0 | 平均分: 83.5
==================================================
六、方案对比与封装核心价值总结
为了直观展现面向对象相较于过程式字典散列的优势,我们从维护成本、排错难度和功能扩展三个维度做出对比:
| 对比维度 | 字典 / 列表散列实现 | class 封装实现 |
|---|---|---|
| 数据规范性 | 依赖散落的键名字符串,容易发生大小写错误与遗漏 | 由类属性与 __init__ 严格约束,补全提示友好 |
| 数据合法性 | 无边界保护,外部代码可以直接注入负数或空值 | 通过 setter 与封装方法设立准入屏障,守卫数据一致性 |
| 计算逻辑聚合 | 总分、均分等函数散落在各处,传参冗长且繁琐 | 挂载为对象的方法或计算属性,高内聚且开箱即用 |
| 持久化演进 | 格式松散,对接数据库或 JSON 文件时需写大量胶水转换代码 | 结构清晰,极易通过 to_dict() 或 ORM 工具完成存储迁移 |
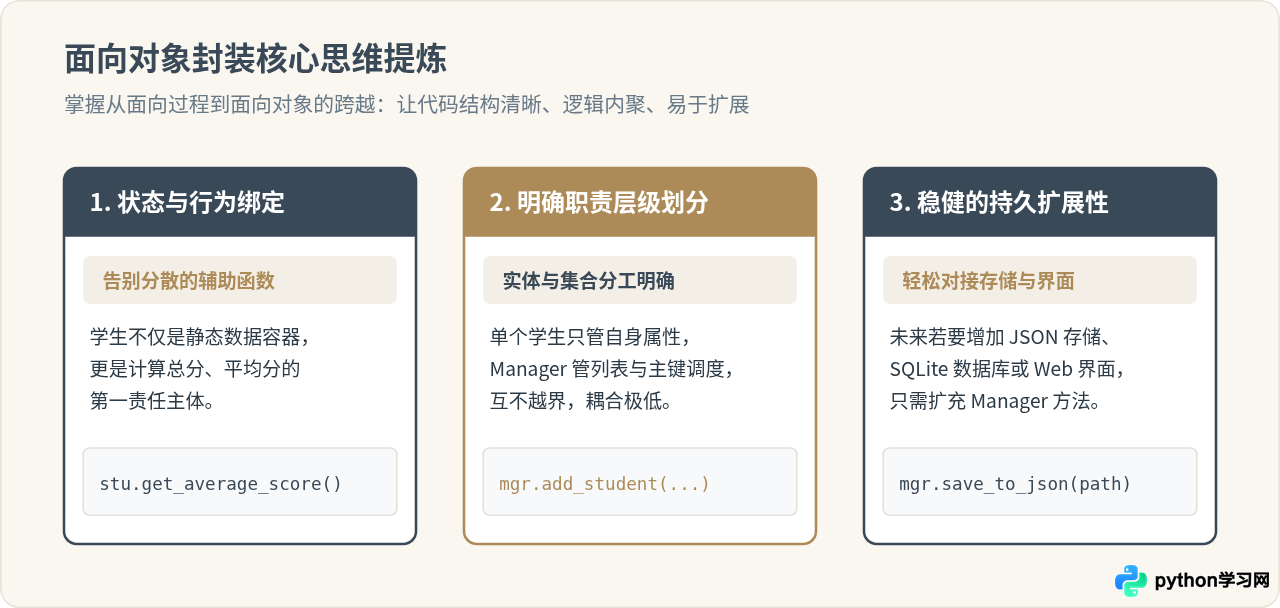
通过本文的实战演练可以看到,用 Python 的 class 封装学生信息管理功能并不是为了追求语法形式上的复杂,而是通过“单一职责”与“数据封装”让代码结构更加清晰健壮。掌握了“实体类 + 管理类”的分层设计模型,未来无论是面对员工管理、图书库存还是复杂的电商订单系统,都能以不变的面向对象思维游刃有余地组织业务逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















