


IPython魔法命令怎么用:%run、%timeit与!系统调用指南
全面讲解IPython中%run、%timeit魔法命令与!系统调用的具体用法、运行原理、参数技巧与易混淆陷阱,帮助开发者高效进行代码调试、性能测试与系统交互。
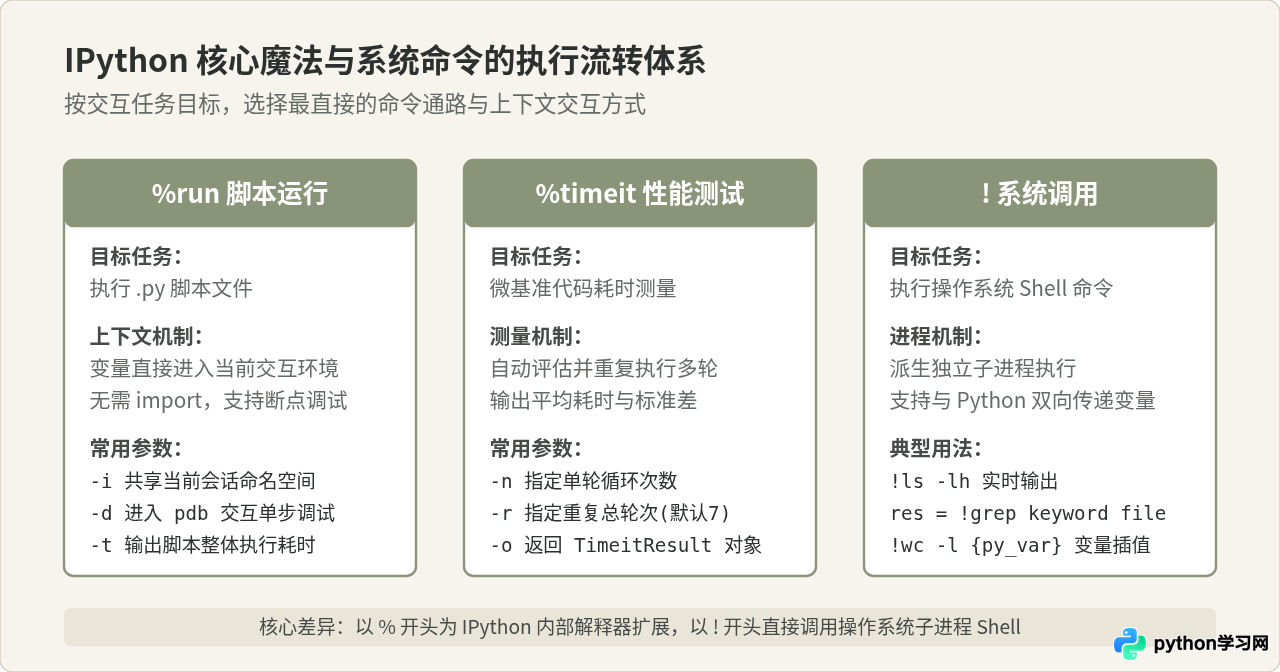
在日常数据分析、原型验证和算法开发中,IPython 与 Jupyter 提供了远超标准 Python 交互解释器的能力。其中,%run、%timeit 和 ! 系统调用是最常用且实用的三大功能,分别负责“运行外部脚本并保留交互上下文”、“精确评估代码执行性能”以及“直接穿透调用操作系统底层命令”。掌握这三个命令的具体参数、运行机制与边界条件,能够显著减少在终端与编辑器之间频繁切换的时间损耗,建立清晰流畅的交互式开发节奏。
一、%run:脚本执行与命名空间注入
在编写数据处理脚本时,很多开发者习惯在终端里反复运行 python script.py。这种方式最大的痛点在于:脚本一旦运行结束,其内部计算出的对象、清洗好的数据框和模型状态会立即随进程退出而销毁。如果接下来要检查某个局部变量,就必须重新在脚本末尾打印,或者重新启动整个流程。
%run 解决了这一断点问题。它允许你在当前 IPython 交互环境中直接运行外部 .py 脚本,并且在脚本执行完成后,保留脚本中定义的所有全局变量、函数和类,供后续交互直接使用。
1. 基础调用与常用选项
假设当前目录下有一个数据预处理脚本 process.py:
# process.py
import math

raw_data = [12, 45, 68, 23, 89, 34]
normalized_data = [round(x / max(raw_data), 4) for x in raw_data]
summary_mean = sum(normalized_data) / len(normalized_data)
print(f"处理完成,平均值: {summary_mean}")
在 IPython 会话中,直接执行:
In [1]: %run process.py
处理完成,平均值: 0.5187

In [2]: normalized_data
Out[2]: [0.1348, 0.5056, 0.764, 0.2584, 1.0, 0.382]

In [3]: summary_mean
Out[3]: 0.5187
如上所示,脚本执行完毕后,变量 normalized_data 和 summary_mean 已经自然留存在当前的命名空间中,无需显式 return 或外部持久化。
%run 还提供了几个核心选项以应对不同调试需求:
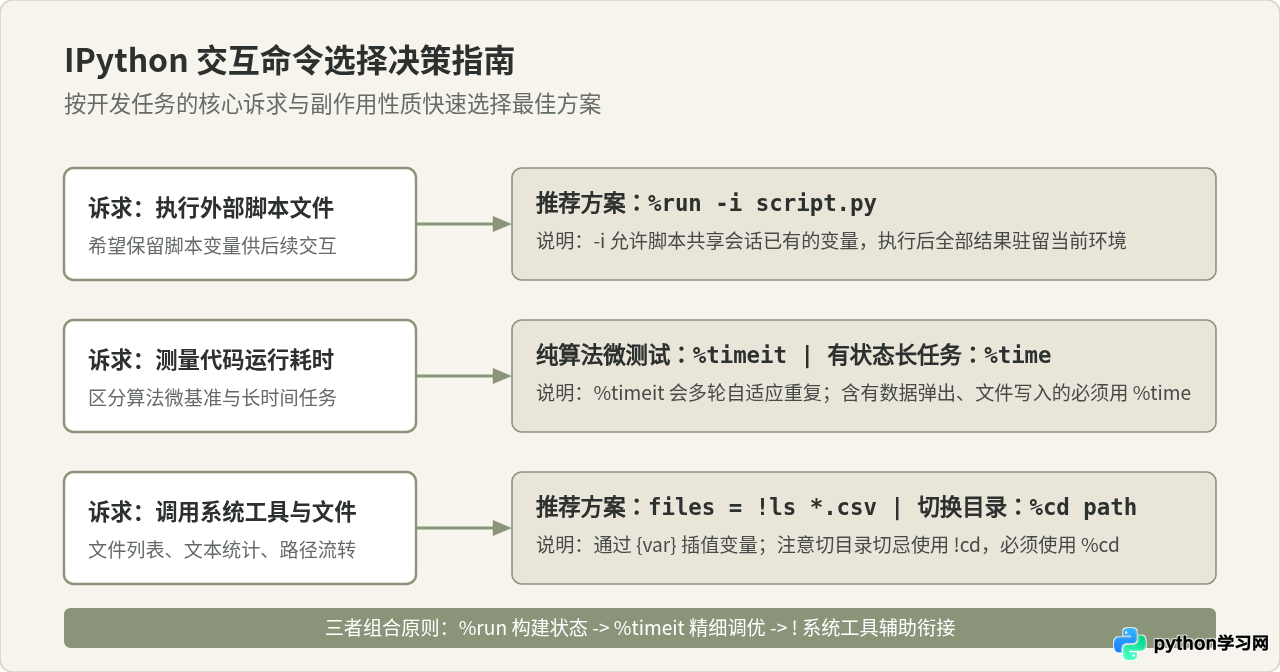
%run -i script.py:共享会话环境。默认情况下,%run会在一个干净的新命名空间中执行脚本;如果加上-i参数,脚本就可以直接访问你在当前 IPython 会话中已经定义好的变量,适合用外部脚本处理当前内存中的大型数据。%run -d script.py:启动内置调试器。脚本会在第一行暂停并进入pdb提示符,支持单步执行(n)、进入函数(s)与检查上下文。%run -t script.py:脚本整体计时。在脚本执行完毕后,输出该脚本在操作系统中的实际执行耗时(包括系统时间与用户 CPU 时间)。%run -p script.py:性能分析调用。通过 Python 内置的cProfile模块运行脚本,输出每个函数的调用次数与耗时排行,迅速定位瓶颈。
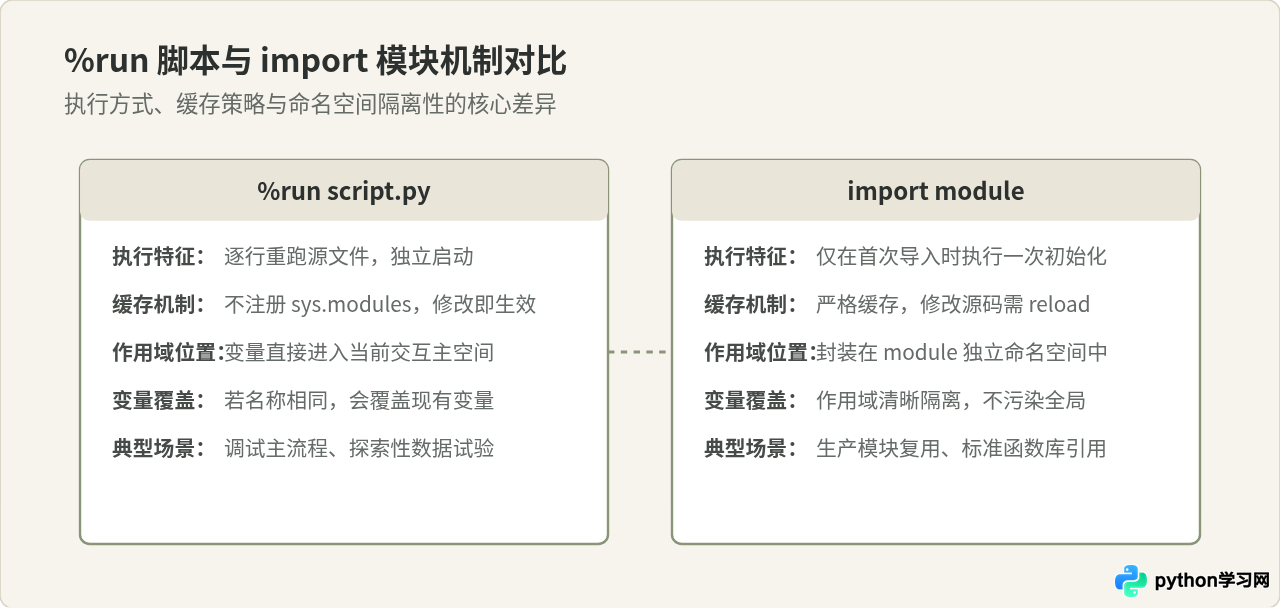
很多初学者会产生疑问:“既然 import process 也能载入脚本里的变量和函数,为什么还要用 %run?”
这种看法看似合理,因为两者都能载入代码定义,但在机制上存在根本区别:
- 缓存机制不同:
import遵循 Python 模块导入协议,首次导入后会将模块缓存到sys.modules中。如果你在编辑器里修改了process.py的代码,在 IPython 中再次import process不会重新执行代码,必须手动调用importlib.reload()。而%run每次都会重新从头执行目标文件,修改立即生效。 - 命名空间不同:
import process会将对象封装在process命名空间下,访问时需要加前缀(如process.summary_mean);而%run默认将顶层变量直接注入当前交互作用域。 - 设计目的不同:
import适合构建长期稳定、有层次的代码模块依赖;%run则适合在交互式会话中调试工作流脚本。
二、%timeit:精确测量代码执行时间
评估一段算法或逻辑的耗时是性能优化的第一步。Python 自带的 time.time() 容易受到操作系统调度、垃圾回收(GC)以及瞬时 CPU 频率波动的影响,测量极短代码块时误差极大。IPython 提供的 %timeit(单行)与 %%timeit(多行单元格)正是专为解决微基准测试(micro-benchmarking)而设计的工具。
1. 自动循环与统计机制
%timeit 最大的优势是它的自适应测量算法。在执行时,它会先进行极短的预测试,判断单次执行大概需要多少时间:
- 如果代码执行很快(微秒或纳秒级),它会自动将单轮循环次数增加到 100,000 次甚至 1,000,000 次,使得总体耗时达到足够精确的测量阈值;
- 随后默认执行 7 轮(runs),计算每轮的平均耗时,最终输出平均值与标准差。
示例:对比列表推导式与 map 构造平方列表的速度:
In [4]: %timeit [x**2 for x in range(1000)]
118 µs ± 1.84 µs per loop (mean ± std. dev. of 7 runs, 10,000 loops each)

In [5]: %timeit list(map(lambda x: x**2, range(1000)))
164 µs ± 2.65 µs per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
输出清晰展示了:测试总共重复了 7 轮,每轮循环 10,000 次,列表推导式的平均执行时间为 118 微秒,标准差为 1.84 微秒。
2. 常用控制参数
在面对某些耗时较长、或需要程序化处理测试结果的场景时,可以通过参数显式约束行为:
-n <N>:固定每轮循环执行的次数。例如%timeit -n 100 func(),每次测试只运行 100 遍。-r <R>:固定总重复轮次。默认是 7 轮;若希望测试更快完成,可设置为-r 3。-o:将测量结果作为一个TimeitResult对象返回,便于在后续代码中提取数据绘制图表。-q:静默模式,不向标准输出打印统计文字,通常与-o配合使用。
In [6]: result = %timeit -o -r 5 -n 1000 [x for x in range(500)]
10.2 µs ± 215 ns per loop (mean ± std. dev. of 5 runs, 1,000 loops each)

In [7]: result.best
Out[7]: 9.987541200000024e-06

In [8]: result.all_runs
Out[8]: [1.02e-05, 1.05e-05, 9.98e-06, 1.01e-05, 1.03e-05]很多开发者认为“%timeit 结果更准,所以永远应该用 %timeit”。这个结论在有状态变更的代码中是错误的。
两者的根本区别在于:
%time只执行代码一次,输出实际流逝的壁钟时间(Wall time)和 CPU 时间。它的优点是完全保留副作用,缺点是单次执行容易受瞬时抖动干扰。%timeit会重复执行成千上万次。如果被测代码含有不可逆的副作用(例如list.pop()、写入文件、向数据库插入数据),第一次执行可能耗时很短,但从第二次开始代码就会报错(如IndexError: pop from empty list)或者由于数据规模改变导致测量彻底失真。
判断原则:测量无状态的纯计算逻辑(如数学运算、数据格式解析、小片段算法)使用 %timeit;测量耗时很长(数秒至数分钟)、或者带有状态修改的操作时,必须使用 %time。
三、!系统调用:穿透调用底层 Shell 与双向数据交互
在数据探索过程中,我们经常需要查看文件系统中的数据文件、安装 Python 包、检查 Git 分支或使用命令行工具(如 grep、wc、curl)。如果每次都切出编辑器去打开系统终端,会打断心流。以英文感叹号 ! 开头,可以直接让 IPython 执行操作系统原生 Shell 命令。
1. 基础调用与输出捕获
最简单的用法是直接在命令行前加上 !:
In [9]: !ls -lh data/
total 32
-rw-r--r--  1 user  staff   1.2M 10 28 10:15 samples.csv
-rw-r--r--  1 user  staff   450K 10 28 10:20 labels.json
更强大的是,IPython 允许将命令行的标准输出直接赋值给 Python 变量:
In [10]: csv_files = !ls data/*.csv
In [11]: type(csv_files)
Out[11]: IPython.utils.text.SList

In [12]: csv_files
Out[12]: ['data/samples.csv', 'data/test.csv']
这里的返回值不是普通的字符串,而是一个 IPython.utils.text.SList(字符串列表)对象。它继承自内置 list,但额外提供了类似 Shell 工具链的便捷过滤方法:
csv_files.grep("sample"):类似grep,筛选包含指定模式的行;csv_files.fields(0):类似awk '{print $1}',提取空格分隔的第 0 列;csv_files.s:以空格拼接成单个扁平字符串;csv_files.n:以换行符拼接成单个长字符串。
2. Python 变量反向传入 Shell 命令
数据交互不仅可以从 Shell 流向 Python,也可以将 Python 运行时的变量传入 Shell。在 ! 命令中,使用 {var_name} 大括号语法,IPython 会在向底层 Shell 发送命令前完成变量插值:
In [13]: target_file = "data/samples.csv"
In [14]: line_threshold = 5

In [15]: !head -n {line_threshold} {target_file}
id,feature_1,feature_2,label
1,0.234,1.892,0
2,0.871,0.112,1
3,0.445,0.982,0
4,0.612,1.334,1
这种机制极大方便了对批处理脚本与外部命令行工具的动态编排。
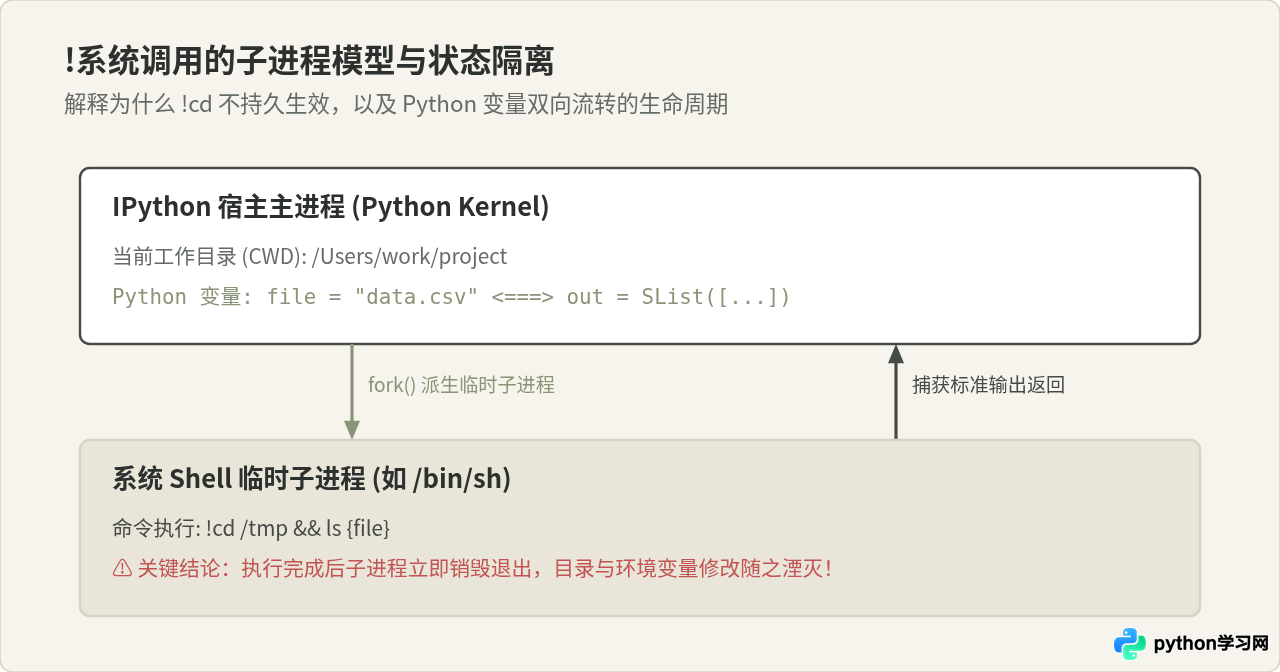
很多初次使用 ! 的人经常会踩一个经典陷阱:在 IPython 中执行 !cd /tmp,然后执行 !pwd,发现当前目录根本没有改变。
底层原因分析:
每一个以 ! 开头的命令,IPython 都会调用操作系统派生(fork)一个全新的临时子进程 Subshell 来执行该命令。当 !cd /tmp 执行时,确实成功改变了那个子进程的工作目录,但命令一旦执行完毕,该子进程便立刻销毁退出。而 IPython 本身运行在父进程中,父进程的工作目录从未被修改。
正确解决方案:
要改变 IPython 进程本身的工作目录,不能使用系统调用 !cd,而必须使用 IPython 内置的目录切换魔法命令 %cd /tmp。%cd 直接在当前 Python 进程内调用 os.chdir(),能够真正持久保留路径切换状态。
四、常见应用场景与综合决策指南
为了在实际编码过程中快速判断该使用哪种命令,下表整理了三者在典型业务场景中的对应关系与关键使用模式:
| 命令类型 | 核心语法形态 | 最适用开发场景 | 关键注意事项与常见陷阱 |
|---|---|---|---|
| %run | %run [-i] script.py |
运行完整处理脚本、载入模型状态、进入 pdb 交互单步排错 | 同名变量会被直接覆盖;大脚本修改频繁时比 import 更加便捷 |
| %timeit | %timeit [-n N] [-r R] expr |
函数算法比对、列表推导式与生成器性能评估、纯计算微基准测试 | 严禁用于含有不可逆副作用的代码(如 pop、写文件),否则导致测试失真 |
| %time | %time statement |
单次长时间运行的大数据清洗任务、网络请求与有状态操作耗时统计 | 仅单次执行,易受瞬时 CPU 负载抖动影响,不作为微观算法标准基准 |
| ! 系统调用 | res = !cmd {py_var} |
轻量级系统交互(查看磁盘、调用 grep/wc)、快速安装依赖 pip install | 不能用 !cd 更改会话目录(必须用 %cd);子进程环境变量不持久 |
五、总结
%run、%timeit 与 ! 系统调用构成了 IPython 交互式开发的核心三脚架:
- 通过
%run,我们打破了“每次运行脚本都要重新加载庞大数据集”的繁琐流程,使代码调试无缝融入交互命名空间; - 通过
%timeit,我们获得了客观、自适应且剔除噪声的基准性能数据,使性能瓶颈排查有了科学依据; - 通过
!与{var}语法,我们打通了 Python 与宿主操作系统工具链的数据通路,将系统 Shell 作为交互环境的自然延伸。
在日常实践中,牢记“无状态微测试用 %timeit、长耗时/有副作用用 %time”、“环境持久切换用 %cd 替代 !cd”,便能在保持代码探索灵活性的同时,避免各种潜在的隐蔽缺陷,大幅提升日常研发与数据分析效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















