


Python标准库与第三方库的区别:哪些功能无需安装额外包?
深入解析Python标准库与第三方库的物理隔离、生命周期差异与架构边界,详细梳理无需安装第三方包即可直接使用的八大高频工程功能与模块选型指南。
pip install 依赖,还能在无外网生产环境与轻量级脚本编写中直接写出稳定、免维护的代码。
一、标准库与第三方库的根本区别在哪里?
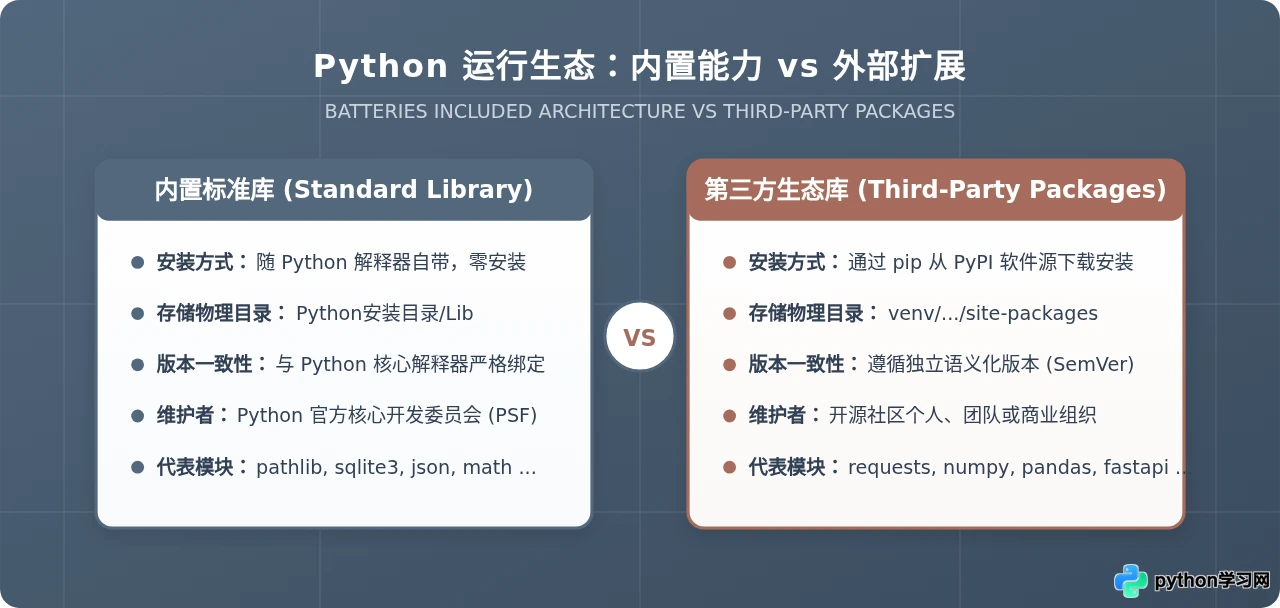
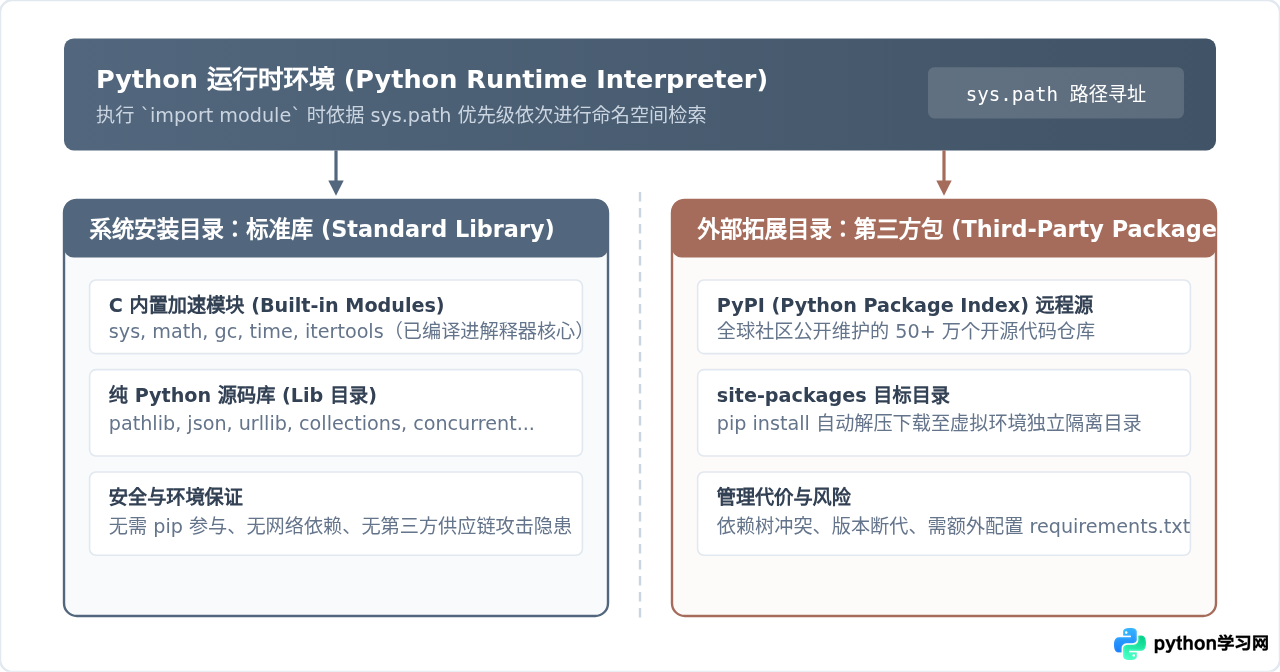
在 Python 开发中,区分一个模块究竟是“标准库”还是“第三方库”,最直观的标准并不是代码导入时的 import 语法,而是它存放的位置、分发的方式以及版本维护的责任方。
1. 物理位置与分发机制的隔离
当你从 Python 官网下载并安装 Python 解释器时,标准库就已经被完整写入到你的计算机磁盘中。在 Windows 上通常位于 Python安装路径\Lib,而在 macOS/Linux 上位于 /usr/lib/python3.x/ 或虚拟环境的共享库目录中。
第三方库则不同,它们最初托管在官方的包索引仓库 PyPI (Python Package Index) 上。开发者只有在终端中运行类似于 pip install requests 的命令后,包分发工具才会通过网络将轮子文件(.whl)或源码包解压到虚拟环境的 site-packages 目录下。如果当前环境处于无网状态,也没有提前配置离线轮子源,第三方库就完全无法获取。
2. 稳定性承诺与维护成本的差异
标准库由 Python 核心开发团队(Python Software Foundation)直接维护。在标准库中添加一个新模块或废弃旧接口,需要经过严苛的 PEP(Python Enhancement Proposal)提案、公开评审与多个小版本(例如 Python 3.10 到 3.12)的过渡期警告。因此,标准库具有极高的向后兼容性。一段仅依赖标准库的代码,往往在 5 年甚至 10 年后依然能够开箱运行。
第三方库由社区个人或组织独立维护,迭代速度极快,功能通常也更贴合特定业务痛点。但其潜在问题在于:作者可能随时停止维护、不遵守严格的语义化版本控制导致突发 Breaking Changes,或者由于深度依赖树中某个间接依赖(Transitive Dependency)的安全漏洞,导致整个项目出现供应链风险。
二、选型流程:如何判断是否真正需要安装额外包?
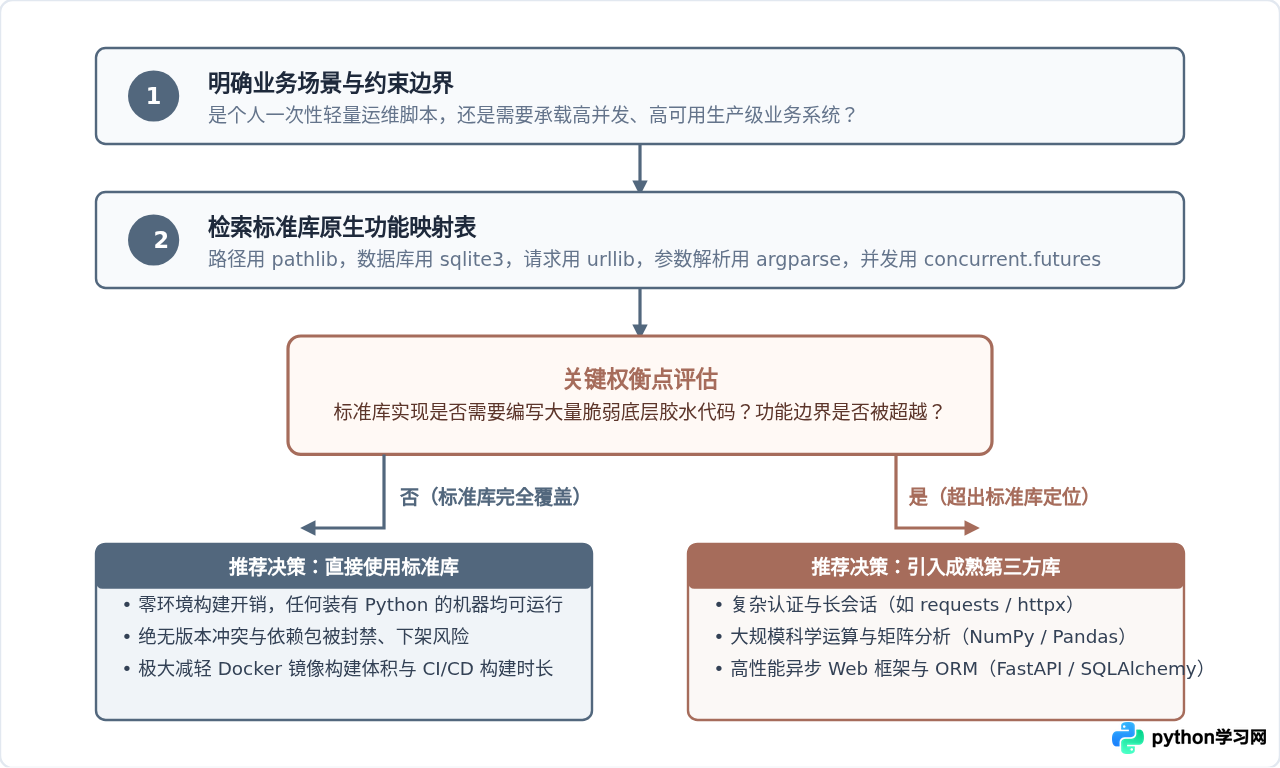
许多初学者在遇到新需求时,第一反应是在搜索引擎上查找“Python 做某个功能的库”,随后习惯性地敲下 pip install。这种做法往往导致一个简单的批量重命名文件或调用 HTTP 接口的脚本,附带了一个多达几十兆的 venv 虚拟环境。
合理的依赖引入应当遵循清晰的工程化评估流程:优先核对标准库是否原生提供解决方案;若标准库能够以可读、健壮的方式在几十行代码内完成任务,则绝不引入外部依赖。
三、哪些高频功能完全无需安装额外包?
在实际开发中,很多开发者习惯安装的第三方库,实际上标准库已经提供了极其优雅且性能卓越的现代原生解法。以下梳理七大最常见的场景与对应标准库用法。
1. 文件与文件系统路径处理:彻底弃用 os.path 与第三方路径库,拥抱 pathlib
在 Python 3.4 之前,跨平台拼接文件路径需要频繁使用 os.path.join、os.path.exists 等函数,语法繁琐且容易因为 Windows 的反斜杠与 POSIX 的正斜杠产生路径分隔符 Bug。许多人因此去安装第三方的路径封装库。
现代 Python 标准库内置了面向对象的 pathlib.Path,不仅支持使用 / 运算符直接拼接路径,还能直接读写文本与二进制流,几乎覆盖了 95% 以上的文件读写需求:
from pathlib import Path

# 1. 跨平台路径定义与拼接(自动适配系统分隔符)
workspace_dir = Path("my_project") / "output"
workspace_dir.mkdir(parents=True, exist_ok=True)

# 2. 文本直接写入与读取(自动管理文件句柄,无需繁琐的 with open)
data_file = workspace_dir / "report.txt"
data_file.write_text("状态: 运行正常\n错误数: 0", encoding="utf-8")

content = data_file.read_text(encoding="utf-8")
print(f"读取内容:\n{content}")

# 3. 模式匹配查找文件(相当于递归 glob)
for file_path in workspace_dir.glob("*.txt"):
    print(f"找到文件: {file_path.name}, 字节大小: {file_path.stat().st_size}")
状态: 运行正常
错误数: 0
找到文件: report.txt, 字节大小: 32
2. 轻量级数据持久化:无需搭建 MySQL 或安装 ORM,内置完整的 sqlite3
当编写一个小工具、爬虫记录去重、桌面应用配置或本地轻量数据存储时,许多开发者会下意识地使用 Docker 运行 MySQL 乃至安装复杂的 SQLAlchemy ORM。事实上,Python 标准库直接捆绑了全球使用最广泛的关系型数据库引擎——SQLite。
sqlite3 模块完全兼容标准 SQL 语法,支持事务 ACID 特性,数据直接以单个独立文件保存在本地,甚至可以直接运行在内存(:memory:)中作为高性能测试缓存:
import sqlite3

# 连接本地数据库文件(如果不存在则自动创建)
with sqlite3.connect("local_tasks.db") as conn:
    cursor = conn.cursor()
    # 创建任务数据表
    cursor.execute("""
        CREATE TABLE IF NOT EXISTS task_queue (
            id INTEGER PRIMARY KEY AUTOINCREMENT,
            task_name TEXT NOT NULL,
            priority INTEGER DEFAULT 1,
            created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
        )
    """)
    # 参数化查询,原生杜绝 SQL 注入
    cursor.execute(
        "INSERT INTO task_queue (task_name, priority) VALUES (?, ?)",
        ("数据清洗作业", 2)
    )
    conn.commit()

    # 查询数据
    cursor.execute("SELECT id, task_name, priority FROM task_queue WHERE priority >= ?", (1,))
    rows = cursor.fetchall()
    print("当前任务列表:", rows)
3. 轻量 HTTP 通信与静态服务:urllib 与 http.server
不可否认,第三方库 requests 或 httpx 的 API 设计极为符合人性。但在简单的脚本中,仅为了向某个接口发起一个 GET 或 POST 请求并解析 JSON,额外安装 requests 及其庞大的依赖(urllib3、certifi、charset-normalizer、idna)并非唯一解。
标准库的 urllib.request 配合 json 模块足以胜任绝大多数内部接口联动:
import urllib.request
import json

url = "https://httpbin.org/post"
payload = json.dumps({"agent": "Python-Standard-Library", "code": 200}).encode("utf-8")

# 构建带自定义 Headers 的请求对象
req = urllib.request.Request(
    url,
    data=payload,
    headers={"Content-Type": "application/json", "User-Agent": "Core-Script/1.0"},
    method="POST"
)

try:
    with urllib.request.urlopen(req, timeout=5) as response:
        response_body = response.read().decode("utf-8")
        parsed = json.loads(response_body)
        print(f"HTTP 状态码: {response.status}")
        print("服务端接收到的 JSON 数据:", parsed.get("json"))
except urllib.error.URLError as e:
    print(f"网络通信失败: {e.reason}")
服务端接收到的 JSON 数据: {'agent': 'Python-Standard-Library', 'code': 200}
此外,如果需要在局域网内临时分享一个目录中的文件,根本无需安装 Nginx 或任何 Web 框架,只需在终端中执行一行标准库指令:
python -m http.server 8000该命令会立即以当前目录为根路径启动一个开箱即用的静态 HTTP 文件服务器。
4. 生产级命令行参数解析:argparse 原生支持帮助文档与类型转换
开发 CLI(命令行工具)时,许多人倾向于安装 click 或 typer。对于大型多子命令的复杂交互应用,它们确实能提高开发效率。但如果只是构建通用的运维脚本、批处理工具或参数化运行入口,标准库内置的 argparse 已经高度成熟,原生支持参数类型验证、必选/可选控制、互斥开关以及自动生成的 -h/--help 帮助界面:
import argparse

parser = argparse.ArgumentParser(description="文件批量处理工具")
parser.add_argument("source", help="输入目录路径")
parser.add_argument("-b", "--batch-size", type=int, default=50, help="每批处理数量 (默认: 50)")
parser.add_argument("-v", "--verbose", action="store_true", help="启用详细日志输出")

args = parser.parse_args(["./data", "--batch-size", "100", "-v"])
print(f"源路径: {args.source}, 批次大小: {args.batch_size}, 详细模式: {args.verbose}")
5. 高并发批处理:多线程与多进程统一抽象 concurrent.futures
早期 Python 的并发编程需要手动管理 threading.Thread 或 multiprocessing.Process,还要繁琐地构建队列 Queue 收集返回值。为了简化这一流程,部分开发者引入了诸如 Celery、Gevent 等外部轮子。
Python 3.2 引入的标准库 concurrent.futures 提供了极其现代化的线程池与进程池抽象。无论是 I/O 密集型任务(如批量下载、并发请求)还是 CPU 密集型任务(多核数据处理),仅需调整执行器类名即可:
from concurrent.futures import ThreadPoolExecutor
import time

def process_item(item_id):
    time.sleep(0.05)  # 模拟网络等待或耗时 I/O
    return f"项 {item_id} 计算完成"

# 创建拥有 4 个工作线程的线程池
with ThreadPoolExecutor(max_workers=4) as executor:
    items = [101, 102, 103, 104]
    # map 函数保证按输入顺序依次返回结果
    for result in executor.map(process_item, items):
        print("任务反馈:", result)
任务反馈: 项 102 计算完成
任务反馈: 项 103 计算完成
任务反馈: 项 104 计算完成
6. 高性能数据结构与算法支撑:collections、heapq 与 bisect
很多初学者在遇到“统计词频”、“优先队列”、“二分查找”等算法需求时,会手工用纯字典循环遍历,或者去安装算法库。实际上,标准库针对高频容器操作进行了底层 C 语言级别的极限优化:
collections.Counter:一行代码完成频率统计、Top-K 筛选;collections.defaultdict:消除嵌套字典赋值时的KeyError防护样板代码;collections.deque:双端队列,两端进行append和pop具备 $O(1)$ 时间复杂度;heapq:原生的最小堆实现,无需安装任何优先队列库;bisect:原生二分插入与查找模块,在处理百万级有序列表时性能极佳。
7. 自动化测试与模拟隔离:unittest 与 unittest.mock
在自动化测试领域,pytest 几乎是现代项目的标准事实标配。但很多人不知道的是,标准库的 unittest 体系同样非常完备,且内置了极其强大的 unittest.mock。在不需要安装任何第三方依赖的情况下,你可以轻松完成依赖注入、打桩(Patching)和调用断言:
from unittest.mock import MagicMock

# 模拟一个昂贵或不可控的网络服务对象
mock_service = MagicMock()
mock_service.fetch_balance.return_value = {"balance": 8800.0}

# 调用被测逻辑
account_balance = mock_service.fetch_balance("user_007")
mock_service.fetch_balance.assert_called_once_with("user_007")

print("Mock 模拟返回结果:", account_balance)
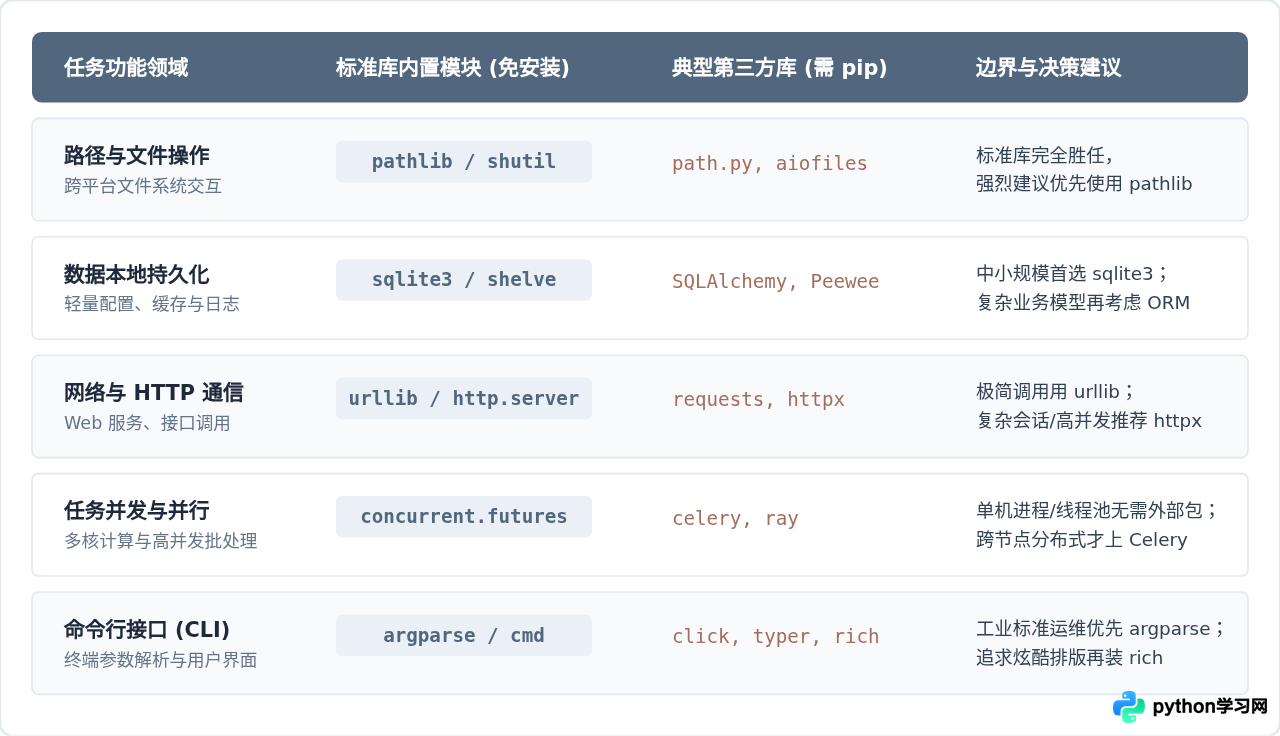
四、为什么在工程实践中不应滥用第三方库?
在快速原型开发中,随意 pip install 确实能在几分钟内拼装出一个功能原型。但随着软件进入维护期,依赖数量与维护成本呈指数级正相关。
- 离线与内网生产环境受限:金融、政企与专有云环境通常物理断网。纯标准库脚本可以直接通过单一
.py文件拷贝运行;而依赖了第三方库的脚本,必须预先打包数十个 Wheel 依赖甚至解决 C/C++ 动态链接库编译问题。 - 极简 Docker 镜像体积优化:在云原生体系中,基于精简系统(如 Alpine 或 Python-Slim)构建镜像时,减少第三方库安装意味着镜像可以从 800MB 骤降至 60MB,不仅极大加快拉取部署速度,还大幅收缩了 CVE 攻击面。
- 规避供应链安全风险:PyPI 仓库曾发生多起恶意包同形异字攻击(Typosquatting)和维护者账号失窃注入恶意代码事件。使用标准库则直接享受由核心开发团队签署的安全审计与长期支持。
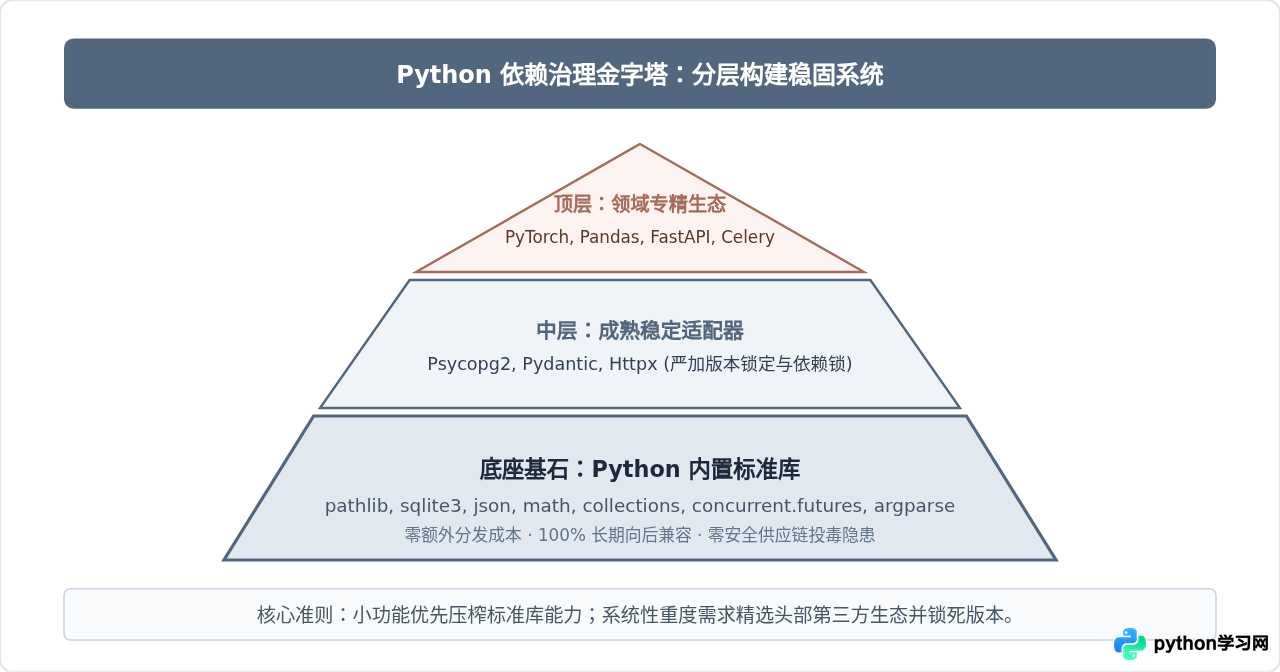
五、总结:在开发效率与依赖纯洁性之间取得平衡
理解 Python 标准库与第三方库的区别,绝不意味着我们要走向“绝不安装第三方库”的另一个极端。第三方生态是 Python 拥有今天繁荣地位的最大功臣,没有 NumPy 就没有现代 AI 生态,没有 FastAPI 也没有现代高效的 Python 微服务。
真正的专业素养在于知其然亦知其所以然:当你需要编写一个辅助小工具、自动化巡检脚本或轻量本地缓存时,能够熟练地调用 pathlib、sqlite3 与 concurrent.futures,写出仅需单个 .py 文件便能在任何标准 Python 环境下稳定运行多年的可靠代码;而在面对大规模复杂业务时,懂得建立清晰的虚拟环境与严格的依赖锁文件。这种根据场景自由切换的能力,正是 Python 开发者走向成熟的重要标志。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















