


Python正则表达式中字符a的含义:字面量匹配与特殊用法区分
深入解析Python正则表达式中字符a的多维含义:从默认字面量匹配到转义序列\a、内联修饰符(?a)、字符集[a-z]及命名分组中的语义转换与避坑指南。
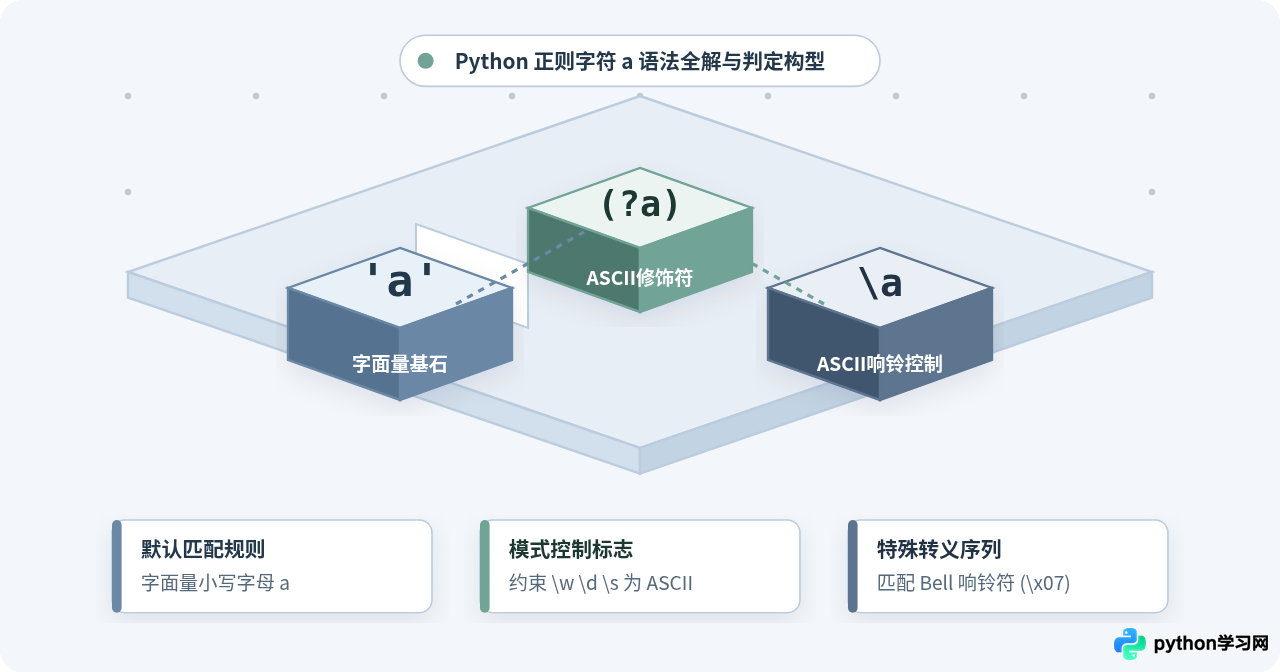
re 模块中,英文字符 a 最基础的角色是一个普通字符(即字面量,Literal),用来精确匹配文本中的小写英文字母 “a”。然而,一旦它置身于特殊语法结构中——如带有反斜杠前缀的 \a、内联标志修饰符 (?a)、中括号字符集 [a-z] 或命名分组 (?P<a>...) 时,它将脱离普通字母的含义,转而充当控制符、模式开关或结构标识。本文将详细拆解这些用法的内部机制、判断依据与常见陷阱。
作为普通字面量匹配的基础行为
在正则表达式的语法规范中,凡是没有被分配为元字符(如 .、*、+、?、^、$、(、)、[、]、{、}、|、\)的字符,都被默认视作字面量(Literal)。字符 a 本身属于标准 ASCII 英文字母,在没有特殊引导符修饰时,它只承担一项最纯粹的任务:直接匹配输入文本中的小写字母 'a'。
大小写敏感性与标志位影响
Python 正则引擎在默认设置下是严格区分大小写的。因此,模式 r'a' 仅能匹配小写的 'a',遇到大写的 'A' 则会判定匹配失败。如果需要忽略大小写,必须显式传入 re.IGNORECASE(或简写 re.I)标志位,或者在模式串开头添加内联标志 (?i)。
import re

text = "Apple, banana, and avocado"

# 1. 默认大小写敏感匹配
pattern_literal = r'a'
matches_default = re.findall(pattern_literal, text)

# 2. 忽略大小写匹配
pattern_ignorecase = r'(?i)a'
matches_ignorecase = re.findall(pattern_ignorecase, text)

print("默认匹配结果:", matches_default)
print("忽略大小写结果:", matches_ignorecase)忽略大小写结果: ['A', 'a', 'a', 'a', 'a', 'a']
从输出可见,在默认模式下,单词 “Apple” 开头的大写字母 A 并未被捕获;只有在加入忽略大小写设置后,字符 a 对应的语义才扩展为同时涵盖 'a' 和 'A'。
特殊用法一:转义序列 \a 与 ASCII 响铃陷阱
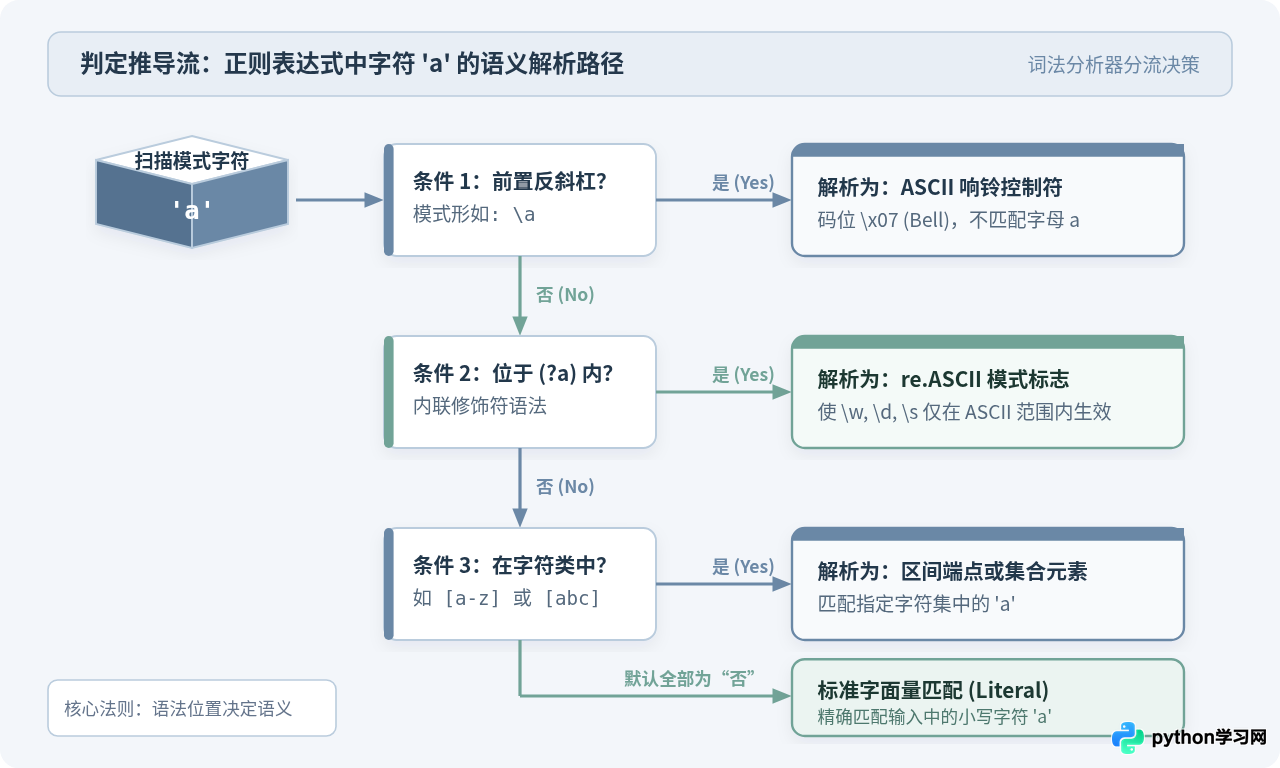
许多刚接触 Python 正则表达式的开发者常犯一个直觉性错误:以为给普通字母加上反斜杠只是“保险起见”,或者试图用 \a 来匹配字面量字符 a。在 Python 的 re 引擎中,这种写法会导致完全偏离预期的行为。
在 ASCII 编码体系中,\a 拥有专门定义的控制字符语义——即 ASCII Bell(响铃控制符,十六进制码位为 0x07)。历史上,这一控制符用于触发终端电传打字机的物理铃铛或扬声器蜂鸣;在现代正则引擎中,它被严格映射为匹配该控制字符本身。
\a 在正则中不是字符 a 的转义写法!在目标文本包含普通字母 a 时,使用 r'\a' 将导致匹配失败。
import re

normal_text = "cat"
bell_char_text = "alert:"

# 尝试用 \a 匹配普通文本 "cat"
print("用 \a 匹配普通字符 a:", re.search(r'', normal_text))

# 匹配包含实际 ASCII Bell 字符的文本
match_bell = re.search(r'', bell_char_text)
print("用 \a 匹配响铃符文本:", match_bell)
if match_bell:
print("匹配到的字符 ASCII 码:", ord(match_bell.group()))用 匹配响铃符文本: <re.Match object; span=(6, 7), match=''>
匹配到的字符 ASCII 码: 7
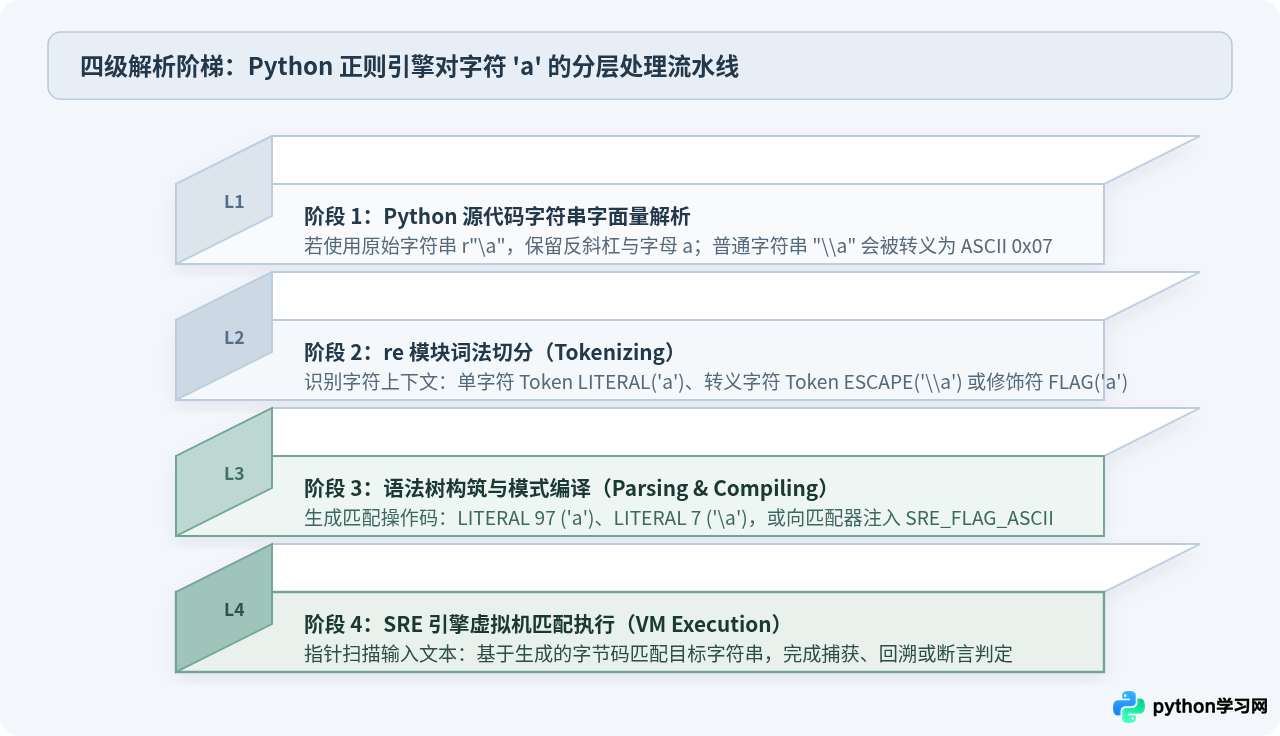
还要特别注意 Python 字符串本身的转义阶段。如果在定义模式时未使用原始字符串前缀 r,写成普通字符串 "\a",那么在代码被 Python 解释器解析时,就已经被提前转义成了单字节的响铃符 。为了让正则引擎按照既定规则工作,始终编写以 r 开头的原生字符串(如 r'\a')是工程上的必备习惯。
特殊用法二:内联标志 (?a) 与 re.ASCII 模式
除了前置反斜杠外,当字母 a 紧跟在 (? 之后并以 ) 闭合时,构成了 Python 正则特有的内联标志(Inline Flag)语法:(?a)。此时,字符 a 代表的是 ASCII 匹配模式(即 re.ASCII 或 re.A)。
默认 Unicode 模式与 ASCII 模式的根本差异
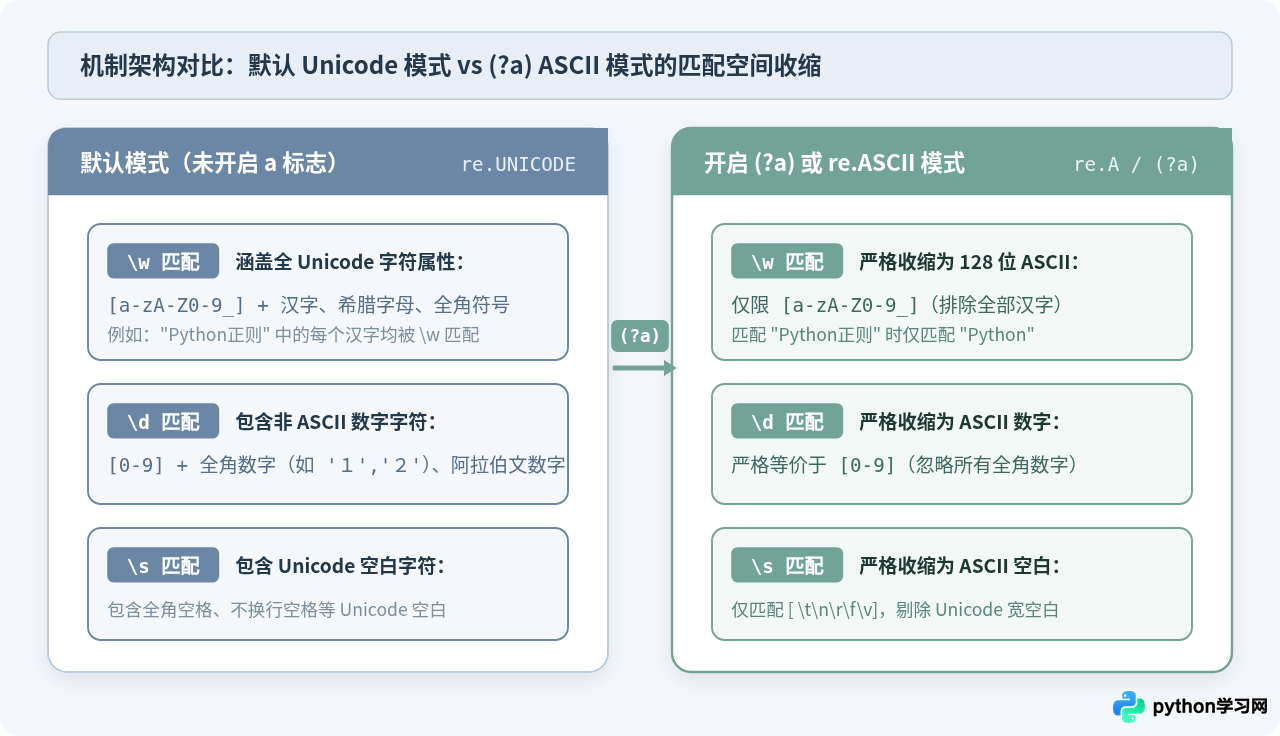
在 Python 3 中,正则表达式引擎默认处于 Unicode 模式。这就意味着内置的预定义字符集 \w(单词字符)、\d(数字字符)、\s(空白符)以及对应的边界符 \b 不仅匹配英文,还会包含整个 Unicode 数据库中符合分类属性的全部字符。例如,中文汉字默认属于 \w,全角阿拉伯数字也属于 \d。
如果希望将这些预定义字符集严格收束在 128 个标准 ASCII 码位以内(即 \w 只匹配 [a-zA-Z0-9_]),就可以在模式中加入 (?a) 修饰符。
import re

sample_text = "Python编程 2026年 123"

# 1. 默认模式:\w 匹配汉字,\d 匹配全角数字
default_words = re.findall(r'\w+', sample_text)
default_digits = re.findall(r'\d+', sample_text)

# 2. 启用 (?a) 限制:字符 a 作为修饰符
ascii_words = re.findall(r'(?a)\w+', sample_text)
ascii_digits = re.findall(r'(?a)\d+', sample_text)

print("默认 \w 匹配:", default_words)
print("ASCII (?a)\w 匹配:", ascii_words)
print("默认 \d 匹配:", default_digits)
print("ASCII (?a)\d 匹配:", ascii_digits)ASCII (?a)\w 匹配: ['Python', '2026']
默认 \d 匹配: ['2026', '123']
ASCII (?a)\d 匹配: ['2026']
在上述代码中,(?a) 中的字母 a 本身并不在文本中消耗任何字符,而是作为编译器的全局指令,直接改变后续符号的分类匹配集合。
特殊用法三:字符集、量词与命名组中的结构语义
除了转义序列与模式开关,字符 a 还会作为结构组成要素嵌入到不同的复合语法块中:
1. 字符集与区间端点:[a-z] 与 [^a]
在方括号 [...] 内部,字符 a 仍然保留匹配自身的字面量含义,但当它与连字符 - 结合使用时(如 [a-z]),它充当了 ASCII 码区间的起始端点。引擎依据 ASCII 码表从 a(97)连续取到 z(122),形成小写英文字母集合。若位于脱字符之后(如 [^a]),则表示否定字符类,匹配任意除 'a' 以外的单个字符。
2. 量词修饰的目标原子:a+ 与 a{2,4}
当字符 a 后方紧随贪婪或非贪婪量词(如 +、*、?、{m,n})时,它作为单一匹配原子被绑定在重复逻辑中。例如 r'a{2,}' 表达的是“连续出现两次及以上的字符 a”,而不再是单次判定。
3. 具名捕获组的标识符:(?P<a>...)
在具名捕获组语法中,字符 a 可以充当组名标识符。此时它的作用是作为 Python 字典键存在,供提取匹配结果时使用:
import re

# a 作为命名捕获组的键名
pattern_group = r'(?P<a>\d{3})-(?P<b>\d{4})'
match_obj = re.search(pattern_group, "Tel: 010-8888")

if match_obj:
    print("键名 'a' 提取的内容:", match_obj.group('a'))
print("字典化映射结果:", match_obj.groupdict())字典化映射结果: {'a': '010', 'b': '8888'}
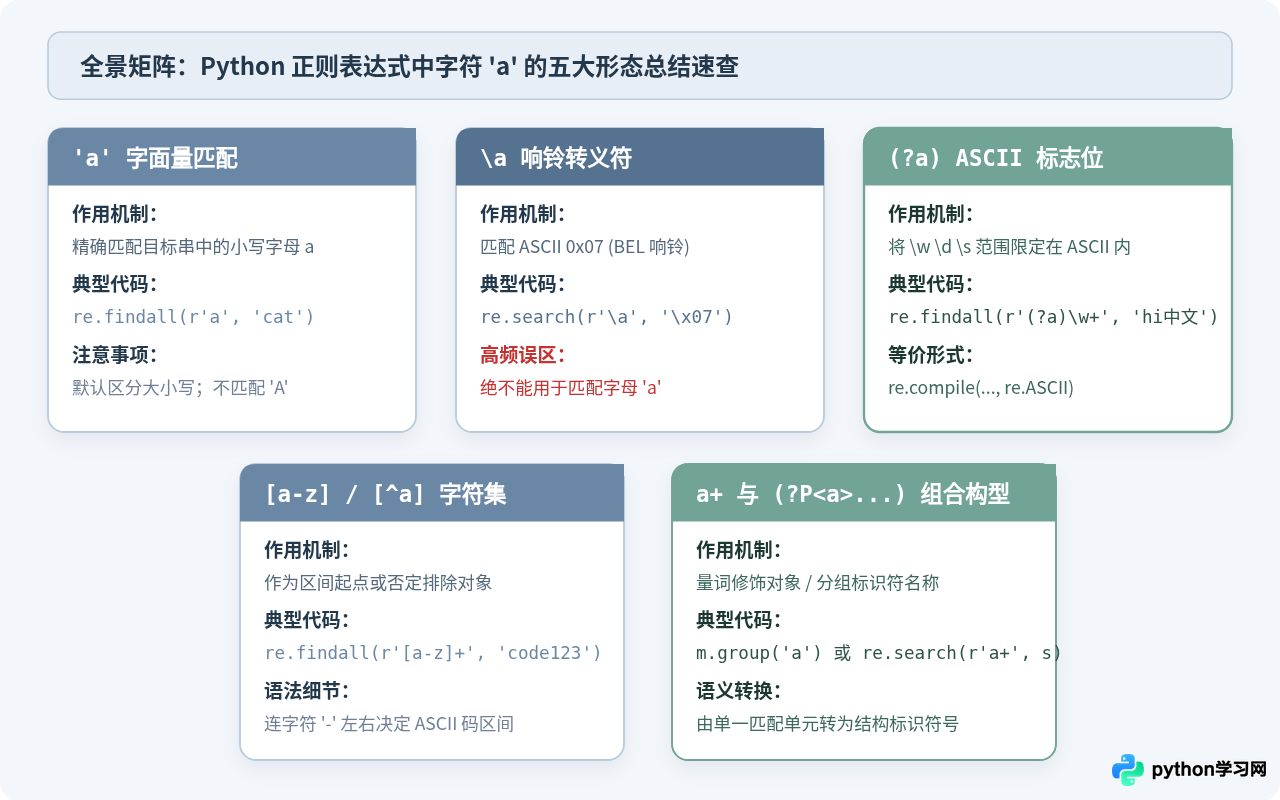
全用法对比与避坑决策矩阵
为了在实际编码与代码审查中快速定位问题,我们将字符 a 的五种主要形态及其工作边界归纳为如下决策表:
| 语法形态 | 语法分类 | 引擎实际含义 | 是否在目标串消耗字符 | 常见错误与排查提示 |
|---|---|---|---|---|
a |
普通字面量 | 匹配单个字符 'a' | 是(消耗 1 字符) | 默认不匹配大写 'A';需注意大小写设置 |
\a |
转义控制符 | 匹配 ASCII Bell(响铃符 0x07) | 是(消耗 1 控制符) | 绝不能写成匹配字母 a;若需匹配字面量只需写 a |
(?a) |
内联标志修饰符 | 激活 re.ASCII 模式限制 |
否(零宽修饰) | 改变全模式中 \w/\d/\s 的匹配范围 |
[a-z] |
字符类与区间 | a 到 z 范围内的任意单个字符 | 是(消耗 1 字符) | 连字符位置影响语义;[a-z] 与 [a] 区别显著 |
(?P<a>...) |
语法结构标识 | 命名捕获组的组名 | 由括号内子模式决定 | 仅作为结果提取时的索引键,不参与模式文本匹配 |
- 在 Python 中定义正则表达式时,一律使用
r'...'前缀,杜绝解释器层面的误转义。 - 要匹配普通字母 a,直接写
a,不要画蛇添足添加反斜杠。 - 如果处理国际化文本且需要过滤中文等非 ASCII 单词字符,显式使用
(?a)或在编译时传入flags=re.ASCII。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















