


Python数字字面量中下划线分隔符的使用方法
全面讲解Python数字字面量中下划线分隔符(PEP 515)的使用规则、核心原理、不同进制与浮点数分组实践、语法边界限制以及与字符串格式化的协作方法。
在 Python 代码中书写较大的数字或密集进制数据时,连续的零与十六进制字符极易引发肉眼清点错误。Python 从 3.6 版本起通过 PEP 515 正式引入了数字字面量中的下划线分隔符功能,允许在数字中间插入单个下划线 _ 作为视觉辅助分组。该特性在词法解析阶段被完全忽略,既不改变数值大小和变量类型,也不产生任何额外的运行时性能开销,是提升大型数值常量、位掩码及底层协议数据可读性的标准手段。
一、核心语法与基础应用场景
下划线分隔符本质上是一种代码排版语法糖。Python 词法分析器在解析数字字面量时,会自动剔除数字间的合法下划线,将其还原为纯数值结构。这意味着无论是十进制大整数、浮点数、科学计数法,还是二进制、八进制与十六进制字面量,都可以借助下划线进行语义化分组。
1. 十进制整数的千分位分组
对于财务金额、时间戳毫秒数或计数统计,最常见的阅读习惯是按照千分位(每三位一组)进行分隔:
# 传统书写方式,难以快速辨认是1000万还是1亿
timeout_ms = 100000000

# 推荐写法:使用下划线按千分位清晰分组
timeout_ms = 100_000_000

# 两者数值与类型完全一致
print(timeout_ms == 100000000)  # 输出: True
print(type(timeout_ms))          # 输出: <class 'int'>
2. 浮点数与科学计数法中的分组
高精度浮点数的小数部分以及科学计数法中的尾数与阶码,同样可以使用下划线来标明有效位:
# 物理常量与高精度小数
pi_val = 3.141_592_653_589
electron_charge = 1.602_176_634e-19

# 科学计数法的阶数部分也可以分组
large_power = 1e1_000  # 等同于 1e1000
3. 二进制、八进制与十六进制中的字节/半字节对齐
在涉及网络协议、硬件寄存器配置和图形渲染时,十六进制通常按字节(2位)或双字节(4位)分组,二进制通常按半字节(4位)或整字节(8位)分组:
# 8位二进制标志位:按4位半字节(nibble)分组
bit_mask = 0b1111_0000_1010_0101

# RGB颜色值:按通道(R、G、B各2位十六进制)分组
brand_color = 0xFF_57_33

# 32位内存地址或魔数:按16位(4位十六进制)分组
magic_number = 0xDEAD_BEEF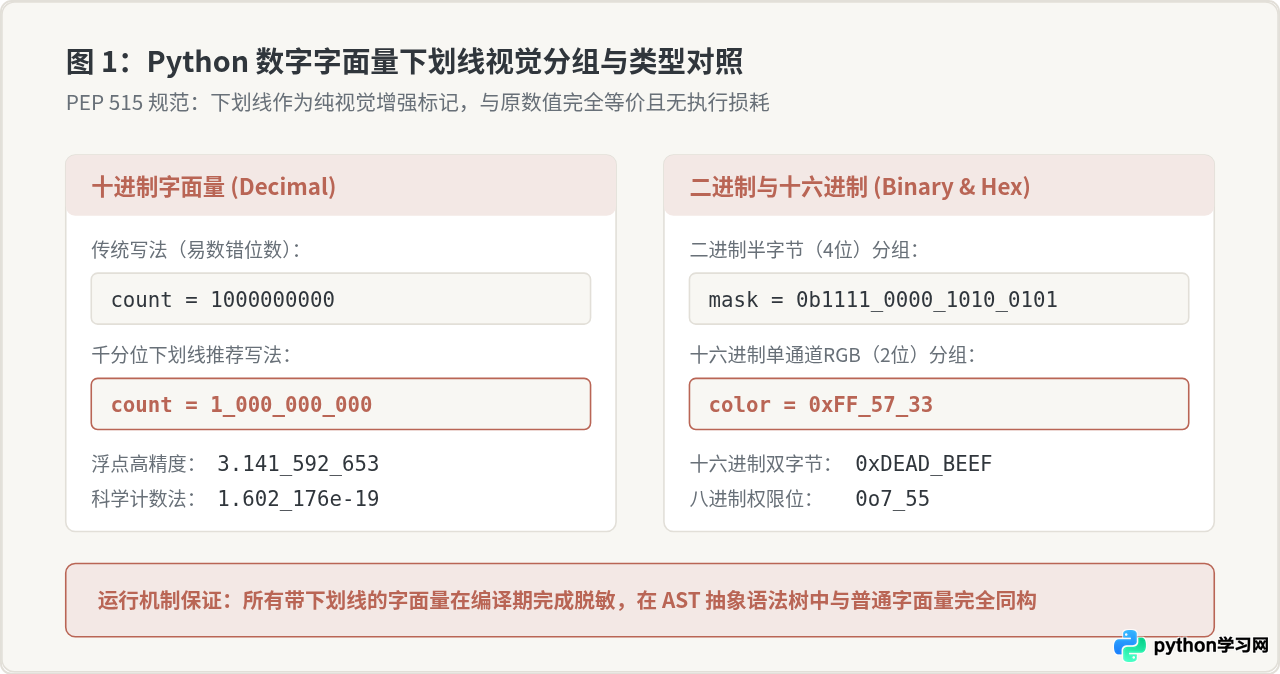
二、下划线放置的五项硬性语法边界
虽然下划线提供了极大灵活性,但为了防止歧义并保持词法分析的严谨性,Python 规定下划线只能置于有效数字之间。如果违背了位置规则,Python 解析器会在语法分析阶段直接抛出 SyntaxError: invalid decimal literal 错误。
1. 禁止作为开头或结尾
数字开头若加下划线(如 _100),会被 Python 语法解析器识别为一个普通变量标识符,而非数字;若放在末尾(如 100_),则会因缺乏后续数字直接触发语法错误:
# 错误示例
_100 = 50   # 这是合法变量名赋值,并不是数字 100
val = 100_  # SyntaxError: invalid decimal literal
2. 禁止连续出现多个下划线
每个分隔位置只能放置单个下划线,禁止连续并排书写两个或多个下划线:
# 错误示例
bad_number = 100__000  # SyntaxError: invalid decimal literal
3. 禁止紧挨小数点前后
小数点两边必须是纯数字,下划线不能直接黏连在 . 的左侧或右侧:
# 正确写法
pi = 3.14_15

# 错误写法:下划线紧挨小数点
bad_pi_1 = 3._1415  # SyntaxError: invalid decimal literal
bad_pi_2 = 3_.1415  # SyntaxError: invalid decimal literal
4. 禁止紧挨进制基数前缀
对于以 0b、0o、0x 开头的非十进制字面量,基数标记与其首位有效数字之间禁止插入下划线:
# 正确写法
valid_hex = 0x1A_2B

# 错误写法
bad_hex_1 = 0_x1A2B  # SyntaxError: invalid decimal literal
bad_hex_2 = 0x_1A2B  # SyntaxError: invalid hexadecimal literal
5. 禁止紧挨指数符号前后
在科学计数法中,e 或 E 符号与其前后数值之间不得直接放置下划线,符号两侧必须紧邻数字或正负符号后的数字:
# 正确写法
valid_sci = 1e1_000

# 错误写法
bad_sci_1 = 1_e6   # SyntaxError: invalid decimal literal
bad_sci_2 = 1e_6   # SyntaxError: invalid decimal literal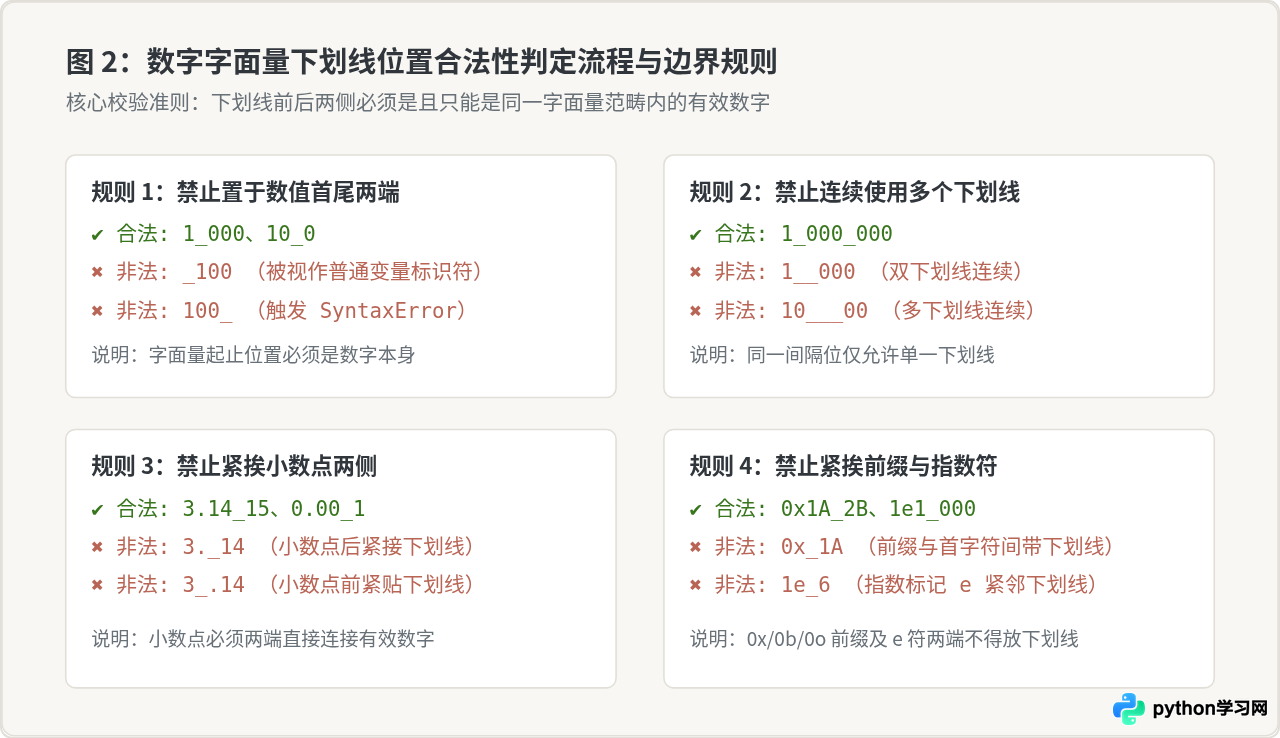
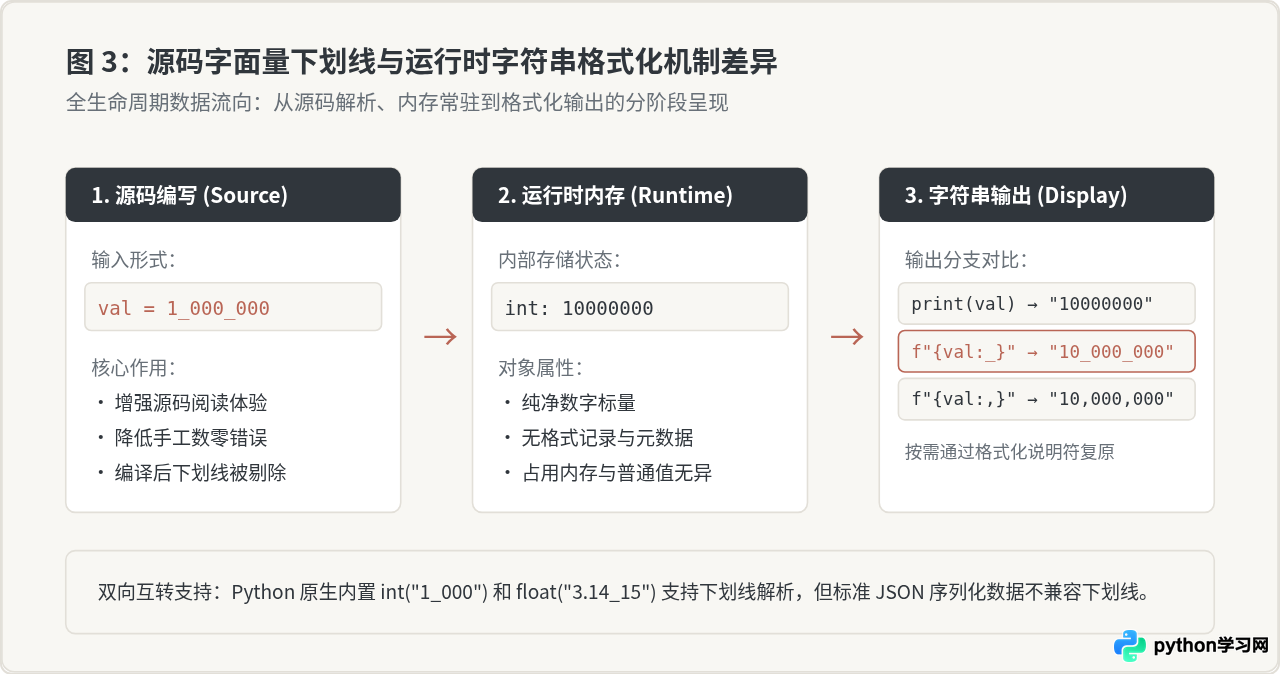
三、字面量下划线与格式化输出的关系
初学者容易产生一个认知误区:认为用 n = 1_000_000 定义的变量,在通过 print(n) 打印时也会自动带有下划线。实际上,字面量中的下划线仅在源代码编写阶段生效,一旦代码被编译为字节码,它就变成了纯粹的数值对象,并不保留最初在代码里切分的位置。
如果希望在程序运行时向终端或用户界面输出带有下划线或逗号分隔的数字字符串,需要显式使用 Python 的格式化机制(如 f-string):
total_amount = 10_000_000

# 直接打印:不会保留源代码中的下划线
print(total_amount)  # 输出: 10000000

# 使用 f-string 的 '_' 说明符:输出下划线千分位
print(f"{total_amount:_}")  # 输出: 10_000_000

# 使用 f-string 的 ',' 说明符:输出逗号标准千分位
print(f"{total_amount:,}")  # 输出: 10,000,000

# 十六进制输出时同样支持 '_' 说明符(按4位分组)
mask_val = 0xDEADBEEF
print(f"{mask_val:_x}") # 输出: dead_beef注意:字符串转换函数 int() 和 float() 同样支持解析带有下划线的字符串,例如 int("1_000_000") 可以正确返回整数 1000000。但外部通用协议(例如标准 JSON 规范)不识别带下划线的数字,因此在通过 json.loads() 处理数据时切勿传入包含下划线的数值文本。
四、工程实践中的分组规范建议
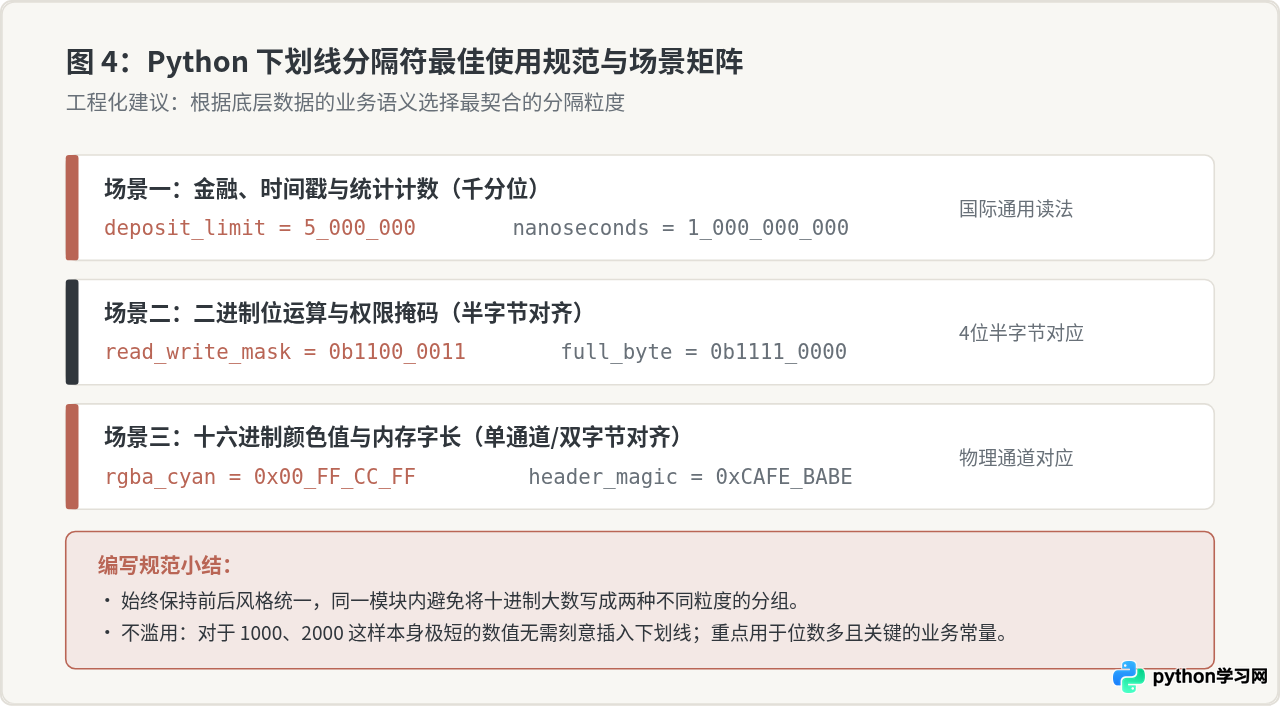
虽然语法只限制下划线必须位于数字之间,但滥用下划线同样会降低代码的可维护性。例如写出 1_0_0_0_0 这样的任意切分方式,反而会让阅读者产生困惑。在团队开发中,建议统一遵循以下几类工业界常见的约定:
| 数据语义类别 | 推荐分组跨度 | 代码规范示例 | 工程设计初衷 |
|---|---|---|---|
| 十进制常规大数 | 每 3 位一组 | 1_000_000_000 |
符合国际通用千进制计数习惯,一眼辨识数值量级。 |
| 高精度浮点常量 | 小数点后每 3 或 5 位 | 3.14159_26535 |
对齐数学/物理标准手册中的常数位次划分。 |
| 二进制位掩码 | 每 4 位(半字节) | 0b1010_1100_0011_1111 |
方便与十六进制单字符快速心算映射与寄存器校验。 |
| 十六进制颜色/地址 | 每 2 位(1字节) | 0xFF_57_33_AA |
对应 RGBA 独立通道,直观检查透明度与色彩分量。 |
| 固定位宽内存魔数 | 每 4 位(2字节/字长) | 0x7FFF_FFFF |
对应 16 位半字边界,快速确认是否有符号位溢出。 |
五、总结与回顾
Python 数字字面量中的下划线分隔符(PEP 515)是一个专为改善代码可读性而设计的轻量级语法特性:
- 核心机制:在词法解析阶段自动消除,不改变数值、不影响数据类型、零性能损耗。
- 使用限制:只能出现在有效数字之间,严禁置于首尾、严禁连续并排、严禁紧挨小数点、严禁黏连进制基数前缀(
0x、0b、0o)或指数符号(e)。 - 输出机制:变量求值后不自动附带下划线,若需向用户或日志输出带下划线/逗号格式的字符串,应配合 f-string 的
:_或:,格式化说明符使用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















