


学习Python后的职业方向:各应用领域对应的岗位与技能要求
深入解析学完Python后的主要职业发展方向,涵盖Web后端、数据分析、数据工程、人工智能与大模型、自动化运维及测试开发等关键领域的岗位职责、核心技术栈、工程能力标准与选型决策指南。
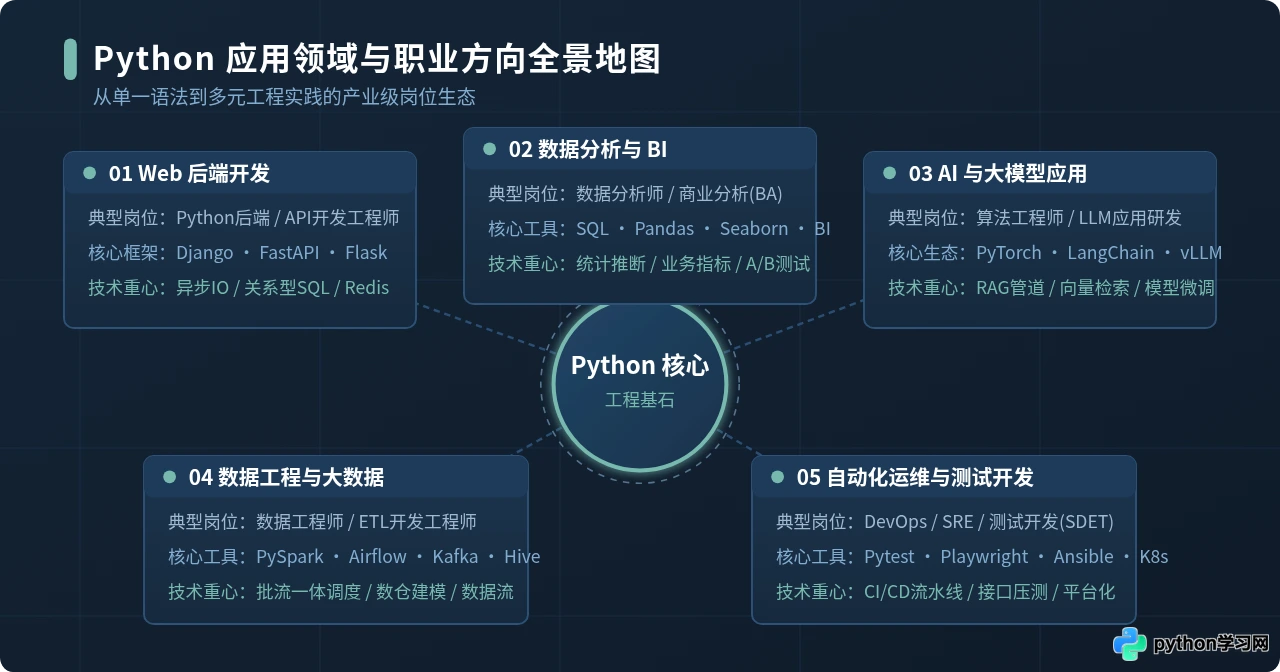
很多自学者在掌握了变量、列表、函数与面向对象语法,甚至照着教程写完几个基础爬虫之后,常会在招聘软件前陷入迷茫:市面上几乎没有名为“Python 程序员”的通用初级岗位。企业招聘从来不为“纯语法掌握”付费,而是需要工程师以 Python 为生产力工具,在特定工业场景中解决系统搭建、海量数据加工、智能模型封装或交付效能保障等实际问题。本文将系统拆解 Python 对应的五大主流就业领域、具体岗位职责、必备硬性技术栈及岗前能力验证标准,帮助你准确识别自身优势,确立高效的进阶路径。
一、核心认知:为什么不存在笼统的“Python 程序员”岗位?
在企业级开发生态中,Python 的角色是一门粘合型工程语言与通用计算接口。它因语法简洁、标准库完善、C/C++底层互操作能力强而在各大行业广泛落地。正因其应用场景极其广泛,不同业务线对 Python 工程师的能力要求存在巨大差异:
- Web 后端开发关注的是数据库事务、异步网络 I/O、接口响应延迟与高并发吞吐;
- 数据分析与商业智能关注的是多表关联查询、业务指标建模、统计显著性与商业决策归因;
- 数据工程与大数据关注的是大规模分布式计算、数据仓库分层架构、ETL 工作流容错与批流一致性;
- 人工智能与大模型应用关注的是模型推理吞吐、向量检索精度、上下文窗口管理与 Agent 工具编排;
- 自动化运维与测试开发关注的是持续集成流水线可靠性、基础设施代码化(IaC)、高并发接口压测与研发效能。
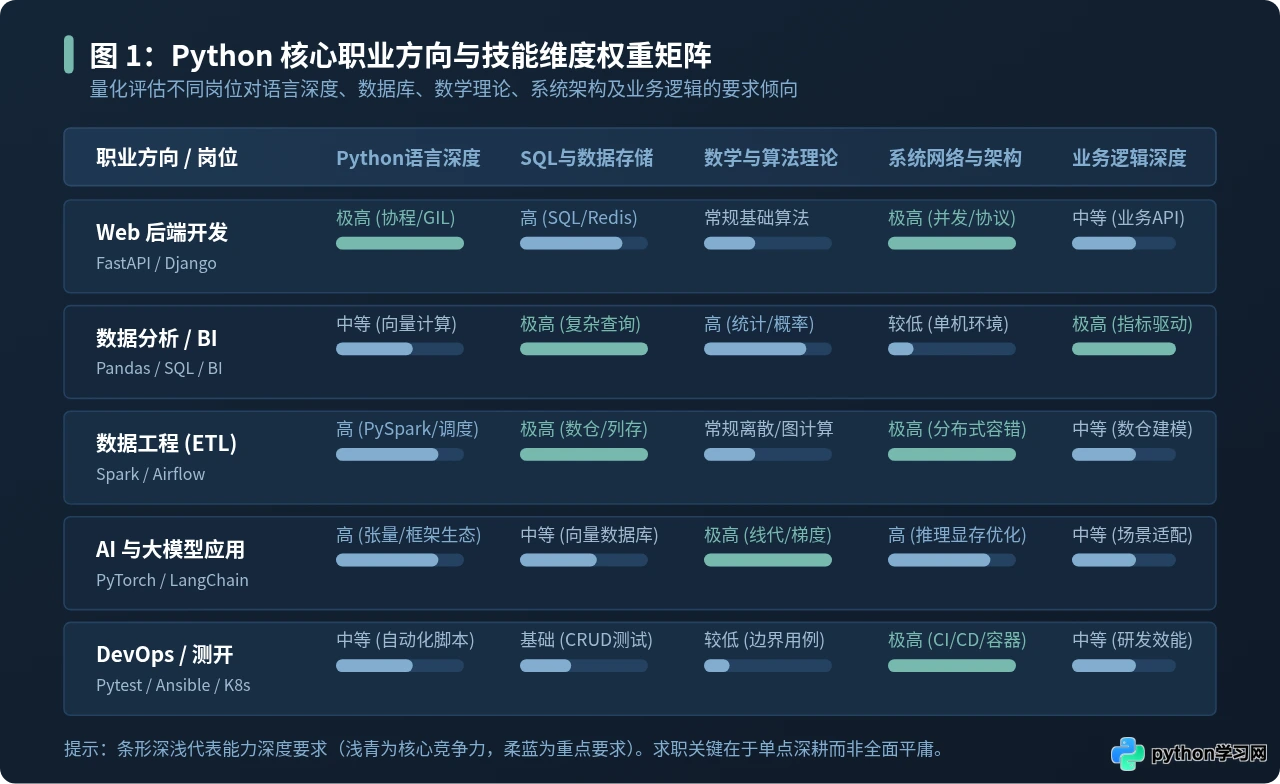
如果仅仅停留在“会用 Python 写几十行脚本”,而对上述垂直领域的专业底层理论、系统中间件和工程规范一无所知,在技术面试中很难通过筛选。明确赛道并建立完整的“Python + 领域技术栈”,是走向就业的必经之路。
二、Web 后端与服务接口开发
Web 服务是软件开发行业中基数最大的方向之一。在许多互联网企业、数字化转型组织以及 SaaS 初创公司中,Python 凭借其极高的迭代效率,常被选作核心业务服务、微服务接口与后台管理系统的首选语言。
1. 对应岗位名称
Python 后端开发工程师、API 服务开发工程师、全栈工程师(Python 后端方向)、业务中台开发工程师。
2. 核心工作职责
- 根据业务需求设计关系型数据库表结构,编写规范的 RESTful API 或 gRPC 服务接口;
- 接入用户鉴权体系(JWT / OAuth2),处理精细的角色权限控制(RBAC);
- 引入分布式缓存(Redis)降低数据库负载,优化接口响应至毫秒级;
- 构建异步耗时任务队列(处理文件导出、第三方 Webhook、消息推送等);
- 配合前端、移动端完成接口联调,编写自动化单元测试,确保线上系统稳定性。
3. 核心技术栈与技能要求
Django:全功能重型框架,内建强悍的 ORM、Admin 后台与身份验证机制,适合复杂业务中台与快速原型交付。
EXPLAIN 分析、锁机制与主从读写分离。Redis:String/Hash/ZSet 结构实操、缓存击穿/穿透/雪崩防御方案、分布式锁实现机制。
Celery / RabbitMQ:构建异步作业流水线、重试熔断机制、定时任务调度。
Docker & Nginx:反向代理、负载均衡、SSL 证书配置、多阶段构建容器镜像。
很多自学者的简历中只有“简易博客”或“学生管理系统”,这类项目无法证明工业级工程能力。能够吸引技术面试官的项目通常具备:① 基于真实业务场景的规范数据库索引设计;② 结合 Redis 缓存的防穿透与防刷机制;③ 结合 Celery 处理耗时任务的异步解耦;④ 代码库中包含覆盖核心接口的 pytest 自动化测试用例与 Dockerfile 部署文件。
三、数据分析与商业智能(BI)
数据驱动决策是现代企业精细化运营的核心。数据分析师的使命是将庞杂的原始业务数据转化为结构化洞察,用统计学和定量分析方法回答“业务现状如何”、“问题发生在哪里”以及“未来如何优化策略”。
1. 对应岗位名称
数据分析师(Data Analyst)、商业分析师(Business Analyst / BA)、商业智能工程师(BI 工程师)、产品/运营数据分析专家。
2. 核心工作职责
- 深入业务线提取生产库与数仓日志,清洗过滤缺失值、异常值与脏数据;
- 搭建业务核心经营指标体系(GMV、留存率、LTV、客单价、流失预警等);
- 设计并评估 A/B 测试实验,判断改版策略在统计学上是否具有显著提升;
- 使用 Python 自动化生成日常/周度业务报告,并将数据同步至交互式 BI 看板。
3. 核心技术栈与技能要求
- SQL(基石中的基石):掌握多表复杂关联(LEFT/INNER JOIN)、窗口函数(
ROW_NUMBER(),RANK(),LEAD(),SUM() OVER(...))、自联结与子查询优化。在数据分析岗位面试中,SQL 的考察权重通常高于 Python 代码本身。 - Python 数据分析核心库:
Pandas:熟练运用切片过滤、透视表(pivot_table)、分组聚合(groupby.agg)、合并连接(merge/concat)、时间序列处理及内存优化技巧;NumPy:理解多维数组切片、广播机制(Broadcasting)与向量化高效运算;Matplotlib & Seaborn:能够绘制符合专业出版标准的折线分布图、热力图、箱线图、散点矩阵图。
- 统计学与实验评估: 掌握正态分布、假设检验(t 检验、Z 检验、卡方检验)、p 值解释、置信区间、相关性分析与多元线性回归建模,能独立撰写科学严谨的 A/B 实验复盘结论。
- BI 可视化工具: Tableau、FineBI、PowerBI 等企业级可视化平台搭建,理解星型与雪花数据模型的数据集关联。
四、数据工程与大数据研发
当企业的数据规模从 GB 级别跃升到 TB 甚至 PB 级别时,单机 Pandas 处理就会遇到内存溢出(OOM)。此时需要数据工程师出场,负责构建海量数据的高并发采集、清洗流转、分布式计算与数仓架构设计。
1. 对应岗位名称
数据工程师(Data Engineer)、ETL 开发工程师、大数据平台开发工程师、数仓开发工程师。
2. 核心工作职责
- 设计并维护数据流管道(Pipeline),将多数据源(MySQL、业务日志、第三方 API)实时或离线导入数据湖仓;
- 规划数据仓库分层架构(ODS 原始层 -> DWD 明细层 -> DWS 汇总层 -> ADS 应用层);
- 编写大规模分布式批处理与流计算作业,解决数据倾斜、计算延迟与内存溢出问题;
- 通过工作流编排系统(如 Apache Airflow)管理成百上千个有依赖关系的定时任务。
3. 核心技术栈与技能要求
| 技术维度 | 核心组件 / 工具 | 掌握深度与实际应用场景 |
|---|---|---|
| 分布式计算 | PySpark / Spark SQL | 深入理解 RDD/DataFrame 转换算子、Shuffle 机制、广播变量、内存模型与数据倾斜调优。 |
| 任务调度编排 | Apache Airflow | 使用 Python 编写规范的 DAG(有向无环图)工作流,管理任务重试、依赖触发、告警通知与 XCom 传参。 |
| 数仓与列式存储 | Hive / ClickHouse / Delta Lake | 掌握维度建模理论(星型模型、雪花模型、缓慢变化维 SCD),针对海量分析查询做分区、分桶与向量化索引设计。 |
| 流式与消息中间件 | Apache Kafka / Flink 基础 | 理解数据流发布订阅模型、消费者组机制、增量数据捕获(CDC, 如 Debezium/Canal)。 |
五、人工智能与大模型应用开发
随着以 Transformer 为代表的深度学习架构和大语言模型(LLM)的普及,Python 在 AI 领域确立了无可动摇的统治地位。当前该领域的就业已分化为两大主要方向:侧重算法训练与理论创新的传统算法工程师,以及侧重大模型与企业业务深度集成的大模型应用开发工程师(LLM Application / Agent 研发)。
1. 对应岗位名称
机器学习工程师(MLE)、深度学习算法工程师、大语言模型应用工程师(LLM Application Engineer)、AI Agent 架构开发工程师。
2. 核心工作职责
- 模型微调与适配:利用企业私有语料,基于 LoRA / QLoRA 等参数高效微调技术对开源开源基座模型(如 Qwen、Llama 等)进行指令微调;
- 检索增强生成(RAG)管道搭建:对非结构化文档进行分块、嵌入(Embedding)、存入向量数据库,并实现基于混合检索(密向量 + BM25 稀疏检索)与 Rerank 重排的高保真知识库问答;
- 自主智能体(Agent)系统开发:通过 Function Calling、ReAct 模式,让大语言模型自主调用外部数据库查询、计算工具与业务 API 完成复杂流程编排;
- 推理加速与高并发服务交付:使用 vLLM、TensorRT-LLM 部署模型推理服务,利用流式传输(SSE)结合 FastAPI 暴露低时延 HTTP/WebSocket 接口。
3. 核心技术栈与技能要求
- 深度学习基石:
PyTorch框架熟练使用,掌握张量运算、自动微分机制(Autograd)、DataLoader 自定义数据加载与模型断点保存恢复; - 开源大模型生态:
Hugging Face Transformers、PEFT、vLLM,了解注意力机制、KV Cache 显存占用计算、量化方案(AWQ, GPTQ, GGUF); - 应用编排与向量数据库:
- 框架:
LangChain/LlamaIndex/ 自研轻量 Agent 执行器; - 向量存储:
Milvus,Chroma,Qdrant,pgvector; - 评估框架:
Ragas/TruLens,评估 RAG 检索命中率(Context Precision)与回答忠实度(Faithfulness)。
- 框架:
- 数学理论底蕴:线性代数(矩阵分解、向量空间投影)、概率论与数理统计、梯度下降与反向传播推导。
很多初学者误以为学习了几个月的机器学习算法包就能应聘“算法工程师”。实际上,传统头部大厂的模型研发岗对学历(重点院校硕博、顶级学术成果发表)要求极为严苛。对于普通背景或转行求职者,“大模型应用开发工程师”(聚焦 RAG 管道优化、Agent 编排与后端工程化落地)具有更高的就业成功率和更宽广的市场需求空间。
六、自动化运维(DevOps/SRE)与测试开发
软件工程的规模化推进使得系统稳定性和质量保障成为核心瓶颈。Python 简洁高效的语法,使其成为运维工程师进行集群治理、开发运维中台,以及测试工程师构建自动化质量屏障的标准武器。
1. 对应岗位名称
DevOps 工程师、SRE 站点可靠性工程师、自动化运维工程师、测试开发工程师(SDET)。
2. 核心工作职责
- DevOps / 运维方向:
- 开发企业级云管平台与自动化发布中台,实现资产统一纳管;
- 编写 Kubernetes Python 客户端脚本,实现容器应用的动态扩缩容、故障自动自愈;
- 整合 Prometheus / Alertmanager 编写智能巡检与故障预警脚本;
- 维护 GitLab CI / GitHub Actions / Jenkins 等 CI/CD 持续交付流水线。
- 测试开发方向:
- 搭建接口自动化测试框架,覆盖服务核心主流程并在每次代码合并时触发;
- 开发 Web / 移动端端到端 UI 自动化脚本(使用 Playwright / Selenium);
- 编写高并发性能压测脚本(使用 Locust),评估接口吞吐上限(QPS)与 P99 响应延迟;
- 开发内部测试效能工具(如测试数据工厂、Mock 仿真服务平台)。
3. 核心技术栈与技能要求
- 测试框架生态:深入精通
pytest框架(参数化@pytest.mark.parametrize、自定义fixture作用域、动态生成测试报告、pytest-xdist并行加速); - 自动化驱动工具:Web 自动化领域推荐使用现代高性能的
Playwright(相较 Selenium 具备更强的自动等待机制与网络拦截能力);网络接口测试使用requests/httpx; - 性能压测:
Locust(基于 Python 协程编写压测场景,支持分布式发压); - 云原生与基础设施:掌握 Dockerfile 编写、Kubernetes API 调用、Ansible 剧本编写、Linux 网络抓包(
tcpdump)与性能监控指标分析。
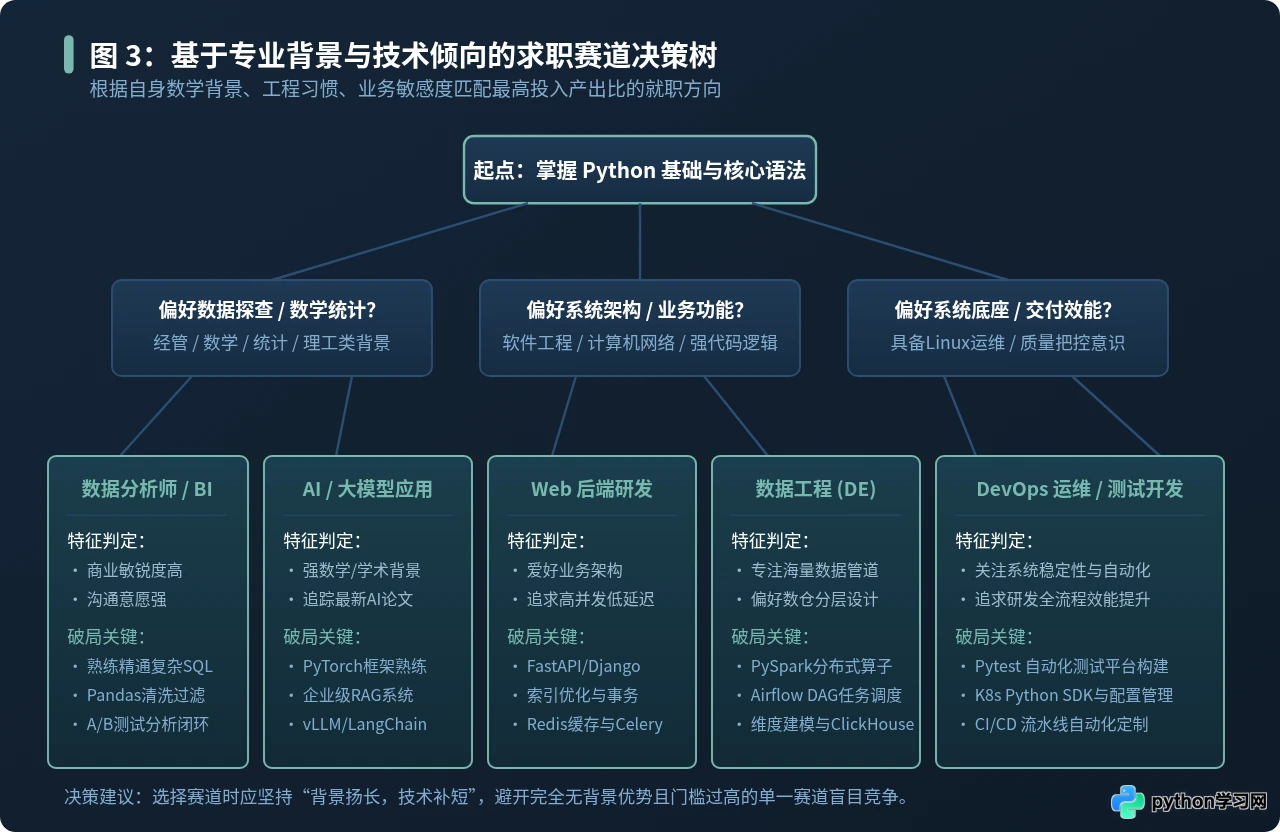
七、通用底座:所有 Python 工程师不可或缺的四项工程能力
无论最终选择哪个垂直分支,企业在考察候选人时,始终会关注代码的工业化成熟度。以下四项能力构成了 Python 工程师的通用底座:
1. Python 语言高阶特性与底层机制
日常写业务脚本与编写高可靠代码的分水岭在于对语言机制的理解深度:
- 生成器与迭代协议:使用
yield处理流式数据,避免一次性加载大文件导致内存暴涨; - 装饰器与闭包:深刻理解函数一等公民属性,掌握带参数装饰器、类装饰器,用于实现无侵入的权限校验、性能耗时统计与重试机制;
- 并发模型与 GIL:能够清晰辨析 CPU 密集型任务(使用
multiprocessing突破全局解释器锁)与 I/O 密集型任务(使用asyncio协程或threading)的设计选择; - 类型提示(Type Hints):在生产级代码中全面标注参数与返回值类型,配合
mypy静态检查工具,杜绝常见的AttributeError与TypeError。
2. 关系型数据库与 SQL 功底
几乎所有真实商业系统都依赖数据库存储核心资产。只依赖 ORM(如 Django ORM 或 SQLAlchemy)自动生成 SQL 是远远不够的。你必须能够手写复杂 SQL,理解 B+ 树索引的最左匹配原则,懂得如何避免全表扫描,并理解事务隔离级别(读未提交、读已提交、可重复读、串行化)如何解决脏读与不可重复读。
3. Linux 操作系统与网络协议
代码最终都会部署在 Linux 服务器或容器环境上。必备操作包括:使用 systemctl 管理系统守护进程、使用 journalctl 与 tail -f 排查应用崩溃日志、使用 netstat / ss 排查端口占用、使用 curl 测试服务可用性,以及掌握 HTTP 状态码规范、Header 缓存控制与 TCP 三次握手工作流程。
4. 工程规范与持续集成交付
个人开发者写代码“能跑通即可”,但企业研发团队看重的是“可维护性”与“团队协作效能”:
- 遵循 PEP 8 规范,使用
Ruff或Black实现自动化格式排版; - 采用语义化 Git Commit 提交信息,严格执行分支协作流程(Feature -> PR / Merge Request -> Release);
- 具备环境依赖隔离意识,使用
Poetry或Pipenv锁定lock文件,避免版本漂移导致生产事故; - 编写单元测试与覆盖率统计(
pytest --cov),确保重构时不破坏既有业务逻辑。
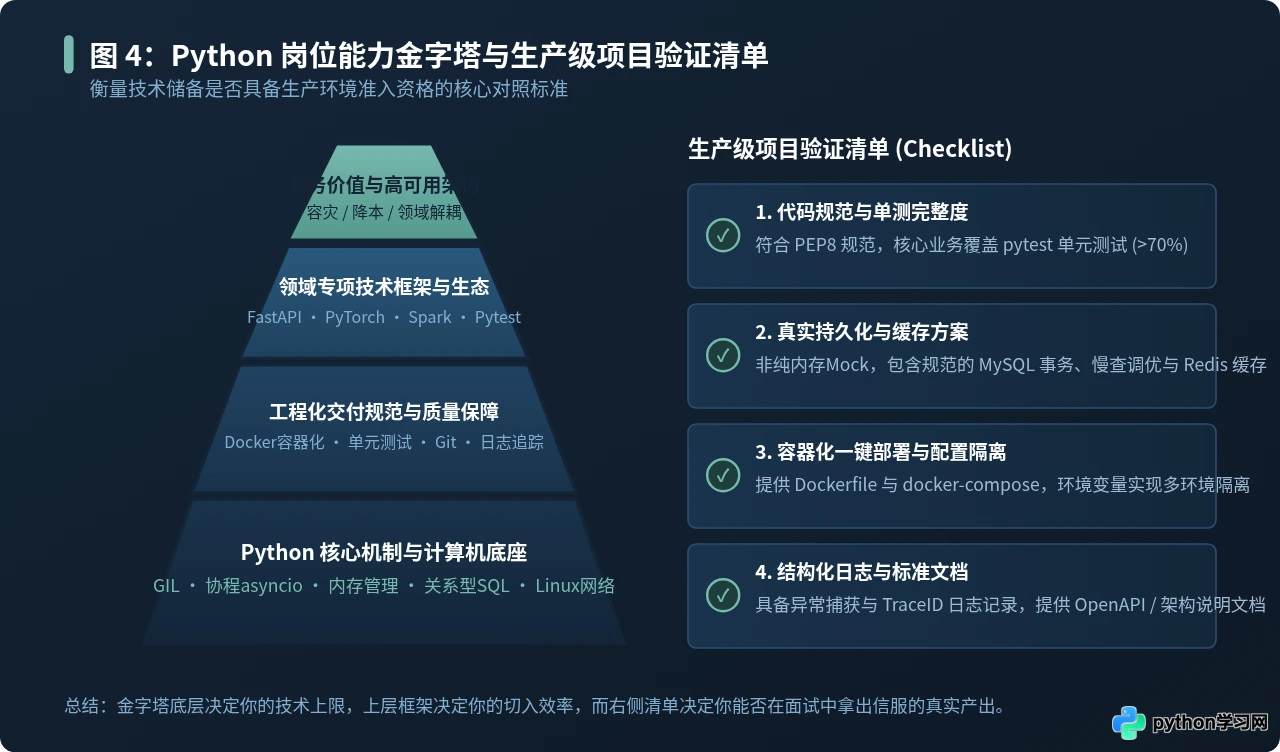
八、求职准备核心误区与避坑指南
在辅导和交流求职经历的过程中,我们发现自学与转行候选人经常踩入几个典型陷阱:
由于许多入门教程以爬虫作为趣味案例,不少初学者花费数月钻研反爬、JS 逆向与代理池,并试图应聘“爬虫工程师”。必须客观看待当前市场环境:纯爬虫岗位由于合规风险与法律监管正在急剧萎缩,多数需求已被集成到常规数据工程或采集模块中。把爬虫当作获取数据的辅助手段是合理的,但不宜将其当作职业生涯的单一支柱。
简历中的项目经验如果是“泰坦尼克号生存预测”、“电商图书商城”、“豆瓣电影 Top250 数据看板”等烂大街案例,面试官一眼就能识别出属于机械复刻教程。打动面试官的项目必须具备真实性与复杂度:例如引入了真实多表业务逻辑、处理了并发场景下的超卖问题、设计了合理的异步队列重试,或者在 RAG 系统中实际调优了文本检索的召回率与时延指标。
简历上罗列了“掌握 Django、熟悉 Pandas、了解 PyTorch、会用 Pytest”,看似全能,但在每个专项面试官面前都接不住深层技术追问。技术招聘更青睐“T 型人才”:在某一个垂直领域(如 Web 异步接口或数据分析)有扎实的项目落地和底层深挖,其余领域具备通用理解即可。
九、总结与行动建议
学习 Python 只是你进入软件工程与数据世界的第一步。从语法掌握到成功就业,本质上是一场技术栈定向补全与工程能力升级的过程:
- 定位清晰:根据自身的学科背景与职业偏好,对照本文第三节的决策树,在前五大方向中选定一条主赛道;
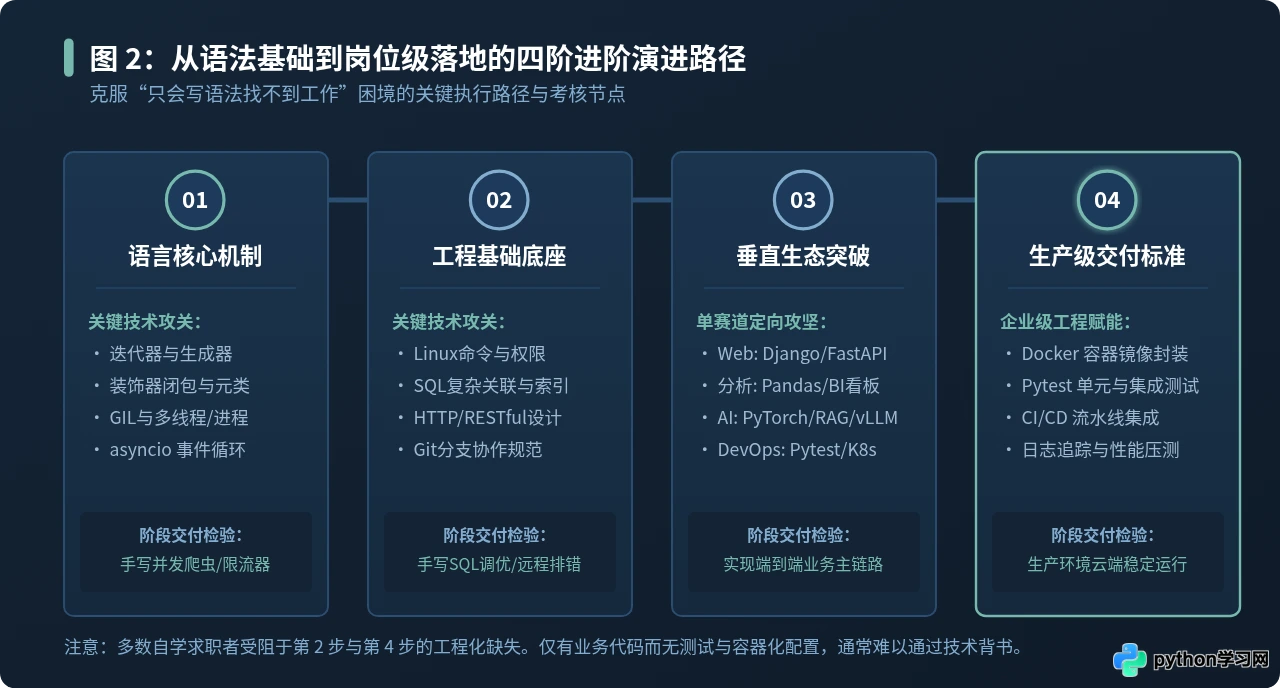
- 筑牢底座:系统补充关系型 SQL 查询优化、Linux 系统命令操作与 Git 分支开发规范;
- 深耕生态:围绕选定的方向,熟练掌握 1~2 个主流工业级框架,读懂官方文档与核心 API 设计理念;
- 打造标杆作品:按照生产级规范完整实现一个具备容器化配置、单元测试覆盖、完整错误日志记录与清晰 README 文档的独立项目,将其作为求职交付的硬核资产。
保持对代码底层原理的好奇心,以工程可靠性为交付基准,脚踏实地完成从“代码书写者”到“生产问题解决者”的蜕变。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















