


Python怎么按条件提取字符串中的特定字符
详细讲解在Python中如何按条件提取字符串中的特定字符。涵盖列表推导式结合内置字符判断、集合白名单过滤、正则表达式模式匹配及反向提取的完整步骤与性能对比。
在 Python 中按条件提取字符串中的特定字符,本质是将源字符串作为字符序列进行遍历,通过布尔逻辑判定保留符合条件的字符,再通过 ''.join() 聚合成目标字符串。最常见且高效的方式是使用列表推导式配合内置字符串方法(如 isdigit()、isalpha());面对离散的字符限制时,采用集合(set)白名单能够实现常数级时间查找;而当提取条件涉及复合结构、上下文环视或特定边界时,标准库中的 re(正则表达式)则是更适用的手段。本文将详细讲解这几种方式的具体操作步骤、关键差异与注意事项。
一、使用列表推导式按单字符属性提取
列表推导式是 Python 中处理字符串字符提取最直观、易读的方案。其标准结构为:在推导式内部使用 for char in text 逐字符遍历,在 if 子句中编写判别条件,最后借助 ''.join() 将过滤出来的字符列表合并为连续字符串。
1. 提取所有数字字符
当源字符串中夹杂着各种字母、标点符号,而业务要求仅保留其中的纯数字时,可以直接调用字符串内置的 char.isdigit() 方法。
# 示例代码:提取文本中的所有纯数字
raw_text = "订单编号: No.2026-X8849_Ver#3"

# 列表推导式结合 str.isdigit()
digits_list = [char for char in raw_text if char.isdigit()]
result_digits = ''.join(digits_list)

print("提取结果:", result_digits)2. 提取英文字母或特定大小写
如果提取目标是英文字母,可以使用 char.isalpha()。若需要进一步区分大小写,例如仅抽取大写状态码或首字母缩写,可在条件中叠加 char.isupper() 或 char.islower()。
# 示例代码:提取大写字母和所有英文字母
data_str = "Report-2026_Approved_By_Admin"

# 仅保留大写字母
upper_only = ''.join([c for c in data_str if c.isupper()])

# 保留所有英文字母
alpha_only = ''.join([c for c in data_str if c.isalpha()])

print("仅大写:", upper_only)
print("纯字母:", alpha_only)纯字母: ReportApprovedByAdmin
3. 提取中文字符(汉字)
提取中文字符通常依赖字符的 Unicode 编码区间。常用汉字的 Unicode 范围为 一 到 龥。只要字符落在这个区间内,即可判定为中文字符。
# 示例代码:从混合文本中提取中文字符
mixed_content = "状态报告: 任务执行成功 (Latency: 15ms) [已归档]"

# 判定字符落在中文 Unicode 区间
chinese_chars = ''.join([c for c in mixed_content if '\u4e00' <= c <= '\u9fa5'])

print("中文字符:", chinese_chars)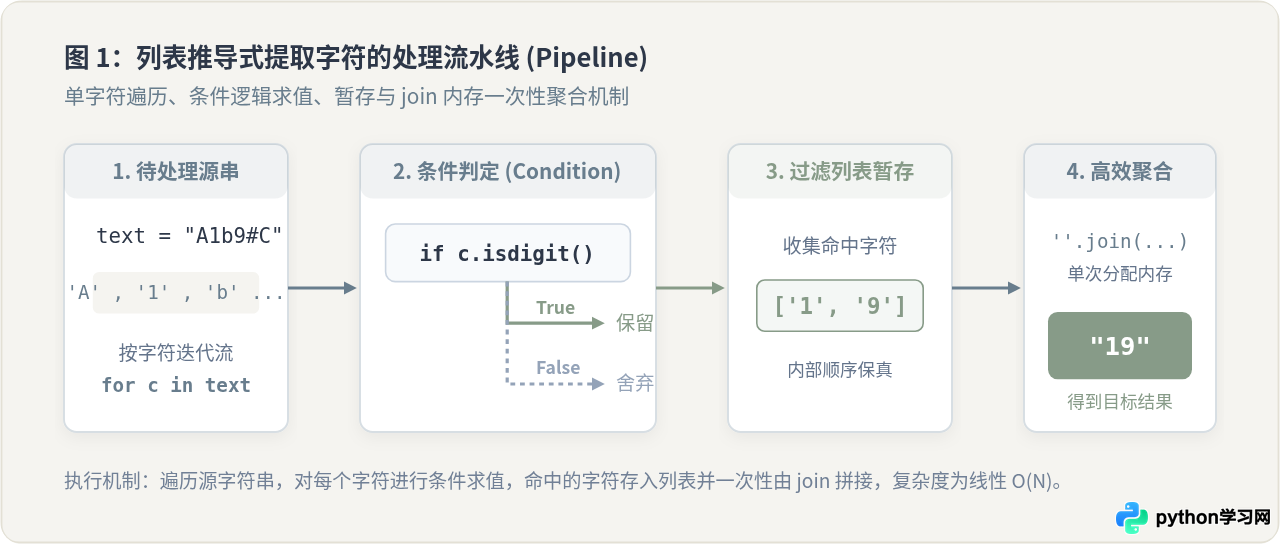
二、基于集合白名单与黑名单的精确提取
在很多实际业务场景中,需要提取的字符并不属于纯数字或纯字母等标准类别,而是由特定字符组成的集合。例如:提取十六进制字符(0-9 以及 a-f、A-F)、提取变量命名合法字符(字母、数字与下划线),或是排除某些特定的干扰标点。
此时,定义一个 set(集合)作为“白名单”或“黑名单”是最清晰且运行效率最高的做法。Python 中集合的成员判断 char in allowed_set 采用哈希表查找,单次操作的时间复杂度为 $O(1)$,即使白名单字符较多也不会降低判断速度。
1. 白名单模式:仅保留指定合法字符
# 示例代码:提取合法的十六进制字符
hex_source = "Packet_Data: #0x4A, 0xFF, checksum=0x9B;"

# 构建白名单集合
hex_allowed = set("0123456789abcdefABCDEF")

# 过滤保留
cleaned_hex = ''.join([c for c in hex_source if c in hex_allowed])

print("提取后的十六进制字符流:", cleaned_hex)2. 黑名单模式:排除特定非法或干扰字符
如果绝大部分字符都需要保留,仅需剔除特定的几个符号(如换行符、斜线或星号),采用 not in blocked_set 更为简便。
# 示例代码:排除黑名单中的特殊符号
raw_name = "path/to*invalid:file?name#01.txt"
forbidden = set("/\\:*?\"<>|#")

sanitized_name = ''.join([c for c in raw_name if c not in forbidden])
print("剔除黑名单字符后:", sanitized_name)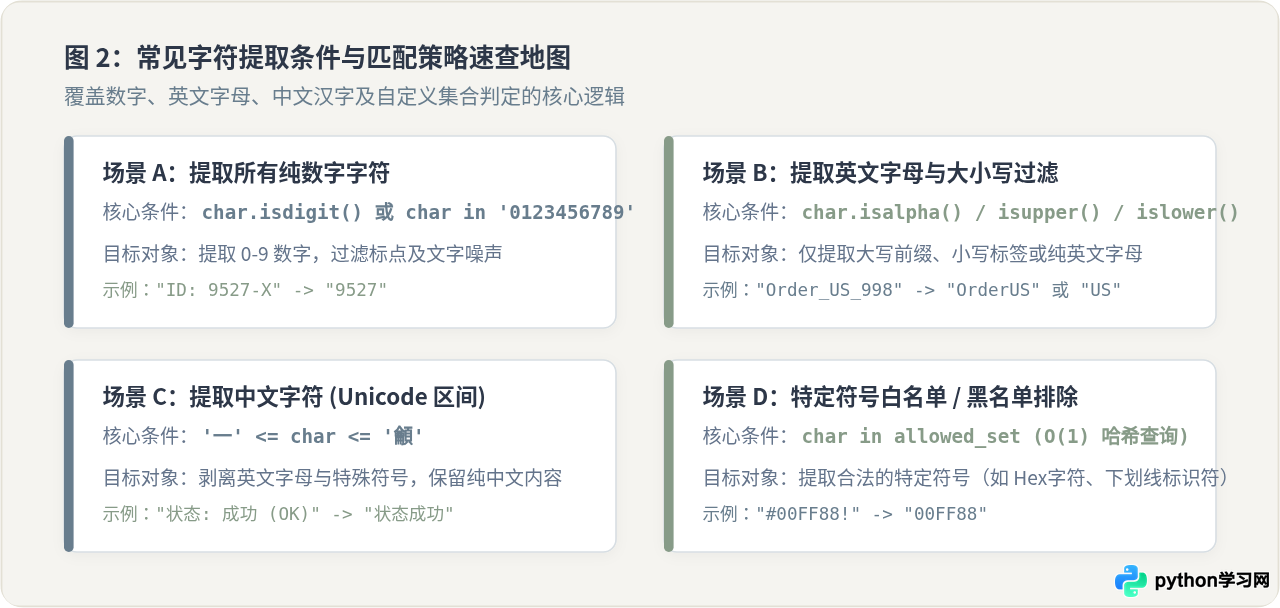
三、列表推导式与正则表达式的关键差异
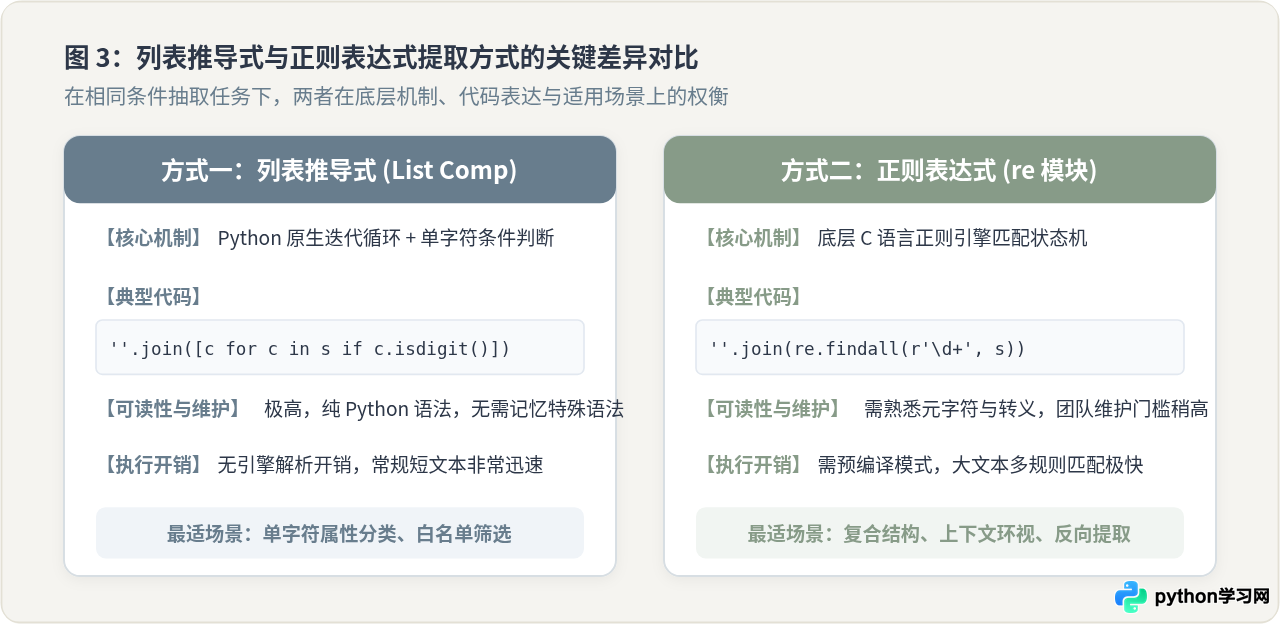
在按条件提取特定字符时,开发者最常犹豫的两种途径是“列表推导式”与“正则表达式(re 模块)”。为了在实践中做出合理选择,我们需要在一致的测试条件下评估两者的核心差异:
设定测试场景:从混合字符串 "Code: #A2026-v8.9" 中提取所有的字母与数字,过滤其他所有符号。
- 列表推导式写法:
''.join([c for c in s if c.isalnum()]) - 正则表达式写法:
''.join(re.findall(r'[a-zA-Z0-9]', s))或re.sub(r'[^a-zA-Z0-9]', '', s)
| 对比维度 | 列表推导式 (List Comprehension) | 正则表达式 (re 模块) |
|---|---|---|
| 底层实现机制 | 在 Python 解释器虚拟机中逐字符循环迭代,调用内置 C 函数判定。 | 由底层 C 编写的独立正则引擎根据状态机进行模式匹配。 |
| 代码可读性与维护 | 依赖通用 Python 语法,逻辑直白,新加入团队的成员无理解障碍。 | 依赖正则语法与特殊转义符,规则复杂时容易出现“可写不可读”的维护困难。 |
| 短文本执行开销 | 无正则模式的编译与解析开销,单次短文本提取响应极快。 | 若未预编译,正则对象解析存在轻微初始化开销。 |
| 复杂模式表达能力 | 仅能直接处理“针对当前单个字符”的属性判断,难以表达上下文环视或多字符边界。 | 极强,天然支持前后字符约束、量词、分组捕获以及上下文条件。 |
| 反向清洗便利度 | 需在推导式中编写复杂的取反逻辑(not in 或 not condition)。 |
re.sub(r'[^...]', '', s) 能够简洁地完成反向剔除。 |
为什么这些差异很重要?在单字符属性(如提取数字、英文字母、固定白名单)的简单场景下,列表推导式无论在可读性还是调用直观性上都明显更胜一筹,无需额外引入外部模块;但如果字符的提取条件与前后文相关(例如“仅提取括号内的字符”或“仅提取特定单词后面的数字”),列表推导式需要自行维护状态机,代码复杂度会急剧上升,此时必须交由正则表达式处理。
四、使用正则表达式处理复合条件与上下文提取
当条件提取涉及更复杂的规则时,Python 标准库中的 re 模块提供了两种标准提取手段:一种是正向匹配所有符合条件的字符(re.findall),另一种是反向剔除不符合条件的字符(re.sub)。
1. 使用 re.findall 正向抽取字符序列
通过字符集方括号 [...] 声明所需提取字符的组合,通过 ''.join() 将匹配出的字符列表连在一起。
import re

# 示例代码:提取所有字母、数字及下划线
raw_content = "Device_ID: (ESP32-S3) [Rev#1.2] Status: OK!"

# 匹配所有大小写字母、数字及下划线
matched_chars = re.findall(r'[a-zA-Z0-9_]', raw_content)
result_str = ''.join(matched_chars)

print("提取结果:", result_str)2. 使用 re.sub 反向剔除非目标字符
有时候使用排除法更加简练。通过字符集内部开头的插入符 ^,表示“非”该集合中的字符,并将其直接替换为空字符 ''。
import re

# 示例代码:反向过滤,仅保留数字和小数点
price_text = "特价优惠: ¥1,299.50元 (含税)"

# 将除了 0-9 和 . 之外的所有字符替换为空字符串
cleaned_price = re.sub(r'[^0-9.]', '', price_text)

print("提取金额数字:", cleaned_price)3. 提取带上下文边界的特定字符
如果提取的字符必须满足位置要求,例如“仅提取圆括号 (...) 内包含的英文字符”,可以结合正则的环视或匹配后提取:
import re

text_with_context = "用户 [admin] 提交了申请,审批人 (director_zhang) 已确认。"

# 提取被圆括号包裹的内容中的英文字符
# 先提取圆括号内部的文本块,再提取其中的字母
blocks = re.findall(r'\((.*?)\)', text_with_context)
extracted = [''.join([c for c in b if c.isalpha()]) for b in blocks]

print("提取括号内字母:", extracted)五、关键避坑提醒与技术选型指南
Python 中的字符串(str)是不可变对象。每次执行 res += char,系统都会重新开辟内存并将旧字符串与新字符复制一份,循环 $N$ 次会导致 $O(N^2)$ 的时间开销。正确的做法始终是收集为列表,最后调用 ''.join(chars) 一次性聚合,时间复杂度保持在 $O(N)$。
Python 3 中的 str.isdigit() 遵守 Unicode 标准,它不仅对半角 ASCII 数字 0-9 返回 True,对全角数字(如 123)、罗马数字上标等同样返回 True。如果业务场景需要严格的 ASCII 纯数字,建议写为 char in '0123456789',或使用 char.isascii() and char.isdigit()。
总结与选型速查
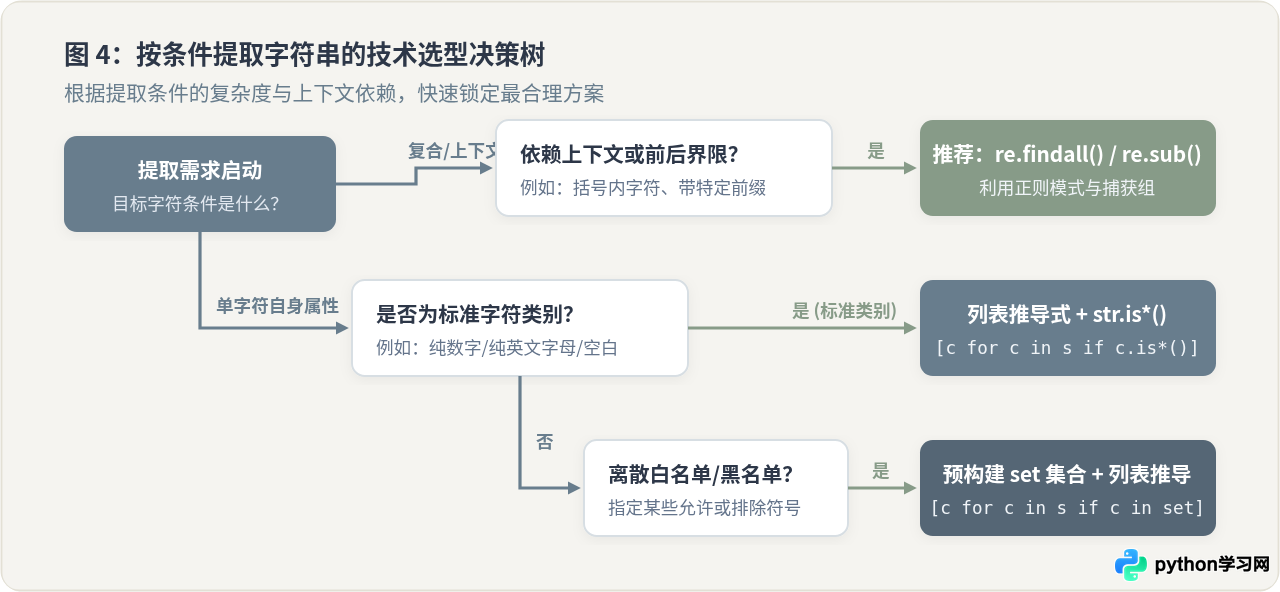
- 提取标准类别字符(纯数字、纯字母、大小写、汉字):首选 列表推导式 + 内置方法/编码区间。语法最简明,无外部依赖。
- 提取离散定制符号集(如特定标点、Hex值):首选 预设 set 集合 + 列表推导式。集合哈希检索带来稳定的极高查询性能。
- 反向清除大量杂质:首选
re.sub(r'[^...]', '', text)。一句话完成否定规则替换。 - 依赖上下文、界定符或复杂匹配:首选
re.findall()配合模式组。充分发挥正则引擎在模式匹配上的强大表达力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















