


Python字典和切片操作中的冒号用法及常见报错
深入解析Python中冒号在序列切片与字典结构中的不同语法角色,系统剖析左闭右开区间、步长跳转、键值映射约束以及常见报错原因与排查方案。
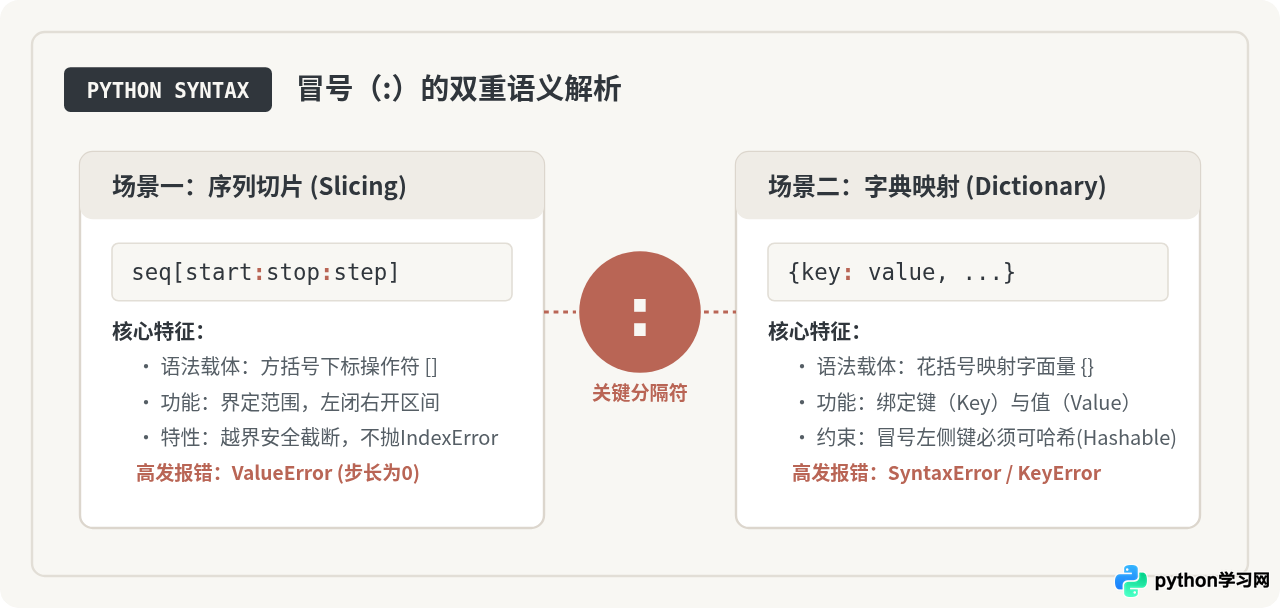
:)扮演着截然不同的双重角色:在序列切片(Slicing)中,它作为范围界定符,控制起止索引与推进步长;在字典(Dictionary)中,它作为键值映射符,将键与内存中的对应对象建立哈希关联。混淆二者的语法上下文、越界认知错误或传入不合法的参数类型,会引发 SyntaxError、TypeError、ValueError 及 KeyError。本文全面拆解切片与字典中冒号的底层运行机制,剖析边界条件与行为规则,并提供常见异常的诊断与修复方案。
一、序列切片中冒号的语法规范与推导机制
在 Python 中,支持序列协议的对象(如列表 list、元组 tuple、字符串 str 和字节串 bytes)均可通过方括号内的切片操作提取子序列。切片通过冒号将表达式拆分为最多三个参数,其标准语法格式如下:
# 序列切片基础语法模版
sequence[start:stop]
sequence[start:stop:step]
当解析器遇到方括号内的冒号时,会调用内置的 slice(start, stop, step) 类构造一个切片对象,并传递给序列的 __getitem__ 特殊方法。理解切片中的冒号,必须掌握以下四项核心法则:
- 左闭右开区间:切片严格遵循数学上的半开半闭区间
[start, stop)。截取结果包含起始索引start处的元素,但不包含终止索引stop处的元素。例如s[1:4]仅抽取索引为 1、2、3 的三个元素。 - 参数缺省替换规则:切片表达式中的三个参数均可缺省。当
start缺省时,正向步长下默认指向序列首端(索引 0);当stop缺省时,默认指向序列末尾(包含最后一个元素);当step缺省时,默认为 1。单冒号形式s[:]则代表复制从头到尾的全部元素。 - 步长推进机制:
step控制移动步幅与前进方向。当step > 0时,索引由左向右递增;当step < 0时,索引由右向左递减。若省略start和stop而指定负步长[::-1],Python 会自动将起点视为最末端、终点视为首端前驱,从而实现序列翻转。 - 容错与安全截断特性:切片与单元素索引(Indexing)有着本质区别。直接访问单元素
seq[99]若越界会立即抛出IndexError;但切片操作具备容错截断机制,当start或stop超出序列真实长度时,解释器会自动将其规整为序列的实际边界,不抛出异常。
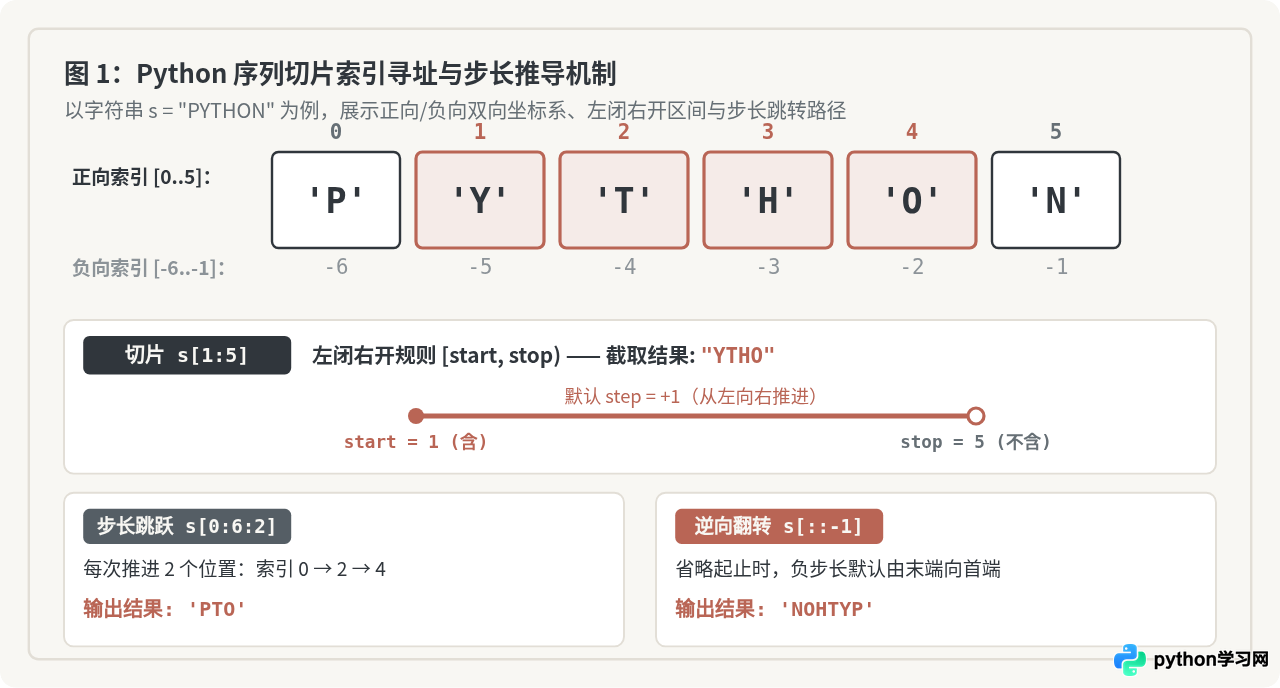
下面的代码清单展示了切片冒号在常规截取、步长采样、越界截断及负索引逆序中的典型应用:
# 切片冒号语法示例
text = "PYTHON"

# 1. 基础左闭右开截取:包含索引 1,不含索引 5
print(text[1:5])      # 示例输出: 'YTHO'

# 2. 省略边界与指定步长采样
print(text[::2])       # 示例输出: 'PTO' (取索引 0, 2, 4)

# 3. 负步长倒序翻转
print(text[::-1])      # 示例输出: 'NOHTYP'

# 4. 越界安全截断(不抛出 IndexError)
print(text[2:100])    # 示例输出: 'THON'
二、字典结构中冒号的映射语义与语法约束
与切片用于划分连续索引不同,字典(dict)是哈希表的实现。字典中的冒号是键值关联符号,强制建立从“键(Key)”到“值(Value)”的映射链接:
# 字典字面量语法规范
mapping = {
    "name": "Alice",
    "age": 25,
    "scores": [95, 88, 92]
}
在书写字典中的冒号时,必须严格遵守以下底层语法与语义约束:
- 冒号两侧的类型对称性与限制:冒号右侧的
Value可以是任意类型的对象(包含可变列表、嵌套字典或自定义函数);但冒号左侧的Key必须是可哈希对象(Hashable)。在 Python 原生类型中,数字、字符串、元组(其元素也必须全为可哈希)可以充当键,而列表、集合、字典等可变对象严禁作为键。 - 字典推导式(Comprehension)位置限定:在构建字典推导式时,冒号只能出现在最前端的键值输出对中,例如
{k: v for k, v in pairs}。在后端的循环语句for ... in ...以及过滤分支if condition中均不得出现冒号,否则会被解释器标记为语法错误。 - 花括号上下文辨析(Dict vs Set):Python 中字典与集合均使用花括号
{}定义。解析器通过花括号内部是否存在冒号来判决类型:逗号分隔的单值元素{"a", "b"}解析为集合(set),而带冒号的键值对{"a": 1, "b": 2}解析为字典(dict)。空花括号{}在 Python 语法中默认判定为空字典,创建空集合需显式使用set()。
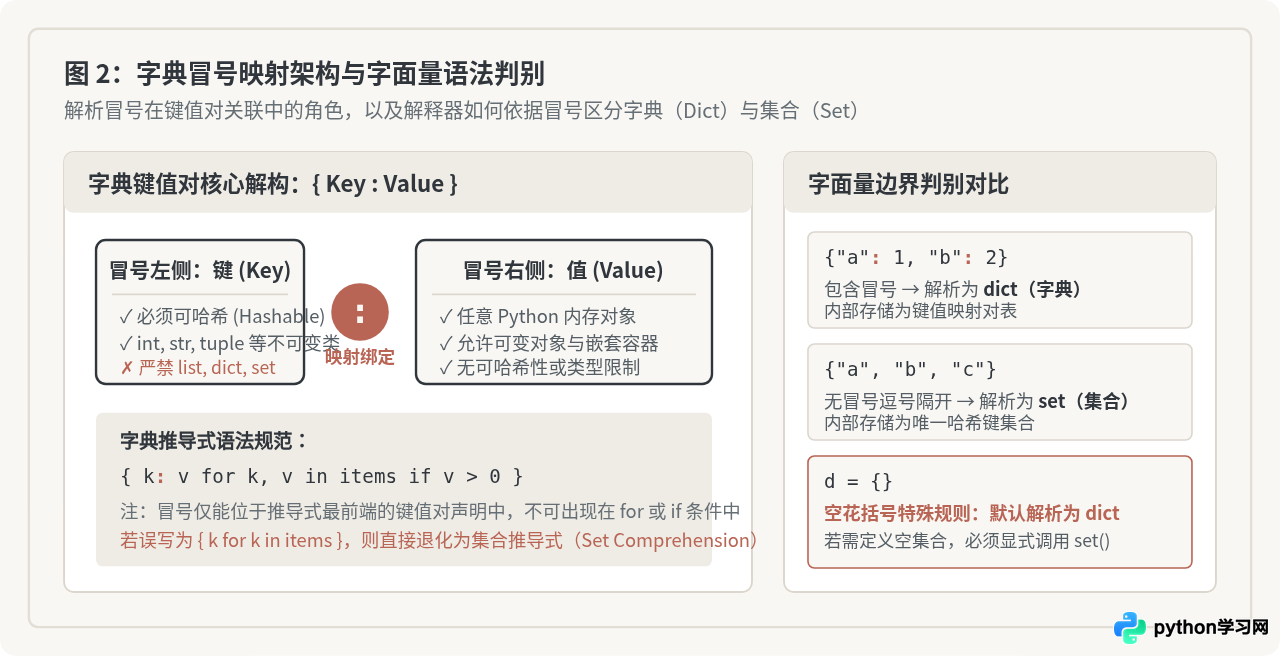
初学者容易将函数的命名传参 func(key=value) 与字典字面量 {"key": value} 混淆。在字典字面量中书写 {a=1} 是非法语法,字典字面量内必须使用冒号 : 连接键值对。
三、切片操作中的常见报错与排查指南
切片操作虽然在边界溢出时表现宽容,但在参数类型、步长有效性及方向匹配上存在严格的语法检验。以下是切片场景中最高频的报错类型与隐藏隐患。
1. ValueError: slice step cannot be zero
报错现象:当执行类似于 data[::0] 的切片时,控制台抛出 ValueError: slice step cannot be zero。
根本原因:步长 step 决定了游标在序列中的推进偏移量。如果步长为 0,游标将陷入死循环无法前进或后退。Python 底层 C 实现(slice_indices 函数)明确禁止 step == 0。
# 错误示例
nums = [10, 20, 30, 40]
# sub = nums[::0]  # 触发 ValueError: slice step cannot be zero

# 正确修复方案:动态计算步长时加入兜底防护
step = 0
safe_step = step if step != 0 else 1
sub = nums[::safe_step]
print(sub)  # 示例输出: [10, 20, 30, 40]
2. TypeError: slice indices must be integers or None
报错现象:执行 items[0: mid / 2] 时,抛出 TypeError: slice indices must be integers or None or have an __index__ method。
根本原因:切片的 start、stop 和 step 只能是整数或 None。在 Python 3 中,标准除法运算符 / 总是返回浮点数(float)。即使 4 / 2 的数学结果是 2,其在 Python 中的类型也是 2.0。浮点数不能直接作为序列的离散下标。
# 错误示例:除法产生浮点数切片索引
items = ["a", "b", "c", "d"]
mid = len(items)
# result = items[0: mid / 2]  # 抛出 TypeError

# 正确修复方案:改用整除运算符 // 确保结果为 int
result = items[0: mid // 2]
print(result)  # 示例输出: ['a', 'b']
3. 空序列陷阱:步长方向与起止索引反向(静默逻辑错误)
异常现象:程序没有抛出任何报错,但切片结果返回了空列表 [] 或空字符串 "",导致后续逻辑出现计算缺失。
根本原因:当指定的起止范围与步长推进方向发生逻辑冲突时,切片会提前终止。例如 items[5:2],默认步长为 +1(向右移动),但起点 5 位于终点 2 的右侧,游标向右移动永远无法触碰终点,解释器判定区间无有效元素,直接返回空结果。
# 隐蔽逻辑缺陷示例
nums = [0, 1, 2, 3, 4, 5]
print(nums[5:2])      # 默认 step=+1,无法倒退,输出: []

# 正确修复方案:显式指定负步长 step=-1
print(nums[5:2:-1])   # 逆向步长,输出: [5, 4, 3]
四、字典冒号相关的常见报错与修正方案
字典中的冒号不仅是词法层面的分隔标记,更是运行时构建哈希映射的触发点。以下列举字典定义与访问过程中与冒号最相关的错误场景。
1. SyntaxError: invalid syntax(字面量与推导式语法书写失误)
场景一:字典字面量中误将冒号写为赋值等号。
# 错误示例:受函数 kwargs 影响误写为 '='
# user = {"name" = "Tom", "role" = "admin"}  # SyntaxError: invalid syntax

# 正确写法:字面量中必须使用冒号
user = {"name": "Tom", "role": "admin"}
场景二:字典推导式中遗漏冒号或误加循环冒号。
# 错误示例 A:推导式中缺失冒号,退化为集合推导式
keys = ["a", "b"]
res_set = {k for k in keys}            # 结果是 set: {'a', 'b'},非 dict

# 错误示例 B:习惯性在推导式的 for 之后添加冒号
# bad_dict = {k: 0 for k in keys:}       # SyntaxError: invalid syntax

# 正确写法:输出项使用冒号连接键值,迭代子句不带冒号
res_dict = {k: 0 for k in keys}        # 结果: {'a': 0, 'b': 0}
2. TypeError: unhashable type: 'list'(冒号左侧键的可哈希性违规)
报错原因:在冒号左侧充当键(Key)的对象必须具备不可变性并实现 __hash__ 方法。如果将列表或字典放置在冒号左侧,解释器会即刻报错。
# 错误示例:使用可变列表作为字典键
# coord_map = {[10, 20]: "Target"}  # TypeError: unhashable type: 'list'

# 正确写法:使用不可变元组 tuple 替代列表
coord_map = {(10, 20): "Target"}
print(coord_map[(10, 20)])  # 示例输出: 'Target'
3. 检索阶段误写切片语法引发的异常
报错表现:初学者希望获取字典中“前两个键”的值,写出了形如 my_dict[0:2] 或 my_dict["a":"c"] 的代码,从而导致 KeyError: slice(0, 2, None) 或 TypeError: unhashable type: 'slice'。
原因剖析:字典的下标访问通过 __getitem__(key) 执行点对点哈希查找。如果在方括号中写入冒号,Python 会将整个 slice 实例作为参数传递给字典。因为标准字典不支持范围切片查询,且切片对象是不可哈希的(当键为字符串切片时报 TypeError),因此无法执行范围查询。
# 正确方案:若需对字典条目执行类似切片的截取,先转换为列表或使用 itertools
from itertools import islice

data = {"a": 1, "b": 2, "c": 3, "d": 4}
sliced_items = dict(islice(data.items(), 2))
print(sliced_items)  # 示例输出: {'a': 1, 'b': 2}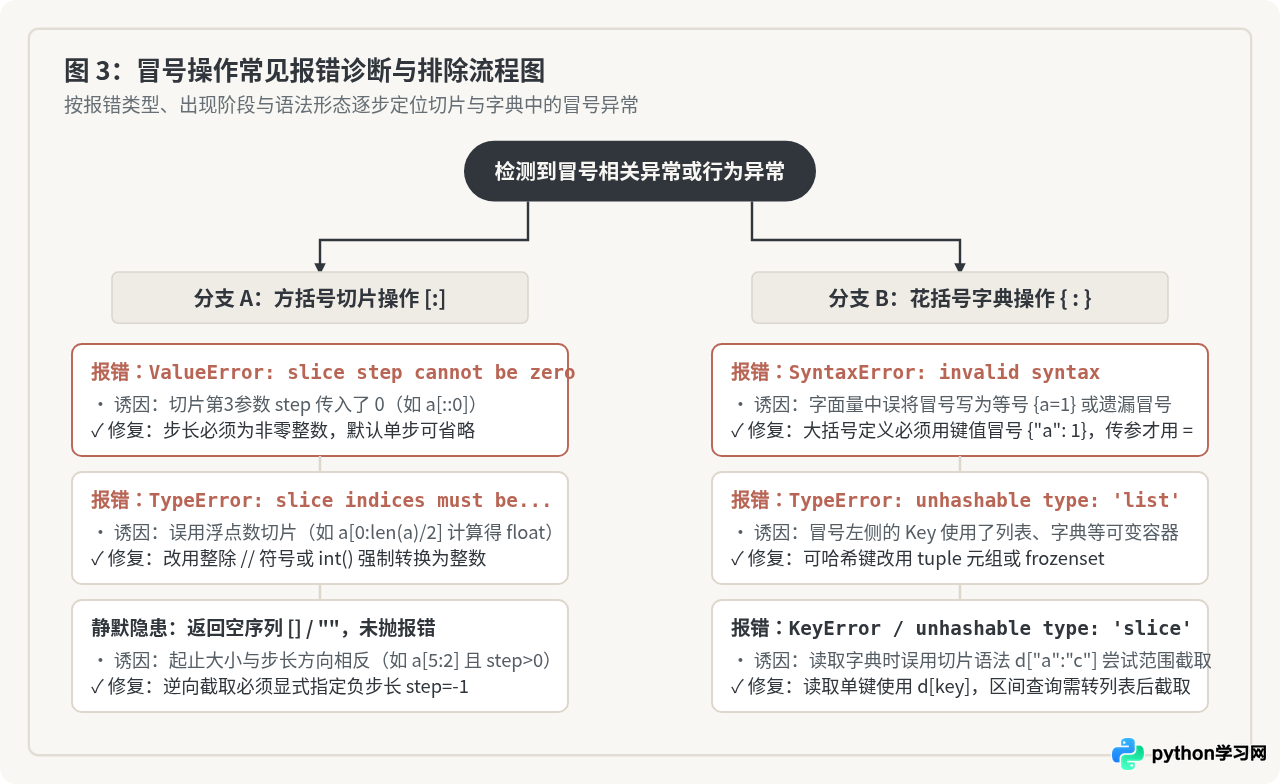
五、切片与字典冒号的全景对比与总结
为了在实际编码中快速做出准确判断,下表系统梳理了冒号在切片操作与字典结构中的核心差异:
| 特性指标 | 序列切片中的冒号 [:] | 字典定义中的冒号 { : } |
|---|---|---|
| 语法载体 | 方括号下标索引运算符 seq[start:stop:step] |
花括号容器字面量 {key: value} |
| 冒号数量 | 1 个(两参数)或 2 个(三参数) | 每个键值对必有 1 个,条目之间用逗号分隔 |
| 冒号左侧对象 | 起始位置 start(整数或 None) |
映射键 Key(必须可哈希,如 int、str、tuple) |
| 冒号右侧对象 | 终止位置 stop(整数或 None,左闭右开) |
映射值 Value(任意对象,无类型限制) |
| 越界行为表现 | 自动截断,不抛出异常 | 无越界概念;访问不存在的键直接抛出 KeyError |
| 最常见致命报错 | ValueError(步长为 0)TypeError(索引传入浮点数) |
SyntaxError(误用等号或漏写冒号)TypeError(不可哈希对象充当键) |
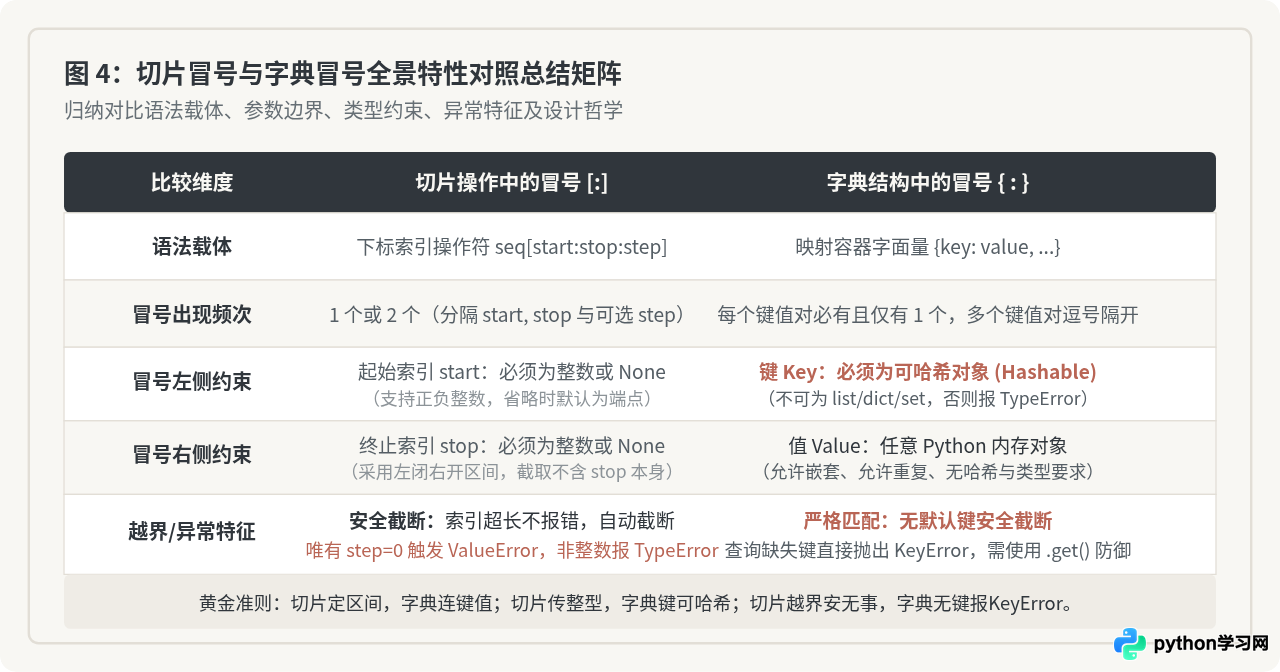
掌握 Python 冒号的核心在于区分执行上下文与容器协议:在方括号中,冒号是序列切片的标尺,界定连续空间,步长不能为零且索引必须为整数;在花括号中,冒号是哈希表的纽带,连接散列键与存储值,左侧不可变右侧无限制。遵循这套确定性的规则,即可从根本上杜绝语法混淆与隐蔽的运行期异常。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















