


Python标准库与第三方库的区别及常用模块盘点
系统对比Python标准库与第三方库的物理存储、管理方式与解析机制,辨析常见误区,详解规范化虚拟环境管理流程,并分类盘点最常用的核心模块与选型指南。
pip 等包管理工具单独下载安装到本地环境。本文系统梳理两者的核心机制与物理差异、辨析常见认知误区,给出第三方库的规范管理流程,并盘点实际项目中最常用的标准库与第三方模块及选型准则。
一、概念辨析:什么是标准库与第三方库?
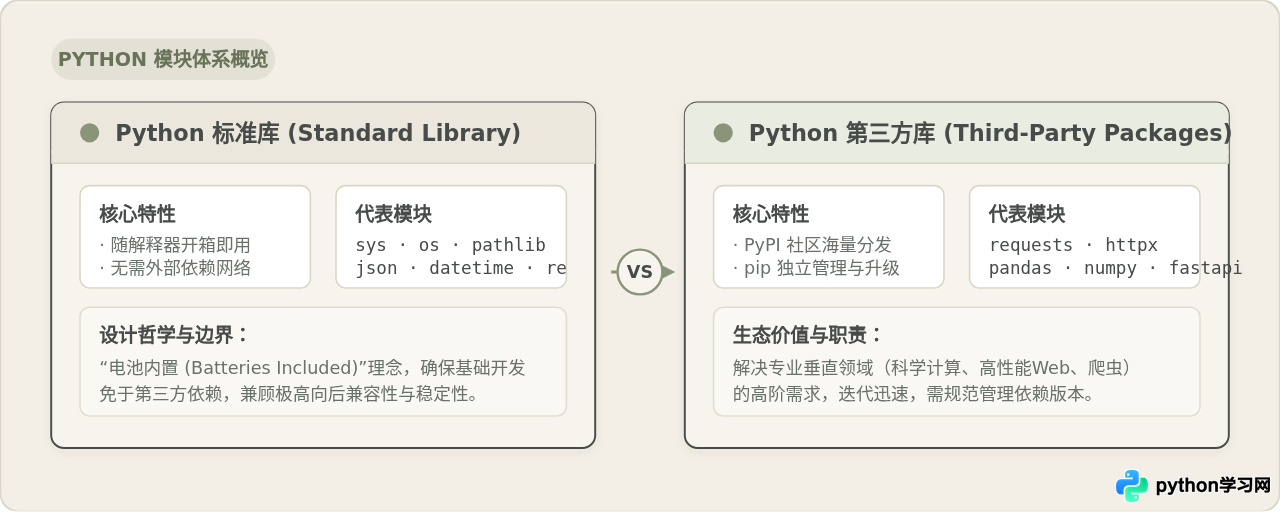
Python 能够成为当今最主流的编程语言之一,很大程度上归功于其庞大且活跃的模块生态。然而,不少初学者在写代码时往往只记得 import,却不清楚引入的模块究竟来自何方。在 Python 生态中,模块与包按来源通常分为两大阵营:
1. 标准库(Standard Library):开箱即用的“电池内置”
Python 秉承著名的“电池内置”(Batteries Included)设计理念。这意味着,当你从 python.org 官方下载安装 Python 解释器时,就已经打包获得了数百个经过极其严苛测试的内置模块。
- 零额外依赖:在任何安装了标准 Python 环境的主机上,不需要联网,也不需要执行任何安装命令,即可直接在代码中使用
import json、import pathlib、import sys。 - 终身向后兼容:标准库的 API 变更遵循极其审慎的 PEP(Python 增强提议)流程与废弃周期,通常跨越多个大版本依然保持接口稳定,极少出现由于升级导致代码无法运行的情况。
- 官方安全背书:所有标准库源码直接托管于 Python 官方核心仓库,随 CPython 版本同步编译构建与安全修补,不存在恶意供应链投毒的顾虑。
2. 第三方库(Third-Party Packages):社区驱动的无限可能
第三方库是指由独立开发者、开源社区组织(如 Apache、Pallets)或科技企业(如 Google、Meta)开发并公开分享的软件包。这些库并不包含在官方的 Python 安装包中,而是统一托管在官方包索引仓库 PyPI (Python Package Index) 上。
- 按需独立安装:必须在本地终端通过包管理工具(如
pip)显式执行安装,下载编译后的 Wheel 二进制包或源码包至本机的特定目录。 - 迭代极其迅速:第三方库独立于 Python 本身发布,不受 Python 每年一次大版本周期的限制。它们可以数周或数月就推出新特性、性能优化或架构升级。
- 需工程化管理:第三方库存在复杂的依赖网络(例如安装库 A 可能需要自动递归安装库 B、C、D)。若不加规范,极易出现版本冲突或依赖丢失。
二、物理存储与导入寻址机制:底层究竟有何不同?
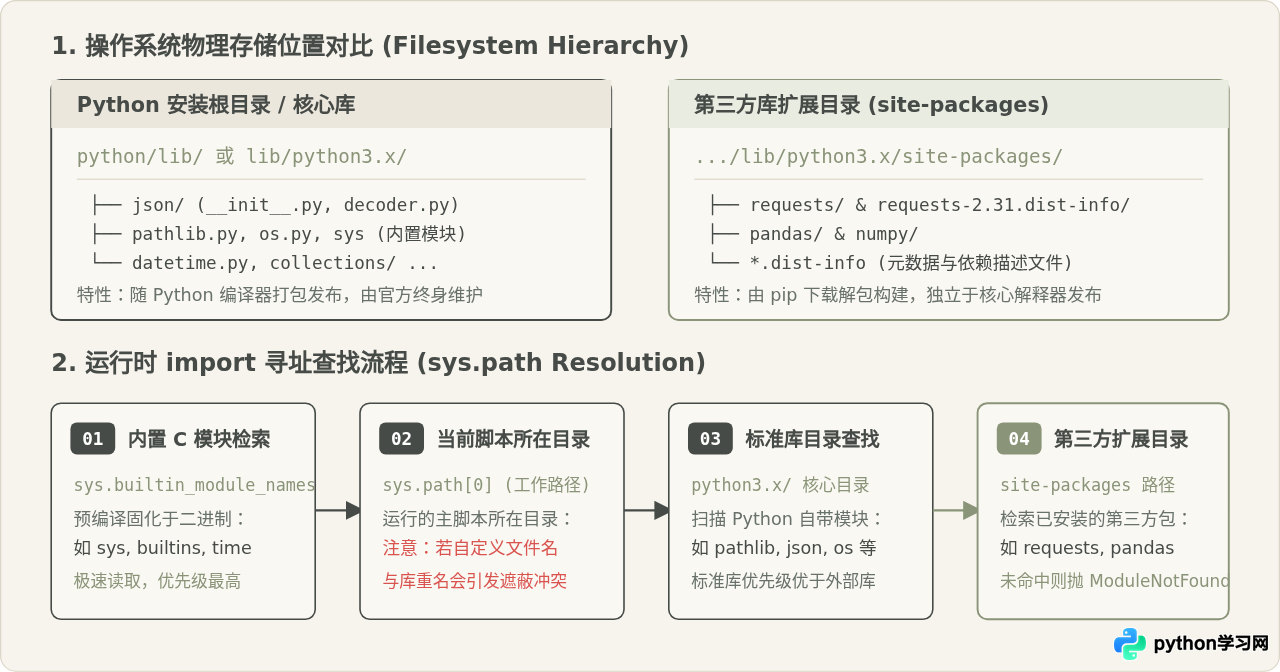
标准库与第三方库不仅在定义上不同,在操作系统的物理文件系统和解释器的运行时导入流程中,也有着清晰的分界线。
1. 文件系统中的物理存储位置
可以通过 Python 内置的 sys.path 观察解释器的搜索路径,以及通过模块的 __file__ 属性查看其实际物理位置:
import json
import sys

print("标准库 json 路径:", json.__file__)
print("Python 模块搜索路径前 3 项:", sys.path[:3])Python 模块搜索路径前 3 项: ['/Users/demo/project', '/usr/local/lib/python311.zip', '/usr/local/lib/python3.11']
由输出可见,标准库直接位于 python3.x/ 根目录下;而第三方库在通过 pip install 之后,会被统一部署在该目录的子目录 site-packages/ 中,同时伴随生成一个用于描述版本、许可证与依赖拓扑的 .dist-info 文件夹。
2. 运行时 import 寻址优先级与遮蔽陷阱
当执行 import xxx 时,Python 解释器会严格按照以下顺序进行检索:
- 内置 C 模块(Built-in Modules):如
sys、builtins、time,直接内嵌于 Python 核心二进制文件中,瞬时加载。 - 当前运行脚本所在目录(
sys.path[0]):优先查找当前工作目录中的 Python 文件。 - 标准库目录(Standard Library):检索
lib/python3.x/下的模块文件。 - 第三方扩展目录(Site-packages):检索项目虚拟环境或全局的
site-packages/。
由于当前目录优先级(第 2 步)高于标准库与第三方库,许多初学者在练习时会把自己的脚本命名为 json.py、math.py 或 requests.py。当在同目录的其他脚本中 import json 时,解释器会错误加载你写的这个空文件,进而抛出莫名其妙的 AttributeError: module 'json' has no attribute 'loads'。切勿将自定义代码文件命名为已知库的同名文件名。
三、容易混淆的认知误区辨析
在实际项目选型与日常编码中,开发者常陷入几个典型的极端认知误区,需要结合工程实际予以纠偏:
| 常见说法 / 误区 | 合理成因(为什么看似正确) | 问题与边界(为何需要修正) | 正确工程实践准则 |
|---|---|---|---|
| “第三方库功能更丰富,项目里能用第三方库就少用标准库” | 第三方库通常针对高频痛点进行了高层封装,语法糖丰富,少量代码即可达成目标。 | 每引入一个第三方库,就引入了一份外部安全攻击面、维护淘汰风险和环境部署构建成本。 | 轻量或核心底层功能优先用标准库;只有标准库无法高效解决(如高级矩阵运算、复杂 HTTP 交互)时才引入第三方库。 |
| “标准库都是老旧代码,性能一定不如第三方库” | 某些标准库接口(如 urllib)设计于十几年前,代码书写繁琐,容易给人留下“老旧落后”的刻板印象。 |
标准库中大量核心计算逻辑(如 json、itertools、collections、hashlib)均是用底层的 C 语言高度优化实现的,性能极快且内存开销极低。 |
在基础算法、数据结构转换和数据流解析上,标准库通常是速度与轻量的代表,无需盲目替换。 |
| “第三方库装好就能用,直接在系统终端 pip install 最省事” | 在单机个人电脑上,全局安装确实省去了敲击虚拟环境命令的步骤,立即可跑。 | 不同项目可能依赖同一个第三方库的不同冲突版本(如项目 A 需 Pydantic v1,项目 B 需 Pydantic v2),全局安装会导致版本踩踏与系统 Python 崩溃。 | 所有项目必须无条件建立独立的虚拟环境(virtualenv),严格禁止直接向系统全局环境滥装依赖。 |
四、规范实践:第三方库的安装、隔离与工程管理步骤
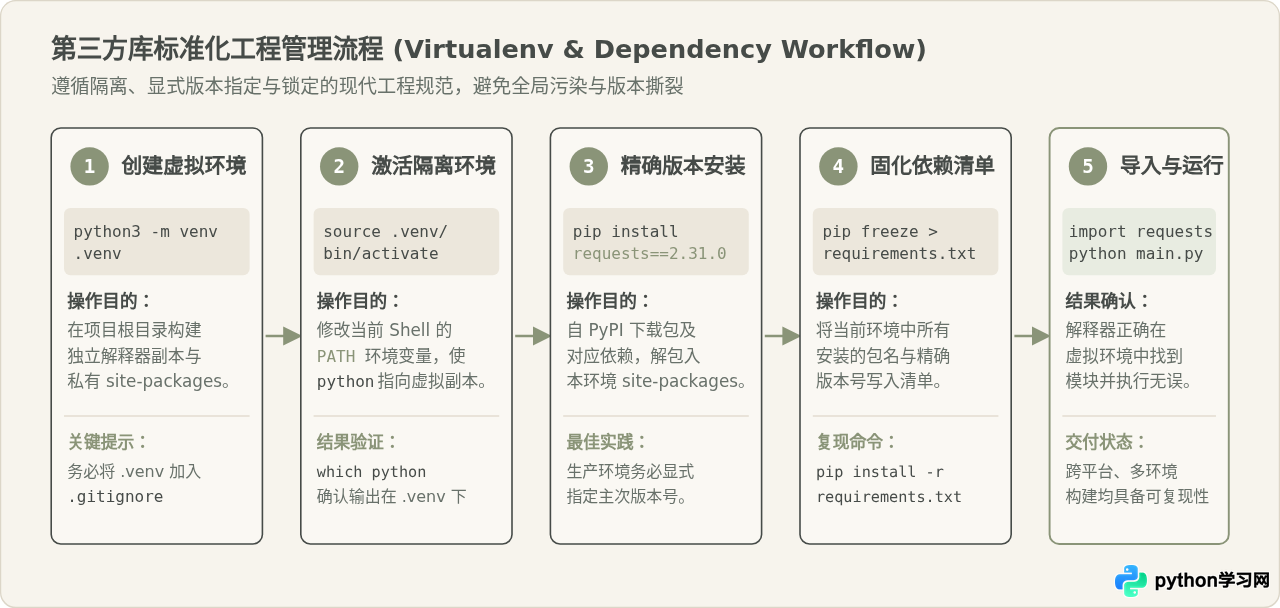
为了保证代码在不同开发机、测试服务器及容器环境中的确定性与可复现性,管理第三方库必须形成固定的工程化闭环。
步骤 1:在项目根目录创建隔离虚拟环境
使用 Python 内置的 venv 模块创建独立的运行环境,该操作会在当前目录生成一个包含专属 Python 解释器和独立 site-packages 的目录(通常命名为 .venv):
python3 -m venv .venv
注意:应立即将 .venv/ 写入项目的 .gitignore 文件中,切勿将虚拟环境的二进制文件提交至版本控制系统。
步骤 2:激活虚拟环境并核验环境状态
激活操作的本质是将虚拟环境的 bin/ 目录置于当前终端环境 PATH 变量的首位:
# macOS / Linux 激活命令:
source .venv/bin/activate

# Windows PowerShell 激活命令:
# .venv\Scripts\Activate.ps1

# 验证当前正在使用的 python 与 pip 路径:
which python
which pip/Users/demo/my_project/.venv/bin/pip
步骤 3:安装指定版本的第三方库
在正式生产代码中,不建议裸执行 pip install package_name,而应显式指定版本范围,避免突发的破坏性更新(Breaking Changes):
pip install requests==2.31.0步骤 4:固化依赖清单(Locking Dependencies)
将当前环境中所有精确安装的包及底层依赖写入标准清单文件,便于团队成员或部署脚本一键重构环境:
pip freeze > requirements.txt在另一台新机器上部署时,只需执行以下命令即可毫秒级复现完全相同的依赖树:
pip install -r requirements.txt五、常用标准库模块深度盘点与代码示例
Python 官方标准库功能丰富,以下 6 大模块是现代开发中出镜率最高、解决基础问题最优雅的利器。
1. pathlib:现代面向对象的文件与路径系统
过去开发者习惯使用 os.path.join 和字符串切片操作路径,容易在 Windows(反斜杠 \)与 Linux(正斜杠 /)之间产生跨平台异常。自 Python 3.4 引入的 pathlib 提供了优雅的面向对象路径操作:
from pathlib import Path

# 获取当前工作目录下的数据文件路径,使用 / 操作符自然拼接
base_dir = Path.cwd()
config_file = base_dir / "data" / "app_config.json"

# 创建目录(parents=True 自动递归创建上层目录,exist_ok=True 避免已存在报错)
config_file.parent.mkdir(parents=True, exist_ok=True)

# 直接以 UTF-8 写入文本,无需显式 open/close
config_file.write_text('{"version": "1.0", "status": "active"}', encoding="utf-8")

# 读取并检查属性
if config_file.exists():
    print(f"文件名: {config_file.name}, 扩展名: {config_file.suffix}")
    print(f"内容: {config_file.read_text(encoding='utf-8')}")
2. json:轻量级通用数据交换
在处理 RESTful API 返回值或本地配置文件时,标准库的 json 提供了极其稳健的序列化(dumps/dump)与反序列化(loads/load)能力:
import json

user_data = {
    "user_id": 10086,
    "username": "linus",
    "roles": ["admin", "developer"],
    "verified": True
}

# 序列化为格式化 JSON 字符串(ensure_ascii=False 保留中文,indent 设置缩进)
json_str = json.dumps(user_data, indent=2, ensure_ascii=False)
print("JSON 输出示例:
", json_str)

# 反序列化还原为 Python 原生字典
parsed_obj = json.loads(json_str)
assert parsed_obj["user_id"] == 10086
3. collections:扩展数据结构工具箱
标准库 collections 在基础 dict、list 之外提供了性能更高、逻辑更简洁的容器类型,其中最常用的包括 defaultdict 和 Counter:
from collections import Counter, defaultdict

# 场景 A: 词频统计
words = ["python", "code", "python", "lib", "code", "python"]
counter = Counter(words)
print("出现频次最高的单词:", counter.most_common(1))  # [('python', 3)]

# 场景 B: 自动初始化默认值的字典,避免频繁判断 key in dict
grouped_users = defaultdict(list)
grouped_users["tech"].append("Alice")
grouped_users["tech"].append("Bob")
grouped_users["finance"].append("Charlie")
print("分组结果:", dict(grouped_users))
4. sqlite3:免服务嵌入式关系型数据库
不需要安装任何 MySQL 或 PostgreSQL 服务,Python 自带了轻量且遵循 ACID 标准的嵌入式数据库 sqlite3。对于本地工具、缓存存储或小型桌面应用,它是零依赖持久化的首选:
import sqlite3

# 连接本地数据库文件(如果传 ":memory:" 则在内存中创建临时库)
with sqlite3.connect("cache.db") as conn:
    cursor = conn.cursor()
    cursor.execute("""
        CREATE TABLE IF NOT EXISTS metrics (
            id INTEGER PRIMARY KEY AUTOINCREMENT,
            metric_name TEXT NOT NULL,
            val REAL NOT NULL
        )
    """)
    cursor.execute("INSERT INTO metrics (metric_name, val) VALUES (?, ?)", ("cpu_usage", 42.5))
    conn.commit()

    cursor.execute("SELECT metric_name, val FROM metrics WHERE val > ?", (40.0,))
    rows = cursor.fetchall()
    print("查询结果:", rows)  # [('cpu_usage', 42.5)]
六、主流第三方库模块盘点与场景实战
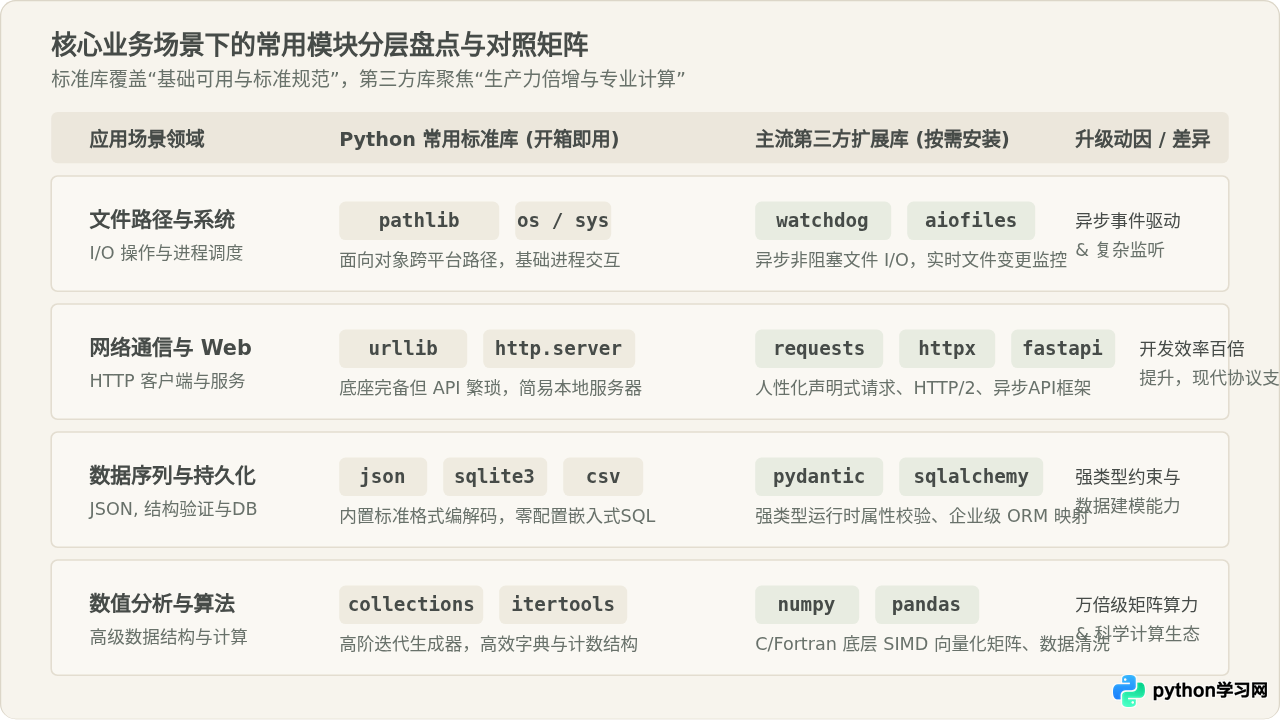
当业务走向复杂的网络通信、高阶数学分析、Web 服务构建等专业垂直场景时,标准库的初级接口难以满足生产力需求,此时正是第三方库发挥巨大威力的舞台。
1. requests / httpx:优雅的人性化 HTTP 客户端
标准库内置的 urllib.request 语法繁复(处理代理、Cookie、证书、JSON 需大量样板代码)。第三方库 requests(以及支持异步的 httpx)以“HTTP for Humans”为宗旨,极大降低了网络交互门槛:
# 规范依赖: requests==2.31.0
import requests

url = "https://httpbin.org/post"
payload = {"query": "python标准库", "page": 1}
headers = {"User-Agent": "MyDemoApp/1.0"}

try:
    response = requests.post(url, json=payload, headers=headers, timeout=5.0)
    response.raise_for_status()  # 若 HTTP 状态码为 4xx/5xx 则直接抛出异常
    data = response.json()       # 自动解析 JSON 响应
    print("请求成功,远端返回数据:", data.get("json"))
except requests.exceptions.RequestException as err:
    print("网络请求失败:", err)
2. pandas / numpy:海量数据处理与科学计算基石
Python 自身的原生列表无法进行高效的矩阵数学计算。第三方库 numpy 在底座使用 C/Fortran 实现了连续内存布局的 SIMD 向量化运算,而 pandas 则在其之上封装了工业级的 DataFrame 表格操作:
# 规范依赖: pandas==2.1.4, numpy==1.26.2
import numpy as np
import pandas as pd

# 创建示例表格数据集
df = pd.DataFrame({
    "dept": ["Dev", "Dev", "QA", "QA", "Ops"],
    "score": [88, 95, 78, 85, 91],
    "bonus": [1.2, 1.5, 1.1, 1.3, 1.4]
})

# 向量化运算:比 Python 原生 for 循环快数百倍
df["total_bonus"] = df["score"] * df["bonus"]

# 分组聚合分析
grouped = df.groupby("dept")["total_bonus"].mean().reset_index()
print(grouped)
3. pydantic:现代强类型与运行时数据验证
在企业级微服务或 FastAPI 体系中,pydantic 凭借基于 Python 类型提示(Type Hints)的运行时数据验证机制,彻底终结了“脏数据进入系统内部”的隐患:
# 规范依赖: pydantic==2.5.3
from pydantic import BaseModel, EmailStr, Field

class UserModel(BaseModel):
    user_id: int = Field(gt=0, description="用户ID必须为正整数")
    username: str = Field(min_length=3, max_length=20)
    email: EmailStr
    is_active: bool = True

# 模拟传入不可靠的外部 JSON 数据
raw_input = {
    "user_id": 42,
    "username": "dev_alex",
    "email": "alex@example.com"
}

user = UserModel(**raw_input)
print(f"验证成功对象: {user.username}, 邮箱域: {user.email.split('@')[1]}")
七、总结与选型指南:如何在项目中做权衡?
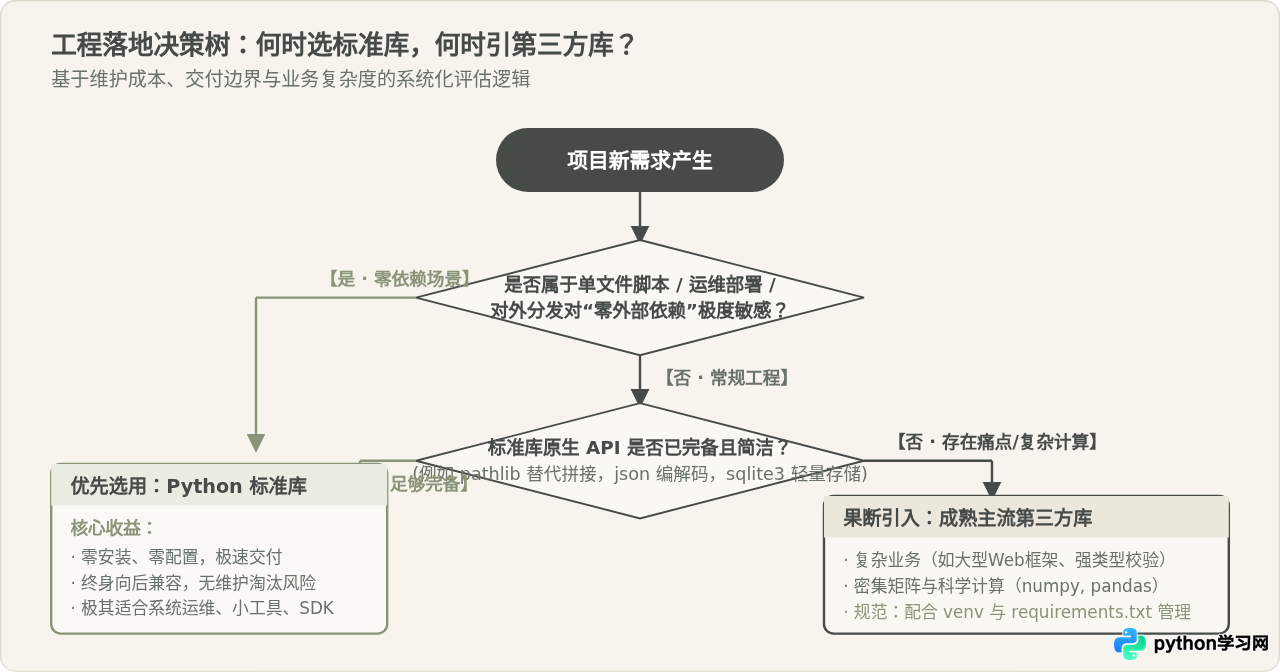
选用标准库还是第三方库,本质上是在“环境零依赖与长期维护成本”与“开发生产力与功能上限”之间做出的工程权衡。
选型决策清单
- 必须优先选标准库的场景:
- 运维自动化与单文件小工具:运行在无外网权限的生产服务器上,或需要随拷随跑的脚本(如定时备份、巡检告警)。
- 公开分发的轻量 SDK:如果你的开源库只为了实现一个简单功能,尽量不要拉入庞大的第三方依赖,否则会增加下游用户的依赖冲突风险。
- 长期无人维护的关键系统:要求代码在 5 年甚至 10 年后换了新机器依然能零修改直接运行。
- 果断引入成熟第三方库的场景:
- 存在成熟工业标准的领域:HTTP 通信(
requests/httpx)、高性能 Web 框架(fastapi/django)、强类型配置与ORM(pydantic/sqlalchemy)。 - 数学计算与数据工程:任何涉及矩阵乘法、时序分析、统计清洗的任务,严禁手写原生 Python 循环,应全面采用
numpy/pandas。 - 重塑轮子成本极高的专项领域:如图像编辑(
pillow)、加密认证、异步多任务队列(celery)。
- 存在成熟工业标准的领域:HTTP 通信(
成熟的 Python 工程师既能深刻理解并榨干标准库(pathlib、json、collections、sqlite3)的内置潜力,以极轻的代码实现高可靠系统;又能在面对复杂业务时,严格依托虚拟环境与 requirements.txt 规范化引入经过社区检验的主流第三方库。明晰两者的差异与边界,是迈向高质量工程交付的基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















