


Python 3官方文档与其他开源教程哪个更适合自学
深入对比Python 3官方文档与主流开源教程的编写逻辑、适用人群及学习效能,提供清晰的选型标准与双轨协同自学策略。
在规划 Python 3 自学路线时,官方文档与第三方开源教程并非简单的二选一替代关系,而是对应着不同的认知负荷与学习阶段。自学初期的核心障碍往往不是知识太深,而是信息密度的排异反应:开源教程以场景为牵引、辅以直观比喻和逐步拆解,更适合快速建立正向反馈与代码直觉;而官方文档作为语言规范的基准源,具备最高等级的严谨性与完整度,更适合在掌握基础语法后作为查阅标准库与核对底层机制的工具书。盲目孤立地推崇其中任何一方,都会导致自学进程陷入停滞。本文将系统拆解二者的编写逻辑差异,剖析主流认知误区,并提供基于具体基础的选型依据与双轨协同自学方法。
一、核心选型模型:学习阶段与信息密度的匹配
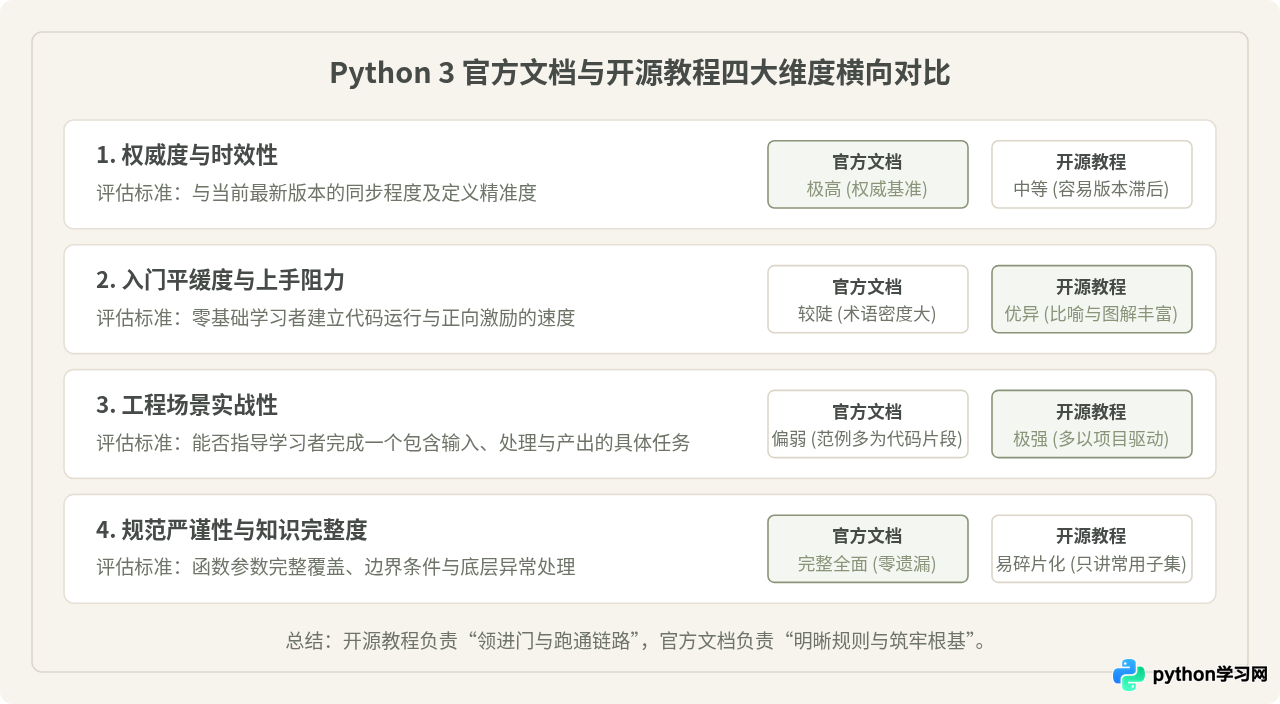
自学教材的选择,本质上是学习者当下的“先验背景”与资料“信息组织密度”之间的匹配过程。许多初学者感到官方文档晦涩难懂,并非因为文档质量不佳,而是因为官方文档的编写首要任务是定义标准,而非教学引导。
官方文档的每一行描述都力求在计算机科学术语框架下做到零歧义。例如解释一个数据结构时,文档会直接列出其时间复杂度、异常类型与边界条件;而优秀的开源教程则致力于降低认知摩擦,往往会用生活中的清单、字典比喻来替代形式化概念,优先让学习者在屏幕上看到运行结果。明确两者的定位落差,是制定正确自学策略的起点。
二、Python 3官方文档的结构体系与真实阅读门槛
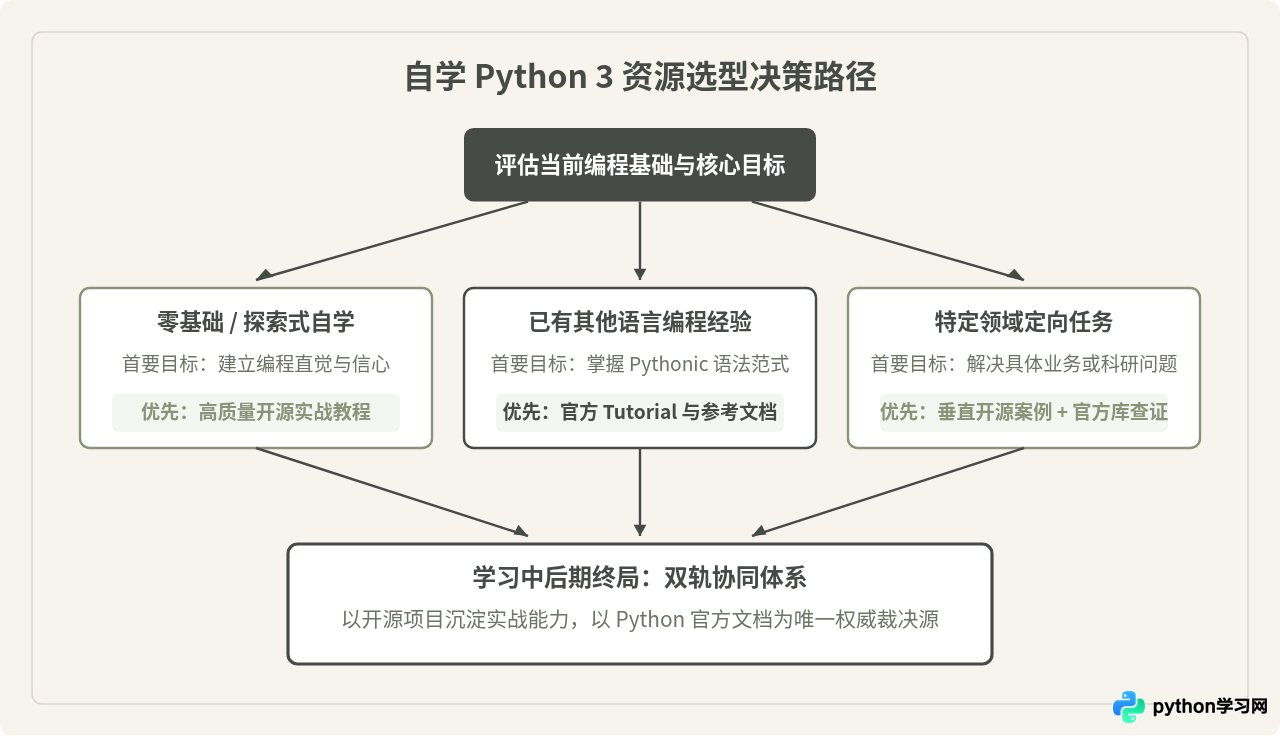
通常所说的“Python 官方文档”,实际上是一个庞大的技术文档集合,主要由四个核心模块构成:
- Python Tutorial(入门教程):由 Guido van Rossum 亲自主笔的精炼指南,按由浅入深的逻辑涵盖基本类型、控制流、数据结构、模块与类机制。它的篇幅紧凑,偏向标准示范。
- Library Reference(标准库参考):Python 最重要的资产之一,详尽记录了随解释器附带的所有内置函数与标准库模块(如
sys、os、json、re、pathlib等),包含严格的函数签名与参数说明。 - Language Reference(语言参考手册):详细描述 Python 的形式化语法规则与执行模型(如数据模型、属性查找顺序、操作符重载机制),适合需要深入底层语义的研究者。
- HOWTOs 与专题指南:针对正则、套接字、性能分析、C 扩展等特定工程主题撰写的最佳实践文章。
常见说法辨析:“真正的高手只读官方文档”
技术社区常有一种声音认为“二手资料都是低效的,真正的程序员应该直接看官方文档”。这种观点看似追求纯粹,但在认知心理学上存在明显偏差。
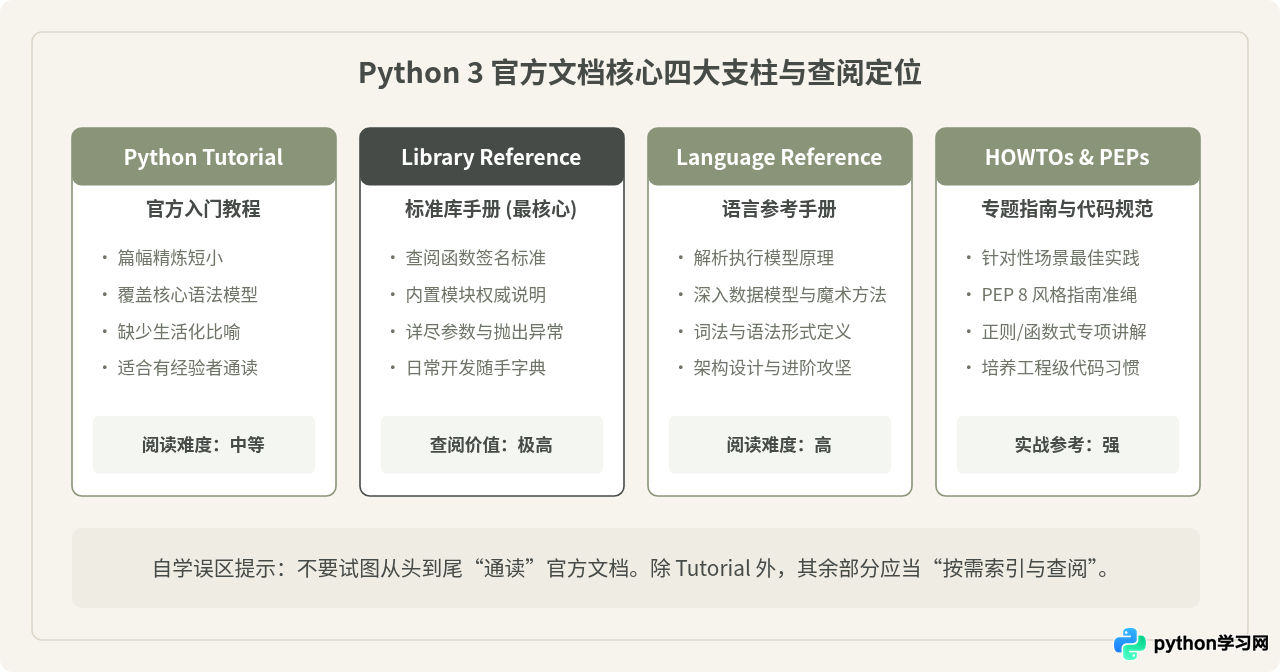
合理之处:官方文档具有无可替代的权威性,排除了社区作者个人习惯的干扰,并且永远与 Python 最新版本(如 3.11/3.12/3.13)同步,不会引入过时的语法包袱。
局限与修正:所谓“只读官方文档”通常是成熟工程师在熟悉通用编程概念后的阅读体验。对于初学者而言,若尚未建立变量引用、作用域、栈与堆、输入输出等基本心智模型,直接阅读文档中关于“迭代器协议”或“元类”的形式化定义,会面临极高的概念断层。成熟开发人员在调研全新生态(如 Docker、Kubernetes 或 Web 框架)时,也普遍依赖优质开源教程建立框架感,随后才回归官方文档确认细节。
三、开源社区教程的优势场景与潜在缺陷
优秀的开源中文教程(如各类 GitHub 开源电子书、技术社区知名专栏等)之所以广受自学者推崇,是因为它们主动填补了“抽象概念”与“具体操作”之间的沟壑。
开源教程的核心优势体现在三点:
- 上下文代入感强:开源教程通常围绕真实小项目展开(如制作待办事项 CLI 工具、简易网络爬虫或个人博客),让学习者在敲出代码后立即获得可视化的运行反馈。
- 排错引导贴近实际:很多开源作者会记录初学者最容易踩的坑(例如 Windows 下路径反斜杠转义、字符编码
GBK与UTF-8冲突、虚拟环境激活失败等),这些工程经验在官方语言文档中通常只是一笔带过。 - 梯度循序渐进:有意识地控制每节课的信息量,避免一次性抛出完整语法全集。
开源教程的三大潜在风险
完全依赖开源教程自学往往会遇到以下结构性隐患:
- 版本滞后与语法漂移:开源项目更新多依赖作者业余维护。许多 2018 年撰写的教程至今仍在使用旧式格式化字符串(如
%操作符或str.format()),而现代 Python 开发已全面普及f-string(并在 3.12 引入了更强大的嵌套解析);部分教程仍在传授os.path,而非现代面向对象的pathlib。 - 代码风格的个人印记:部分教程作者并非资深工程规范践行者,代码中可能夹杂不推荐的做法(如滥用裸
except:捕捉所有异常、忽略变量命名规范、使用全局变量在模块间传参等),初学者一旦形成肌肉记忆很难纠偏。 - 被动抄写的“掌握假象”:顺畅跟随教程逐行复制代码,容易产生“我已经学会了”的心理错觉。一旦离开教程脱离框架,面对空白编辑器往往不知如何组织逻辑。
四、针对不同自学背景的具体选型指南
为了让选择更具实操性,自学者可以根据自身背景选择适配路径:
1. 零编程基础的学习者
推荐路径:优质开源互动/视频教程(前 2-3 周) → 官方 Tutorial 快速核对 → 结合官方标准库编写微型项目。
实操要点:前期重点是建立对“程序执行流程”的感性认知。在开源教程中完成变量、循环、列表、字典及简单函数的练习,体验编写与运行程序的过程。当能够独立写出包含 30-50 行逻辑的代码脚本时,立即回看官方文档的 Tutorial 对应章节,此时你会惊讶地发现官方文档的措辞豁然开朗,正是帮你建立严谨定义的最佳时机。
2. 有其他编程语言(C/Java/Go/JS)经验的开发者
推荐路径:直接以官方文档为主,跳过任何通用概念类开源教程。
实操要点:此类学习者已经理解内存模型、控制流与面向对象思想,不需要别人解释“什么是循环”。只需花 1-2 天快速浏览官方文档的 Tutorial,着重理解 Python 的特色机制:动态类型与鸭子类型、列表推导式、生成器与 yield、装饰器原理、以及基于数据模型(Data Model)的双下划线魔术方法(如 __getitem__、__enter__)。随后将标准库手册置于书签栏,即可直接开展工程开发。
3. 目标明确的领域自学者(数据分析、网络运维、自动化办公)
推荐路径:Python 核心基础开源串讲 → 领域专项库文档(如 Pandas、Requests、OpenPyXL) → Python 官方内置库手册做底层支撑。
实操要点:不要试图先将 Python 语言学得面面俱到再去碰领域库。掌握基础语法后,直接进入目标生态的实战。在此过程中,涉及标准库工具(如文本处理 re、时间计算 datetime、文件读写 csv/json)时,强制自己查阅 Python 官方标准库文档,而不是在搜索引擎中胡乱复制零碎博客。
五、高效自学的“双轨并行”工作流
真正高效的 Python 自学策略不是在两者中择其一,而是构建一条互为印证的双轨工作流:
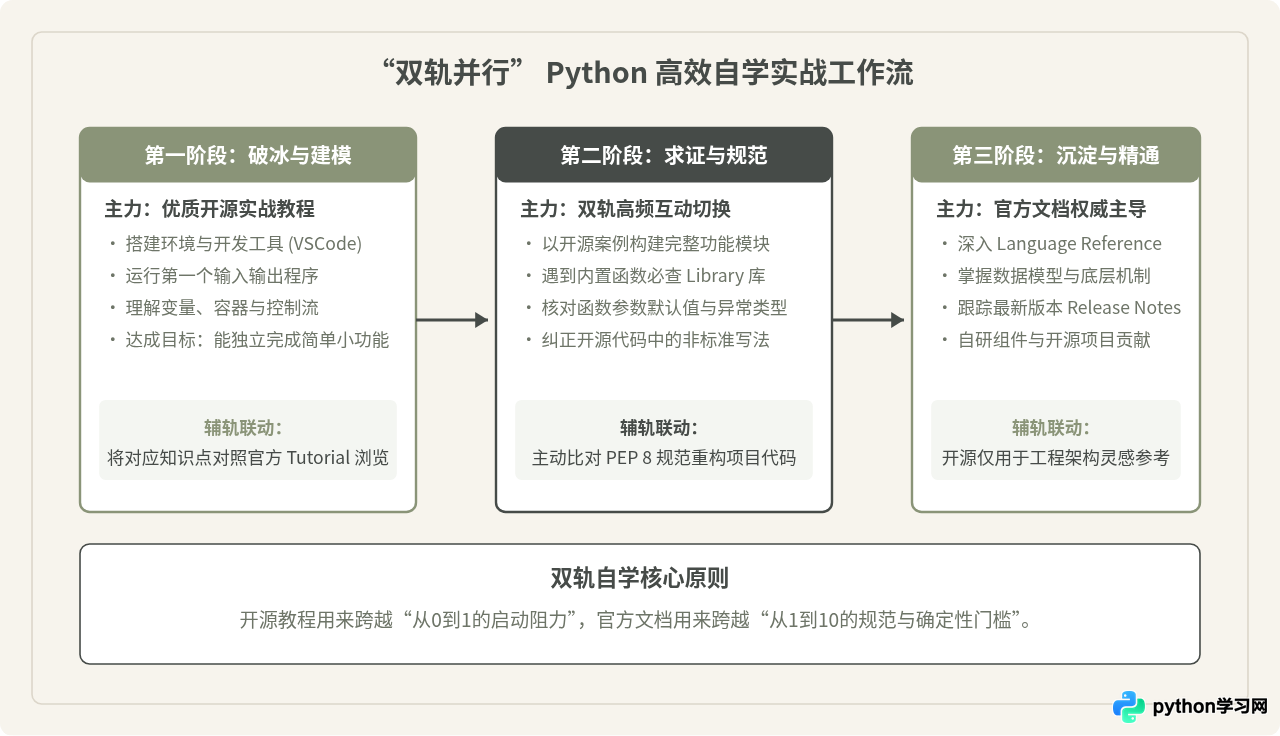
双轨验证实操范例:以文件路径操作为例
在许多开源教程中,处理文件路径的代码常常是这样书写的:
当学习者在开源教程中掌握了“文件路径拼接”的业务含义后,若能主动打开 Python 3 官方文档的 pathlib 库章节核对,便能迅速接触到更现代、更符合 Pythonic 面向对象思维的标准实现:
这种“从开源教程学功能,到官方文档验规范”的习惯,能够在极短时间内消除新手特有的不规范代码印记。
六、自学过程中的常见问题与避坑清单
答:Python 官方文档官方提供了简体中文语言分支(访问地址以 docs.python.org/zh-cn/3/ 开头)。翻译工作由国内开源社区志愿者通过 Transifex 平台协同维护,核心 Tutorial 与常用标准库模块的翻译质量非常高。建议在阅读中文页面时,遇到关键术语或存疑语句随时切回英文原版(页面右上角可快速切换语言)核对,避免翻译偏差。
答:可以观察教程前三章的代码特征:如果教程依然在使用 Python 2 与 Python 3 的兼容说明、没有提及类型注解(Type Hints)、依然将 % 或 .format() 作为主要字符串格式化方式、使用第三方包管理时依然只讲 virtualenv 而无现代虚拟环境介绍,通常说明该教程内容陈旧,建议另寻更新的参考资料。
答:检验这一能力的标准很简单:当你需要使用一个陌生的标准库函数(例如 itertools.groupby 或 urllib.parse.urlencode)时,不再依赖百度或普通技术博客提供的片段,而是直接在官方文档中看懂其函数签名、参数类型、返回值及抛出的异常,并根据文档自带的最小代码示例在本地交互式解释器(REPL)中验证成功。一旦达到这个节点,意味着自学阶段已成功毕业,迈入独立自足的工程探索期。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















