


Python常用内置函数用法指南:len、range、enumerate代码示例
深入解析Python三个最常用的内置序列操作函数:len、range与enumerate。涵盖底层执行机制、左闭右开区间推导、带索引遍历重构及高频代码示例。
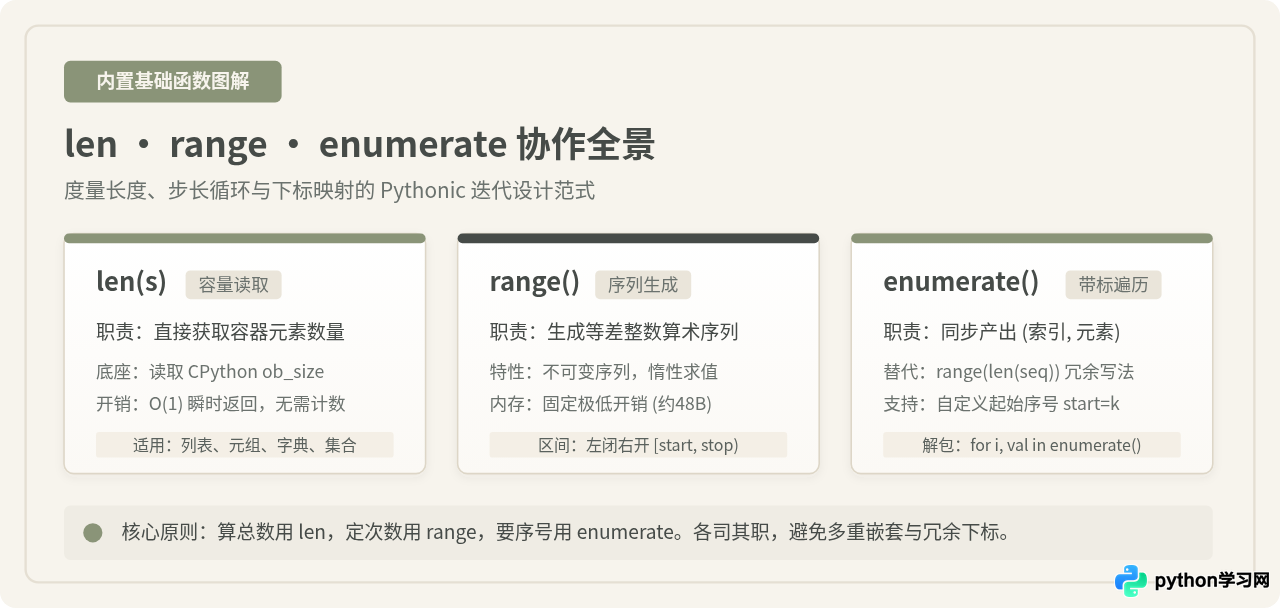
len()、range() 与 enumerate() 三个内置函数分别承担了容量查询、等差序列生成和带标遍历的职能。掌握这三个函数的底层执行逻辑与协同范式,能够帮助开发者写出更符合 Python 哲学(Pythonic)、既简洁又高效的高质量代码。
一、len():测量对象容量与元素个数
len() 函数用于返回对象中元素的个数或序列的长度。其基本调用语法极其简明:直接传入目标对象即可,如 len(s)。
1. 常见内置类型的基础用法
len() 支持所有内置序列(如字符串、列表、元组、字节串)以及集合和映射结构(如集合、字典):
# 测量字符串字符数(包含空格与特殊标点)
text = "Python 优雅编程"
print("字符串长度:", len(text))

# 测量列表与元组的元素个数
user_ids = [1001, 1002, 1003, 1004]
config_tuple = ("127.0.0.1", 8080, True)
print("列表长度:", len(user_ids))
print("元组长度:", len(config_tuple))

# 测量字典键值对数量与集合唯一项数量
user_info = {"id": 1, "name": "Alice", "role": "admin"}
unique_tags = {"python", "backend", "web", "python"}
print("字典键值对数量:", len(user_info))
print("去重后集合大小:", len(unique_tags))列表长度: 4
元组长度: 3
字典键值对数量: 3
去重后集合大小: 3
2. len() 的底层原理与误区辨析
常见困惑:不少初学者认为 len(my_list) 会从第一个元素遍历到最后一个元素进行计数,因此在处理包含数千万元素的庞大列表时担心耗费大量计算资源。
机制解释:在 CPython 解释器中,对于 list、tuple、dict、str 等基础容器,对象在 C 语言结构体层面对应 PyVarObject,其中维护着一个名为 ob_size 的整型字段。当对列表添加或删除元素时,该字段会实时更新。调用 len() 时,解释器直接读取此字段,时间复杂度为严苛的 O(1),与容器内元素的实际数量毫无关系,耗时极短。
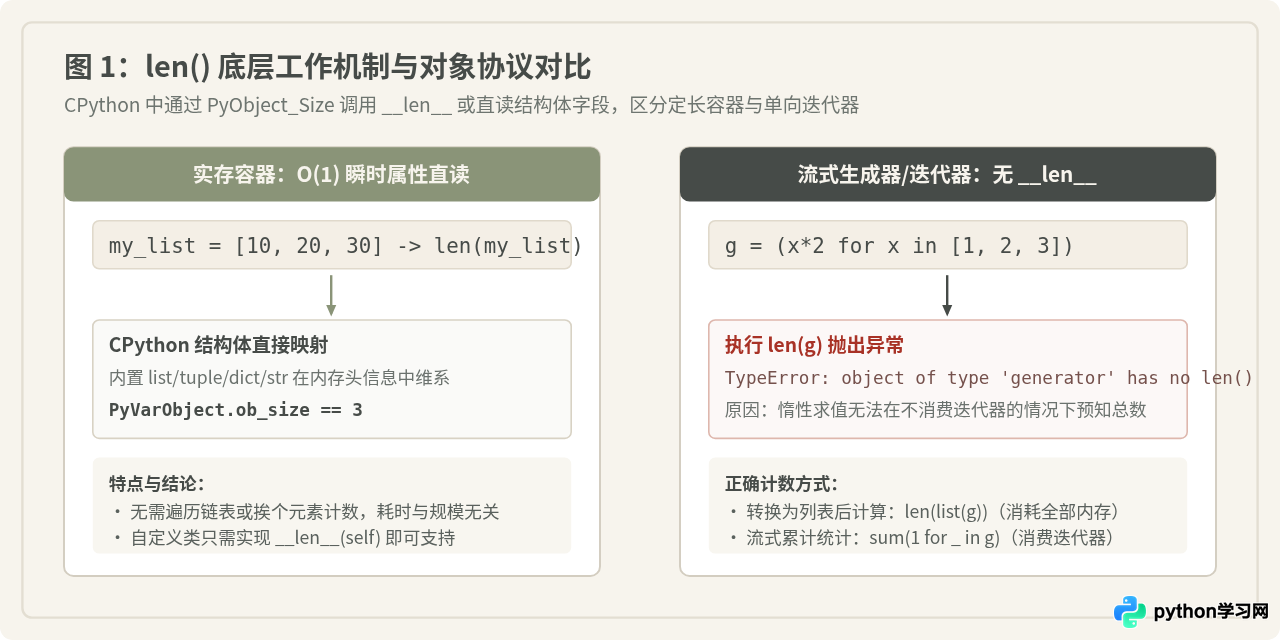
len()仅对实现了__len__()协议的对象有效。生成器表达式(如(x for x in data))与生成器函数是单向产出数据的惰性流,没有预置长度,直接对其调用len()会抛出TypeError: object of type 'generator' has no len()。- 在 Python 中判断列表是否为空时,更推荐直接利用容器在布尔上下文中的真假性(如
if not my_list:),而不是if len(my_list) == 0:,前者更加直观规范。
二、range():生成可控算术序列
在许多编程语言中,for 循环依赖显式的递增计数器。而在 Python 中,range() 是专门用于生成等差整数序列的不可变序列类型。它通常用于控制循环轮次或按索引步长访问数据。
1. range() 的三种参数模式
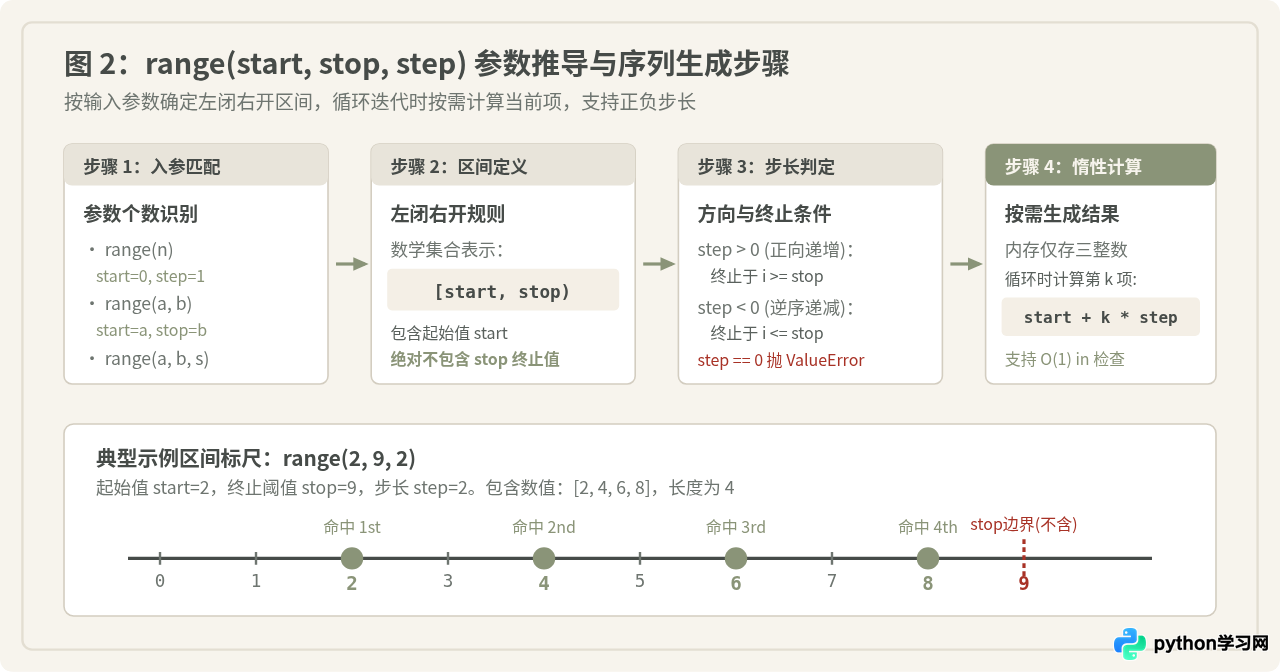
range() 函数支持 1 到 3 个整数参数,参数遵循统一的“左闭右开”规则(包含下界,不包含上界):
range(stop):只传一个参数时,默认从0开始递增,步长为1,直至stop - 1。range(start, stop):指定起始值start和结束边界stop,步长默认为1。range(start, stop, step):完整指定起点、终点和步长。step可以为负数,用于实现逆序递减。
2. 典型场景代码示例
# 1. 单参数:固定循环执行 3 次
print("--- 单参数循环 ---")
for i in range(3):
    print(f"轮次: {i}")

# 2. 双参数:指定区间 [5, 9)
print("--- 双参数区间 ---")
even_sum = 0
for n in range(5, 9):
    even_sum += n
print("区间和为:", even_sum)

# 3. 三参数:指定跨度步长采样与负步长倒计时
print("--- 步长与倒计时 ---")
print("步长为2:", list(range(10, 20, 2)))
print("倒计时:", list(range(5, 0, -1)))轮次: 0
轮次: 1
轮次: 2
--- 双参数区间 ---
区间和为: 26
--- 步长与倒计时 ---
步长为2: [10, 12, 14, 16, 18]
倒计时: [5, 4, 3, 2, 1]
3. range 的惰性求值特性辨析
在 Python 2 中,range() 会在内存中一次性分配全部数字列表,容易耗尽系统内存。而在现代 Python 3 中,range 是一个专门的内置类,它仅在内部记录 start、stop 和 step 三个整数属性。
无论你创建 range(10) 还是 range(10_000_000_000),它在内存中的占用都仅有约 48 字节。只有在循环推进或显式转换为列表时,才会依次产出数字。此外,它原生支持高效的索引、切片以及 O(1) 复杂度的成员判断(val in range_obj 通过数学模运算直接计算,不进行逐项查找)。
三、enumerate():带序号遍历的优雅解法
当我们在循环处理列表、元组或文本行时,常常既需要获取元素本身的内容,又需要获知当前元素对应的位置序号。
1. 为什么应摒弃 range(len(seq)) 反模式
很多从 C/Java 转向 Python 的开发者习惯写出如下代码:
# 传统冗长写法(不推荐)
tasks = ["环境检查", "依赖安装", "编译构建", "自动化测试"]
for i in range(len(tasks)):
    task = tasks[i]
    print(f"步骤 {i + 1}: {task}")
虽然这种写法能正常运行,但在 Python 社区中被视为典型的反模式(Anti-Pattern)。它的弊端显而易见:
- 需要先计算
len()再构造range(),多了一层嵌套包装; - 在循环体内部必须通过
tasks[i]二次寻址,语法冗余且容易误敲变量名; - 完全无法应用于没有下标索引特性的可迭代对象,例如集合
set、生成器表达式或打开的文件行迭代器。
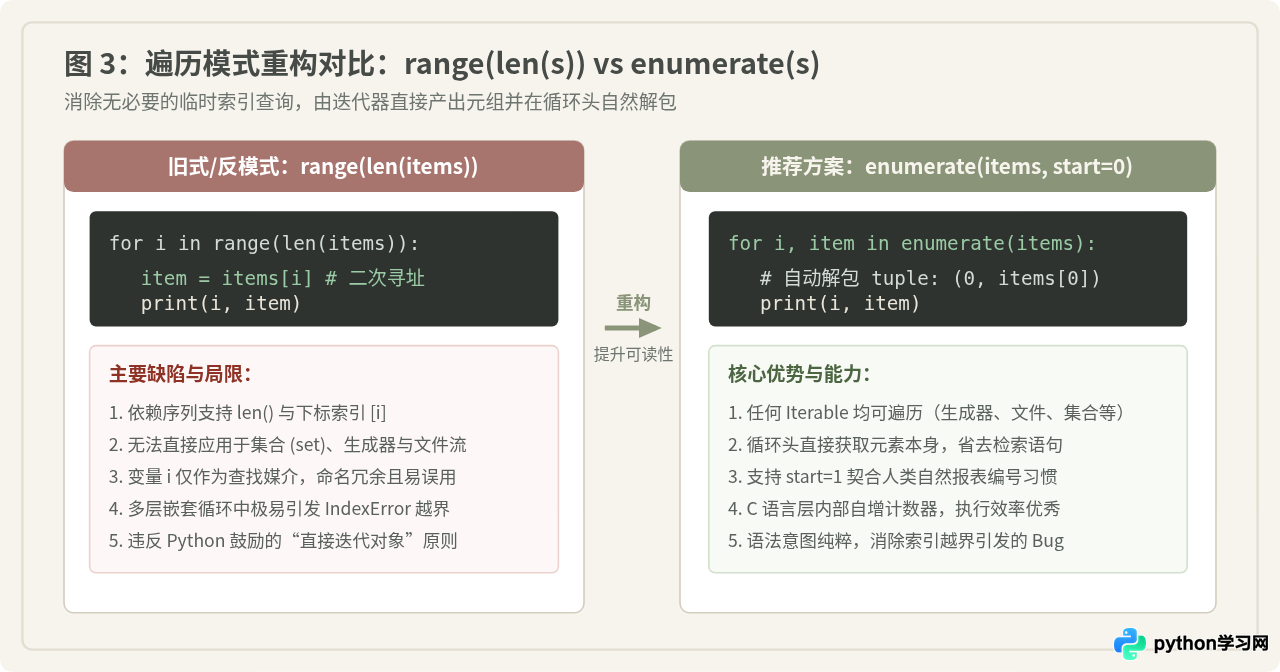
2. enumerate() 的标准用法与 start 参数
enumerate(iterable, start=0) 接收一个可迭代对象,返回一个生成 (index, value) 元组的迭代器。借助 Python 的多元赋值解包机制,我们可以直接在 for 语句头部分离序号与元素:
tasks = ["环境检查", "依赖安装", "编译构建", "自动化测试"]

# 标准用法:同时解包获取索引 i 和元素 task
for i, task in enumerate(tasks):
    print(f"索引 {i} -> 任务: {task}")

print("-" * 30)

# 进阶用法:指定 start=1,直接生成符合日常业务编号的清单
for step_num, task in enumerate(tasks, start=1):
print(f"第 {step_num} 步: {task}")索引 1 -> 任务: 依赖安装
索引 2 -> 任务: 编译构建
索引 3 -> 任务: 自动化测试
------------------------------
第 1 步: 环境检查
第 2 步: 依赖安装
第 3 步: 编译构建
第 4 步: 自动化测试
3. 在不可切片迭代器上的泛用性
enumerate() 不依赖底层对象的 __getitem__ 随机访问特性。即使是逐行读取文件、数据库游标或动态生成器,它也能在 CPython 底层顺畅递增计数:
# 模拟读取日志生成器
def log_stream():
    yield "2026-10-30 10:00:01 [INFO] 节点就绪"
    yield "2026-10-30 10:00:05 [WARN] 内存占用超过75%"
    yield "2026-10-30 10:00:12 [INFO] 任务队列完成"

# 优雅为流式日志附加行号
for line_no, record in enumerate(log_stream(), start=101):
print(f"行号 {line_no} | {record}")行号 102 | 2026-10-30 10:00:05 [WARN] 内存占用超过75%
行号 103 | 2026-10-30 10:00:12 [INFO] 任务队列完成
四、三者综合场景与选型决策指南
在实际工程开发中,这三个函数经常组合使用,但在选择具体工具时应当遵循清晰的判定规则。
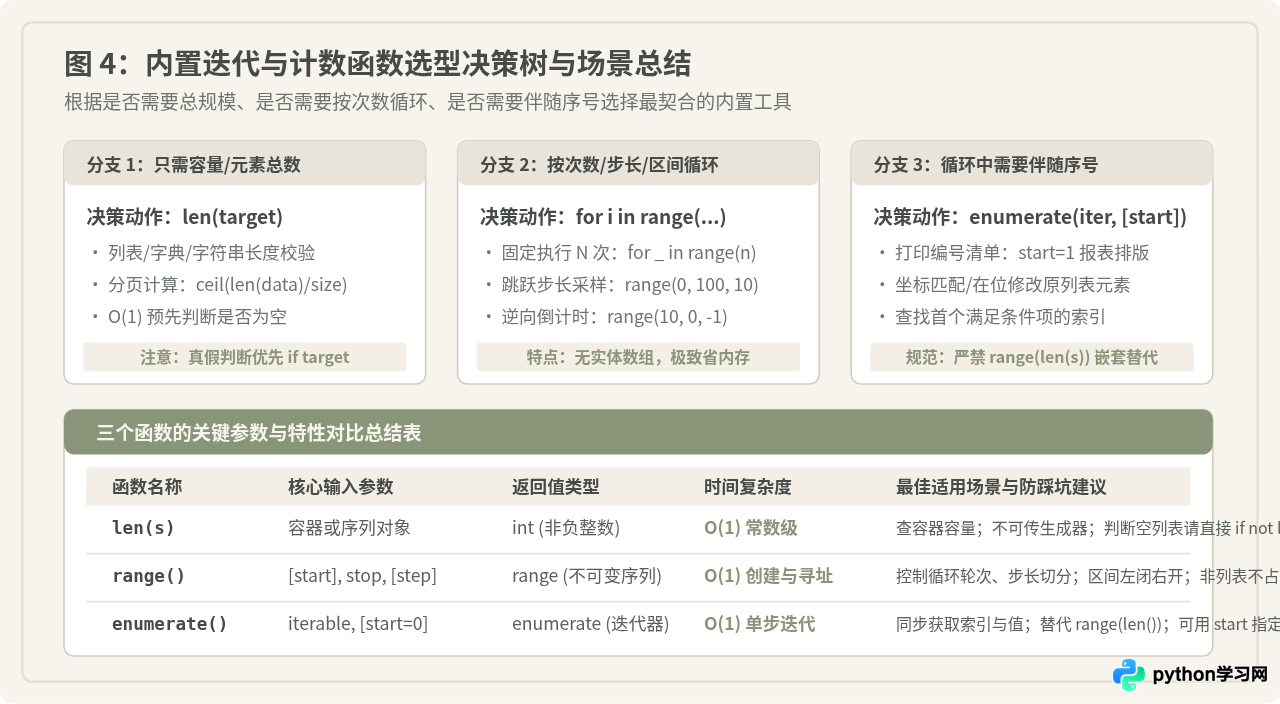
1. 综合实战案例:在位更新与带条件过滤
在某些业务场景中,我们需要根据业务规则修改原列表中的部分元素,同时输出变更记录:
scores = [58, 85, 92, 45, 78, 60]

print("调分前原始数据:", scores)

# 需求:找出不及格成绩(<60),按补偿分调整,并标记原位置
for idx, score in enumerate(scores):
    if score < 60:
        boosted = score + 5
        scores[idx] = boosted  # 凭借 enumerate 提供的索引进行在位安全赋值
        print(f"序号 {idx}: {score} 分已调整为 {boosted} 分")

print("调分后最终数据:", scores)
print(f"总计批改考卷份数: {len(scores)}")序号 0: 58 分已调整为 63 分
序号 3: 45 分已调整为 50 分
调分后最终数据: [63, 85, 92, 50, 78, 60]
总计批改考卷份数: 6
2. 常见问题排查与速查清单
- 问题 1:为什么
print(range(5))打印出来的不是列表?
解答:在 Python 3 中range是独立的不可变序列对象,不会主动展开为列表。如果需要查看实际内容,可使用list(range(5)),但在循环中直接for x in range(5):最为高效省内存。 - 问题 2:为什么
enumerate()只能遍历一次?
解答:enumerate返回的是迭代器对象。一旦使用循环遍历完毕,该迭代器即被耗尽。若需多次反复遍历同一带索引序列,应将其持久化为元组列表list(enumerate(data))。 - 问题 3:什么时候才应该使用
range(len(seq))?
解答:绝大多数情况都不应当使用。唯有当算法需要显式做多指针移动(如双指针相向逼近、滑动窗口)、或者同时跨越非固定步长修改多个索引时,直接管理整型下标才具备合理性。否则,一律优先使用enumerate()或zip()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















