


Python字符串和列表怎么用切片提取前六位
本文深入讲解在Python中使用切片语法提取字符串和列表前六位具体操作方法,解析左闭右开索引机制、边界与容错处理以及内存特性,帮助读者准确掌握序列截取技巧。
[:6]。无论是字符串还是列表,只需在变量名后紧跟方括号及冒号与数字6(例如 text[:6] 或 items[:6]),即可截取下标从 0 到 5 的前六个元素并返回同类型的新序列。
一、核心语法与基础代码示例
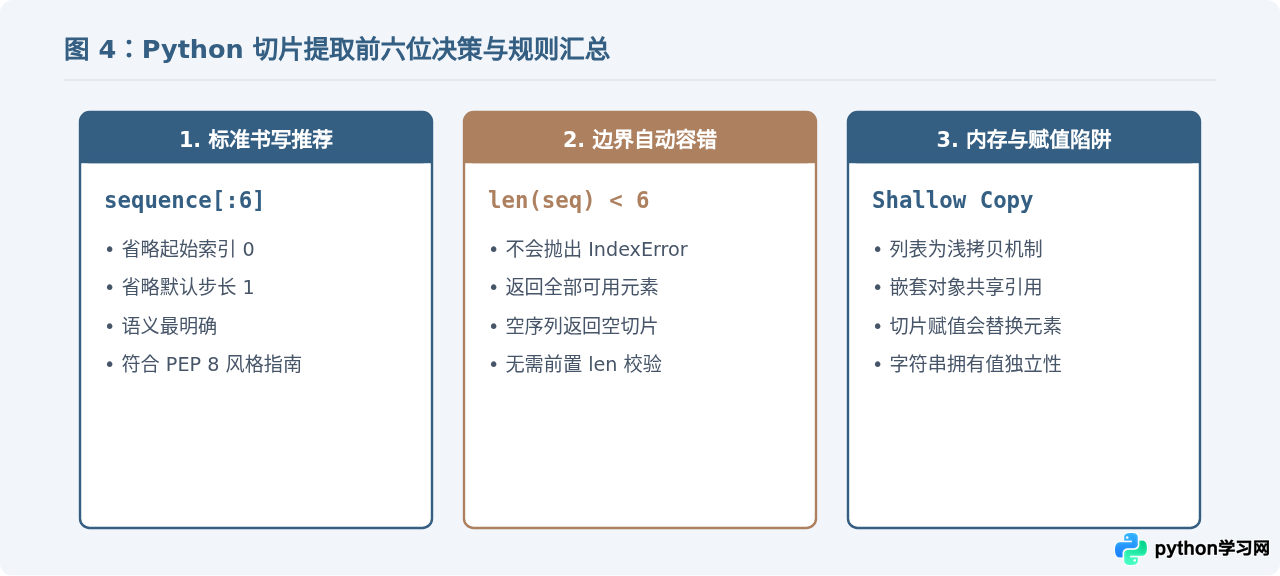
Python 中的切片语法格式为 sequence[start:stop:step]。当我们需要从序列的最开始提取元素时,起始位置 start 默认为 0,因此可以省略不写;终止位置 stop 填写 6,步长 step 默认为 1 亦可省略。最终简化后的切片表达式就是 [:6]。
1. 字符串提取前六位
对于字符串类型,切片操作会截取前六个字符,并返回一个全新的字符串对象:
# 示例代码:提取字符串前六位
sample_str = "HelloWorldPython"
result_str = sample_str[:6]

print("截取结果:", result_str)
print("结果类型:", type(result_str))

# 示例输出:
# 截取结果: HelloW
# 结果类型: <class 'str'>
2. 列表提取前六位
对于列表类型,切片操作会截取前六个元素,并返回一个包含对应元素的新列表:
# 示例代码:提取列表前六位
sample_list = [10, 20, 30, 40, 50, 60, 70, 80, 90]
result_list = sample_list[:6]

print("截取结果:", result_list)
print("结果类型:", type(result_list))

# 示例输出:
# 截取结果: [10, 20, 30, 40, 50, 60]
# 结果类型: <class 'list'>
二、切片索引原理:理解“左闭右开”区间
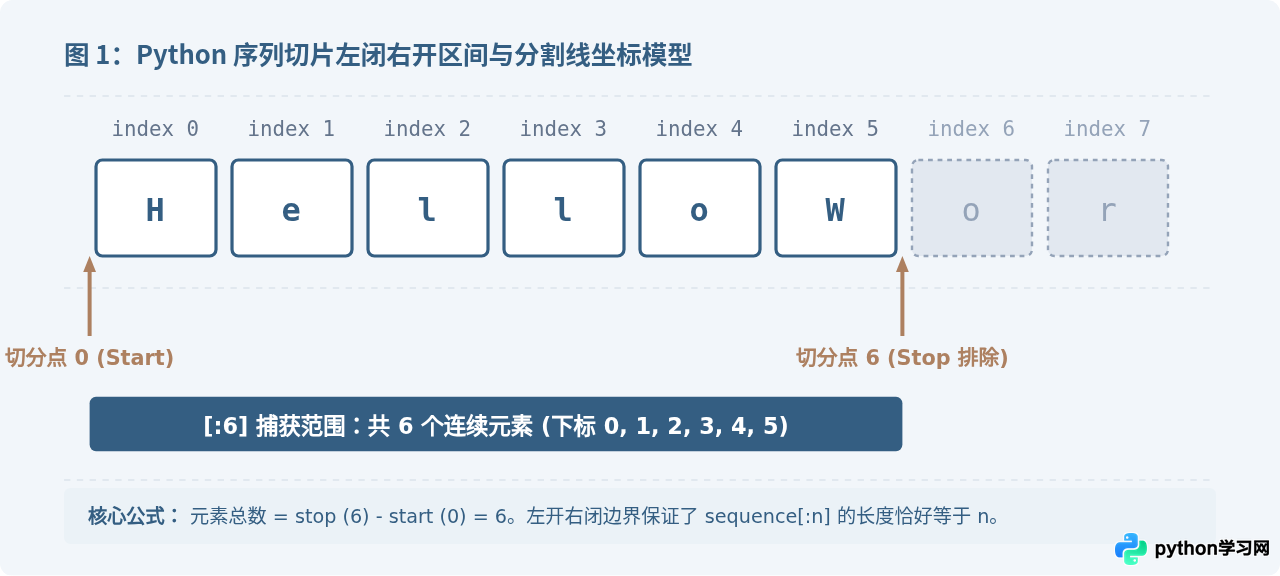
很多初学者在编写切片时会有疑问:既然是提取 6 个元素,为什么末尾写 6,而不是下标 5?这源于 Python 切片设计的核心规则——左闭右开区间(Half-Open Interval),即包含起始下标 start,但不包含终止下标 stop,数学上表示为 [start, stop)。
计算机中的序列索引从 0 开始计数。前六位元素分别对应的下标是 0, 1, 2, 3, 4, 5。如果切片写成 [0:6],Python 会从索引 0 开始提取,直到遇到索引 6 之前停止,刚好选出索引 0 到 5 共计 6 个元素。计算提取元素个数的公式非常简单:stop - start = 6 - 0 = 6。
三、提取前六位的标准执行流程与推导
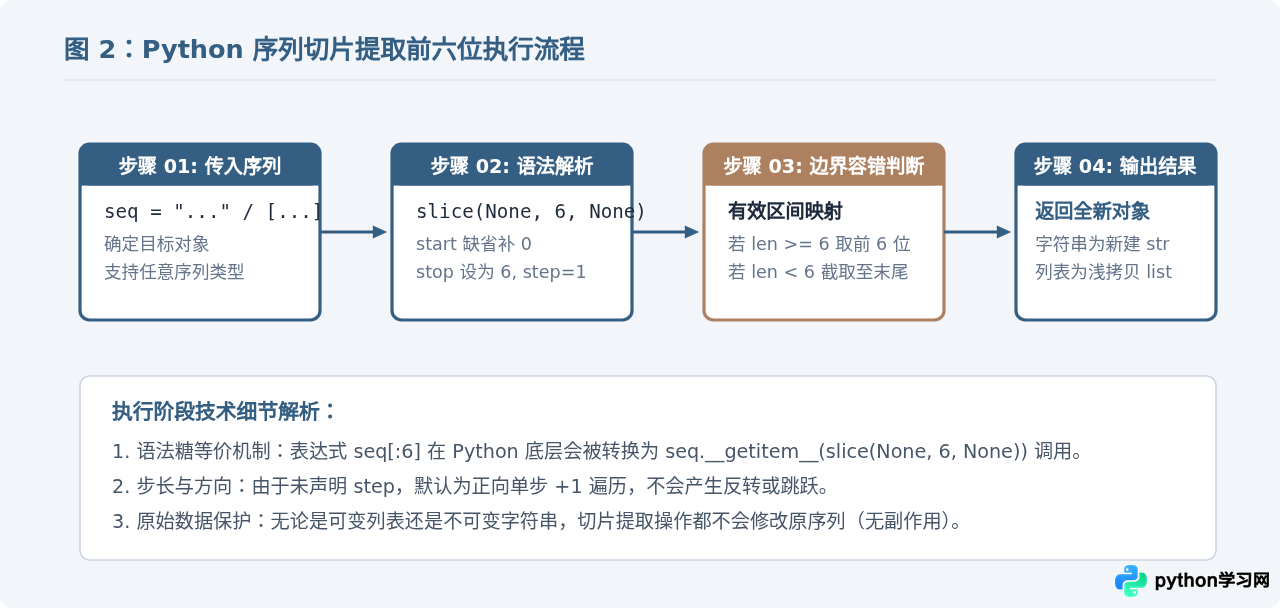
在实际开发中,对序列进行前六位提取遵循清晰的逻辑执行步骤。切片解析器首先定位起始和截止索引,然后根据底层内存模型生成切片结果。具体执行流程如下:
四、关键细节与边界情况处理
在工程开发中,处理真实业务数据时常常会遇到各种非标准数据或特殊需求,以下是提取前六位时必须掌握的三个关键场景:
1. 长度不足六位时的自动容错(不会抛出 IndexError)
初学者常常担心:如果字符串或列表的长度不足 6 位(例如只有 3 个字符),执行 [:6] 会不会报 IndexError: list index out of range?
结论:切片操作具有内置容错机制,绝不会抛出索引越界异常。当序列长度小于指定的 stop 索引时,切片会自动静默截取到序列末尾,返回当前实际拥有的全部元素。
# 示例代码:序列长度小于6时的切片表现
short_str = "Cat"
short_list = [1, 2]

print("短字符串截取:", short_str[:6])
print("短列表截取:", short_list[:6])

# 示例输出:
# 短字符串截取: Cat
# 短列表截取: [1, 2]sample_list[5])在长度不足时会抛出 IndexError;但切片语法 sample_list[:6] 是区间操作,Python 会在底层自动将 stop 限制在 min(stop, len(sequence)),因此始终保持安全。
2. 步长参数的扩展应用
完整切片包含第三个参数 step。虽然提取前六位的标准写法是 [:6],但如果需要“在前六位范围内每隔一个元素提取”,可以传入步长:
# 示例代码:在前六位范围内按步长提取
data = ["A", "B", "C", "D", "E", "F", "G", "H"]
# 提取前6位内偶数位下标元素 (索引 0, 2, 4)
step_sample = data[:6:2]

print("间隔提取:", step_sample)

# 示例输出:
# 间隔提取: ['A', 'C', 'E']
五、底层内存与特性对比:字符串与列表的差异
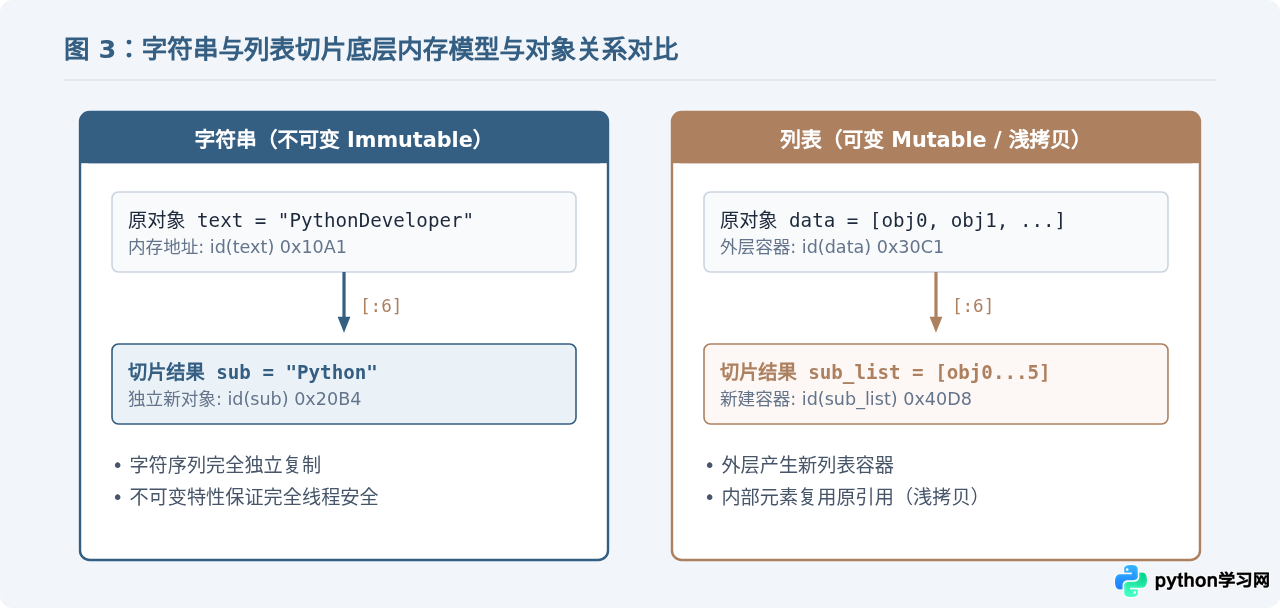
虽然切片对字符串和列表的外在语法一致,但两者的底层数据结构和内存分配机制存在根本差异:
- 字符串(str):属于不可变序列(Immutable)。无论切片提取前六位还是进行拼接,原字符串在内存中的字符数组都不会改变,切片结果会在内存中分配空间并生成全新的字符串对象。
- 列表(list):属于可变序列(Mutable)。执行
lst[:6]时,Python 会创建一个新的列表对象,但新列表内部存储的是原列表中前六个元素的浅拷贝(Shallow Copy)引用。如果列表中包含可变嵌套对象(如字典或子列表),修改新列表中的嵌套对象仍会影响原列表。
六、切片特性对照与综合速查
为了帮助读者在不同开发场景下快速决策,下表总结了字符串与列表在提取前六位时的特性对照:
| 对比维度 | 字符串提取前六位 str[:6] |
列表提取前六位 list[:6] |
|---|---|---|
| 标准代码写法 | result = text[:6] |
result = items[:6] |
| 返回结果类型 | 新字符串 (str) |
新列表 (list) |
| 原对象是否改变 | 否(原字符串保持不变) | 否(原列表保持不变) |
| 长度不足6时 | 返回全部字符(长度 0 ~ 5) | 返回全部元素(长度 0 ~ 5) |
| 抛出 IndexError | 否(完全安全) | 否(完全安全) |
| 内存行为 | 创建独立只读字符串对象 | 创建新列表,包含前六位元素的引用 |
七、常见问题解答
问:写法 [:6] 和 [0:6] 有区别吗?
答:功能上完全相同,执行结果也完全一致。但省略 0 写成 [:6] 是 Python 官方文档和社区推荐的标准习惯,代码更加简练。
问:如果想修改列表的前六位,切片能否直接用于赋值?
答:列表作为可变序列,支持切片赋值。例如执行 items[:6] = [1, 2, 3],会将原列表中前六个元素替换为指定的新内容。而字符串是不可变的,对字符串执行切片赋值(如 text[:6] = "abc")会导致 TypeError。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















