


本地部署RAG知识库需要多少硬件资源:GPU与内存评估
本文针对个人开发者和小团队,拆解本地部署RAG(检索增强生成)系统的真实硬件需求。通过对比纯CPU方案与GPU加速方案,明确嵌入模型、向量数据库和大语言模型各自的资源占用,提供从4GB显存到24GB显存的分级配置建议,帮助读者在预算与性能间找到平衡点。
在本地搭建一套RAG(检索增强生成)系统,最大的痛点往往不是代码逻辑,而是硬件资源的分配。很多开发者在选型时容易陷入误区:要么高估了向量检索的计算量,导致购买了不必要的顶级显卡;要么低估了大语言模型(LLM)的显存需求,导致推理速度极慢甚至直接OOM(内存溢出)。
实际上,RAG系统的硬件瓶颈主要集中在两个环节:一是将文档转化为向量的“嵌入”过程,二是最终生成回答的“大模型推理”过程。对于中小规模的私有知识库,只要合理选择模型量化版本和批处理大小,普通的消费级显卡甚至高性能笔记本也能流畅运行。
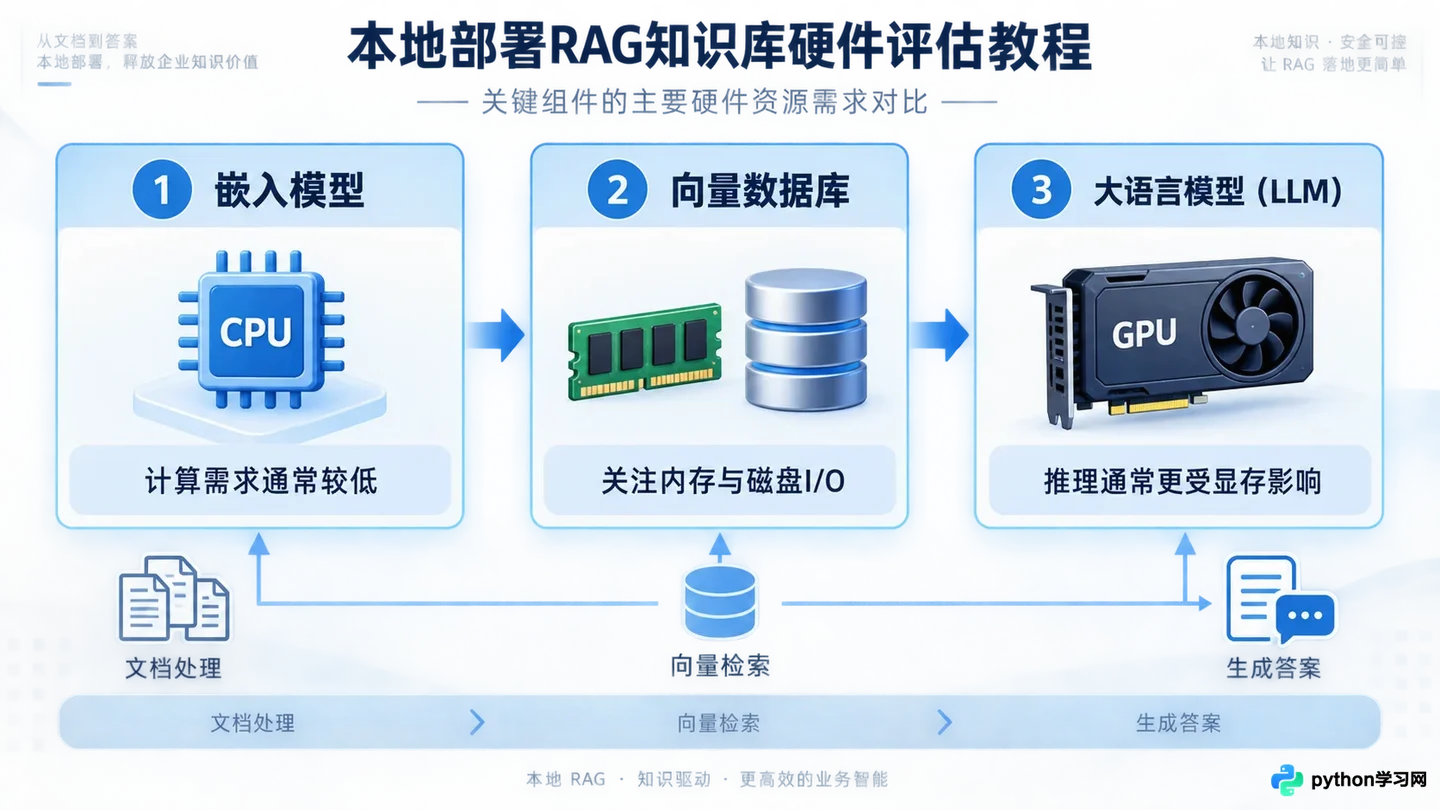
RAG系统各组件对硬件资源的依赖分布
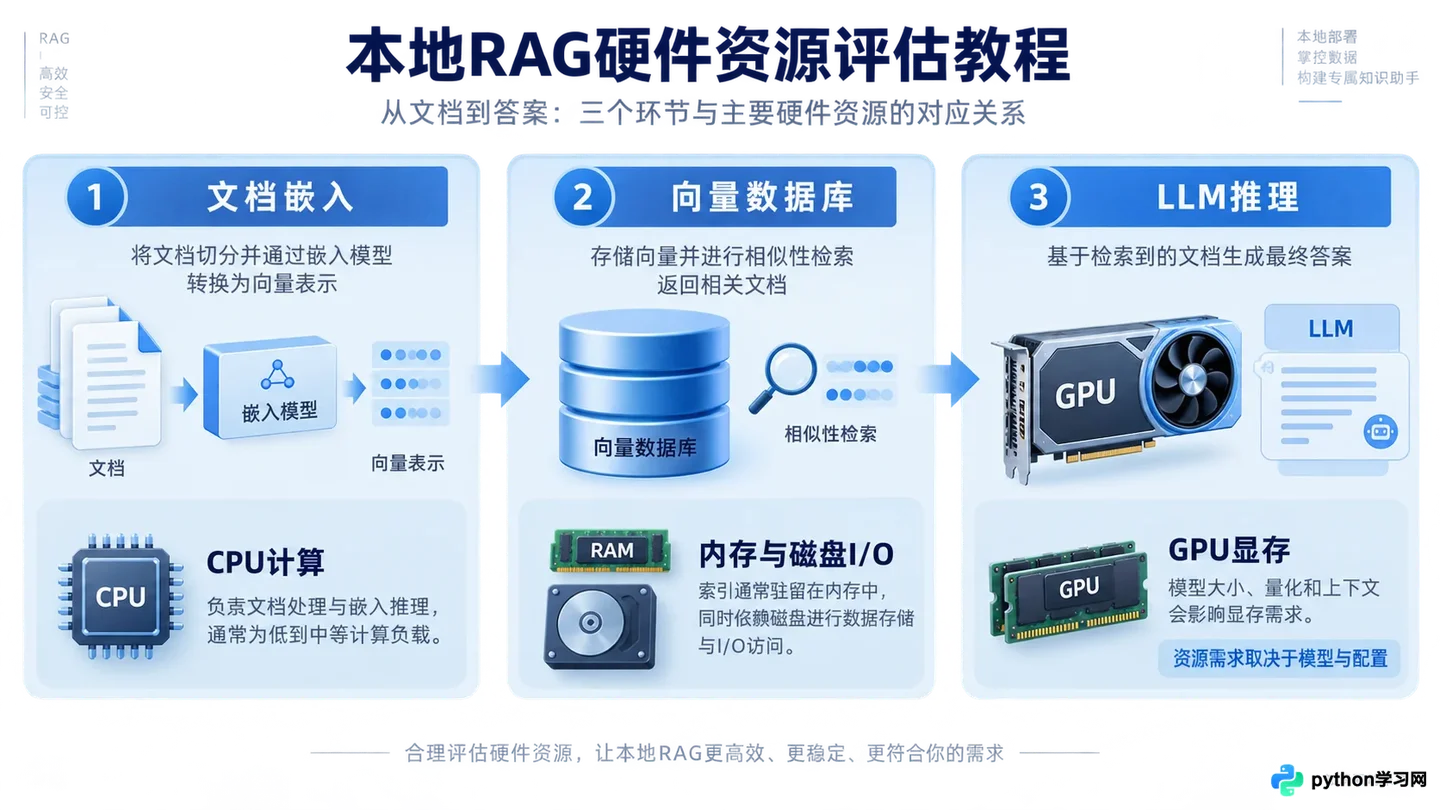
1. 拆解RAG三大组件的资源消耗
要准确评估硬件,首先得知道资源都去哪了。一个标准的本地RAG流程包含三个核心部分,它们的硬件偏好各不相同。
首先是嵌入模型(Embedding Model)。它的作用是将你的PDF、Word文档切成片段并转化为向量。这类模型通常较小(如BGE-M3、text-embedding-ada-002的本地替代品),计算密度低。即使是CPU,处理几百页文档也只需几分钟,对实时性要求不高时,完全不需要GPU介入。
其次是向量数据库。无论是Chroma、Milvus还是Faiss,它们主要消耗的是内存(RAM)和磁盘I/O。向量索引一旦建立,查询阶段的计算量极小,主要依赖内存带宽。因此,大内存比强GPU更重要。
最后是大语言模型(LLM)。这是硬件消耗的绝对大头。无论是Llama 3、Qwen还是ChatGLM,参数量决定了显存底线。7B参数的模型在FP16精度下需要约14GB显存,而经过4-bit量化后,可压缩至6GB左右。这就是为什么我们常说“显存即正义”。
1. 拆解RAG三大组件的资源消耗
2. 入门级配置:CPU为主,小显存辅助
如果你只是想在个人笔记本上测试RAG流程,或者知识库文档量在几千页以内,不需要追求秒级响应,那么入门级配置足以胜任。
推荐配置:
- CPU: 现代多核处理器(如Intel i5/i7 12代以上,或AMD Ryzen 5/7)。
- 内存: 16GB - 32GB DDR4/DDR5。
- GPU: 集成显卡或入门独显(4GB - 6GB显存)。
在这种配置下,策略是“重CPU轻GPU”。嵌入过程完全交给CPU多线程处理,虽然速度慢一些,但不会报错。对于LLM,必须使用高度量化的模型,例如Q4_K_M格式的7B参数模型。使用Ollama或LM Studio等工具加载时,确保将上下文窗口(Context Window)限制在4k-8k以内,这样可以防止内存爆满。
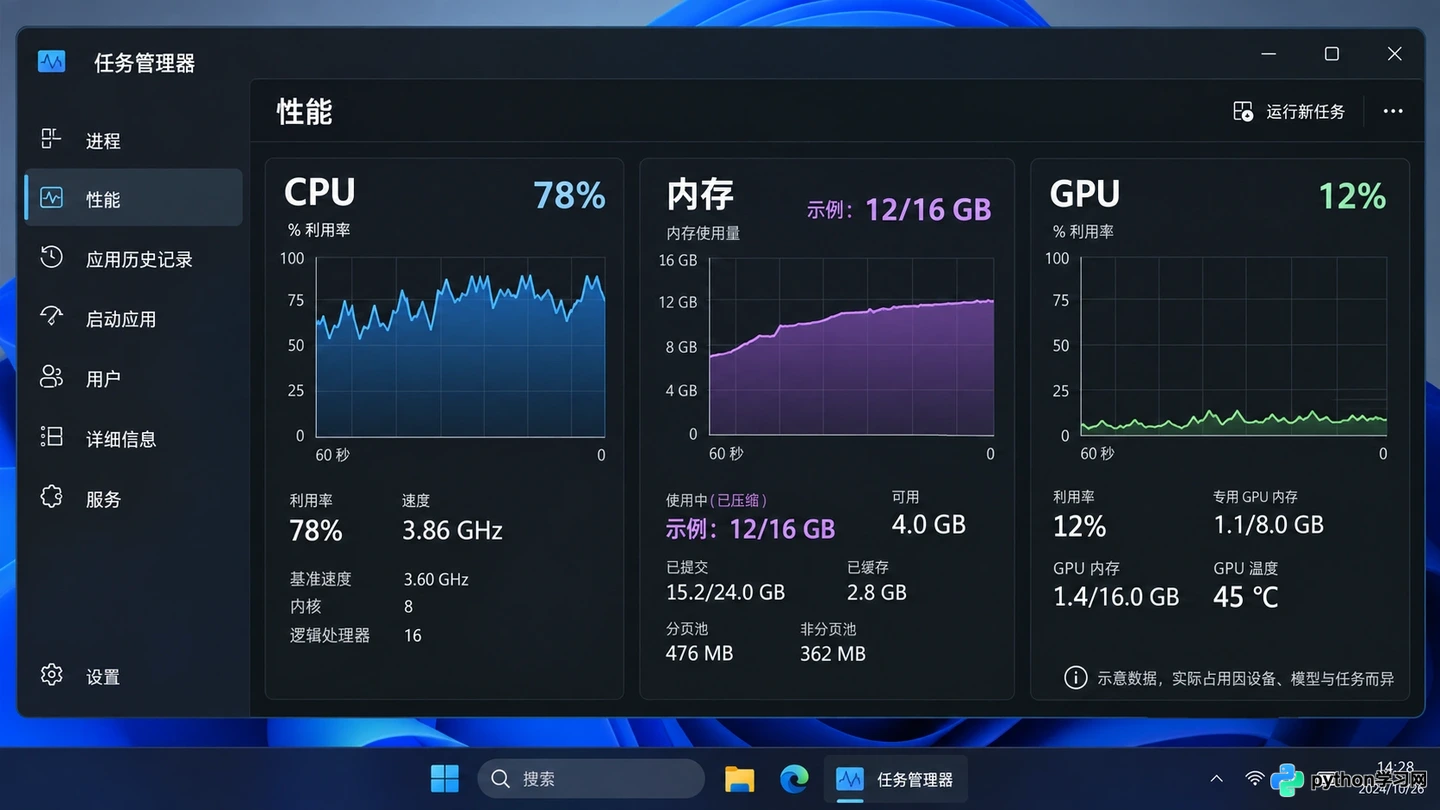
入门级配置下CPU高负载与内存占用情况
实际操作中,你会发现文档导入阶段(Embedding)会占用较高的CPU利用率,风扇狂转是正常的。而在问答阶段,如果显存不足,系统会自动将部分层卸载到系统内存中,这会导致生成速度从每秒几十个字下降到每秒几个字,但功能依然可用。
3. 进阶级配置:单卡加速,平衡性价比
对于小团队内部使用,或者希望获得流畅对话体验的用户,一张中高端消费级显卡是分水岭。这个级别的目标是让LLM完全驻留在显存中,实现高速推理。
推荐配置:
- GPU: NVIDIA RTX 3060 12GB / 4060 Ti 16GB / 4070 Ti Super 16GB。
- 内存: 32GB - 64GB。
- 存储: NVMe SSD(加速向量库读取)。
这里特别推荐RTX 3060 12GB或4060 Ti 16GB,因为显存容量比核心频率更关键。12GB显存可以 comfortably 容纳一个7B模型的Q4量化版本,并留出足够的空间给KV Cache(键值缓存),支持更长的上下文窗口(如16k-32k)。
在这个配置下,你可以尝试稍大一点的嵌入模型,或者开启GPU加速的向量索引(如CuVS)。此时,RAG的整个链路——从文档解析、向量化到最终生成——都可以获得显著的加速。特别是当并发用户数增加到2-3人时,12GB以上的显存能保证服务不崩溃。
4. 专业级配置:大参数模型与高并发
如果需要部署13B、34B甚至70B参数的模型,或者需要支持数十人同时查询知识库,就需要专业级的硬件投入。此时,单张消费级显卡往往捉襟见肘,需要考虑多卡互联或专业卡。
推荐配置:
- GPU: 双RTX 3090/4090 24GB(共48GB显存)或 A100/A800 80GB。
- 内存: 128GB及以上。
24GB显存是运行13B-20B参数模型量化版的舒适区。如果要运行70B模型,即使经过4-bit量化,也需要约40GB显存,这就必须使用两张24GB显卡进行模型并行,或者直接使用A100等专业卡。
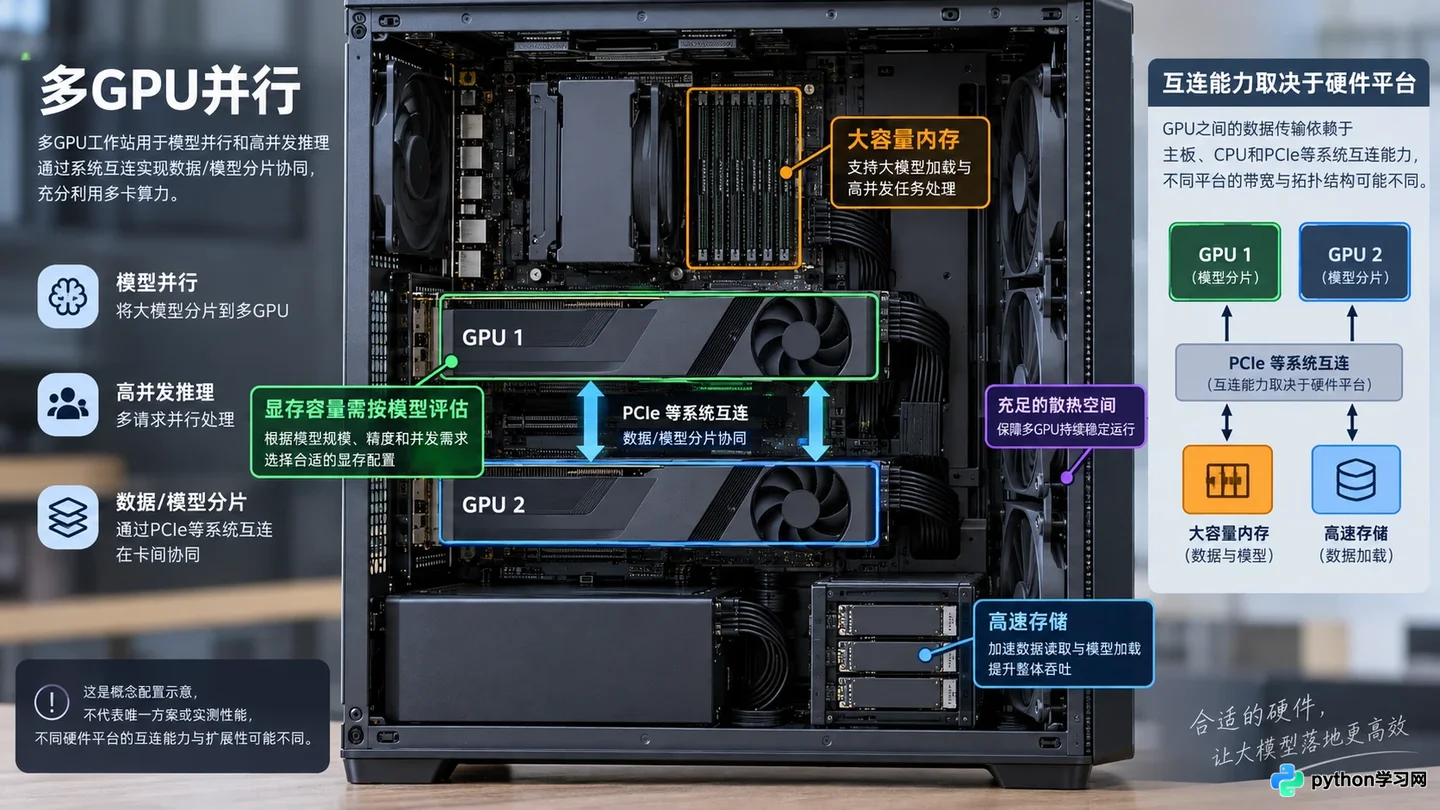
专业级多卡并行部署硬件结构
在企业级部署中,除了模型本身,还要考虑向量数据库的性能。当向量数量达到千万级时,内存需求量会急剧上升。此时,大内存不仅用于加载模型,更用于维持向量索引的热数据缓存,确保检索延迟在毫秒级。
5. 如何根据场景做最终决策
不要盲目追求最高配置,请根据你的具体使用场景对号入座:
- 个人学习/演示Demo: 16GB内存 + CPU即可。重点在于跑通流程,速度慢点没关系。使用Ollama加载Qwen2-7B-Instruct-Q4,配合ChromaDB,零成本启动。
- 小团队知识助手(<10人): 1张RTX 3060 12GB或4060 Ti 16GB。保证单人使用时响应迅速,偶尔多人并发也能排队处理。这是性价比最高的选择。
- 企业核心业务系统: 多卡24GB显存组合或专业卡。需要保证高可用性、低延迟和对长文档的深度理解能力。此时硬件成本应让位于稳定性及数据安全。
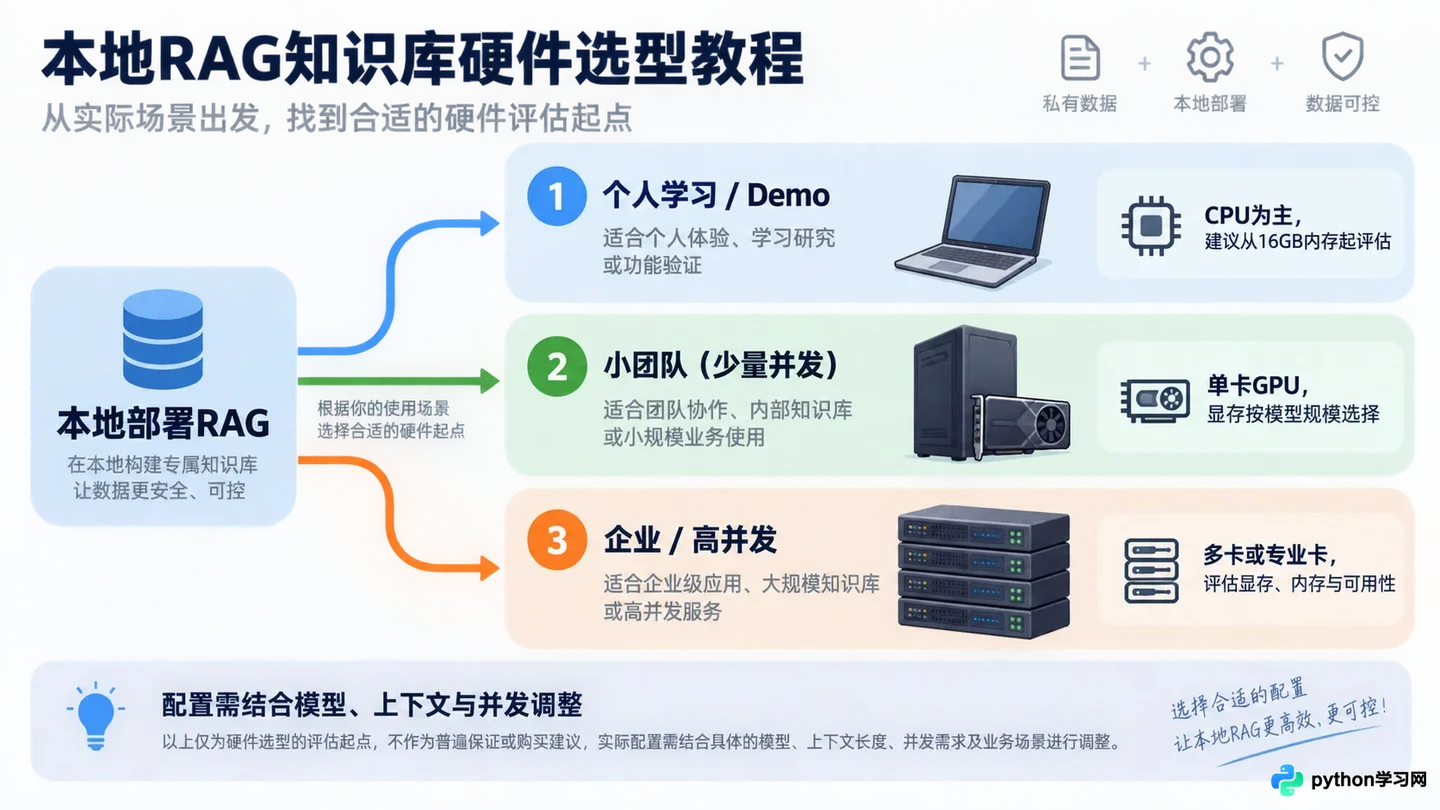
根据不同使用场景选择硬件配置的决策路径
最后提醒一点,软件优化也能“省”硬件。使用更高效的嵌入模型(如bge-m3)、对文档进行更精细的分块(Chunking)、以及启用KV Cache量化,都能在不升级硬件的情况下提升系统表现。先软件调优,再硬件升级,才是部署RAG的正确姿势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















