


Python调试打印变量与logging日志记录的最佳实践区别
深入解析Python调试中print打印变量与logging日志记录的核心区别、适用场景及最佳实践。涵盖运行机制、架构流程、代码示例及生产演进方案。
print 属于瞬态、即席的本地调试手段,生命周期随调试结束而应当立即删除;而标准库 logging 是工业级的系统观测方案,具备级别过滤、多目标分发、上下文注入与日志轮转能力。厘清二者的本质区别并在适当时机平滑演进,是保障代码质量与线上稳定性的关键。
一、核心认知:print 与 logging 的本质定位差异
初学者编写 Python 代码时,遇到逻辑偏差最直接的反应往往是在代码各处插入 print(variable)。在几行到几十行的简单脚本中,这种操作简单高效。然而,一旦项目规模扩大、引入多模块协同,或者部署到无人值守的生产服务器上,残留的 print 就会暴露出严重缺陷。
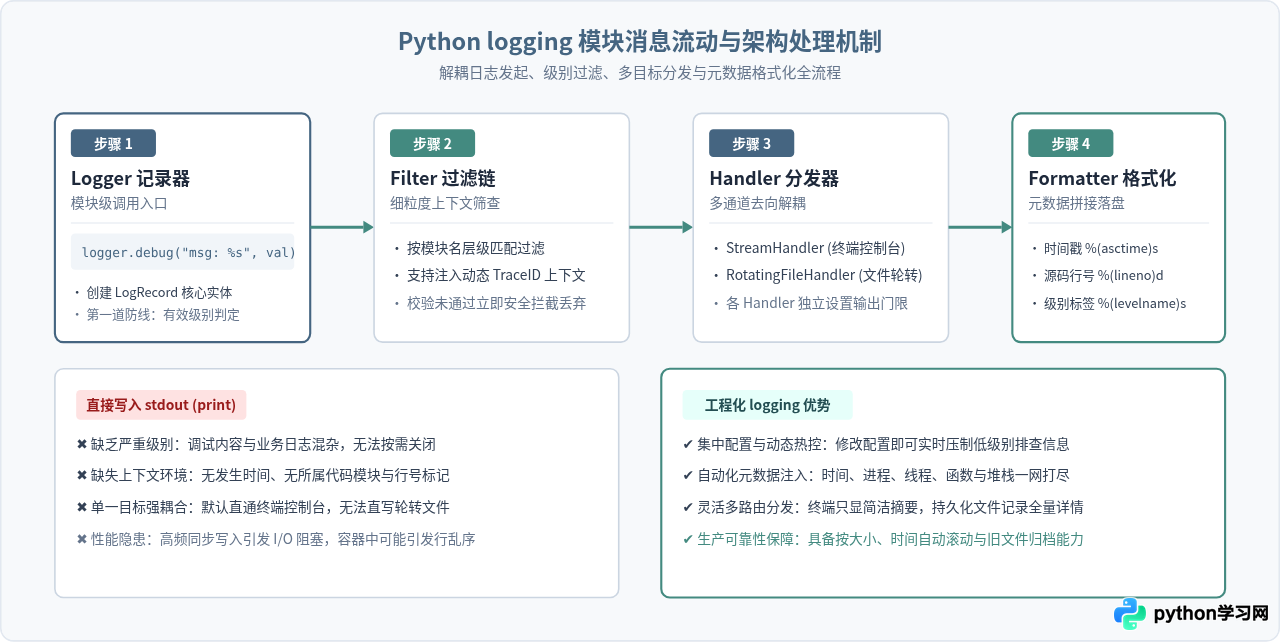
理解二者的差异,首先要从它们的系统职责入手:
- 生命周期差异:
print专为“开发时刻”的人机交互而设计。它的目标是给当前坐在屏幕前的开发者一个即时反馈,调试完成后必须人工清理;logging专为“全生命周期”的系统运行而设计,伴随软件从测试、灰度到生产的整个阶段,提供持续的状态监控与故障回溯依据。 - 控制粒度差异:
print是硬编码的输出语句,Python 解释器只要执行到该行,就会无差别地写入标准输出;logging引入了标准的严重级别(DEBUG、INFO、WARNING、ERROR、CRITICAL),开发者可以在程序外部通过配置随时调整全局或单个模块的输出门限,实现零代码修改即可静默低级调试信息。 - 输出通道解耦:
print默认且仅直接绑定标准输出流(sys.stdout);logging采用模块化管道设计,支持将不同级别的日志分别分发到终端、按大小/时间自动滚动的日志文件、系统 Syslog,甚至远程集中式日志服务中。 - 元数据与溯源能力:
print输出的内容完全依赖人工手写拼接;logging框架在每次记录时会自动捕获时间戳、模块名称、文件名、代码行号、线程/进程 ID 以及完整的异常堆栈(Traceback)。
二、深度对比:六大关键维度的功能与性能指标
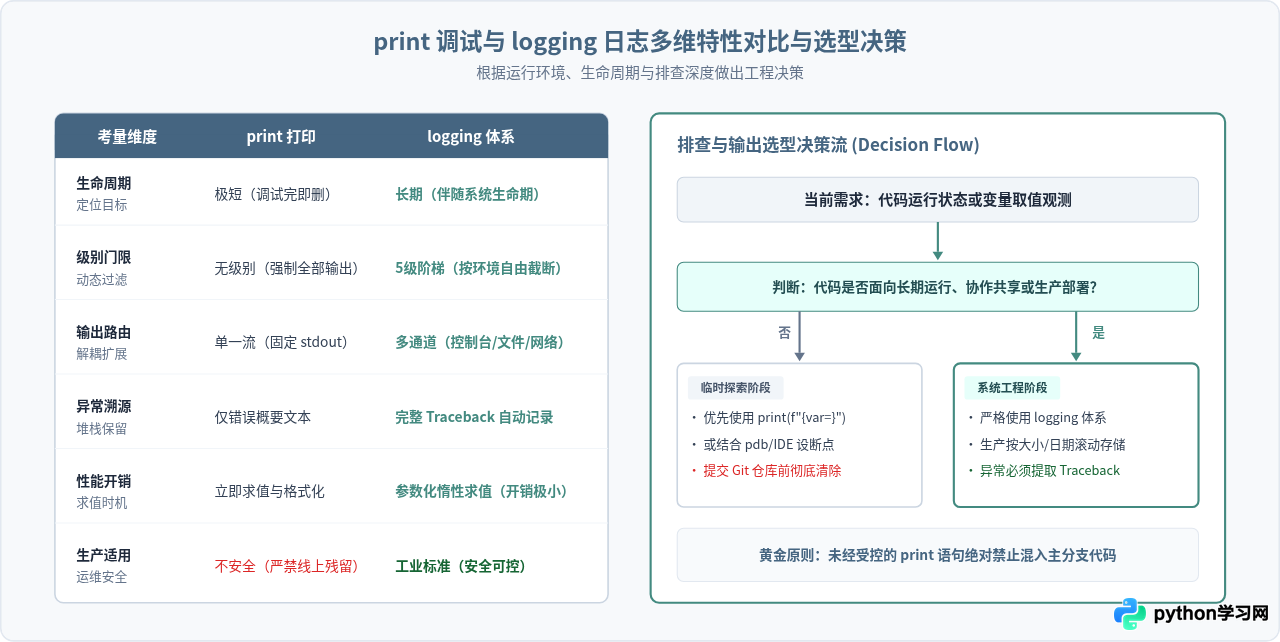
为了更清晰地展示为何不应在生产环境直接使用 print,我们可以从以下六个关键技术维度进行横向比对:
| 特性维度 | print 打印语句 | logging 日志模块 |
|---|---|---|
| 过滤与级别 | 无级别概念。写在代码中就会执行输出,无法在不改动源码的前提下将其屏蔽。 | 内置 5 级标准级别(DEBUG/INFO/WARNING/ERROR/CRITICAL),支持全局或针对模块单独过滤。 |
| 输出目标 | 固定输出到 sys.stdout。若要重定向需在 Shell 层或修改解释器全局句柄。 |
通过 Handler 支持多通道并行输出:标准终端、多文件轮转、Syslog、邮件及远程监控服务。 |
| 上下文元数据 | 无元数据。如需显示时间、行号,必须开发者在每个 print 中自行调用模块拼装。 | Formatter 自动注入时间戳、进程/线程名、源文件名、函数名、行号等完整调试要素。 |
| 异常堆栈捕获 | 在 except 块中通常只能打出 str(e),丢失具体出错代码行号与调用上下文。 |
内置 logger.exception(),自动提取并格式化完整的异常调用栈(Traceback)。 |
| 性能开销机制 | 使用 f-string 或 + 会在执行时立即计算字符串;高频输出引发同步 I/O 阻塞。 |
支持参数化传参(惰性求值)。当日志级别低于门限时,直接跳过格式化字符串计算,开销极低。 |
| 生产环境风险 | 容易造成输出泛滥并撑满容器标准输出;难以追溯事件时序;可能意外泄露敏感字段。 | 具备日志切割轮转机制(避免撑爆磁盘),支持 Filter 统一脱敏与规范化结构存储。 |
三、场景代码剖析:从初学者写法到生产级标准
通过具体代码示例,可以更直观地看清初学者的临时 print 写法与工程级 logging 的明显反差:
1. 变量追踪与信息输出
初学者排查订单处理流程时经常这样写:
# 脆弱的初学者写法
def process_order(order_id, user_id, amount):
    print(f"进入处理: order_id={order_id}, user={user_id}")
    if amount <= 0:
        print(f"警告:金额异常 {amount}")
        return False
    # 业务逻辑...
    print(f"订单 {order_id} 结算完毕")
return True问题所在:高并发下数千个订单同时处理,控制台将输出成千上万行无时间戳、无线程标识的孤立文本;更严重的是,无法在不改动代码的前提下关掉这些输出。
工程级 logging 的标准做法:
import logging

# 基于当前模块命名空间初始化 Logger
logger = logging.getLogger(__name__)

def process_order(order_id, user_id, amount):
    # 使用惰性格式化传参,只有在 DEBUG 开启时才会组装字符串
    logger.debug("开始处理订单: order_id=%s, user_id=%s", order_id, user_id)

    if amount <= 0:
        logger.warning("订单金额异常,拒绝结算: order_id=%s, amount=%s", order_id, amount)
        return False

    # 业务逻辑...
    logger.info("订单结算成功: order_id=%s, amount=%s", order_id, amount)
    return True
2. 异常捕获与故障现场保留
在处理外部网络请求或数据库交互时,异常记录往往是问题复盘的唯一依据:
# 糟糕的异常捕获写法
try:
    response = requests.post(payment_api_url, json=payload, timeout=5)
    response.raise_for_status()
except Exception as e:
    print(f"支付接口调用失败: {e}") # 致命伤:仅打印出错误简讯,丢失具体行号与调用链路
规范的 logging 异常处理:
try:
    response = requests.post(payment_api_url, json=payload, timeout=5)
    response.raise_for_status()
except Exception:
    # logger.exception 自动提取 sys.exc_info() 并以 ERROR 级别输出完整堆栈
logger.exception("支付接口调用异常,订单挂起: order_id=%s", order_id)except 块中直接调用 logger.exception(),无需显式传入 e,它会自动捕获完整的调用栈并在日志中输出清晰的文件名与行号。如果不是在 except 块中,也可以通过 logger.error("消息", exc_info=True) 达到完全相同的效果。
四、演进指南:从 print 到工业级 logging 的四个标准步骤
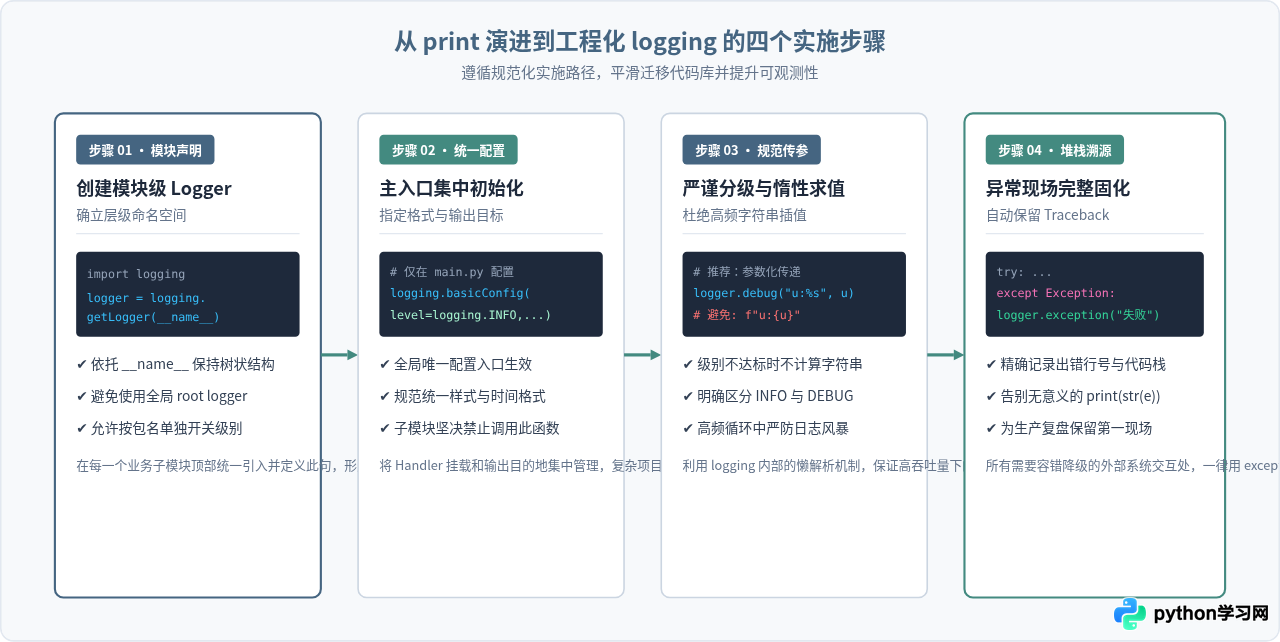
将一个充满 print 的项目重构为工程化日志体系,不必全盘推翻重写,只需遵循以下清晰的四步流程:
步骤一:创建模块级记录器(Logger)
每个 .py 文件的开头,都应通过 __name__ 初始化记录器。例如在 services/payment.py 中,生成的 Logger 名称自动为 services.payment。这样做能够天然形成点分命名树,在后续配置中可以轻松做到“仅将 payment 模块的日志级别调至 DEBUG,其余模块保持 INFO”。
步骤二:在程序顶层入口集中配置
整个应用生命周期中,根日志器(Root Logger)的初始化应只执行一次,通常位于 main.py、manage.py 或应用启动脚本中。一个标准的文件轮转与终端双输出配置示例如下:
import logging
from logging.handlers import RotatingFileHandler

def setup_logging():
    # 基础格式串:包含时间戳、线程名、级别、模块名与行号
    log_format = "%(asctime)s [%(levelname)s] %(process)d:%(threadName)s %(name)s:%(lineno)d - %(message)s"
    formatter = logging.Formatter(log_format)

    # 1. 终端处理器:输出 INFO 及以上级别
    console_handler = logging.StreamHandler()
    console_handler.setLevel(logging.INFO)
    console_handler.setFormatter(formatter)

    # 2. 轮转文件处理器:输出 DEBUG 及以上,单文件 10MB,保留 5 份历史备份
    file_handler = RotatingFileHandler(
        "app.log", maxBytes=10 * 1024 * 1024, backupCount=5, encoding="utf-8"
    )
    file_handler.setLevel(logging.DEBUG)
    file_handler.setFormatter(formatter)

    # 应用到根记录器
    root_logger = logging.getLogger()
    root_logger.setLevel(logging.DEBUG) # 根记录器放行最低级别,交由各 Handler 分别门限控制
    root_logger.addHandler(console_handler)
    root_logger.addHandler(file_handler)
步骤三:规范传参并拒绝主动格式化
很多开发者即使换用了 logging,仍然习惯写 logger.debug(f"用户查询数据: {query_heavy_func()}")。需要特别提醒的是:f-string 会在传参瞬间立即执行函数并拼接出结果字符串,哪怕当前系统日志级别是 WARNING,这行代码也会白白浪费计算资源。正确的做法是:
# 推荐:惰性求值传参
logger.debug("查询用户画像: id=%s, 渠道=%s", user_id, channel)

# 昂贵的数据序列化操作,可先判定级别是否开启
if logger.isEnabledFor(logging.DEBUG):
    logger.debug("高频运算数据详情: %s", heavy_dump(huge_dataset))
步骤四:规范异常现场捕获
放弃 print(f"error: {e}"),在 except 块中直接调用 logger.exception(...)。它不仅会自动记录异常类型和异常消息,还会附带完整的每一层函数调用代码行号,极大减少线上疑难 Bug 的排查时间。
五、生产避坑:开发者最常犯的四个错误
在多进程模型(如 Gunicorn、uWSGI)或容器云原生环境(Kubernetes)中,多个工作进程直接调用 print 会竞争标准输出流,导致日志交错撕裂;同时标准输出没有自动滚动机制,极易撑满宿主机 Docker 运行时磁盘。
如果编写的是供他人
import 的第三方库,绝对不能在模块内部调用 logging.basicConfig(),这会强行覆盖宿主主程序的日志配置。正确做法是在库顶层仅挂载 logging.NullHandler(),把配置决定权完全交给主应用。
在循环次数达数万次的
for 循环体内部直接打印 INFO 级别日志,会导致磁盘 I/O 瞬间飙升甚至造成应用卡顿。循环内应只打 DEBUG 级别,或每隔固定步长(如每 1000 次)输出一条进度汇总。
很多 Python 异常的
str(e) 仅仅是一个数字或空字符串(如某些系统底层错误或键缺失 KeyError),丢失了堆栈的日志几乎等同于无用信息。
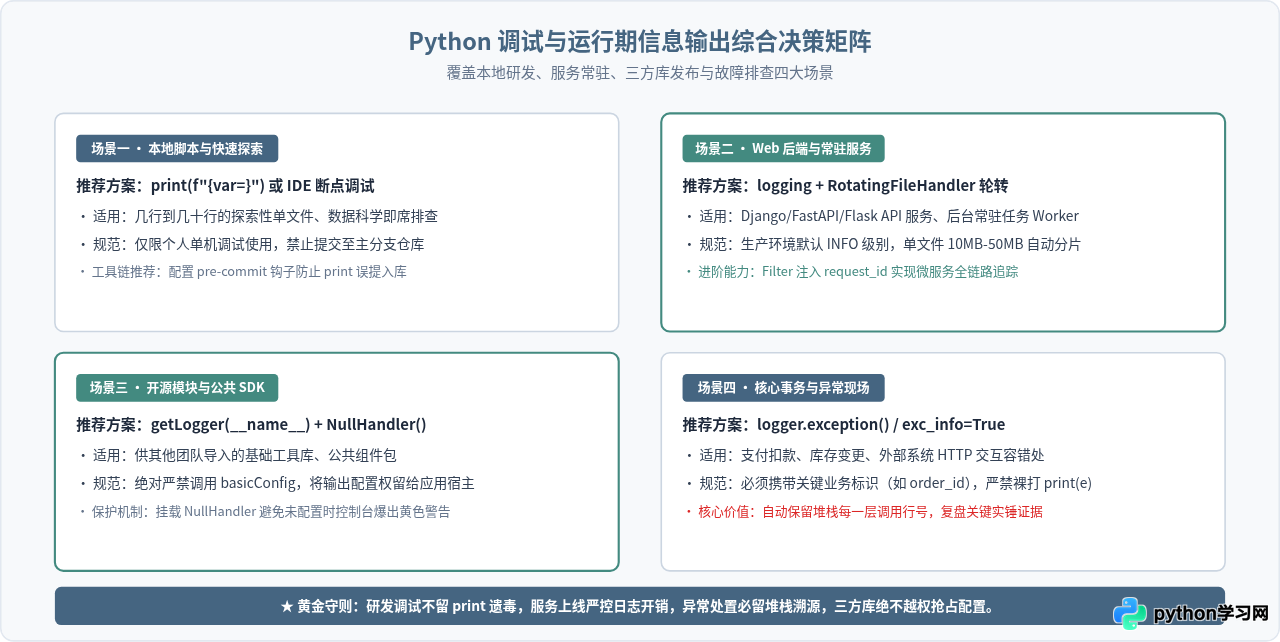
六、总结速查
在 Python 编程实践中,选择 print 还是 logging 并非非黑即白的对立,而是开发阶段与生产部署之间的自然过渡:
- 本地交互调试:充分利用 Python 3.8+ 引入的
print(f"{x=}")语法糖或断点调试器,快速验证算法片段,但在代码合并前养成彻底清理调试打印的良好习惯。 - 工程代码编写:从第一行开始引入
logger = logging.getLogger(__name__),规范使用logger.debug、logger.info和logger.warning进行信息分流。 - 生产稳定保障:配置
RotatingFileHandler避免磁盘被填满,利用logger.exception保全异常现场,让日志成为系统可观测性与快速排障的坚实后盾。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















