


Python中该用列表还是字典?根据数据特征做出正确选择
面对复杂数据时,Python新手常在列表(list)与字典(dict)之间犹豫。本文从底层存储原理、查询模式、数据关系与时间复杂度四个数据特征维度深入剖析,并提供实战场景对比与决策全景指南。
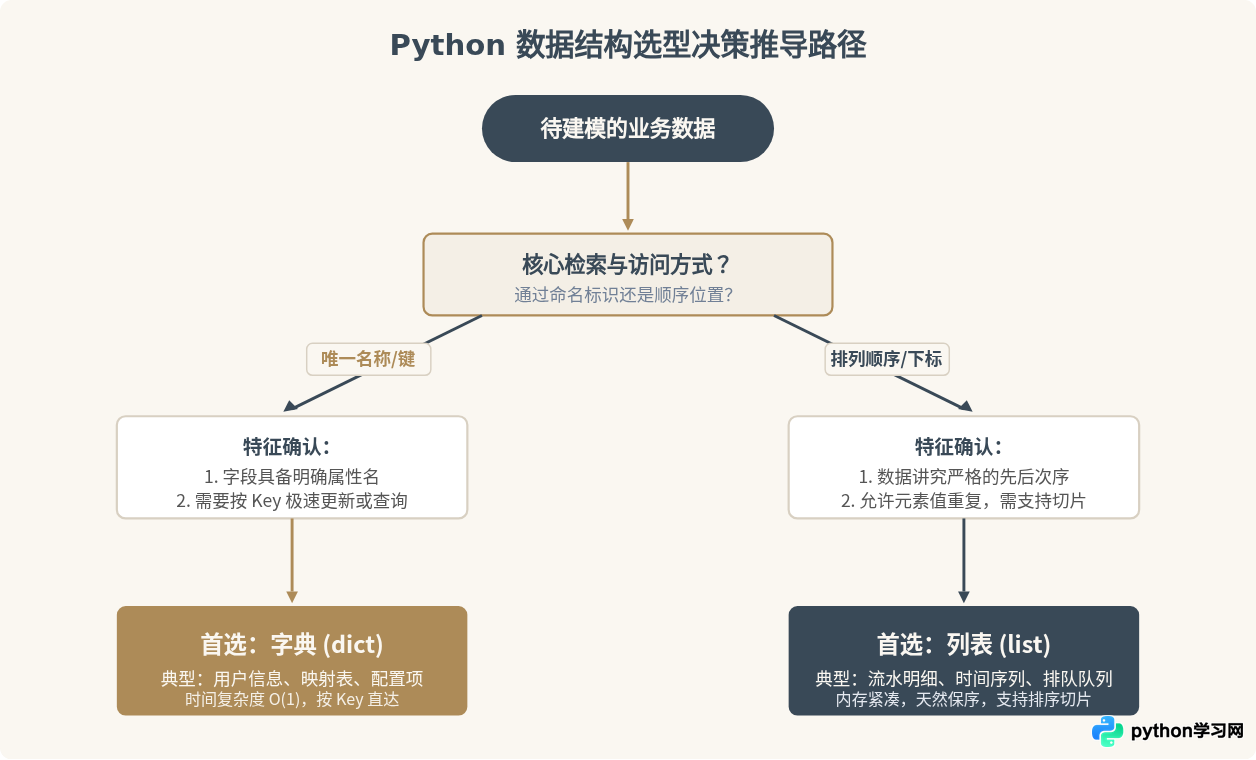
list)还是字典(dict),完全取决于数据的固有特征与核心访问方式。当你需要保证元素先后顺序、依赖物理位置(索引)访问,或者存在同类型可重复元素时,列表是标准选择;而当你需要通过唯一命名标识(键)直接定位内容、建立多对一属性映射,或者进行极其频繁的高速检索时,字典则是无可替代的解决方案。
一、底层存储原理:连续内存数组 vs 哈希映射表
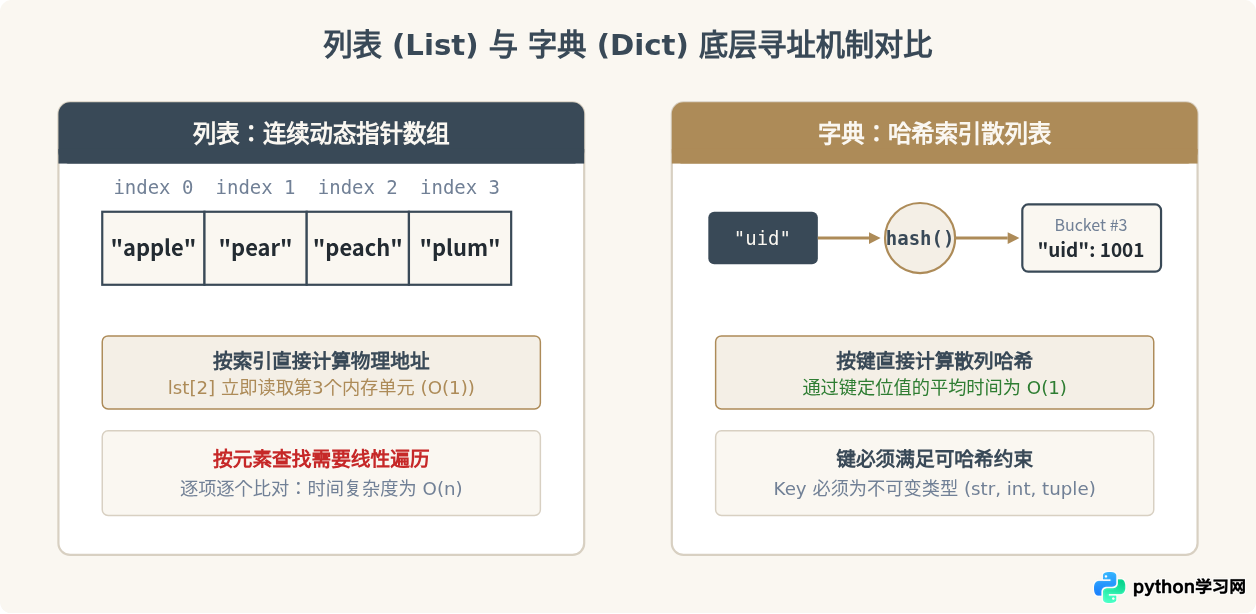
要想在编码时做出准确的技术决策,必须首先看清两者在内存中的组织形式。Python 中的列表本质上是一个动态指针数组。它在内存中申请一片连续的地址空间,按升序紧凑地存放指向对象的内存引用。因为物理地址连续,Python 能够根据索引下标 i 以公式直接跳转到目标单元,这使基于位置的访问耗时固定。但如果要在列表中搜索某个具体元素,解释器只能从头到尾挨个比对,直到找到为止。
与此相对,Python 的字典底层采用高度优化的散列表(Hash Table)。字典中存储的每一对数据都由 Key 和 Value 构成。当你请求某个键时,解释器先对该键计算哈希值(Hash),经由哈希散列映射直接定位到底层哈希桶。无论字典内存储了一百条还是一千万条数据,只要不发生严重的哈希冲突,其寻址定位的速度几乎完全一致。
二、基于数据特征做出选择的四大维度
在实际项目开发中,选择容器不能凭空猜测,应当检视待处理数据的四个基本属性:
1. 标识模式:是按自然序号访问,还是按业务语义访问?
如果数据的每一项没有独立的名字,其含义完全由排列前后的顺序赋予(例如班级成绩排名、流水线处理步骤),使用列表是最自然的。读者可以通过 ranking[0] 拿到冠军,通过 pipeline[1] 取得第二道工序。
如果数据本身具备明确的业务属性或唯一编号(例如学生的学号、商品的 SKU、用户的配置参数),则必须使用字典。通过 user_profile["email"] 读取邮箱,比用 user_data[3] 清晰得多,也绝不会因为前面插入了新字段而导致索引偏移错乱。
2. 关系维度:是同质序列,还是复合属性映射?
列表适合同质数据(Homogeneous Collection):即集合里的所有元素在业务概念上是平等的。例如一组待处理的 IP 字符串、一组采集的温度数值。它们拥有相同的类型和处理逻辑。
字典适合异质映射(Heterogeneous Mapping):即把不同的属性聚合在同一个逻辑对象中。例如一个订单对象包含 order_id(字符串)、amount(浮点数)、status(状态码)。字典以键为锚点,明确表达了键与值之间的“从属/属性关系”。
3. 唯一性要求:是否允许重复值?
列表对内容没有唯一性约束,允许放入多个完全相同的对象(例如投掷骰子记录的连续点数 [3, 5, 3, 6, 3])。而字典的键(Key)具有天然唯一性,在一个字典内,同名键只可能存在一个;对已有键再次赋值会直接覆盖旧值。如果你需要按唯一标识建立无重复的索引表,字典是必选。
4. 变动频次与模式:是两端进出,还是按需随机修改?
如果在业务运行过程中,数据经常需要在尾部追加(append)或依次弹出(pop),列表具备极佳的栈和队列操作效率。但如果在运行中需要随时根据某个名字更新状态(例如根据设备 ID 刷新设备心跳时间),字典直接赋值 devices[device_id] = now 可以在常数时间内完成,而列表必须先遍历找到该项再替换。
三、核心操作性能与时间复杂度对比
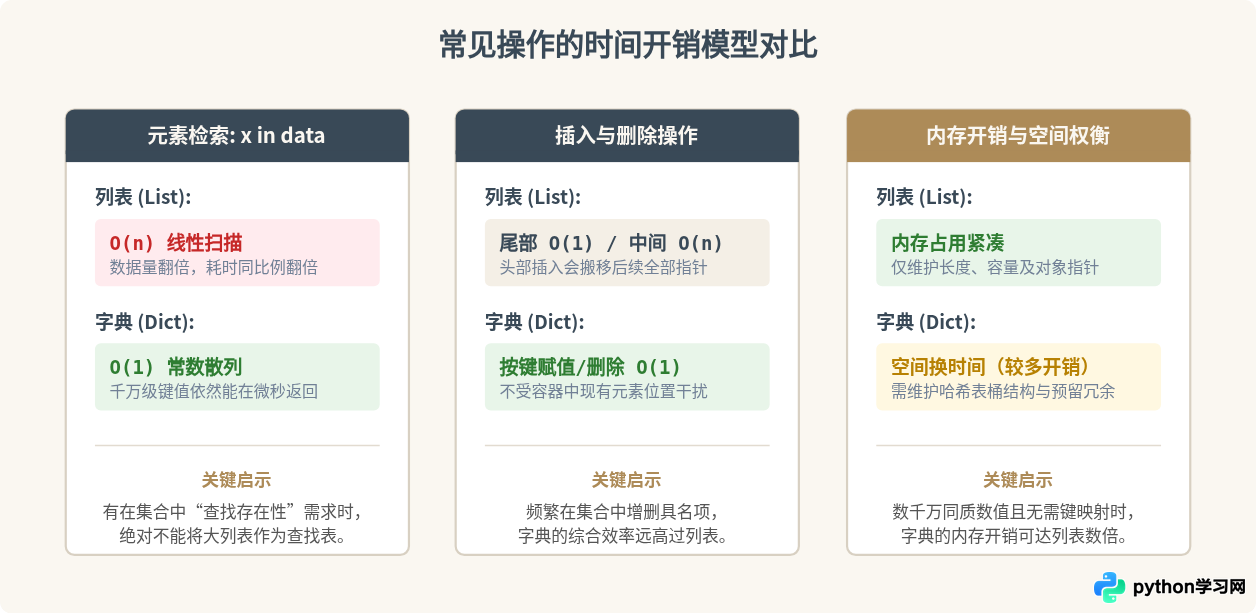
为了更直观地体现选型对程序性能的影响,我们对比两类容器在日常高频操作中的理论时间复杂度:
| 操作分类 | 列表 (list) 语法与复杂度 | 字典 (dict) 语法与复杂度 | 选型性能建议 |
|---|---|---|---|
| 成员判定 (in) | item in lst O(n) |
key in d O(1) |
高频搜索务必使用字典或集合 |
| 随机/命名访问 | lst[index] O(1) |
d[key] O(1) |
均具备常数寻址能力,但语义完全不同 |
| 末尾追加 / 增添键值 | lst.append(x) O(1)* |
d[k] = v O(1)* |
两者在常规扩容下均表现极佳 |
| 任意位置插入 | lst.insert(i, x) O(n) |
d[k] = v O(1) |
列表中间插入会导致后续元素全部后移 |
| 删除目标元素 | lst.remove(x) O(n) |
del d[k] O(1) |
列表需先查后移,字典哈希定位秒删 |
代码实例:直观感受百万级查找的差距
以下代码演示在拥有 100,000 个元素的集合中,判断一个不存在的元素是否存在:
import time

# 准备同等规模的数据
elements_count = 100000
data_list = list(range(elements_count))
data_dict = {i: True for i in range(elements_count)}

target = -1  # 不存在的元素

# 测试列表的成员检索耗时
t0 = time.perf_counter()
for _ in range(100):
    _ = target in data_list
t_list = time.perf_counter() - t0

# 测试字典的成员检索耗时
t0 = time.perf_counter()
for _ in range(100):
    _ = target in data_dict
t_dict = time.perf_counter() - t0

print(f"列表 100 次检查总耗时: {t_list:.5f} 秒")
print(f"字典 100 次检查总耗时: {t_dict:.5f} 秒")
典型运行结果(示例):
列表 100 次检查总耗时: 0.14231 秒
字典 100 次检查总耗时: 0.00001 秒
在 10 万级数据下,字典的查找速度就能高出列表上万倍。如果你的代码里在一个大循环内部反复调用 if x in my_list:,程序就会出现明显的卡顿甚至假死。
四、经典实战场景对比
脱离业务的数据结构讨论没有意义。以下列举四个典型的真实开发场景,演示合理的建模选择:
场景 1:任务流水线与操作日志(有序序列 → 列表)
当数据代表严格的时间顺序或流程阶段时,必须使用列表:
# 任务流水线:阶段不可跳跃,保持先后执行关系
pipeline_tasks = [
    "download_source_file",
    "decompress_archive",
    "verify_sha256_checksum",
    "load_into_database",
    "send_notification_email"
]

# 按部就班执行
for step_num, task in enumerate(pipeline_tasks, start=1):
    print(f"正在执行第 {step_num} 步: {task}")
场景 2:用户信息与系统配置(具名映射 → 字典)
如果用列表来存用户信息 ["张三", 28, "admin", "Beijing"],后期维护者根本无法分辨 user[1] 到底代表年龄还是工号。此时字典是唯一清晰的选择:
# 具备明确属性名与键值映射
user_account = {
    "username": "zhangsan",
    "age": 28,
    "role": "admin",
    "city": "Beijing",
    "is_active": True
}

# 具备自解释性的读取方式
if user_account["role"] == "admin" and user_account["is_active"]:
    print(f"欢迎管理员 {user_account['username']}")
场景 3:复合结构——列表中嵌套字典(多条记录列表)
在 Web API 开发中,从数据库查询一组数据时,最经典的组合是“列表包字典”:外部用列表表示顺序集合,内部每个单元用字典表示结构化属性:
# 电商系统中的购物车商品明细
cart_items = [
    {"sku": "A101", "name": "机械键盘", "price": 399.0, "qty": 1},
    {"sku": "B205", "name": "无线鼠标", "price": 129.0, "qty": 2},
    {"sku": "C309", "name": "超大桌垫", "price": 49.0, "qty": 1}
]

# 既保留了添加顺序,又保证了字段访问的直观清晰
total_amount = sum(item["price"] * item["qty"] for item in cart_items)
print(f"购物车总价: ¥{total_amount:.2f}")
场景 4:多对一倒排索引(字典的值为列表)
当你需要按特定分类归纳多个元素时,字典的键是分类名,值则是归属该类的列表:
# 按部门组织员工名单
department_staff = {
    "研发部": ["李华", "王伟", "陈晨"],
    "市场部": ["赵敏", "钱程"],
    "财务部": ["孙丽"]
}

# 追加新入职员工(O(1) 定位部门,O(1) 追加到员工列表)
department_staff["研发部"].append("周杰")
五、三大常见误区与避坑建议
很多新手为了省去写引号键名,使用 item[0]、item[1] 代表属性。一旦系统需要增加新字段(例如在第 1 项和第 2 项中间插一个“创建时间”),整个系统所有基于下标硬编码的代码将全部崩溃。只要描述的是具名属性,就务必用字典或 dataclass。
比如有黑名单列表 blacklist = [...],在处理 10 万条日志时执行 if log.ip in blacklist:。这会导致整个程序的复杂度骤升至 \(O(M \times N)\)。正确做法是先把列表转为集合或字典:blacklist_set = set(blacklist),然后再在循环中做常数时间的快速过滤。
因为字典要求键必须是不可变对象(拥有确定的 __hash__),试图执行 d[[1, 2]] = "data" 会抛出 TypeError: unhashable type: 'list'。如果你需要用复合序列作为坐标或联合键,请将列表转换为不可变的元组(Tuple):d[(1, 2)] = "data"。
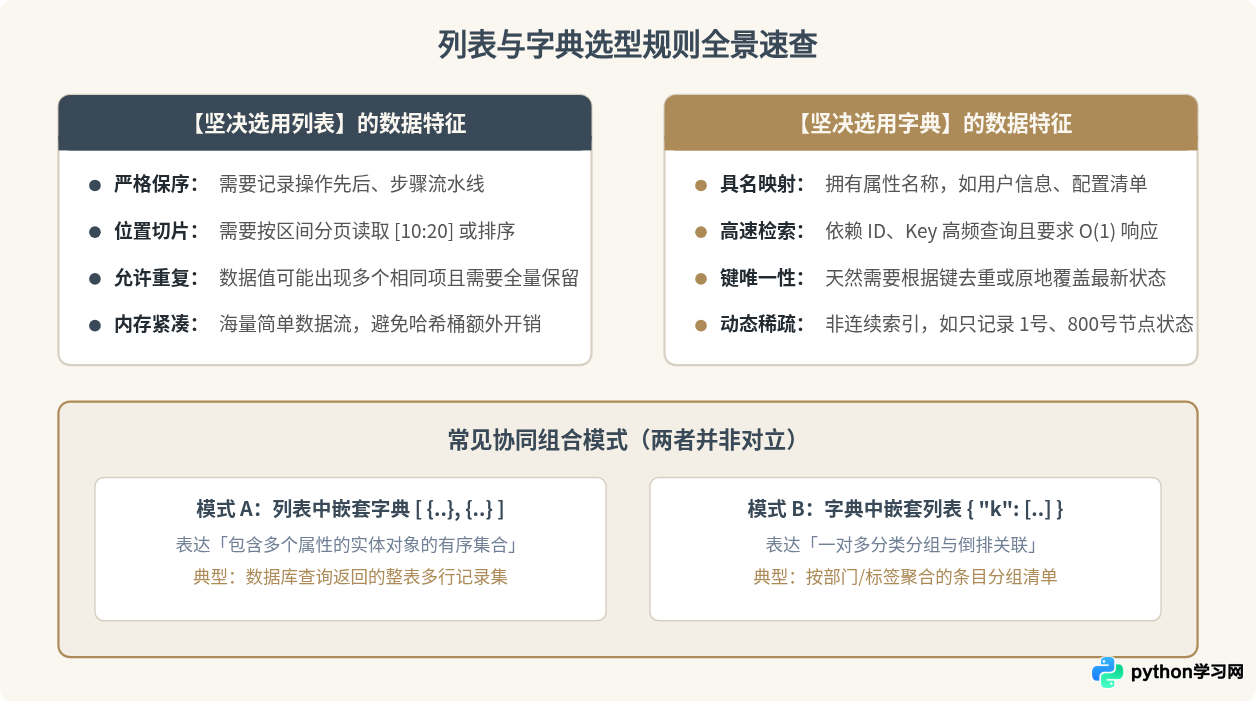
六、数据特征与选型规则速查全景
为了便于在日常编码和代码评审中快速查阅,以下全景图梳理了两者在各个维度上的选型定式:
总结:一句话选型法则
在写下 [] 还是 {} 之前,问自己两个核心问题:
- 我取数据时,心里想的是“第几个”(Index)还是“哪个名字”(Key)?想的是第几个,用列表;想的是名字,用字典。
- 后续是否有频繁判断“某元素是否在里面”的需求?如果有,绝不用大列表,立刻改用字典(或集合
set)。
理清数据语义与底层存储的映射关系,不仅能让你的 Python 代码优雅易读、边界清晰,更能让程序在高并发和大数据量场景下始终保持稳定高效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















