


Python微服务架构框架推荐:轻量级与云原生支持能力对比
深度对比评估主流Python微服务框架FastAPI、gRPC Python、Nameko与Flask/Quart,从轻量级运行时开销、云原生Kubernetes探针、优雅停机、可观测性及协议治理等维度提供选型建议与落地指南。
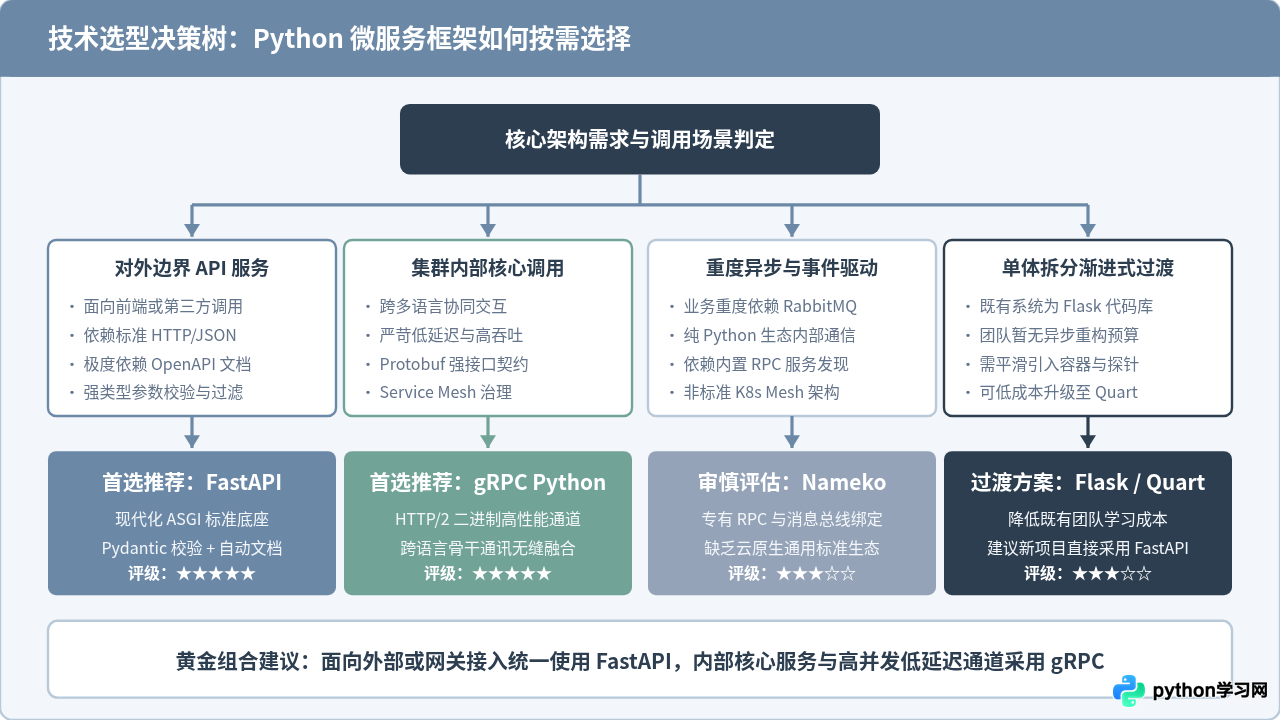
构建微服务架构时,框架的选型直接决定了系统的吞吐上限、硬件资源开销以及与容器编排底座的协作效率。在 Python 生态中,评估微服务框架的核心标准已经从单纯的“接口编写便捷度”演进为“运行时轻量化程度”与“云原生基础设施适配能力”的双重考核。本文直接给出工业级选型结论:面向外部通信与通用业务接口,首选天然集成 OpenAPI 与异步 ASGI 底座的 FastAPI;面向内部高性能 RPC 骨干与低延迟服务间调用,首选基于 HTTP/2 二进制序列化的 gRPC Python;对于既有 Flask 资产,建议通过 Quart 进行低成本平滑迁移;而重度依赖 AMQP 的 Nameko 则需审慎评估其与现代 Kubernetes 异步生态的隔阂。以下从框架特性、能力矩阵、云原生落地实操及避坑指南展开详细解析。
一、核心选型结论与服务拓扑模型
现代云原生环境(以 Kubernetes、Envoy 与 Istio 为代表)要求微服务具备轻量冷启动、严苛资源边界限制、确定性探针响应以及端到端分布式链路透传能力。单体架构下常见的长驻内存、同步阻塞与全局解释器锁(GIL)竞争,在容器按需自动扩缩容(HPA)场景下会被显著放大。
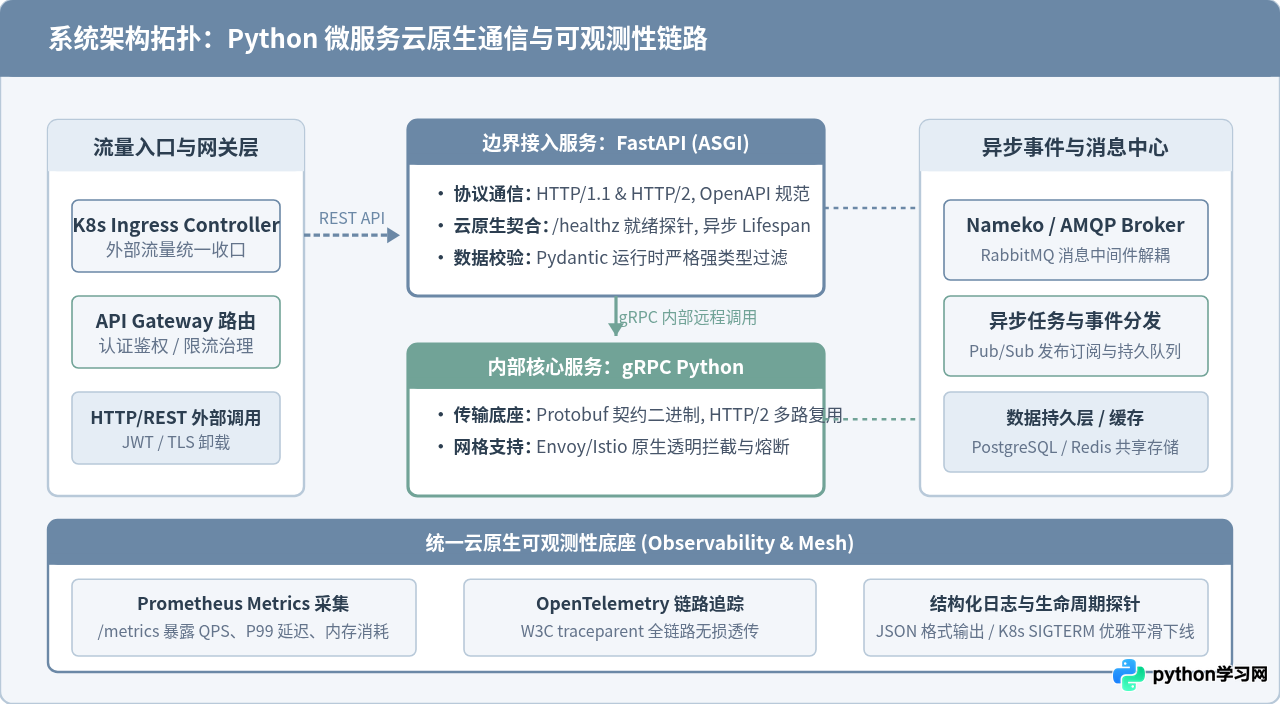
合理的 Python 微服务拓扑通常采用“边界网关 + 内部高性能通道”的分层模式。外部流量经由 Ingress 或 API 网关统一路由至面向业务编排的 FastAPI 服务节点,后者完成参数强校验与聚合;节点之间的大规模内部调用则直接通过 gRPC 二进制流承载,并统一挂载 Prometheus 指标与 OpenTelemetry 追踪中间件。
二、主流推荐框架核心特性解析
1. FastAPI:现代异步强类型微服务的基准首选
FastAPI 基于 Starlette(ASGI 异步核心)与 Pydantic(数据校验引擎),是目前 Python 微服务生态中活跃度最高且与云原生技术栈结合最紧密的框架。其轻量级特性体现在无庞大 ORM 捆绑、启动瞬时完成以及纯粹的声明式路由。
在云原生支持方面,FastAPI 具备三项核心优势:
- 原生支持异步生命周期(Lifespan Context):能够精准捕获容器退出时的
SIGTERM信号,完成正在处理请求的排空与数据库连接池注销。 - 开箱即用的自动化接口契约(OpenAPI / JSON Schema):与外部 API 网关(如 Kong、Apisix)的动态路由与 Schema 验证可实现零成本对接。
- 高度契合异步 I/O 运行时(uvicorn + uvloop):高并发 I/O 密集型场景下吞吐量极佳,单实例内存基线通常在 30MB~45MB 之间。
import asyncio
from contextlib import asynccontextmanager
from fastapi import FastAPI, status, Response
from pydantic import BaseModel, Field

# 全局就绪状态标识(用于应对优雅停机过渡期)
is_ready = False

@asynccontextmanager
async def lifespan(app: FastAPI):
    global is_ready
    # 启动阶段:初始化异步连接池、加载模型或建立缓存链接
    await asyncio.sleep(0.1)
    is_ready = True
    print("{\"level\": \"INFO\", \"event\": \"ServiceInitialized\"}")
    yield
    # 关闭阶段:Kubernetes 收到 SIGTERM 触发优雅退出
    is_ready = False
    print("{\"level\": \"INFO\", \"event\": \"GracefulShutdownStarted\"}")
    # 释放数据库链接池,等待正在进行的请求处理完毕
    await asyncio.sleep(0.5)
    print("{\"level\": \"INFO\", \"event\": \"ServiceStopped\"}")

app = FastAPI(title="UserMicroservice", version="1.0.0", lifespan=lifespan)

class UserProfileRequest(BaseModel):
    user_id: int = Field(..., gt=0, description="用户唯一数字标识")
    tenant_code: str = Field(..., min_length=2, max_length=16, description="租户编码")

@app.get("/healthz", status_code=status.HTTP_200_OK, tags=["Probes"])
async def liveness_probe():
    """存活探针:判断进程是否存活,失败则触发容器重启"""
    return {"status": "alive"}

@app.get("/ready", tags=["Probes"])
async def readiness_probe(response: Response):
    """就绪探针:判断服务是否可接客,失败则从 K8s Endpoints 摘除流量"""
    if not is_ready:
        response.status_code = status.HTTP_503_SERVICE_UNAVAILABLE
        return {"status": "not_ready"}
    return {"status": "ready"}

@app.post("/api/v1/users/profile", status_code=status.HTTP_200_OK)
async def query_user_profile(payload: UserProfileRequest):
    return {
        "code": 0,
        "message": "success",
        "data": {
            "user_id": payload.user_id,
            "tenant": payload.tenant_code,
            "status": "active"
        }
    }
2. gRPC Python:跨语言低延迟通信的性能中枢
当微服务规模超过数十个,服务间高频的“东西向流量”(East-West Traffic)若仍全部采用 HTTP/1.1 与 JSON 文本序列化,将产生大量的 CPU 序列化损耗与网络带宽占用。gRPC 基于 Google Protocol Buffers(Protobuf)与 HTTP/2 多路复用传输,在性能、网络利用率及契约强约束上具备天然优势。
云原生环境对 gRPC 的支持已非常成熟:Kubernetes 1.24+ 原生支持 grpc 协议探针;Envoy 等 Service Mesh 数据面代理原生解析 gRPC 帧,可实现细粒度的 RPC 级别熔断、超时重试与流量切分。
syntax = "proto3";

package order.v1;

service OrderService {
  rpc GetOrderDetail (OrderRequest) returns (OrderResponse);
}

message OrderRequest {
  int64 order_id = 1;
}

message OrderResponse {
  int64 order_id = 1;
  string status = 2;
  double amount = 3;
}import time
from concurrent import futures
import grpc
from grpc_health.v1 import health, health_pb2, health_pb2_grpc
# 导入根据 proto 编译生成的代码桩
# import order_pb2, order_pb2_grpc
class OrderServiceImpl:
def GetOrderDetail(self, request, context):
return {
"order_id": request.order_id,
"status": "PAID",
"amount": 199.50
}
def serve():
server = grpc.server(futures.ThreadPoolExecutor(max_workers=10))
# 注册标准 gRPC 健康检查服务,供 Kubernetes grpc 探针探测
health_servicer = health.HealthServicer()
health_pb2_grpc.add_HealthServicer_to_server(health_servicer, server)
health_servicer.set("", health_pb2.HealthCheckResponse.SERVING)
server.add_insecure_port("[::]:50051")
server.start()
print("{\"level\":\"INFO\",\"message\":\"gRPC Server listening on 50051\"}")
try:
server.wait_for_termination()
except KeyboardInterrupt:
# 接收到中断信号后停止接收新 RPC,留出 5 秒处理在途请求
server.stop(grace=5.0)
if __name__ == "__main__":
serve()3. Nameko:专注 RPC 与事件总线的传统框架
Nameko 是一套历史较长且内置 RPC 与事件驱动(基于 RabbitMQ/AMQP)的 Python 微服务框架。它的核心设计理念是通过依赖注入(Dependency Provider)解耦基础设施与业务逻辑,服务间无需知道对方的 IP,统一通过消息队列交换机路由。
局限性分析:虽然 Nameko 让初学者在不依赖服务发现组件(如 Consul/Eureka)的情况下快速实现 RPC,但其架构底座采用了基于 eventlet 的协程机制,与目前主流的 Python asyncio 标准异步生态存在严重兼容冲突。此外,在以 Kubernetes 服务发现(CoreDNS)和 Service Mesh 统一纳管东西向流量的现代架构中,Nameko 绕开透明代理、自成一体的 AMQP 通信模型增加了运维复杂度与监控盲区,因此在现代化云原生体系中不作为第一推荐。
4. Flask / Quart:极简渐进式迁移方案
Flask 凭借极致的灵活性拥有庞大的存量代码资产。但在云原生微服务场景下,经典的 Flask 依赖 WSGI 同步阻塞模型,面对高并发 I/O 往往需要堆叠更多的 Gunicorn Worker 进程,导致容器内存膨胀严重。
若团队已有大量 Flask 工具函数和代码结构,直接重构为 FastAPI 成本过高,Quart 是最佳的折中选项。Quart 完全遵循 Flask 1.0+ 的 API 规范,但底层基于 ASGI 异步架构重构,支持在保留现有路由书写习惯的同时,无缝获得 async/await 原生非阻塞能力与更低的内存开销。
三、轻量级与云原生能力全景深度对比
衡量微服务框架不能仅凭语法喜好,必须通过明确的指标维度进行客观量化。我们在相同的容器基线环境(Alpine/Debian-slim,Python 3.11,4 核 8GB 资源限额)下,对上述框架的核心技术参数与云原生生态契合度进行对比评估。
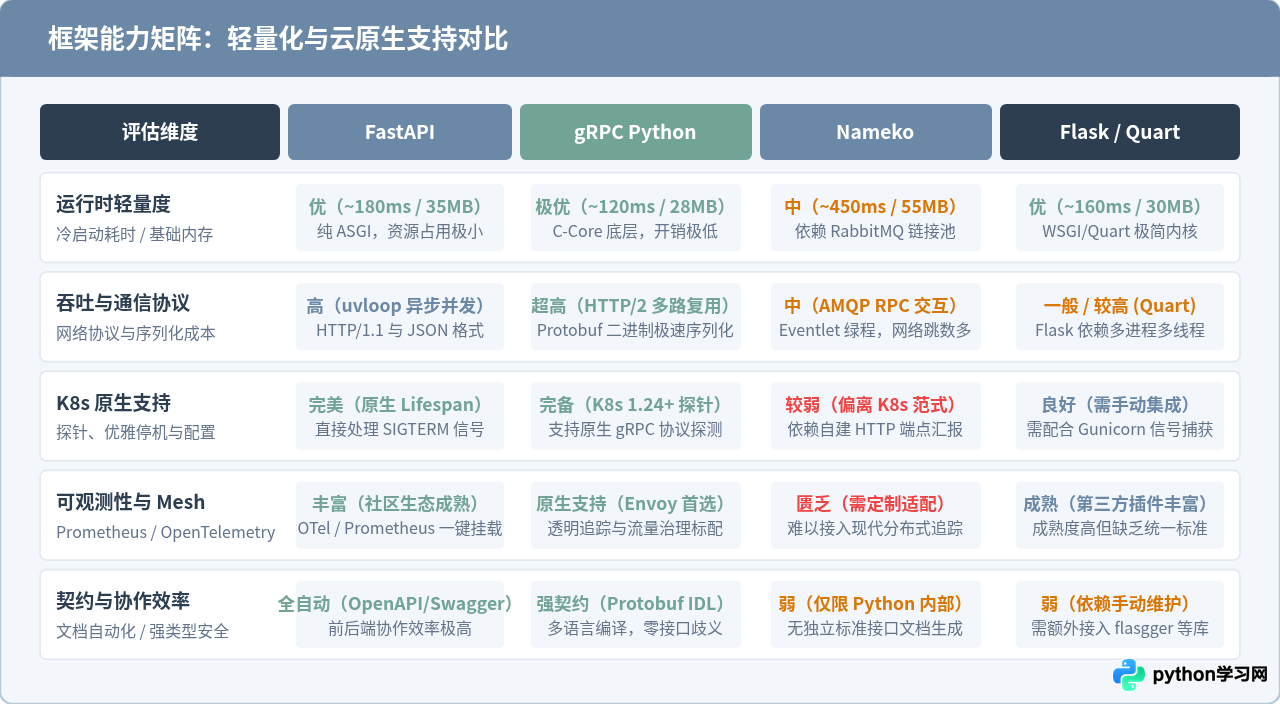
从架构演进的角度来看,轻量级特性与云原生能力呈现强相关性:
- 冷启动时间决定了弹性收缩能力:FastAPI 与 gRPC Python 的进程初始化时间均在 200ms 以内,在流量洪峰触发 HPA 扩容时,可在 1~2 秒内配合轻量容器完成流量承接,避免级联超时。
- 强类型接口契约降低了跨团队协作摩擦:FastAPI 依靠 Python 3.10+ 原生类型注解自动生成 OpenAPI 文档,gRPC 依靠 Protobuf IDL 生成跨语言代码,杜绝了“接口入参改动而文档未更新”导致的微服务线上故障。
- 标准可观测性接口是容器化排障的基础:通过遵循 W3C TraceContext 标准透传
traceparent,调用链无论经过 Python 服务、Go 网关还是 Java 订单中台,均能在 Jaeger/Tempo 中形成完整拓扑。
四、Python 微服务接入云原生的 4 个标准实操步骤
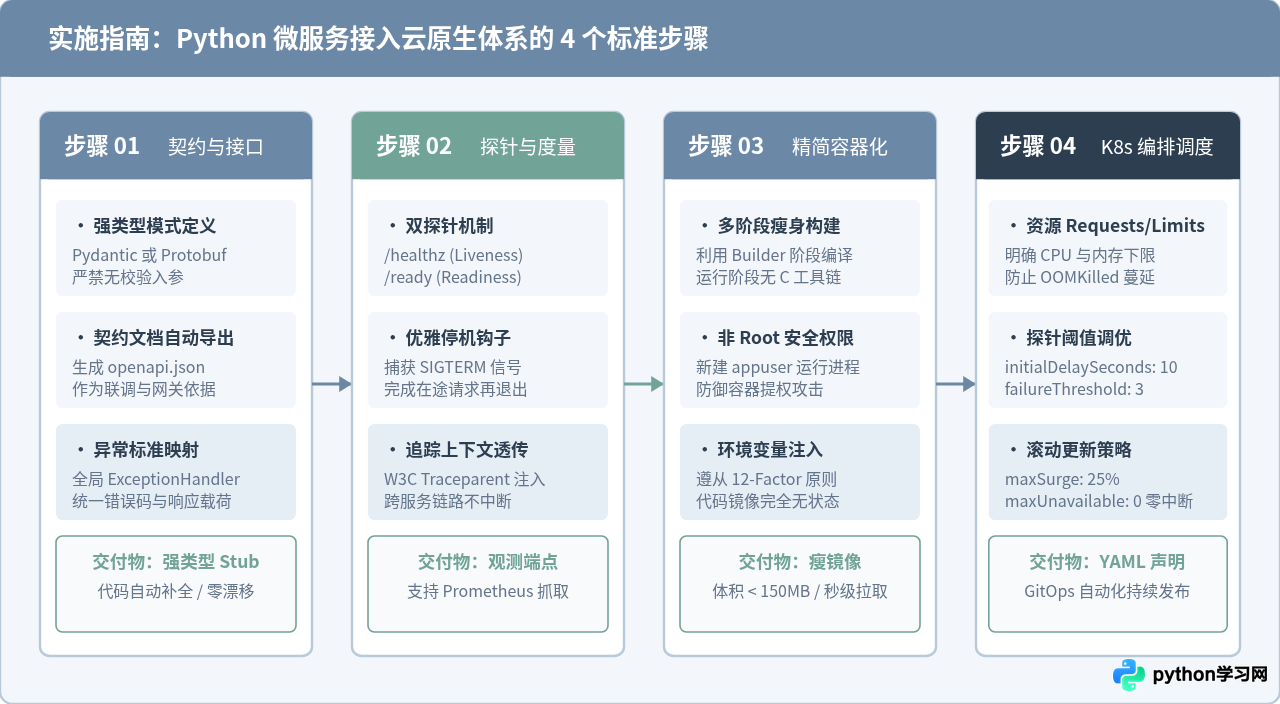
将一个本地编写的 Python 应用转化为合规的云原生微服务,需要经历标准化接口设计、双探针与优雅停机、精简容器镜像构建以及 Kubernetes 声明式资源编排四个步骤。
步骤 1:规范化生命周期与结构化监控指标
服务在启动和终止时必须具有可预测的行为。FastAPI 支持通过异步上下文管理器精确控制组件生命周期。同时,利用 prometheus-fastapi-instrumentator 可以一行代码将系统的 QPS、P95/P99 响应耗时与异常统计自动暴露在 /metrics 端点。
from fastapi import FastAPI
from prometheus_fastapi_instrumentator import Instrumentator

def init_observability(app: FastAPI):
    # 自动注册 HTTP 请求耗时直方图、请求计数器
    instrumentator = Instrumentator(
        should_group_status_codes=False,
        should_ignore_untemplated=True,
        excluded_handlers=["/metrics", "/healthz", "/ready"]
    )
    instrumentator.instrument(app).expose(app, endpoint="/metrics")
步骤 2:分布式追踪上下文无损透传(TraceContext)
微服务调用拓扑错综复杂,必须保证每次调用的唯一追踪 ID(Trace ID)能跨语言穿透所有服务。Python 服务在向其他微服务发起下游 HTTP 或 RPC 请求时,必须主动读取当前请求头中的 traceparent 并注入下游调用中。
import httpx
from fastapi import Request

async def call_downstream_service(request: Request, url: str):
    # 提取上游注入的 W3C TraceContext
    incoming_traceparent = request.headers.get("traceparent", "")
    headers = {}
    if incoming_traceparent:
        headers["traceparent"] = incoming_traceparent

    async with httpx.AsyncClient(timeout=3.0) as client:
        response = await client.get(url, headers=headers)
        return response.json()
步骤 3:多阶段精简容器构建(Dockerfile)
传统的 Python 镜像经常直接使用包含构建依赖的完整镜像,不仅体积超过 1GB,还留下了 gcc、make 等潜在攻击面。采用多阶段构建,在构建镜像中完成 wheel 包编译,在运行镜像中仅拷贝安装成果,能够将镜像体积压缩至 120MB 以内,并以非 Root 用户运行。
# 第一阶段:编译构建阶段
FROM python:3.11-slim AS builder

WORKDIR /build
RUN apt-get update && apt-get install -y --no-install-recommends gcc python3-dev && rm -rf /var/lib/apt/lists/*
COPY requirements.txt .
RUN pip install --no-cache-dir --user -r requirements.txt

# 第二阶段:最终生产运行镜像
FROM python:3.11-slim AS runner

WORKDIR /app
# 创建非特权运行用户
RUN useradd -u 10001 -m -s /bin/bash appuser

# 从构建器中仅复制安装好的 Python 依赖库
COPY --from=builder /root/.local /home/appuser/.local
COPY --chown=appuser:appuser . /app

ENV PATH=/home/appuser/.local/bin:$PATH \
    PYTHONUNBUFFERED=1 \
    PYTHONDONTWRITEBYTECODE=1

USER appuser
EXPOSE 8000

# 启动 uvicorn,指定 lifespan 为 on,使用单个进程由 K8s Pod 副本管理扩缩
CMD ["uvicorn", "app_fastapi:app", "--host", "0.0.0.0", "--port", "8000", "--lifespan", "on"]
步骤 4:Kubernetes Deployment 与探针编排定义
在编写 Kubernetes 资源配置文件时,存活探针(livenessProbe)、就绪探针(readinessProbe)与启动探针(startupProbe)需要精细区分。特别是 terminationGracePeriodSeconds 应当设置为 30~60 秒,确保应用有充足的时间完成正在执行的长事务。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: user-microservice
  labels:
    app: user-microservice
spec:
  replicas: 3
  selector:
    matchLabels:
      app: user-microservice
  template:
    metadata:
      labels:
        app: user-microservice
    spec:
      terminationGracePeriodSeconds: 30
      containers:
      - name: microservice
        image: registry.example.com/services/user-microservice:v1.0.0
        imagePullPolicy: IfNotPresent
        ports:
        - containerPort: 8000
          name: http
        resources:
          requests:
            cpu: "200m"
            memory: "128Mi"
          limits:
            cpu: "1000m"
            memory: "512Mi"
        # 启动探针:允许初始化最长耗费 30 秒,期间不触发存活探针误杀
        startupProbe:
          httpGet:
            path: /healthz
            port: 8000
          failureThreshold: 6
          periodSeconds: 5
        # 存活探针:一旦判定失败重启 Pod
        livenessProbe:
          httpGet:
            path: /healthz
            port: 8000
          initialDelaySeconds: 5
          periodSeconds: 10
        # 就绪探针:失败时只切除流量,不重启 Pod
        readinessProbe:
          httpGet:
            path: /ready
            port: 8000
          initialDelaySeconds: 5
          periodSeconds: 5
五、架构避坑指南与选型决策树
- 切勿在异步路由中调用阻塞同步库:在 FastAPI 的
async def路由中直接调用requests.get()或time.sleep()会直接霸占主事件循环,导致单节点并发暴跌至个位数;纯同步操作应声明为普通def(由框架分发至线程池),或全面改用httpx.AsyncClient与asyncio.sleep()。 - 避免容器内启动过多 Worker 进程:在 Kubernetes 编排模型中,通常推荐“单个 Pod 运行单进程(或双 Worker)”,通过扩展 Pod 副本数实现横向伸缩。若在单 Pod 内配置过大的
workers=8,容易在流量激增时突破容器的cgroup内存配额,导致整 Pod 被 OOMKilled 终止。 - 统一日志输出为标准输出的单行 JSON:禁止将日志写入容器内部的虚拟磁盘文件,必须通过标准输出(stdout)打印单行 JSON,由 DaemonSet 模式运行的 Fluentbit / Vector 集中收集,防止日志打满只读层磁盘。
综上所述,Python 微服务架构的选型并非单一框架的“一刀切”,而是基于业务分层与协议属性的精细化组合:边界交互与业务逻辑层首选 FastAPI,利用其现代 ASGI 异步底座与 Pydantic 强类型体系最大化开发效率;内部核心链路与多语言通信层采用 gRPC Python,利用 HTTP/2 与 Protobuf 压榨极限传输性能;同时辅以标准的存活/就绪双探针、结构化链路透传与瘦身容器化构建,方能构建出真正轻量、弹性且高度可观测的云原生微服务体系。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















