


为什么列表不能直接使用Python集合运算符?
深入解析Python中列表为什么不能直接使用交集、并集、差集等集合运算符,剖析列表与集合在底层机制、顺序性与唯一性上的本质冲突,并给出保留顺序、去重及多重集运算的实用解决方案。
在Python中,如果你尝试对两个列表直接使用交集(&)、并集(|)、差集(-)或对称差集(^)运算符,Python解释器会立即中断并抛出 TypeError: unsupported operand type(s) for &: 'list' and 'list'。这并不是Python语言未完工的遗留缺陷,而是基于数据结构定义、运算语义一致性以及执行效率所做出的深思熟虑的严格设计。
一、直观报错现象与底层机制
我们先来看一段最常见的错误尝试代码。许多初学者希望求出两个列表的公共项,可能会写出如下语句:
list_a = [1, 2, 3, 4]
list_b = [3, 4, 5, 6]

# 尝试直接使用位与运算符(集合交集)
result = list_a & list_b
运行上述代码后,终端中会直接出现如下类型错误异常:
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: unsupported operand type(s) for &: 'list' and 'list'
在Python的魔法方法(Special Methods)体系中,符号 & 映射到底层实例方法 __and__,| 映射到 __or__,- 映射到 __sub__。Python内置的 set(集合)类型完整实现了这些方法,因而支持优雅的数学符号运算;而 list(列表)的类型定义中并没有重载这些操作符。这背后的核心根源在于:列表与集合遵循着截然不同的核心设计契约。
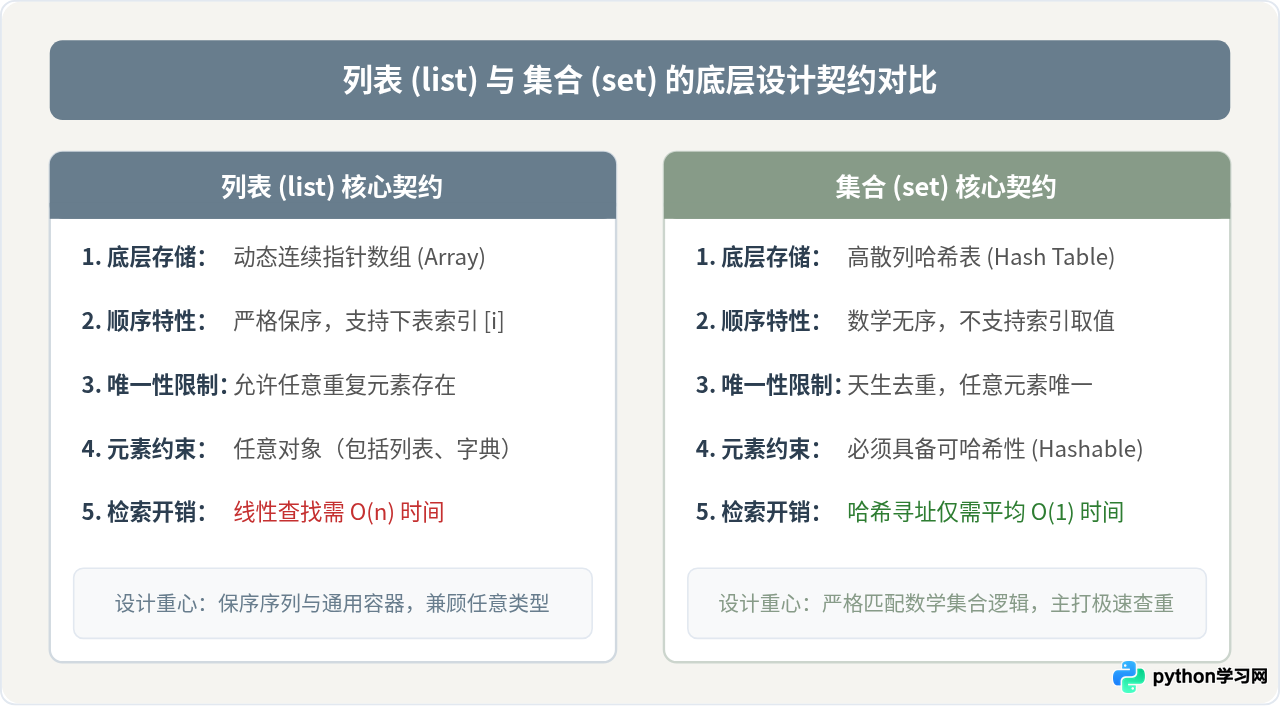
二、禁止直接运算背后的四大设计冲突
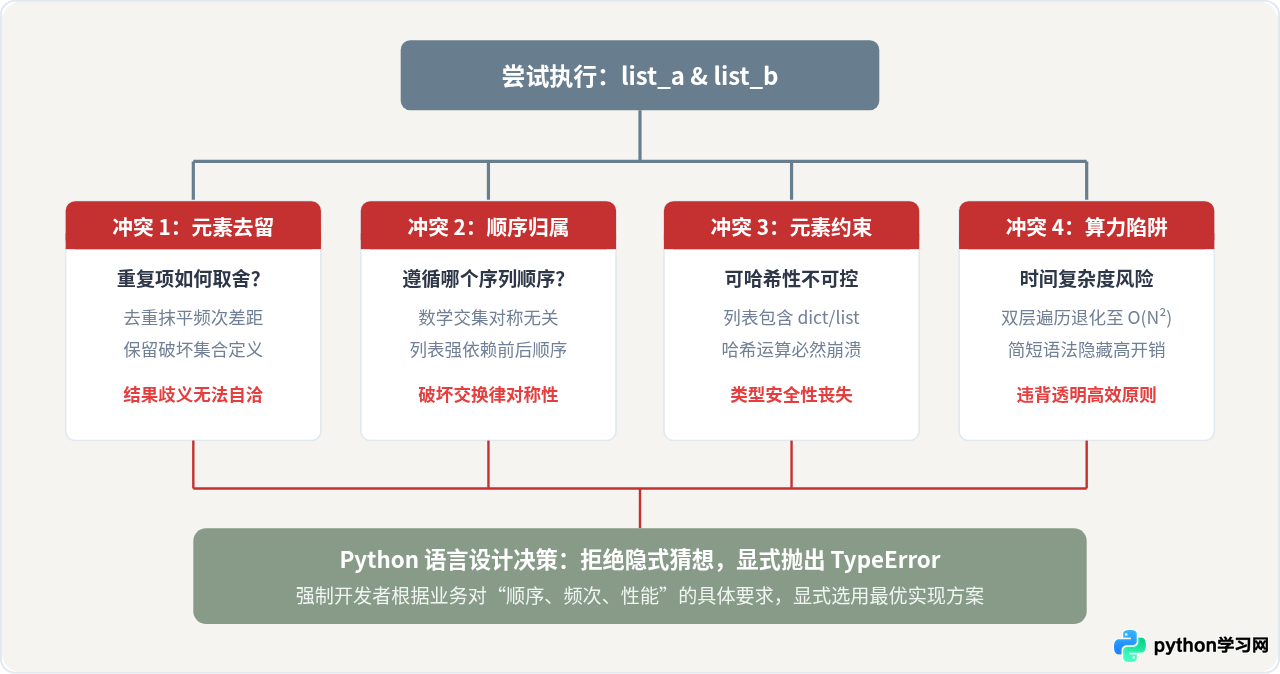
如果Python在语法层面对列表强行重载 & 或 | 等符号,表面上似乎省去了一次转换,但实际上会引发语言设计上严重的语义崩塌。具体体现在以下四个不可调和的矛盾之中:
1. 重复元素的歧义问题(去重 vs 保留)
集合在数学定义中是“互异性”的,即不允许存在重复元素。但列表是有序多重集(Multiset)。假设我们允许 [1, 1, 2] & [1, 2, 2],运算结果应该是几个 1 和几个 2 呢?
- 如果结果是
[1, 2]:列表作为有序容器,其内部原有的元素频次被隐式破坏,违反了列表保持原始数据的基本预期; - 如果结果是
[1, 1, 2, 2]或取频次较小值[1, 2]:在不同编程背景的开发者之间极易引发理解偏差,违背了“明确优于隐晦”的哲学。
2. 顺序保留的歧义问题(以谁为准)
列表是严格保序的序列,而集合运算在数学上满足交换律(即 A ∩ B = B ∩ A)。若对列表进行交集运算,结果中元素的相对排列顺序是以左操作数为准,还是以右操作数为准?一旦结果与操作数的书写顺序强相关,它就破坏了集合运算天然的对称律;反之,若结果无序,又违背了列表的数据结构契约。
3. 可哈希性(Hashable)约束的破裂
集合能够实现常数级时间复杂度 $O(1)$ 的快速交并计算,依赖于底层哈希表机制。这要求被计算的所有元素必须具备 __hash__ 且不可变。然而列表中经常存储不可哈希的可变对象,例如嵌套列表 [[1, 2], [3]] 或字典 [{'id': 1}]。若允许列表直接使用集合符号,此类列表在运算瞬间就会突发崩溃,导致类型系统难以自圆其说。
4. 隐式计算复杂度的性能陷阱
如果不通过哈希转换,而是用传统的双重循环匹配两个长度为 $N$ 的列表,交集运算的时间复杂度将骤增至 $O(N^2)$。若在看似简短的 list_a & list_b 背后隐藏着平方级的算力消耗,会在开发者不知情的情况下造成严重的性能灾难。
三、三类常见业务场景的正确处理方法
既然列表无法直接使用集合运算符,在实际工程中我们应当如何高效、优雅地实现交集、并集和差集需求?这取决于业务对“顺序”和“重复频次”的具体诉求:
场景 1:不需要保留顺序,也不需要保留重复项(最快、最简洁)
如果业务只关心“有哪些元素”,不在意原始顺序,直接显式转换为 set 进行运算,最后视需要转回 list 是最高效的做法。整体时间复杂度仅为 $O(N + M)$:
a = [1, 2, 3, 4, 2]
b = [3, 4, 5, 6]

# 1. 交集运算
intersection = list(set(a) & set(b))  # [3, 4]

# 2. 并集运算
union = list(set(a) | set(b))         # [1, 2, 3, 4, 5, 6]

# 3. 差集运算(存在于 a 但不存在于 b)
difference = list(set(a) - set(b))    # [1, 2]
场景 2:必须严格保留原始列表的先后顺序
在数据清洗、流水线展示等场景下,通常要求输出结果严格遵循左侧列表的相对出现次序。如果使用 set(a) & set(b) 会打乱顺序,而使用嵌套遍历 [x for x in a if x in b] 则会导致 $O(N \times M)$ 的高昂耗时。
最佳实践是:先将参照列表转为集合,再配合列表推导式或字典去重,这样既保持了顺序,又将每次查找时间压低至 $O(1)$:
a = ['apple', 'banana', 'orange', 'apple', 'pear']
b = ['orange', 'apple', 'grape']

# 构造 O(1) 查找基准
b_set = set(b)

# 保留 a 顺序的交集(若包含重复项按 a 顺序保留)
ordered_intersect = [item for item in a if item in b_set]
# 示例输出: ['apple', 'orange', 'apple']

# 若还需要顺便去除重复项,且保持首次出现的相对顺序(Python 3.7+ 字典天然保序)
unique_ordered_intersect = list(dict.fromkeys(ordered_intersect))
# 示例输出: ['apple', 'orange']
场景 3:多重集运算(需要精确保留元素出现频次)
如果列表中 1 出现了 3 次,另一个列表中出现了 2 次,要求交集结果精确保留 2 次 1(取较小值),并集保留 3 次 1(取较大值),应使用标准库中的 collections.Counter:
from collections import Counter

c1 = Counter([1, 1, 1, 2, 3])
c2 = Counter([1, 1, 2, 4])

# 多重集交集:min(c1[x], c2[x])
intersect_counter = c1 & c2
result_intersect = list(intersect_counter.elements())
# 示例输出: [1, 1, 2]

# 多重集并集:max(c1[x], c2[x])
union_counter = c1 | c2
result_union = list(union_counter.elements())
# 示例输出: [1, 1, 1, 2, 4]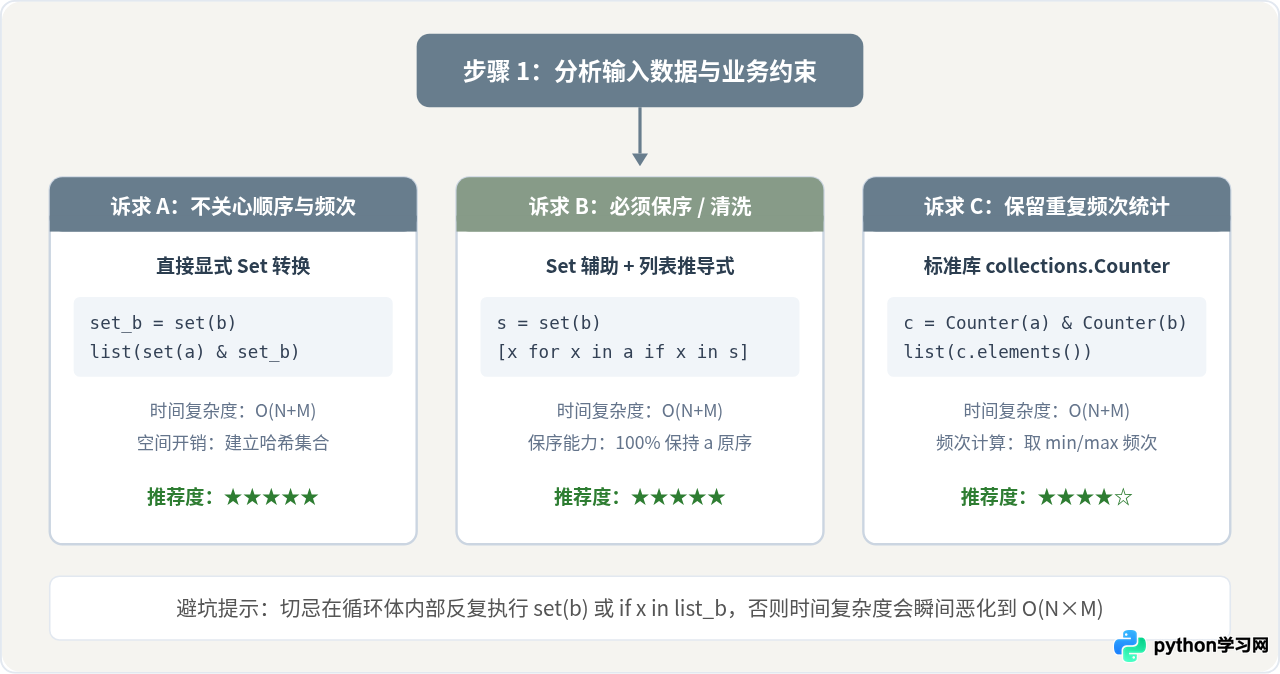
四、方案对比与关键选型建议
为了让不同方案在时间复杂度、空间消耗及功能特性上的差异更加直观,下表对各类处理方法进行了横向对比:
| 处理方式 | 典型代码表达 | 时间复杂度 | 是否保序 | 重复项处理 |
|---|---|---|---|---|
| 原生报错尝试 | list_a & list_b |
无(直接中断) | - | 直接抛出 TypeError |
| 嵌套列表推导(错误示范) | [x for x in a if x in b] |
$O(N \times M)$(低效) | 是 | 保留重复项 |
| 显式集合转换 | list(set(a) & set(b)) |
$O(N + M)$(高效) | 否(无序) | 自动去重 |
| 集合辅助 + 列表推导 | s=set(b); [x for x in a if x in s] |
$O(N + M)$(高效) | 是(依 a 的顺序) | 保留 a 中原有频次 |
| 多重集 Counter 计算 | (Counter(a) & Counter(b)).elements() |
$O(N + M)$(高效) | 否(按分组输出) | 精确保留频次下限 |
当列表中包含字典、列表等不可哈希元素时,上述依赖 set 或 Counter 的高效方法均会报错 TypeError: unhashable type。此时必须根据业务字段(如提取唯一标识 id)构建辅助集合,或者显式定义比较函数进行去重和匹配,切忌试图对不可哈希对象直接调用哈希结构。
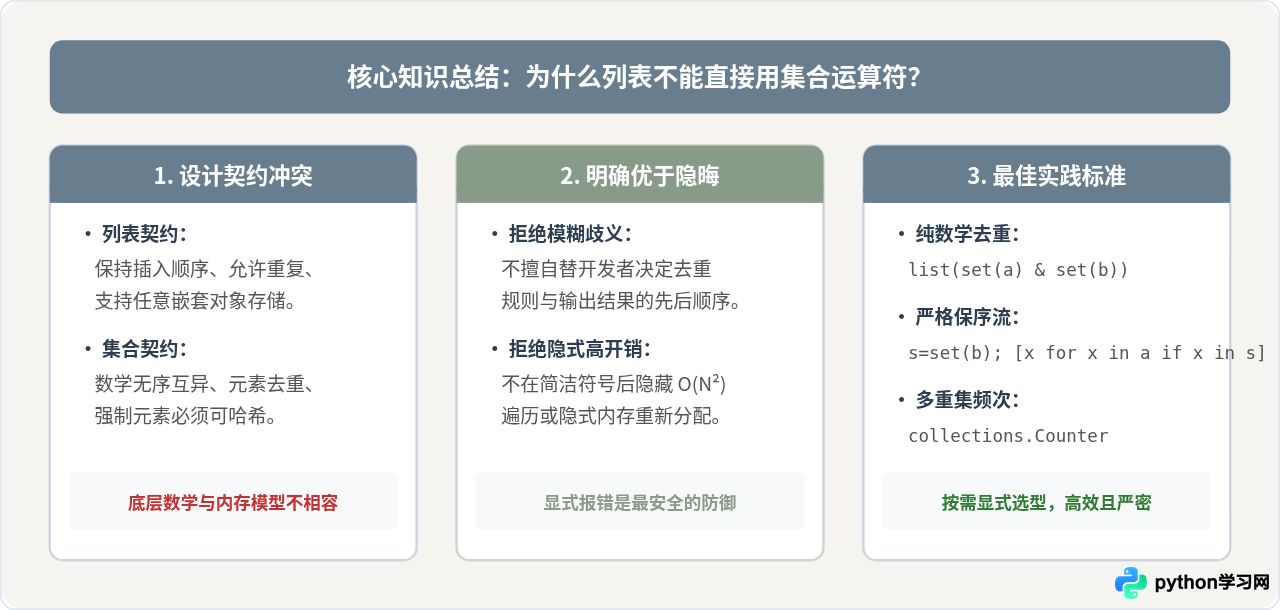
五、结语
理解“为什么列表不能直接使用Python集合运算符”,本质上是理解Python对数据结构语义纯粹性与类型契约的尊重。列表是通用的、保序的多重序列,而集合是无序的、去重的数学概念。不为列表提供 &、| 运算符,规避了歧义、隐藏的性能恶化与潜在的类型崩溃。在需要集合操作时,根据实际是否需要保序或统计频次,显式地选择 set 转换、集合辅助推导式或 Counter,才是符合Pythonic哲学的高效健壮之道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















